---
title: "Fünf Python-Bibliotheken für Datenvisualisierung: Welche wann"
description: "matplotlib, seaborn, plotly, bokeh und altair zeichnen alle ein Balkendiagramm. Der Unterschied liegt darin, wo das Diagramm gerendert wird und wo deine Daten dabei landen. Ein praktischer Leitfaden zur Auswahl — mit der einen Einschränkung, die jede Bibliothek mitbringt."
author: Aleksei Aleinikov
date: 2026-09-17
lang: de
tags: [matplotlib, seaborn, plotly, bokeh, altair, datenvisualisierung, python-diagramme]
canonical: https://www.alekseialeinikov.com/de/blog/topics/programming/python-bibliotheken-datenvisualisierung
source: alekseialeinikov.com
---
# Fünf Python-Bibliotheken für Datenvisualisierung: Welche wann
Jeder Vergleich von Python-Plotting-Bibliotheken wird zur Galerie. Fünf Seiten Beispieldiagramme, alle hübsch, keines davon hilfreich — denn alle fünf Bibliotheken können ein Balkendiagramm zeichnen, und alle fünf Balkendiagramme sehen gut aus.
Die Frage, die tatsächlich entscheidet, welche du nehmen solltest, ist langweilig und steht nie auf der Galerieseite: **Wo wird das Diagramm gerendert, und wo landen deine Daten dabei?**
Beantworte das, und keine Eigenheit dieser Bibliotheken überrascht dich mehr.
## Die Trennlinie, die alles erklärt
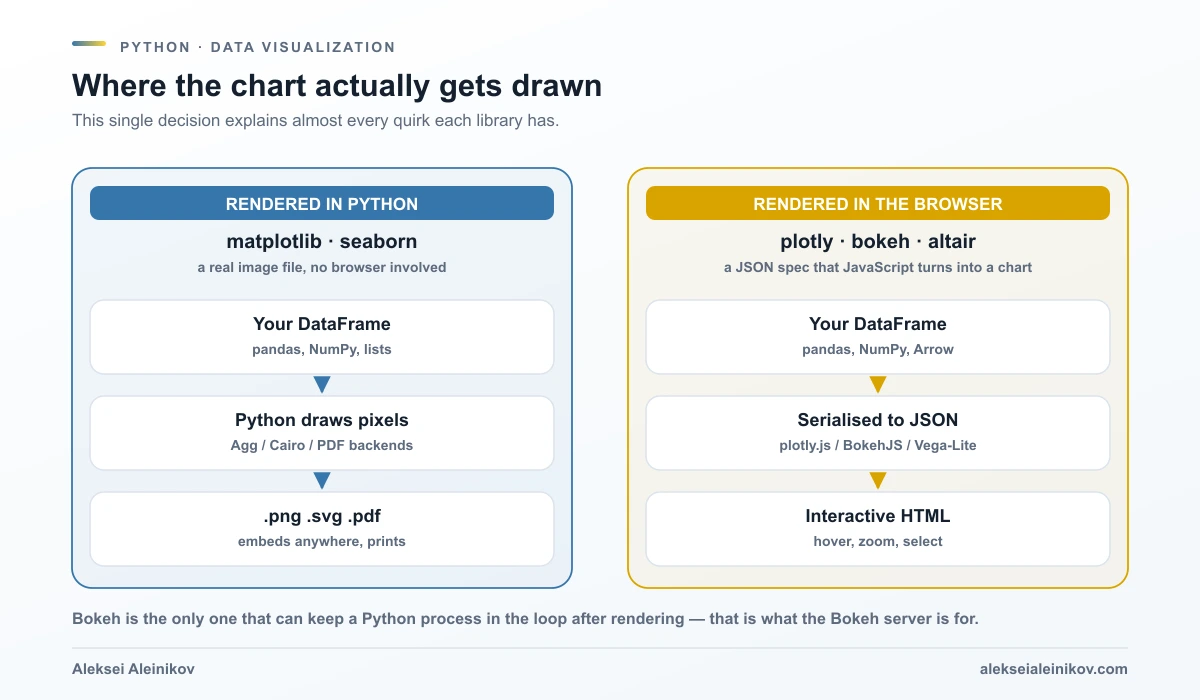
Zwei Rendering-Modelle. Auf welcher Seite eine Bibliothek steht, sagt fast alles andere über sie voraus.
**matplotlib und seaborn zeichnen in Python.** Dein DataFrame geht hinein, ein Rendering-Backend macht daraus Pixel oder Vektoren, und du bekommst eine Datei. Kein Browser ist beteiligt. Das Ergebnis ist ein `.png`, `.svg` oder `.pdf`, das du in ein Paper einbettest, an eine E-Mail hängst oder ins Repository committest.
**plotly, bokeh und altair zeichnen im Browser.** Dein DataFrame wird in eine JSON-Beschreibung des Diagramms serialisiert, und eine JavaScript-Bibliothek — plotly.js, BokehJS oder Vega-Lite — liest diese Beschreibung und rendert sie. Das Ergebnis ist interaktives HTML: Hover, Zoom, Auswahl, alles gratis.
Dieser eine Unterschied sagt den Rest voraus. Er erklärt, warum Altair ein Zeilenlimit hat. Warum plotly einen installierten Browser braucht, um ein PNG zu schreiben. Warum matplotlib sperrig wirkt — und warum es nie kaputtgeht.
## matplotlib — das Fundament, auf dem alles andere steht
matplotlib ist nicht eine von fünf Optionen. Es ist die Schicht, mit der drei der anderen gerade nicht direkt reden wollen.
Es gibt dir vollständige Kontrolle: jeder Tick, jede Achsenlinie, jede Farbe, jeder Artist auf der Leinwand ist ansprechbar. Diese Kontrolle ist zugleich die Beschwerde. Ein Diagramm, das seaborn in einer Zeile erzeugt, braucht in matplotlib fünf bis zehn — und die Defaults sind in die Jahre gekommen.
```python
import matplotlib.pyplot as plt
fig, ax = plt.subplots(figsize=(7, 4))
ax.plot(df["month"], df["revenue"], marker="o")
ax.set_ylabel("Umsatz (EUR)")
ax.set_title("Monatlicher Umsatz")
ax.grid(alpha=0.3)
fig.savefig("umsatz.pdf", bbox_inches="tight")
```
Diese letzte Zeile ist der Grund, warum matplotlib bleibt. Ein Aufruf, und du hast ein Vektor-PDF in Druckqualität. Nichts auf der Browser-Seite der Trennlinie schafft das ohne zusätzliche Maschinerie.
**Nimm es, wenn:** das Ergebnis eine Datei sein muss, das Layout exakt sein muss, oder du ohnehin schon in matplotlib gelandet bist, weil dich etwas anderes dorthin geschickt hat.
## seaborn — Statistik, mit matplotlib darunter
seaborn ist für die meisten Analysearbeiten die wertvollste Bibliothek dieser Liste, weil sie verändert, worüber du nachdenken musst. Die Dokumentation beschreibt die API als **datensatzorientiert und deklarativ**: Du benennst die Spalten und ihre Rollen, den Rest — semantisches Mapping und statistische Aggregation — erledigt die Bibliothek.
```python
import seaborn as sns
sns.set_theme()
tips = sns.load_dataset("tips")
sns.relplot(
data=tips,
x="total_bill", y="tip", col="time",
hue="smoker", style="smoker", size="size",
)
```
Fünf Variablen, ein Aufruf, in Subplots facettiert, Legende inklusive. Das Äquivalent in reinem matplotlib ist eine Schleife und viel Buchhaltung.
Es macht zudem echte Statistik, nicht nur Grafik. Wenn seaborn einen Wert schätzt, nutzt es **Bootstrapping zur Berechnung von Konfidenzintervallen** und zeichnet die Fehlerbalken selbst — `relplot`, `displot` und `catplot` decken Zusammenhänge, Verteilungen und Kategorien ab, und `lmplot` passt eine Regression samt Unsicherheit an.
Zwei Dinge solltest du wissen, bevor du dich darauf verlässt.
Erstens: **seaborn ersetzt matplotlib nicht, es sitzt darauf**. Die Dokumentation benennt die Folge offen: Vollständige Anpassung erfordert Kenntnis der matplotlib-Konzepte, und Teil der Lernkurve ist zu erkennen, wann man eine Ebene tiefer muss. Zusätzliche Keyword-Argumente werden genau deshalb an die darunterliegenden matplotlib-Artists durchgereicht.
Zweitens: `sns.set_theme()` **ist global**. Es schreibt in matplotlibs rcParam-System und verändert damit das Aussehen aller matplotlib-Plots dieser Session — auch solcher, die du nicht mit seaborn gezeichnet hast. Meist ist das gewollt, gelegentlich ist es ein Rätsel, das zehn Minuten kostet.
**Nimm es, wenn:** du einen DataFrame und eine statistische Frage hast. Also meistens.
## plotly — interaktiv ab Werk
plotly baut auf der JavaScript-Bibliothek plotly.js auf, deckt **über 40 Diagrammtypen** ab und liefert Hover, Zoom und Pan, ohne dass du JavaScript schreibst. Die High-Level-API Plotly Express bringt dich in einer Zeile dorthin.
```python
import plotly.express as px
fig = px.scatter(
df, x="bill_length_mm", y="bill_depth_mm",
color="species", size="body_mass_g",
hover_data=["island"],
)
fig.write_html("penguins.html")
```
Öffne dieses HTML irgendwo, und du kannst über einen Punkt fahren, um seine Werte zu lesen. Um explorative Ergebnisse mit Leuten zu teilen, die dein Notebook nicht ausführen werden, ist das ein echter Sprung gegenüber einem PNG.
Die Einschränkung liegt beim Export. plotly schreibt statische Bilder über **Kaleido**, und Kaleido **benötigt ein installiertes Chrome oder Chromium** — findet es keines, gibt es den Befehl `plotly_get_chrome`. Ein interaktives Diagramm ist also gratis, ein PNG für den Bericht zieht einen Browser in deine Build-Pipeline. Gut zu wissen, bevor du dich für alles Druckbare darauf festlegst.
Für vollwertige Web-Anwendungen kombiniert sich plotly mit **Dash** — einem eigenen Framework, keiner Funktion der Plotting-Bibliothek.
**Nimm es, wenn:** das Publikum mit dem Diagramm interagiert und das Ergebnis eine Webseite ist, kein Dokument.
## bokeh — die, die Python in der Schleife hält
Oberflächlich überschneidet sich bokeh stark mit plotly: Browser-Rendering, Interaktivität, Widgets. Der Unterschied ist architektonisch — und genau er ist der Grund, bokeh zu wählen.
**Der Bokeh-Server** erlaubt interaktive Web-Anwendungen, die mit Python-Code auf einem Server verbunden sind. Bei plotly lebt die Interaktivität vollständig im Browser: Das Diagramm kennt, was du ihm mitgegeben hast, und sonst nichts. In einer Bokeh-Server-App kann das Verschieben eines Sliders eine Python-Funktion aufrufen, die eine Datenbank abfragt, neu rechnet und neue Daten ins Diagramm zurückschiebt.
```python
from bokeh.plotting import figure, curdoc
from bokeh.models import Slider, ColumnDataSource
from bokeh.layouts import column
source = ColumnDataSource(data=dict(x=[], y=[]))
p = figure(height=350, title="Live-Abfrage")
p.line("x", "y", source=source)
def update(attr, old, new):
source.data = run_query(window=slider.value) # echtes Python, bei Bedarf
slider = Slider(start=1, end=90, value=30, title="Tage")
slider.on_change("value", update)
curdoc().add_root(column(slider, p))
```
Das läuft mit `bokeh serve app.py`. Was zugleich der Preis ist: Eine Bokeh-Server-Anwendung ist ein **laufender Prozess**, keine Datei zum Mailen. Wenn sie niemand hostet, brauchst du bokeh nicht.
**Nimm es, wenn:** Interaktion echtes Python auslösen muss — Live-Daten, teure Abfragen, Modelle, die nicht in den Browser passen.
## altair — beschreibe das Diagramm, nicht das Zeichnen
Vega-Altair ist eine deklarative Bibliothek **auf Basis von Vega und Vega-Lite**. Die Idee ist präzise: Du deklarierst Verbindungen zwischen Datenspalten und visuellen Encoding-Kanälen — x, y, Farbe, Größe — alles Weitere wird automatisch erledigt.
```python
import altair as alt
from altair.datasets import data
cars = data.cars()
alt.Chart(cars).mark_point().encode(
x="Horsepower",
y="Miles_per_Gallon",
color="Origin",
).interactive()
```
Das ist das ganze Diagramm, und `.interactive()` macht es schwenk- und zoombar. Wo altair davonzieht, ist Komposition: Facettierung, Layering und Verkettung sind Grammatik-Operationen statt Layout-Code — von einem Diagramm zu einem Raster aus zwölf ist eine kleine Änderung, kein Umbau.
Die bekannte Einschränkung folgt direkt aus dem Design. Weil altair **eine Spezifikation samt Daten** erzeugt und keine Pixel, wird jede Zeile in die Ausgabe serialisiert. Versuch, mehr als 5.000 Zeilen zu plotten, und du bekommst:
```text
MaxRowsError: The number of rows in your dataset is greater than the maximum allowed (5000).
```
Das ist Absicht. Große eingebettete Datensätze erzeugen riesige Notebooks, langsame Seitenaufbauten und Transformationen, die in JavaScript auf Daten laufen, die Python nie hätten verlassen sollen. Die Auswege, grob nach Häufigkeit ihrer Richtigkeit:
- **In pandas vorab aggregieren** und Kennzahlen statt Rohzeilen senden.
- **VegaFusion aktivieren** — `alt.data_transformers.enable("vegafusion")` — was Transformationen zuerst in Python auswertet, die Grenze auf **100.000 Zeilen** hebt und ungenutzte Spalten entfernt.
- **Daten per URL übergeben**, sodass sie geladen statt eingebettet werden.
- **Die Prüfung abschalten** mit `alt.data_transformers.disable_max_rows()`, wenn du es wirklich so meinst.
**Nimm es, wenn:** du viele verwandte Diagramme baust und Kompaktheit und Komponierbarkeit wichtiger sind als Kontrolle auf Pixelebene.
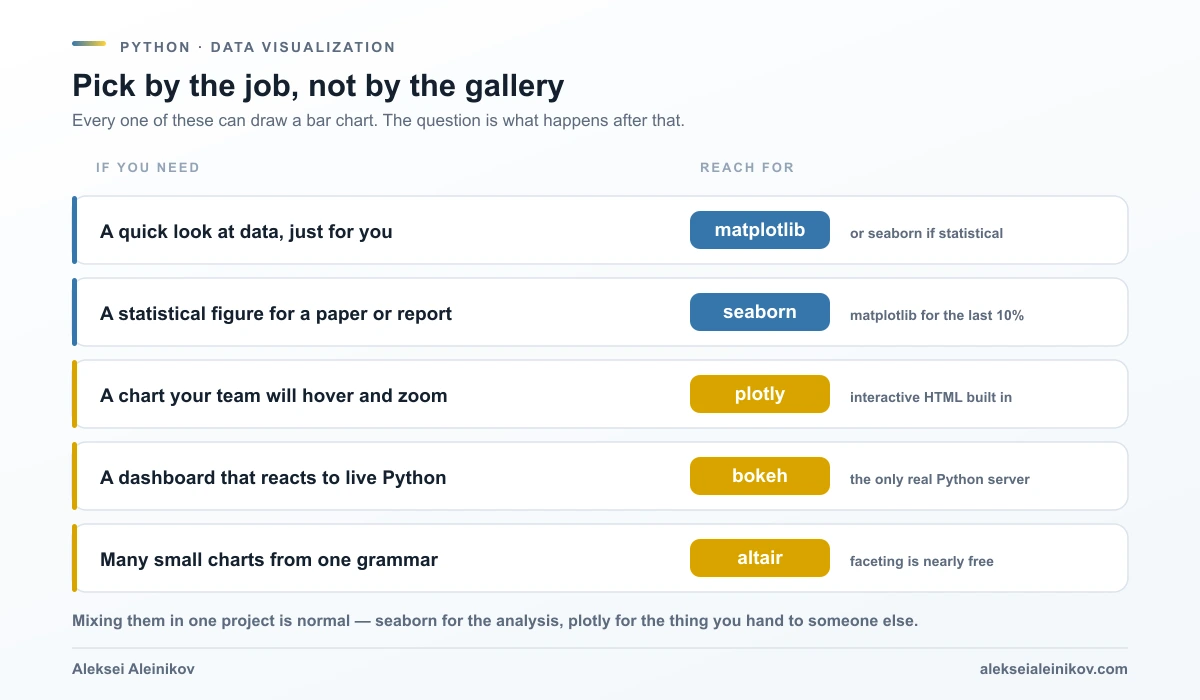
## Welche wofür
Wähle danach, was nach dem Diagramm passieren muss — nicht danach, welche Galerie am schönsten aussah.
Sie zu mischen ist normal. seaborn während der Analyse und plotly für das, was an Stakeholder geht, ist ein völlig stimmiger Stack, keine Unentschlossenheit.
## Die eine Einschränkung, die jede mitbringt
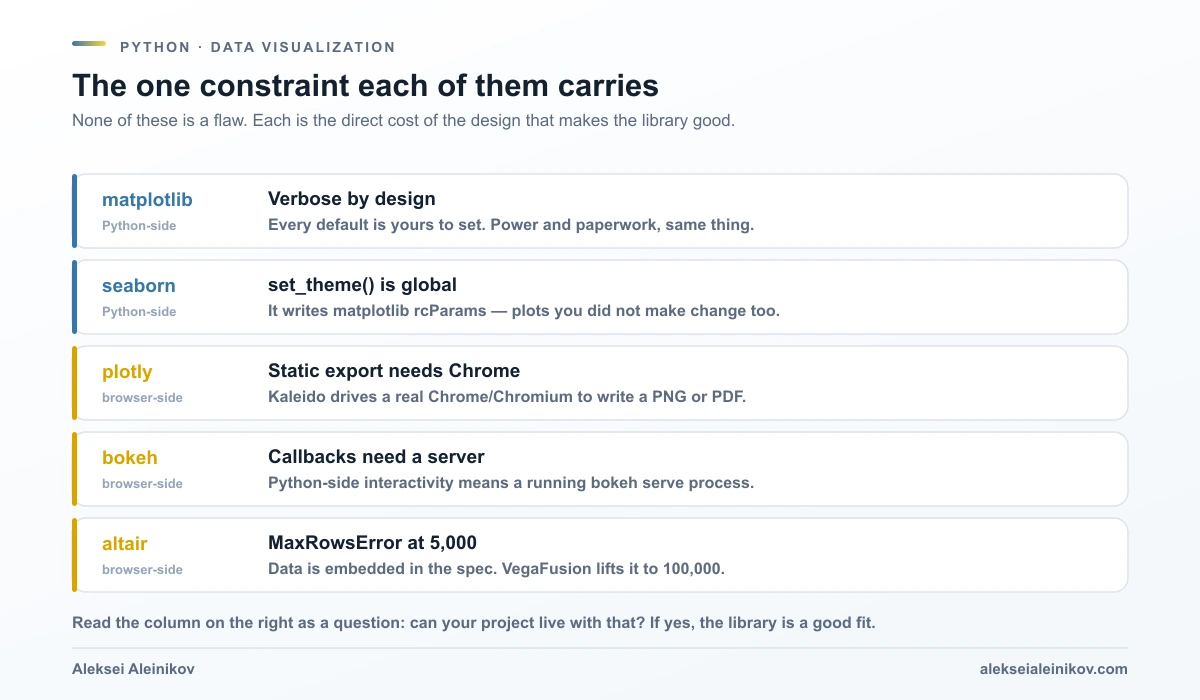
Keine davon ist ein Fehler. Jede ist der direkte Preis der Designentscheidung, die die Bibliothek gut macht.
Lies jeden Punkt als Frage statt als Warnung. Verträgt dieses Projekt einen laufenden Serverprozess? Darf Chrome in der Build-Pipeline stehen? Ist der Datensatz klein genug für die Reise in den Browser — oder hätte er ohnehin vorher aggregiert gehört?
Wenn die Antwort ja lautet, ist die Einschränkung kein Problem. Sie ist nur die Form des Werkzeugs.
## Was ich tatsächlich tun würde
Wenn du heute anfängst und eine Antwort statt fünf willst: **Lerne zuerst seaborn und matplotlib bei Bedarf, wenn seaborn sich nicht biegen lässt.** Das deckt den Großteil echter Analysearbeit ab, erzeugt Dateien, die in Dokumente passen, und bringt keine Infrastruktur mit.
Nimm **plotly** dazu, sobald dich jemand zum ersten Mal fragt: „Kann ich da drüberfahren?" Nimm **altair** dazu, wenn du viele Varianten desselben Diagramms produzierst. Nimm **bokeh** nur, wenn Interaktion wirklich Python ausführen muss — und wenn du unsicher bist, ob sie das muss, muss sie es nicht.
Die Galerie verrät dir nichts davon, weil jede Galerie dieselben fünf Diagramme zeigt, nur gut gezeichnet.
Wenn du speziell auf der Visualisierungsseite tiefer einsteigen willst: Ich habe darüber ein Buch geschrieben — *Prompting Python Data Visualization* (Orange Education, 2026) — das die Designentscheidungen hinter diesen Diagrammen behandelt, nicht nur die Syntax. Zur Technik rund um die Analyse: Der [pytest-Praxisleitfaden](https://www.alekseialeinikov.com/de/blog/topics/programming/pytest-in-der-praxis-2026-python-testing-guide) behandelt das Testen des Codes, der die Zahlen erzeugt, und [joblib](https://www.alekseialeinikov.com/de/blog/topics/programming/python-joblib-2026-prozesse-threads-memmap-caching) das Durchkommen durch Datensätze, bei denen das Plotten der einfache Teil ist.