---
title: "SQLite mit Go: Treiber, WAL, Locking und Production Patterns"
description: "SQLite funktioniert in einem Go-Service erstaunlich gut, wenn der Connection Pool sein Locking-Modell respektiert. Dieser Leitfaden vergleicht aktuelle Treiber, misst ihre realen Kosten und entwickelt ein Production-Setup mit WAL, begrenzten Pools, kurzen Transaktionen, Checkpoints, Backups und beobachtbaren Fehlermodi."
author: Aleksei Aleinikov
date: 2026-09-23
lang: de
tags: [golang sqlite, go sqlite3, sqlite wal, database/sql, sqlite locking, modernc sqlite, go-sqlite3]
canonical: https://www.alekseialeinikov.com/de/blog/topics/programming/sqlite-mit-go-treiber-wal-locking-production-patterns
source: alekseialeinikov.com
---
# SQLite mit Go: Treiber, WAL, Locking und Production Patterns
SQLite scheitert in Go selten daran, dass die Datenbank „zu klein“ wäre. Es scheitert daran, dass ein `*sql.DB` wie eine Connection aussieht, tatsächlich aber einen Pool verwaltet — und dieser Pool mehr Writer öffnen darf, als SQLite ausführen kann.
Das nützliche mentale Modell ist einfach: **Der Treiber entscheidet, wie SQLite in dein Binary kommt. Pool und Transaktionsmodell entscheiden, wie es sich in Produktion verhält.**
Dieser Leitfaden verwendet die am 23. September 2026 verfügbaren Releases und SQLite 3.53.4. Er behandelt eingebettete Single-Host-Deployments mit einem echten persistenten Datenträger. Eine Datenbankdatei auf NFS, einem flüchtigen Container-Dateisystem oder einem Volume, auf das mehrere Application Hosts schreiben, ist eine andere Architektur — keine Tuning-Aufgabe.
## Welchen Go-SQLite-Treiber solltest du wählen?
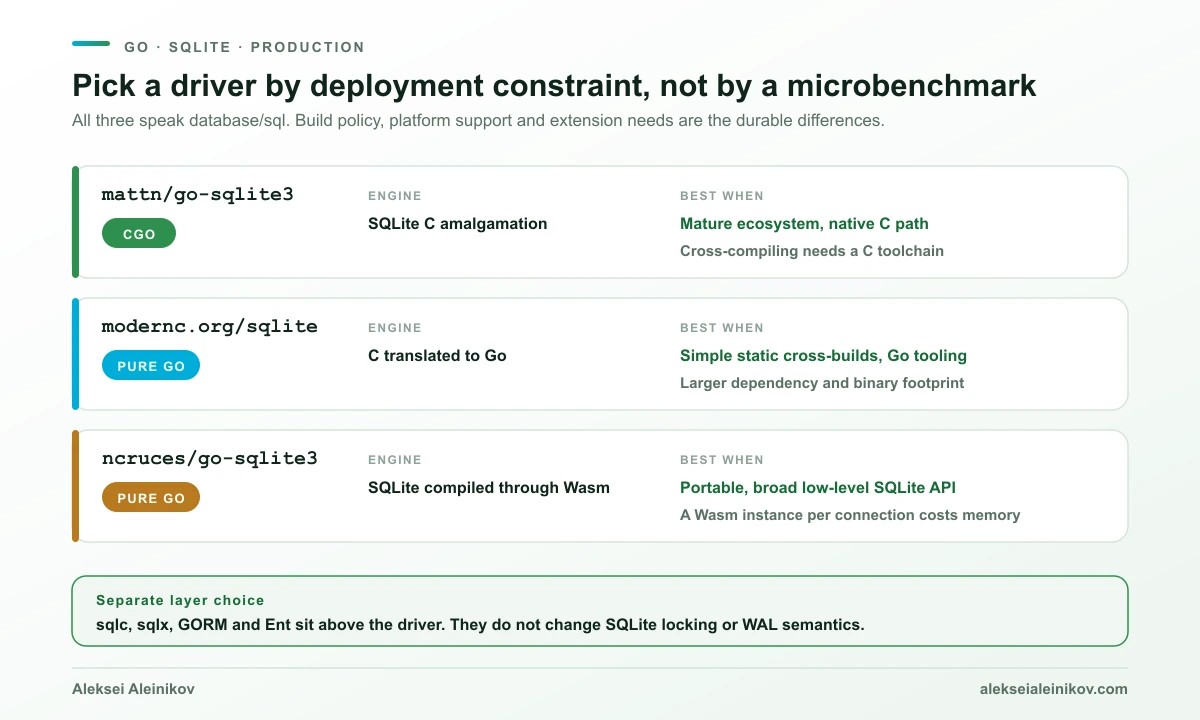
Drei Treiber verdienen eine ernsthafte Betrachtung. Alle stellen `database/sql` bereit; keiner verändert die One-Writer-Regel von SQLite.
| Treiber | Implementierung | CGO | Lizenz | Bester Einsatz |
|---|---|---:|---|---|
| [`github.com/mattn/go-sqlite3`](https://pkg.go.dev/github.com/mattn/go-sqlite3) v1.14.52 | Mitgelieferte SQLite-C-Amalgamation | Ja | MIT | Reifes Ökosystem, native C-Ausführung, Extensions über Build Tags |
| [`modernc.org/sqlite`](https://pkg.go.dev/modernc.org/sqlite) v1.59.0 | Von C nach Go übersetztes SQLite | Nein | BSD-3-Clause | Statische Cross-Builds, Go-Tooling, kein C-Compiler in CI |
| [`github.com/ncruces/go-sqlite3`](https://pkg.go.dev/github.com/ncruces/go-sqlite3) v0.35.5 | Über Wasm kompiliertes und mit wasm2go übersetztes SQLite | Nein | MIT | Portabilität, breite Low-Level-API, eigene VFS- und Backup-Funktionen |
`mattn/go-sqlite3` bleibt der konservative Standard, wenn CGO akzeptabel ist. Der Trade-off ist operativ: Cross-Compiling umfasst nun auch C-Toolchain und Ziel-libc.
`modernc.org/sqlite` entfernt CGO und vereinfacht statische Builds. Die eigene Dokumentation sagt erfreulich klar, dass CPU-lastige SQLite-Arbeit langsamer als natives C läuft, während I/O-lastige Arbeit den Abstand verkleinert. Pinne die Version von `modernc.org/libc`, die das `go.mod` des Treibers auswählt; das Projekt bezeichnet diese Abhängigkeit selbst als fragil.
`ncruces/go-sqlite3` ist ebenfalls CGO-frei, erreicht SQLite aber über Wasm. Der Treiber bietet Online Backup, WAL Hooks, Checkpoint-Steuerung, eigene VFSes und typisierte SQLite-Fehler. Jede physische Connection läuft in einer eigenen Wasm-Sandbox; deshalb sollte Speicher pro Connection gemessen werden.
Wähle zuerst den Build- und Runtime-Vertrag. Ein Microbenchmark liefert Evidenz, aber keine Architektur.
`sqlc`, `sqlx`, GORM und Ent liegen auf einer anderen Ebene. Sie generieren Queries, mappen Rows oder verwalten Entitäten oberhalb von `database/sql`. Sie sind keine SQLite-Treiber und verändern weder WAL noch Locking oder Checkpoints.
## Was kosteten die Treiber lokal?
Ich habe denselben `database/sql`-Harness gegen alle drei Treiber auf einem Apple M4 Pro mit macOS arm64, Go 1.26.0 und SQLite 3.53.4 ausgeführt. Jeder Benchmark nutzte:
- eine dateibasierte temporäre Datenbank mit 10.000 vorab eingefügten Rows,
- `journal_mode=WAL`, `synchronous=NORMAL`, `foreign_keys=ON`, `busy_timeout=5000`,
- `SetMaxOpenConns(4)` und `SetMaxIdleConns(4)`,
- fünf Läufe mit je zwei Sekunden pro Benchmark,
- einen heißen Primärschlüssel-Read mit `QueryRow` und `Scan`,
- eine Transaktion mit 100 vorbereiteten `INSERT`s,
- ein minimales Binary mit `-trimpath -ldflags='-s -w'`.
Die Tabelle zeigt den Median aus fünf Läufen. Eine Batched-Write-Operation ist eine Transaktion mit 100 Rows, nicht eine einzelne Row.
| Treiber | Point Read | Read-Allokationen | 100-Row-Transaktion | Write-Allokationen | Binary |
|---|---:|---:|---:|---:|---:|
| mattn | **2,479 µs/op** | 623 B / 19 | **74,431 µs/op** | 18.404 B / 720 | **3,72 MB** |
| modernc | 3,385 µs/op | **543 B / 18** | 89,102 µs/op | 18.236 B / 812 | 6,38 MB |
| ncruces | 3,466 µs/op | 647 B / 18 | 84,563 µs/op | **15.932 B / 513** | 7,59 MB |
Der native Treiber führte diesen kleinen CPU-lastigen Workload an. `ncruces` lag bei der Batched Transaction dicht dahinter und allozierte dort weniger. `modernc` benötigte beim Point Read die wenigsten Bytes. Das sind Beobachtungen für diese Maschine und Query-Form, keine universelle Rangliste: Storage-Latenz, Query-Pläne, Page-Cache-Wärme, Extension Flags und Concurrency können das Ergebnis verschieben.
Beständiger sind die Build-Eigenschaften und der Binary Footprint. Wenn 15 µs Unterschied pro 100-Row-Transaktion neben Netzwerk- oder Disk-Arbeit irrelevant sind, kann eine einfachere Release-Pipeline mehr wert sein als der Benchmark-Sieg.
## Warum verändert `database/sql` das Locking-Problem?
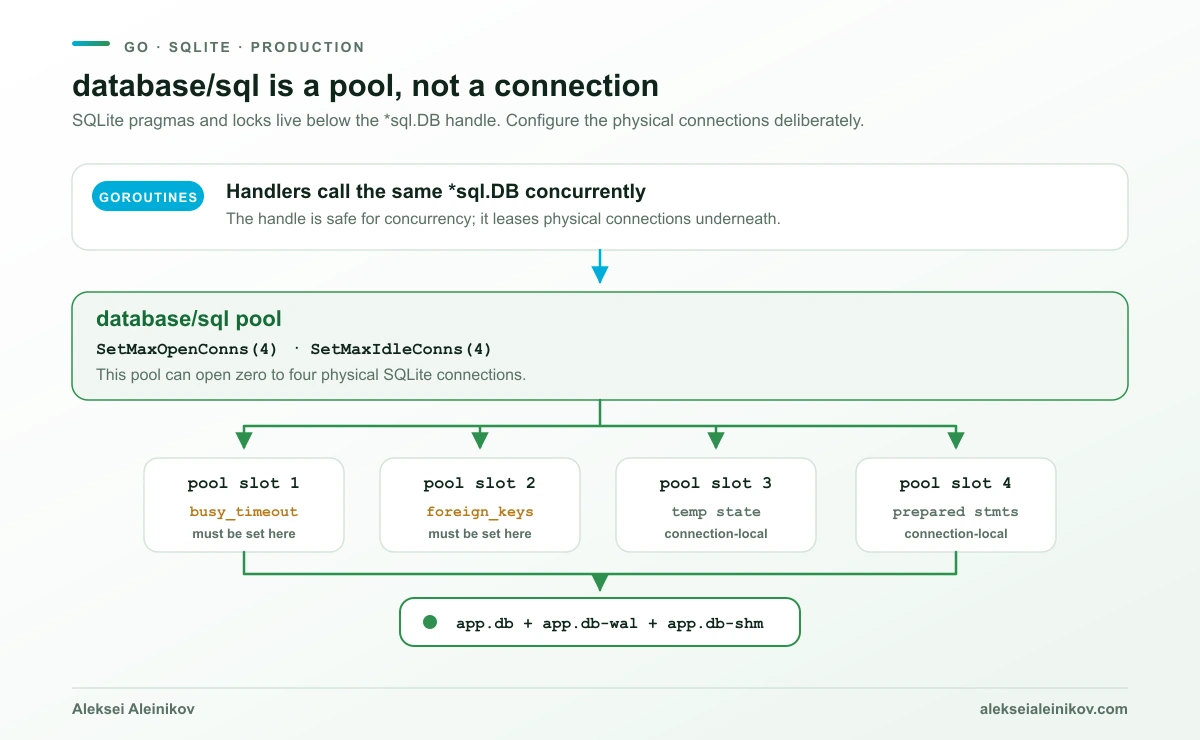
`sql.Open` öffnet normalerweise keine Connection. Es liefert einen langlebigen `*sql.DB`, der physische Connections bei Bedarf erzeugt und wiederverwendet. Der Handle ist für parallele Goroutines sicher; eine einzelne SQLite-Connection trägt ihren eigenen Session State.
`*sql.DB` ist die Pool-Grenze. Konfiguriere jede Connection — nicht nur diejenige, die zufällig das erste PRAGMA ausgeführt hat.
Der Unterschied ist wichtig, weil SQLite-Einstellungen verschiedene Scopes besitzen:
- `journal_mode=WAL` bleibt nach der Aktivierung an der Datenbankdatei erhalten.
- `foreign_keys`, `busy_timeout`, `synchronous`, temporärer State und viele weitere Optionen sind connection-lokal.
- Eine Transaktion und alle über sie ausgeführten Statements bleiben auf einer physischen Connection.
Das hier ist unsicher:
```go
db, err := sql.Open("sqlite", "app.db")
if err != nil {
return err
}
_, err = db.Exec("PRAGMA foreign_keys = ON")
```
`Exec` konfiguriert die Connection, die für diesen Aufruf ausgeliehen wurde. Eine später vom Pool geöffnete Connection kann Foreign Keys weiterhin nicht durchsetzen.
Lege connection-lokale Einstellungen im DSN des Treibers oder in einem Connection Hook fest. Hier ist ein vollständiger Bootstrap für `modernc.org/sqlite`; dessen validierte Kurzschlüssel sind bewusst nah an `mattn/go-sqlite3`:
```go
package store
import (
"context"
"database/sql"
"fmt"
"net/url"
"path/filepath"
"time"
_ "modernc.org/sqlite"
)
func openSQLite(ctx context.Context, path string, maxOpen int) (*sql.DB, error) {
absolute, err := filepath.Abs(path)
if err != nil {
return nil, fmt.Errorf("resolve sqlite path: %w", err)
}
uri := &url.URL{Scheme: "file", Path: absolute}
query := uri.Query()
query.Set("_journal_mode", "WAL")
query.Set("_synchronous", "NORMAL")
query.Set("_foreign_keys", "1")
query.Set("_busy_timeout", "5000")
query.Set("_txlock", "immediate")
uri.RawQuery = query.Encode()
db, err := sql.Open("sqlite", uri.String())
if err != nil {
return nil, fmt.Errorf("open sqlite: %w", err)
}
db.SetMaxOpenConns(maxOpen)
db.SetMaxIdleConns(maxOpen)
pingCtx, cancel := context.WithTimeout(ctx, 3*time.Second)
defer cancel()
if err := db.PingContext(pingCtx); err != nil {
db.Close()
return nil, fmt.Errorf("ping sqlite: %w", err)
}
return db, nil
}
```
Für `mattn` importierst du `github.com/mattn/go-sqlite3`, verwendest den Treibernamen `sqlite3` und behältst dieselben Kurzoptionen. Für `ncruces` importierst du `github.com/ncruces/go-sqlite3/driver`, nutzt ebenfalls `sqlite3` und formulierst PRAGMAs als wiederholte `_pragma=...`-Parameter; `_txlock=immediate` wird direkt unterstützt. Gehe nicht davon aus, dass DSNs portabel sind, nur weil die SQL-API gleich ist.
Prüfe nach dem Öffnen die Werte, von denen der Service abhängt, und stoppe den Start bei Abweichungen. Insbesondere liefert `journal_mode` den Modus zurück, den SQLite tatsächlich gewählt hat. WAL anzufordern beweist nicht, dass das VFS es akzeptiert hat.
`synchronous=NORMAL` ist eine bewusste Latenz-Durability-Entscheidung: In WAL Mode kann die Datenbank nach einem Stromausfall konsistent bleiben, aber die letzten bestätigten Transaktionen können zurückrollen. Wenn diese RPO nicht akzeptabel ist, verwende `FULL` und miss die Commit-Latenz auf dem echten Datenträger.
## Was verändert WAL — und was nicht?
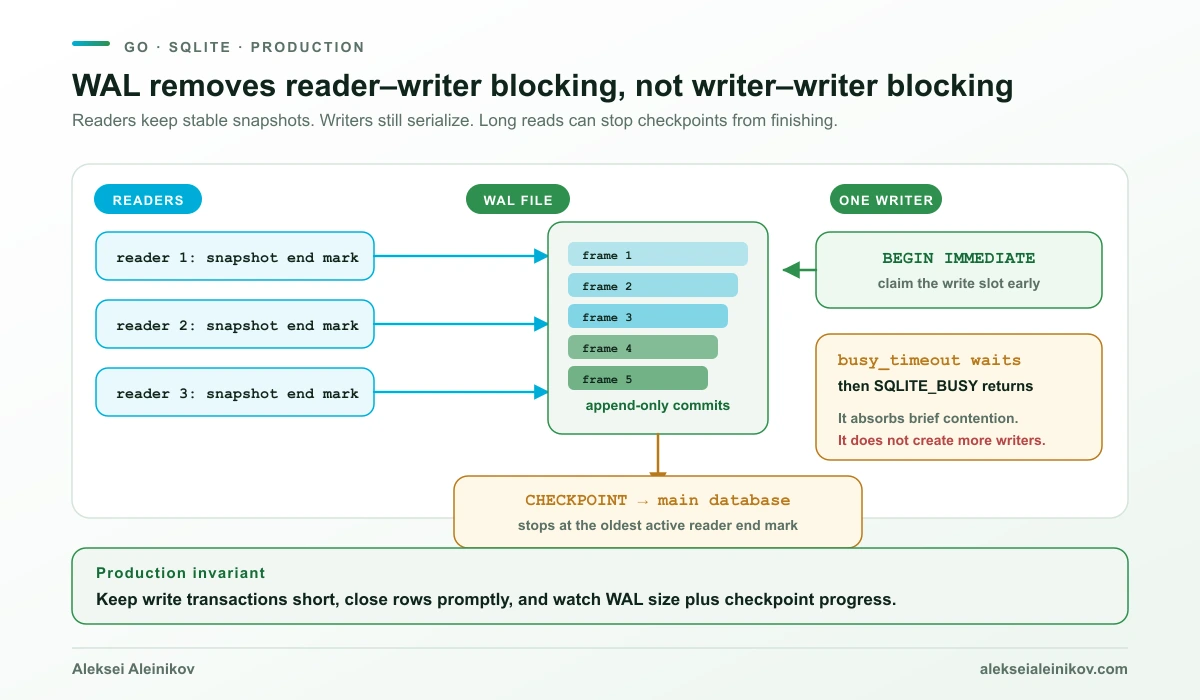
Im Rollback-Journal-Modus braucht ein Writer schließlich exklusiven Zugriff, um die Hauptdatei zu aktualisieren. WAL kehrt den Schreibpfad um: Commitete Pages werden an `app.db-wal` angehängt, während Leser einen End Mark als Snapshot behalten.
Damit erhält SQLite seine wertvolle Production-Eigenschaft: **Leser blockieren keinen Writer, und ein Writer blockiert keine Leser.** Mehrere Writer entstehen dadurch nicht. Die offizielle WAL-Dokumentation ist eindeutig: Es gibt eine WAL-Datei und deshalb nur einen Writer gleichzeitig.
WAL trennt Leser vom Writer. Es entfernt weder die Writer-Serialisierung noch den Checkpoint-Druck.
SQLite versucht standardmäßig automatisch einen Checkpoint, wenn das WAL 1.000 Pages erreicht. Ein Checkpoint kopiert commitete Frames zurück in die Hauptdatei. Er kann parallel zu Lesern laufen, muss aber stoppen, bevor er eine Page überschreibt, die der älteste aktive Reader benötigt.
Das ist Checkpoint Starvation: Überlappende oder vergessene Reads verhindern einen vollständigen Checkpoint, das WAL wächst weiter, und Reads werden teurer, weil mehr Zustand berücksichtigt werden muss.
Schließe `Rows` schnell und prüfe immer `Rows.Err()`:
```go
rows, err := db.QueryContext(ctx, query, args...)
if err != nil {
return err
}
defer rows.Close()
for rows.Next() {
if err := rows.Scan(&item.ID, &item.Name); err != nil {
return err
}
}
return rows.Err()
```
Die Dateien `-wal` und `-shm` gehören zum Live-Zustand der Datenbank. Lösche, verschiebe oder sichere die Hauptdatei nicht ohne sie, solange Connections offen sind.
Eine aktuelle Betriebsanforderung ist hier relevant: SQLite hat in 3.51.3 eine seltene WAL-Reset-Corruption-Race behoben. Betroffen waren WAL-Datenbanken bis 3.51.2, wenn mehrere Connections im selben Moment schrieben oder checkpointeten. Alle drei hier getesteten Treiberversionen meldeten SQLite 3.53.4. Wenn du System-SQLite oder einen älteren gepinnten Treiber nutzt, prüfe `SELECT sqlite_version()`, statt den Fix anzunehmen.
## Wie solltest du den Pool formen?
`database/sql` erlaubt standardmäßig unbegrenzt viele offene Connections. Für eine eingebettete Datenbank ist das ein schlechter Default: Jede Connection besitzt einen Page Cache, während alle Writer letztlich um denselben Slot konkurrieren.
`SetMaxOpenConns(1)` verhindert Write Races, serialisiert aber auch Reads. Mit WAL ist ein sinnvoller Startpunkt:
- ein `*sql.DB` für Reads mit einem kleinen begrenzten Pool, oft vier Connections,
- ein `*sql.DB` für Writes mit genau einer offenen Connection,
- derselbe Datenbankpfad und dieselbe per-Connection-Konfiguration auf beiden,
- eine API-Grenze, die Ad-hoc-Writes über den Read Handle verhindert.
```go
type Store struct {
Read *sql.DB
Write *sql.DB
}
func Open(ctx context.Context, path string) (*Store, error) {
readDB, err := openSQLite(ctx, path, 4)
if err != nil {
return nil, err
}
writeDB, err := openSQLite(ctx, path, 1)
if err != nil {
readDB.Close()
return nil, err
}
return &Store{Read: readDB, Write: writeDB}, nil
}
```
Das macht Writes nicht schneller. Es macht Contention im Prozess sichtbar und begrenzt, während parallele Reads erhalten bleiben.
Wenn Writes stoßweise aus vielen Goroutines kommen, leite Commands durch eine application-lokale Writer Queue. Sie kann benachbarte Arbeit in einer Transaktion bündeln, Queue Depth sichtbar machen, bei voller Queue ablehnen und Backpressure anwenden, bevor SQLite selbst zur Queue wird.
## Warum ist `BEGIN IMMEDIATE` besser als ein Deferred Upgrade?
SQLite-Transaktionen sind standardmäßig deferred. `BEGIN` selbst nimmt keinen Write Lock. Eine Transaktion kann einen Snapshot lesen, Application Work erledigen und beim ersten `UPDATE` feststellen, dass eine andere Connection den Write Slot bereits besitzt. Das Upgrade scheitert mit `SQLITE_BUSY`.
`BEGIN IMMEDIATE` versucht, die Schreibtransaktion am Anfang zu beanspruchen. Es kann weiterhin busy zurückgeben — aber bevor die Transaktion Arbeit auf Basis eines Snapshots erledigt hat, den sie nicht aktualisieren kann.
Setze `_txlock=immediate` auf dem Write Handle, wenn der Treiber es unterstützt. Halte die Transaktion danach kompromisslos kurz:
```go
func (store *Store) Rename(ctx context.Context, id int64, name string) error {
tx, err := store.Write.BeginTx(ctx, nil)
if err != nil {
return fmt.Errorf("begin rename: %w", err)
}
defer tx.Rollback()
if _, err := tx.ExecContext(
ctx,
`UPDATE items SET name = ?, updated_at = unixepoch() WHERE id = ?`,
name,
id,
); err != nil {
return fmt.Errorf("rename item: %w", err)
}
if err := tx.Commit(); err != nil {
return fmt.Errorf("commit rename: %w", err)
}
return nil
}
```
Validierung, HTTP-Aufrufe, JSON-Encoding und CPU-lastige Transformationen gehören **vor** `BeginTx`. Eine Transaktion ist kein bequemer Scope für einen Request Handler, sondern Zeit im Besitz knappen Datenbankzustands.
## Was löst `busy_timeout` tatsächlich?
`busy_timeout=5000` installiert einen Busy Handler pro Connection. Wenn ein Lock nicht verfügbar ist, schläft SQLite und versucht es erneut. Nach insgesamt fünf Sekunden Wartezeit liefert es `SQLITE_BUSY`.
Das hilft bei Überschneidungen im Millisekundenbereich. Es ist keine Concurrency-Strategie.
Drei Regeln halten den Mechanismus ehrlich:
1. Setze ihn über DSN oder Hook auf jeder Connection.
2. Halte ihn unterhalb des kürzesten Request-Deadlines; gehe nicht davon aus, dass Context Cancellation den Busy Handler des Treibers unterbricht.
3. Zähle Busy-Fehler und Latenz. Ein Timeout, das einen dauerhaft gesättigten Writer versteckt, macht aus schnellen Fehlern nur langsame Fehler.
Der zweite Punkt lässt sich messen. Mit `modernc.org/sqlite` v1.59.0 hielt ein Writer den Lock, `busy_timeout` lag bei fünf Sekunden und die konkurrierende Operation hatte ein Context Deadline von 100 ms. Sie kehrte erst nach ungefähr **5,06 Sekunden** zurück — nicht nach 100 ms — und meldete danach `context deadline exceeded`. Teste dieses Zusammenspiel für deinen gewählten Treiber und setze beide Limits bewusst.
Wiederhole vollständige idempotente Transaktionen, nicht beliebige Statements mitten in einer Transaktion. Nutze begrenzten exponentiellen Backoff mit Jitter und wenigen Versuchen. Constraints, Syntaxfehler, Corruption oder volle Datenträger dürfen nie wie Lock Contention behandelt werden.
## Warum bricht `:memory:` Tests mit einem Pool?
Jede Connection mit dem Literal `:memory:` bekommt eine eigene private Datenbank. Ein Test erstellt eine Tabelle, der Pool öffnet eine weitere Connection, und die nächste Query meldet `no such table`.
Nutze eine benannte Shared-Memory-URI, wenn mehrere Pool-Connections dieselbe Testdatenbank sehen müssen:
```text
file:testdb?mode=memory&cache=shared
```
Die Datenbank verschwindet, wenn die letzte Connection schließt. Halte mindestens eine Idle Connection offen — oder nutze eine temporäre Datei und teste den realen Locking-Pfad. Dateibasierte Tests finden WAL- und Permission-Fehler, die eine In-Memory-Datenbank nicht reproduziert.
## Wie sicherst du eine laufende WAL-Datenbank?
`app.db` allein zu kopieren ist kein Backup. Commitete Transaktionen können ausschließlich in `app.db-wal` liegen. SQLite behandelt das WAL ausdrücklich als Teil des persistenten Zustands.
Nutze einen von zwei datenbankbewussten Wegen:
- **Online Backup API:** Kopiert einen konsistenten Snapshot inkrementell und gibt den Read Lock der Quelle zwischen Batches frei. Alle drei Treiber bieten einen Zugang zur Backup API, aber über unterschiedliche Go-APIs.
- **`VACUUM INTO`:** Schreibt einen kompakten Snapshot in eine neue Datei. Das ist für geplante Backups einfach, erledigt die Arbeit aber als eine Operation.
Ein Production-Backup-Job sollte außerdem:
1. in einen neuen Pfad auf demselben zuverlässigen lokalen Dateisystem schreiben,
2. die fertige Datei in unabhängigen Storage verschieben,
3. das Backup separat öffnen und `PRAGMA integrity_check` ausführen,
4. Dauer, Bytes und SQLite-Version aufzeichnen,
5. eine Wiederherstellung automatisiert testen.
Ein ungetestetes Backup ist nur eine optimistische Dateikopie.
## Was solltest du beobachten?
Beginne mit `db.Stats()`:
- `OpenConnections`, `InUse` und `Idle`,
- `WaitCount` und `WaitDuration`,
- Query- und Transaktionslatenz getrennt nach Reads und Writes,
- `SQLITE_BUSY`, `SQLITE_LOCKED`, `SQLITE_FULL`, `SQLITE_CORRUPT` und I/O-Fehler.
Ergänze SQLite-spezifische Probes:
- Bytes in `app.db`, `app.db-wal` und `app.db-shm`,
- Resultate von `PRAGMA wal_checkpoint(PASSIVE)`: busy, Log Pages und checkpointete Pages,
- regelmäßiges `PRAGMA quick_check`, mit `integrity_check` bei der Backup-Validierung,
- Tiefe und Alter der Writer Queue, falls die Anwendung Writes serialisiert,
- freien Disk Space und Dateisystemlatenz.
Ein wachsendes WAL bei flacher Zahl checkpointeter Pages weist auf lange Reader hin. Steigende `WaitDuration` am Write Handle mit einer Connection weist auf Write Saturation hin. Das sind verschiedene Incidents und sollten unterschiedlich alarmieren.
Nutze `EXPLAIN QUERY PLAN`, bevor du Pool-Größen veränderst. Ein nicht indexierter Scan innerhalb einer Read Transaction kann Checkpoints aushungern; vier schnellere Connections reparieren die Query nicht. Dieselbe Disziplin behandelt der [Leitfaden zur SQL-Query-Optimierung](https://www.alekseialeinikov.com/de/blog/topics/data/sql-query-optimierung-2026-schnellere-datenbank-performance).
## Wann solltest du zu PostgreSQL oder MySQL wechseln?
Die Datenbankgröße allein ist ein schwaches Migrationssignal. SQLite kann große Datenbanken tragen, solange der Zugriff lokal bleibt und der Workload zu einem Writer passt.
Wechsle zu einer Client-Server-Datenbank, wenn eine dieser Eigenschaften zur Produktanforderung wird:
- Mehrere Application Instances müssen dieselbe logische Datenbank beschreiben.
- Die Datenbank muss auf einem Network Filesystem oder gemeinsam beschreibbaren Volume liegen.
- Dauerhafte Write-Nachfrage hält den einzelnen Writer oder seine Queue gesättigt.
- Unabhängige Failure Domains, Managed Failover oder Cross-Region Writes werden benötigt.
- Datenbank-Benutzer, Grants, Auditing oder Operations-Tooling wiegen schwerer als eingebettete Einfachheit.
- Backups und Wartung passen nicht mehr in den Local-Disk-Lifecycle des Services.
Warte nicht darauf, dass Lock Timeouts die Architekturentscheidung treffen. Definiere Schwellen für Writer-Queue-Alter, Busy Rate, Restore-Ziele und Availability — und migriere, solange beide Systeme gesund sind.
Wenn daraus die Frage PostgreSQL gegen MySQL wird, trennt der [Vergleich für 2026](https://www.alekseialeinikov.com/de/blog/topics/data/postgres-vs-mysql-2026-vergleich) ihre operativen und SQL-Trade-offs. Wenn du Go-Prozessdichte rund um eine eingebettete Datenbank planst, erklärt die [Untersuchung der Go-Runtime-Threads](https://www.alekseialeinikov.com/de/blog/topics/programming/wie-viele-threads-nutzt-go-wirklich-runtime-untersuchung-2026), warum Connection Count nicht der einzige versteckte Concurrency-Preis ist.
## Das Fazit
SQLite ist eine starke Production-Datenbank für einen Go-Service, der einen Host, ein langlebiges Dateisystem und einen serialisierten Schreibpfad besitzt. WAL gibt ihr hervorragende Read Concurrency. `database/sql` gibt ihr eine robuste Go-API. Keines von beiden entfernt die Notwendigkeit, um einen Writer herum zu entwerfen.
Wähle den Treiber passend zu deiner Release-Pipeline. Konfiguriere jede physische Connection. Begrenze den Pool. Beanspruche Write Intent früh, verlasse Transaktionen schnell, beobachte Checkpoints und sichere über SQLite selbst.
Das ist der Unterschied zwischen „einer Datei, die in Development zufällig funktioniert hat“ und einer bewusst betriebenen eingebetteten Datenbank.