ollama run llama3 bringt in rund dreißig Sekunden ein antwortendes Modell — auf einem Laptop, ohne jede Konfiguration. Das ist 2026 eine bemerkenswerte Sache, die man über ein großes Sprachmodell sagen kann, und gleichzeitig für eine andere Frage völlig irrelevant: Was passiert, wenn 200 Menschen dasselbe Modell gleichzeitig anfragen?
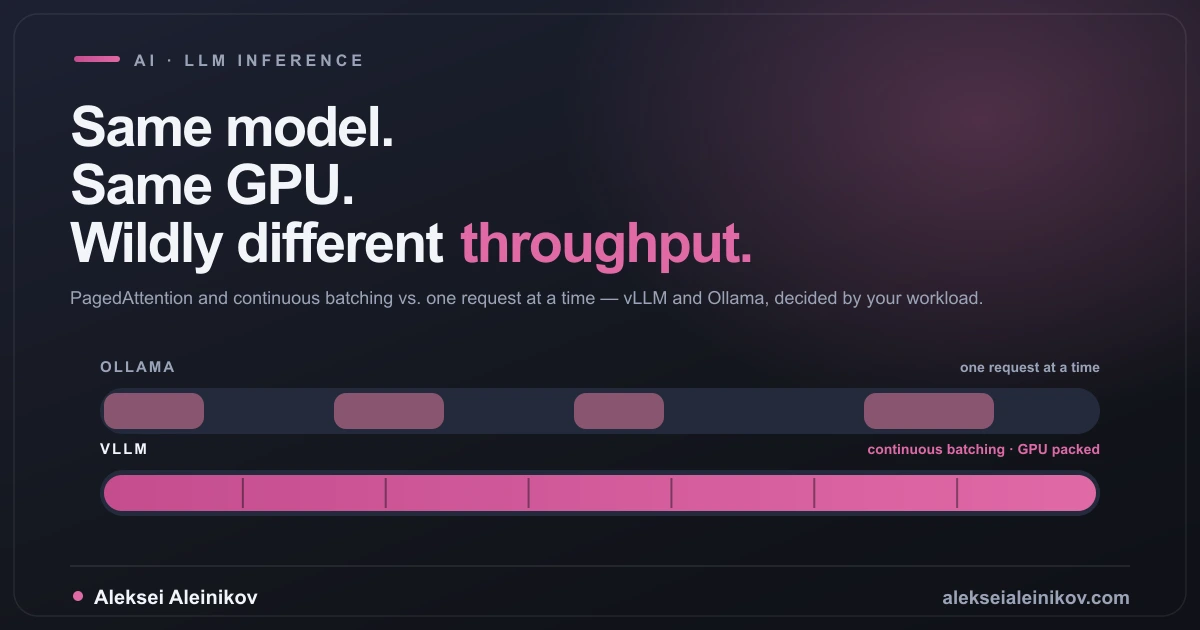
Das sind zwei verschiedene Engineering-Probleme, und die meisten “vLLM vs. Ollama”-Inhalte werfen sie in einen Topf, als würden beide Projekte um denselben Job konkurrieren. Tun sie nicht. Dieser Artikel behandelt, worauf jedes der beiden tatsächlich optimiert ist, die zwei Ideen — PagedAttention und Continuous Batching —, die die gesamte Performance-Lücke unter Last erklären, und eine klare Antwort darauf, welches Sie für die Last brauchen, die Sie tatsächlich haben.
Was Ollama wirklich ist
Ollama ist eine schlanke, gut gestaltete Betriebsschicht über llama.cpp — Georgi Gerganovs C/C++-Inferenz-Engine, dieselbe Engine, die das Ausführen von LLaMA-Familien-Modellen auf gewöhnlichen Laptops überhaupt erst praktikabel gemacht hat. Ollama fügt die Teile hinzu, die es wie ein fertiges Produkt statt ein Forschungsprojekt wirken lassen: eine CLI (ollama run llama3), eine REST-API, eine Modellbibliothek vorquantisierter GGUF-Dateien, die per Name gezogen werden können, und ein Modelfile-Format zum Anpassen von Prompts und Parametern.
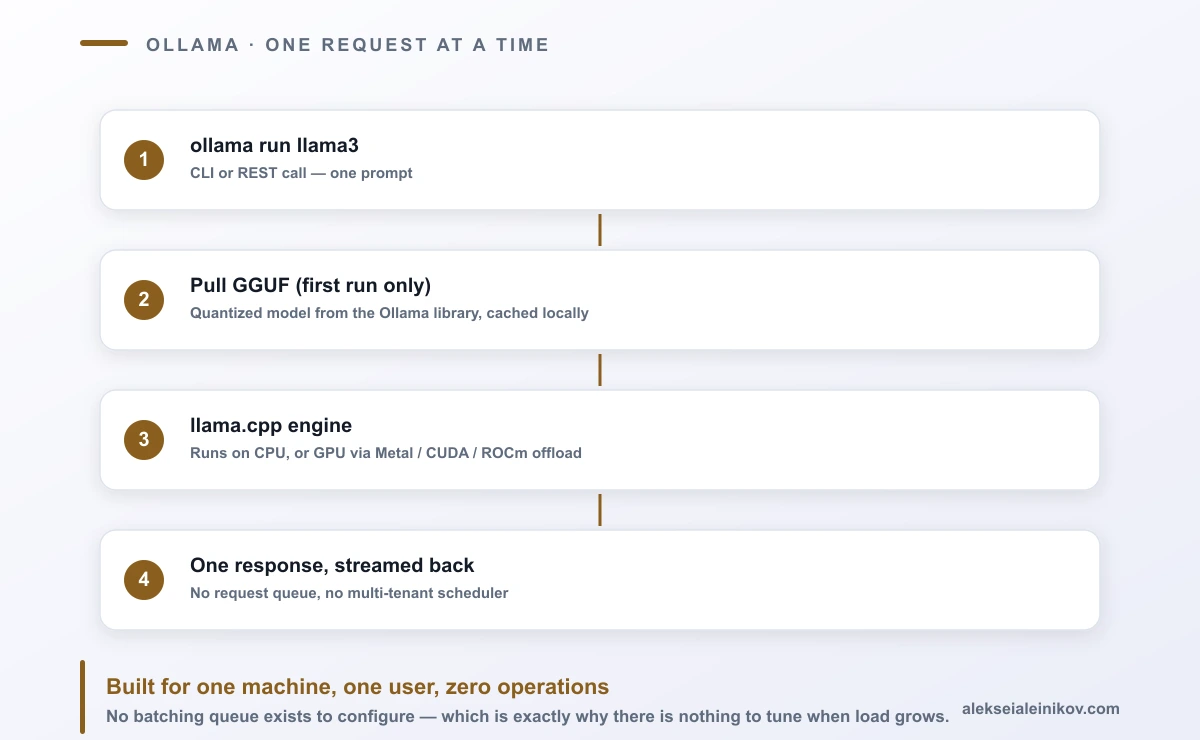
Diese Einfachheit ist der ganze Sinn der Sache, keine Einschränkung, für die man sich entschuldigen müsste. llama.cpp kann so viele Transformer-Layer wie möglich auf die GPU auslagern (Metal auf Apple Silicon, CUDA, ROCm, Vulkan) und den Rest auf der CPU ausführen — deshalb läuft Ollama akzeptabel auf Hardware, die eigentlich gar kein modernes LLM ausführen sollte. Es wurde für eine Maschine, einen Nutzer zur Zeit entworfen, und diese Aufgabe erledigt es besser als fast alles andere Verfügbare.
Wofür es nicht entworfen wurde, ist ein Anfrage-Scheduler. Ollama reiht gleichzeitige Anfragen durchaus in eine Warteschlange ein, aber es gibt keinen Mechanismus vergleichbar mit dem, was als Nächstes beschrieben wird — kein Iteration-Level-Batching, keinen zweckgebauten Speichermanager für viele gleichzeitige KV-Caches. Das ist kein Fehler; das gesamte Design-Briefing lautete “ein Modell mit praktisch keinem Setup laufen lassen”, und jede dieser Entscheidungen ist für genau dieses Briefing richtig.
Was vLLM wirklich ist
vLLM stammt aus einem Forschungspapier, nicht aus einer Produkt-Roadmap: “Efficient Memory Management for Large Language Model Serving with PagedAttention” (Kwon et al., UC Berkeley, veröffentlicht auf der SOSP 2023). Die Kernaussage des Papers — 2- bis 4-fach höherer Durchsatz als damals verfügbare Serving-Systeme wie FasterTransformer und Orca, bei gleicher Latenz — kam aus der Lösung eines konkreten, unglamourösen Problems: GPU-Speicher wurde für den KV-Cache verschwendet.
PagedAttention ist die Lösung. Jedes generierte Token braucht den Aufmerksamkeitsmechanismus, um auf einen wachsenden Cache von Key/Value-Tensoren für alles bisher Generierte zurückzugreifen. Naives Serving reserviert pro Anfrage einen zusammenhängenden Speicherblock, dimensioniert für den schlechtesten Fall — das heißt, Speicher bleibt ungenutzt, sobald die tatsächliche Ausgabe kürzer ist, und dieser ungenutzte Speicher kann keiner anderen Anfrage zugewiesen werden, ohne alles anzuhalten und neu zu ordnen. PagedAttention übernimmt die Idee direkt aus dem virtuellen Speicher von Betriebssystemen: den KV-Cache in kleine, feste Blöcke aufteilen, sie bei Bedarf zuweisen und indirekt über eine Blocktabelle referenzieren. Die Verschwendung schrumpft auf nahezu null, und — ein Nebeneffekt, der etwa bei parallelem Sampling oder Beam Search zählt — identische Präfixe über mehrere Anfragen hinweg können sich per Copy-on-Write dieselben physischen Blöcke teilen.
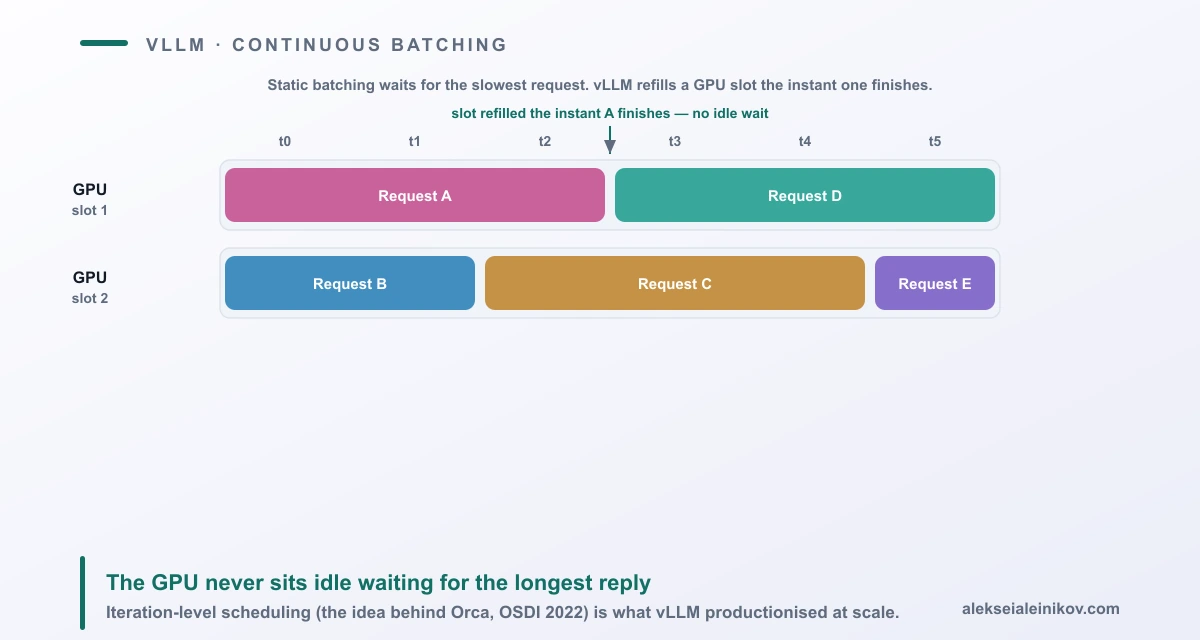
Das zweite Element ist Continuous Batching — manchmal Iteration-Level-Scheduling genannt, eine Idee, die Orca (Yu et al., OSDI 2022) einführte, bevor vLLM sie im großen Maßstab produktionsreif machte. Ältere Serving-Systeme bilden einen Batch, führen jede Anfrage darin bis zum Abschluss aus und starten erst danach den nächsten Batch — eine einzelne lang laufende Anfrage hält damit den gesamten GPU-Batch als Geisel, während kürzere Anfragen fertig sind und ihre Slots leer bleiben. Continuous Batching plant auf Ebene einzelner Generierungsschritte: Sobald eine Sequenz in einem Batch fertig ist, wird ihr Slot in der nächsten Iteration sofort der nächsten wartenden Anfrage übergeben. Die GPU bleibt ausgelastet, statt auf Nachzügler zu warten.
Kombiniert man beides, lautet das Ergebnis nicht “vLLM macht das Modell klüger oder pro Token schneller” — sondern “vLLM hält deutlich mehr gleichzeitige Anfragen auf derselben Hardware in Bearbeitung, mit weniger verschwendetem Speicher und weniger GPU-Leerlauf.” Das ist eine Durchsatz-Geschichte, und das ist der gesamte Grund, warum es vLLM gibt.
Erste Schritte mit beiden
Keines von beiden braucht mehr als ein paar Minuten zum Ausprobieren, und beide nebeneinander laufen zu lassen ist der schnellste Weg, den Unterschied aus diesem Artikel selbst zu spüren statt nur darüber zu lesen.
Ollama — bereits oben gezeigt, ein Befehl zieht ein quantisiertes Modell und startet es:
ollama pull llama3ollama run llama3 "Erkläre PagedAttention in einem Satz"vLLM bringt von Haus aus einen OpenAI-kompatiblen API-Server mit:
pip install vllmvllm serve mistralai/Mistral-7B-Instruct-v0.2# jetzt POST an http://localhost:8000/v1/chat/completionsSchon dieser einzelne vllm serve-Befehl liefert Continuous Batching und PagedAttention mit — es gibt kein separates Flag, um sie einzuschalten; sie sind der Standard-Anfragepfad der Engine, kein Opt-in-Modus. Wer das Ergebnis in Agenten-Tooling einbindet — MCP-Server oder einen Coding-Assistenten wie die in KI-Coding-Agents 2026 verglichenen — profitiert genau von diesem OpenAI-kompatiblen Endpunkt: Er macht beide Engines zu einem Drop-in-Ersatz für eine gehostete API, ohne Client-Code anzufassen.
Der eigentliche Trade-off
Keine der beiden Engines ist “besser”. Sie sind für unterschiedliche Punkte auf derselben Kurve optimiert, und die Entscheidung läuft auf eine Frage hinaus: Ist Ihr Engpass die Anzahl gleichzeitiger Anfragen, oder die operative Komplexität, eine GPU-Flotte zu betreiben?
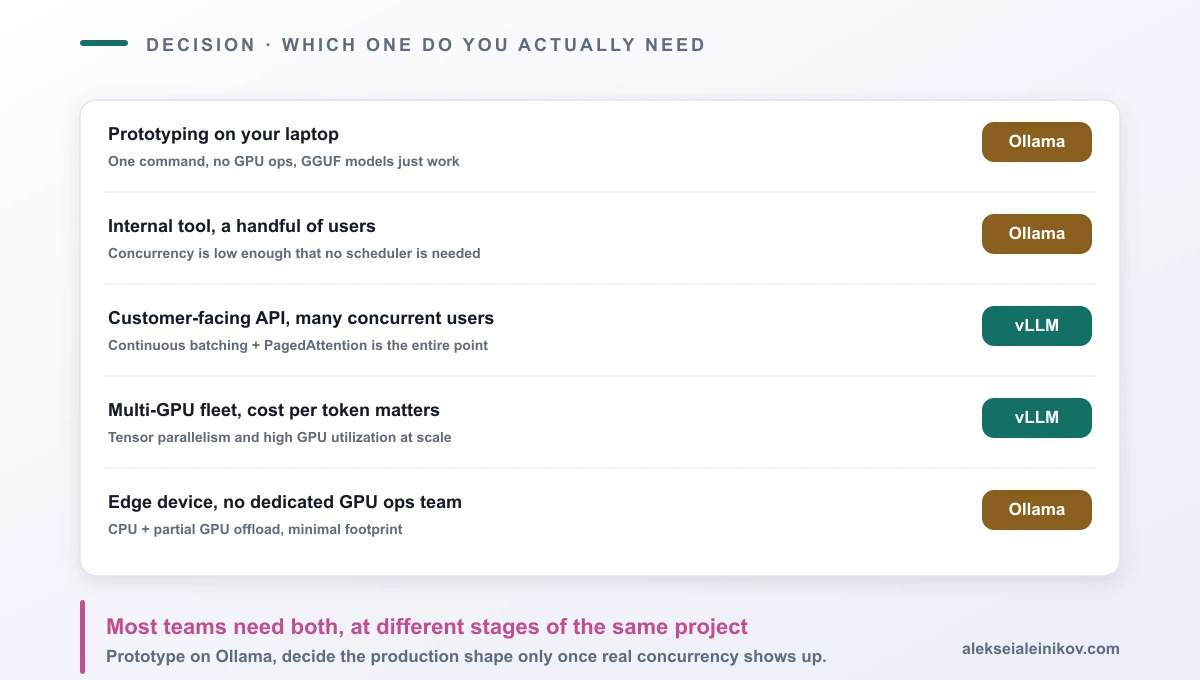
- Prototyping und interne Tools mit einer Handvoll Nutzer — Ollama gewinnt allein durch den Setup-Aufwand. Es gibt praktisch kein Konkurrenzverhalten zu managen, also gibt es auch kein Batching-Verhalten, über das man nachdenken müsste.
- Eine kundenseitige API mit vielen gleichzeitigen Nutzern — genau für dieses Szenario existieren PagedAttention und Continuous Batching. Die Lücke zwischen beiden Engines wächst mit steigender Nebenläufigkeit; bei einer Anfrage ist sie kaum sichtbar, bei fünfzig groß.
- Eine Multi-GPU-Flotte, bei der die Kosten pro Token zählen — vLLM unterstützt Tensor- und Pipeline-Parallelismus, um ein großes Modell über mehrere GPUs zu verteilen, oft auf einem verwalteten Kubernetes-GPU-Node-Pool (siehe GKE Autopilot vs. Standard dafür, wie sich diese Scheduling-Entscheidung speziell bei GPU-Workloads auswirkt), und höhere erreichbare GPU-Auslastung bedeutet direkt weniger benötigte GPUs für dieselbe Last.
- Edge-Geräte oder Umgebungen ohne dediziertes GPU-Ops-Team — Ollamas Flexibilität beim CPU/GPU-Split und der geringe Footprint sind hier die richtige Wahl; vLLMs Wertversprechen setzt GPU-Infrastruktur voraus, die aktiv betrieben wird.
Die Quantisierung ist der Punkt, an dem sich die beiden Projekte auf eine Weise unterscheiden, die man kennen sollte, bevor man sich festlegt. Ollamas GGUF-Modelle (K-Quants wie Q4_K_M) sind für den CPU/GPU-Split-Anwendungsfall gebaut und werden ausführlich in Quantisierung erklärt: 70B-Modell auf normaler Hardware behandelt — die dortige VRAM-Rechnung gilt direkt für die Dimensionierung eines Ollama-Deployments. vLLM setzt stattdessen eher auf GPU-first-Formate wie AWQ und GPTQ, die tendenziell schneller sind, wenn das Modell vollständig in den VRAM passt, plus wachsende FP8-Unterstützung auf neuerer Hardware. Wer plant, ein bisher nur lokal laufendes Modell zu servieren, stößt auf genau diese Formatfrage als eine der ersten Entscheidungen der Migration.
Wer sonst noch in diesem Feld mitspielt
vLLM und Ollama sind die beiden am häufigsten genannten Namen, aber nicht die einzigen Optionen, und es lohnt sich zu wissen, wo die anderen stehen:
- Text Generation Inference (TGI) von Hugging Face zielt mit eigener Continuous-Batching-Implementierung und einem Rust-basierten Serving-Kern auf dieselbe Produktions-Durchsatz-Nische wie vLLM. Eine sinnvolle Wahl, wenn der eigene Stack ohnehin im Hugging-Face-Ökosystem lebt.
- SGLang, aus derselben Forschungslinie wie vLLM, ergänzt strukturierte Generierung und Constrained Decoding auf einem ähnlich optimierten Backend — relevant, wenn die Last stark auf strukturierter Ausgabe oder agentischem Tool-Calling statt offenem Chat liegt.
- LM Studio und llama.cpps eigener mitgelieferter Server liegen näher an Ollamas Nische: lokal-first, auf Einzelnutzer ausgerichtet, wobei LM Studio zusätzlich eine Desktop-GUI mitbringt.
Keine dieser Optionen ändert die zugrunde liegende Entscheidung. Es sind Variationen derselben zwei Pole — optimiert für gleichzeitigen Durchsatz oder optimiert für reibungslose lokale Nutzung —, und die ehrliche Antwort auf “welches von beiden” beginnt damit, ehrlich zu sein, welches der beiden Probleme man tatsächlich hat.
Fazit
ollama run llama3 und ein Produktions-Inference-Endpunkt für 200 Nutzer sind nicht dasselbe Engineering-Problem in anderem Gewand — es sind wirklich unterschiedliche Probleme, und sie zu vermischen ist der Grund, warum “vLLM vs. Ollama”-Debatten so oft aneinander vorbeireden. Ollamas gesamter Wert liegt darin, dass man nicht über Batching, Scheduling oder GPU-Speicherlayout nachdenken muss, und für einen großen Teil der realen Nutzung — Prototyping, interne Tools, kleine Teams, Edge-Deployment — ist das genau der richtige Tausch. vLLMs gesamter Wert liegt darin, dass PagedAttention und Continuous Batching GPU-Speicher und Scheduling zu etwas machen, das man aktiv verwaltet, weil bei echter Nebenläufigkeit genau dort der Durchsatz herkommt.
Die meisten Projekte, die zählen, nutzen am Ende beides — nur nicht gleichzeitig: Ollama, solange man herausfindet, ob das Produkt überhaupt funktioniert, vLLM, sobald gleichzeitige Nutzer das sind, was zwischen einem und der nächsten Größenordnung an Skalierung steht. Die Wahl danach zu treffen, in welcher Phase man tatsächlich ist, statt danach, welcher Name ernsthafter klingt, ist die ganze Entscheidung.
Aus der Community
Diskussion im Fediverse
Antworten von Mastodon und Bluesky — direkt aus dem offenen Netz, ohne Tracking.
Antworten werden geladen …
Noch keine Antworten. Starte die Diskussion:
Antworten konnten gerade nicht geladen werden.