Geerdete, produktionsreife KI — RAG, LLMs und die Daten dahinter.
Das Schwierige an KI in der Produktion ist nicht der Modellaufruf — es ist, dem Modell den richtigen Kontext zu geben und dem Ergebnis zu vertrauen. Ein Sprachmodell ist nur so gut wie die Daten, in denen man es erdet, und Retrieval, Pipelines und Infrastruktur drumherum sind, wo echtes Engineering lebt.
Artikel in diesem Hub
12 Artikel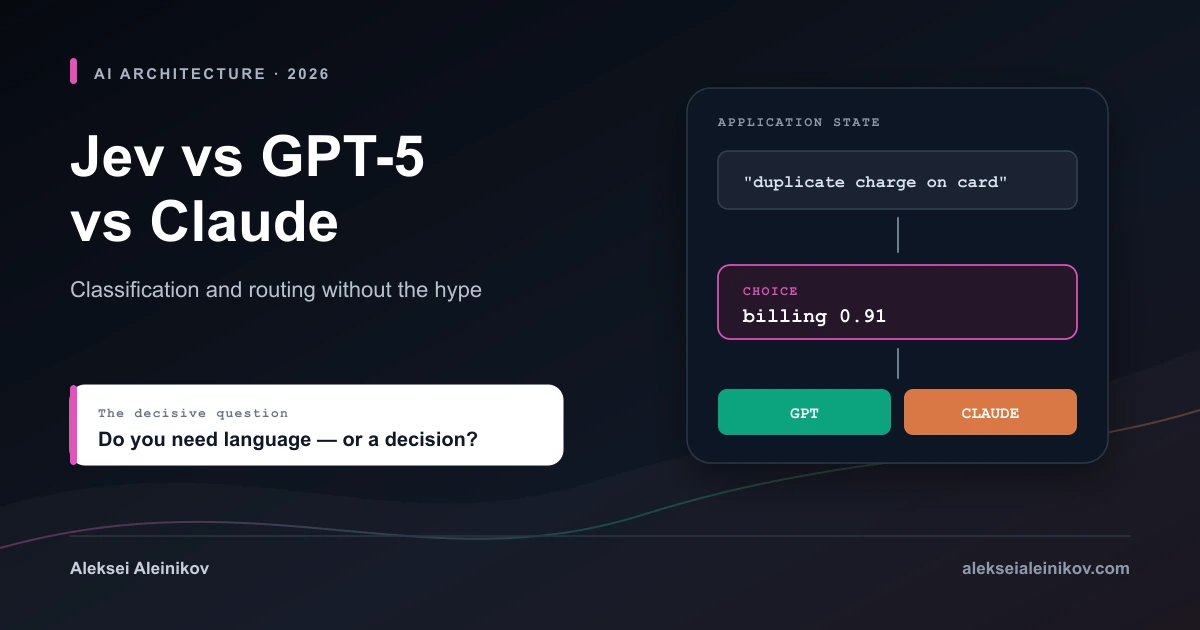 Experten-Level
Jev vs. GPT-5 und Claude für Klassifizierung und Routing
Jev versucht nicht, GPT-5 oder Claude beim Chatten zu schlagen. Das Modell entfernt die Textgenerierung aus einer engeren Aufgabe: typisierte, probabilistische Entscheidungen in Software. Das kann architektonisch stark sein — wenn die Aufgabe wirklich eine Entscheidung ist.
Artikel lesen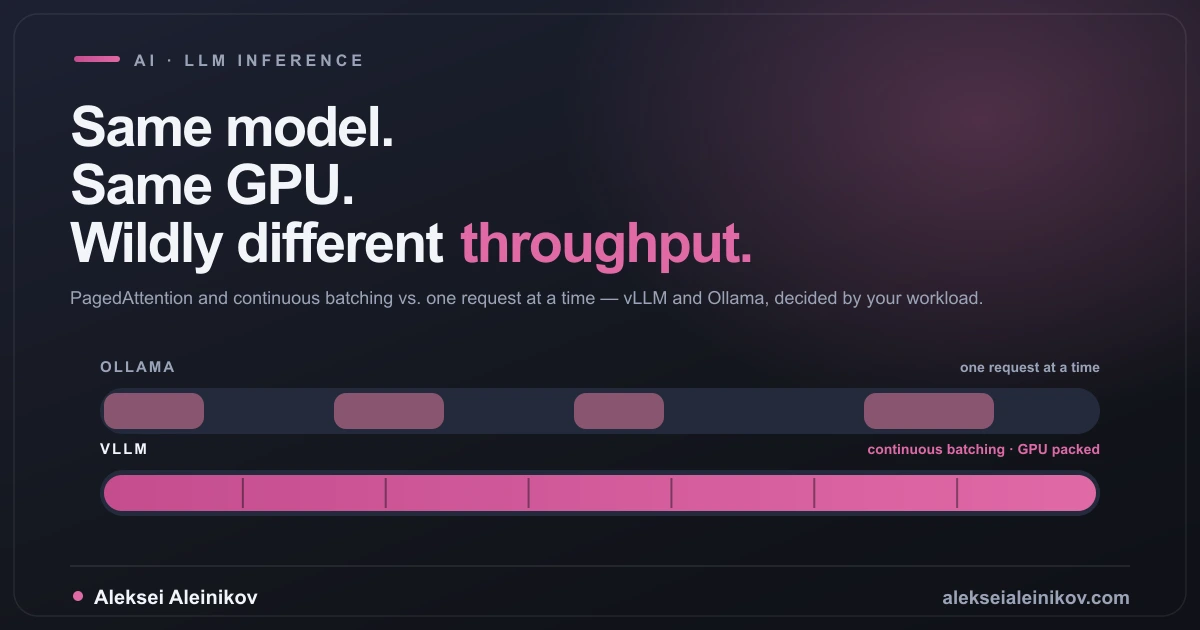 Fortgeschritten
vLLM vs. Ollama: Welchen Inference-Server Sie 2026 wirklich brauchen
ollama run llama3 bringt in dreißig Sekunden ein antwortendes Modell. Dasselbe Modell für 200 gleichzeitige Nutzer bereitzustellen, ohne dass es einbricht, ist ein völlig anderes Engineering-Problem — und vLLM und Ollama lösen es auf entgegengesetzte Weise.
Artikel lesen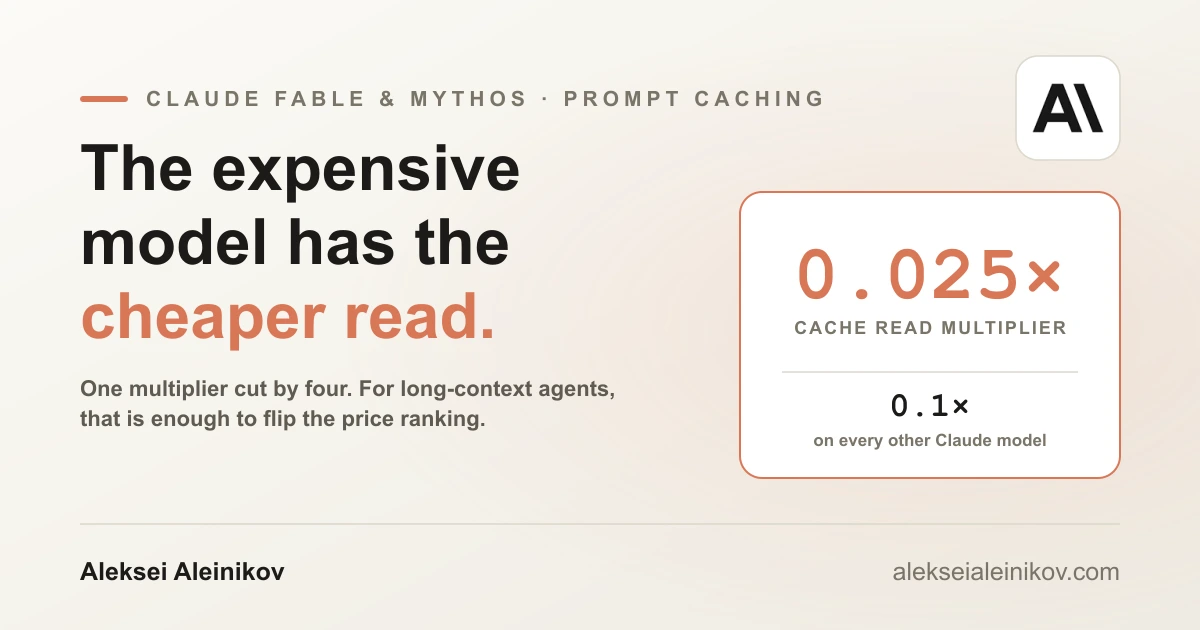 Experten-Level
Claude Fable und Mythos kosten doppelt so viel wie Opus. Für Agenten können sie günstiger sein
Die Fable- und Mythos-Linie hat die günstigsten Cache-Reads und die teuersten Cache-Writes im aktiven Lineup. Diese eine Asymmetrie dreht um, welches Modell für Agenten mit langem Kontext günstiger ist — und macht Ihre Cache-Trefferquote viermal wertvoller als anderswo.
Artikel lesen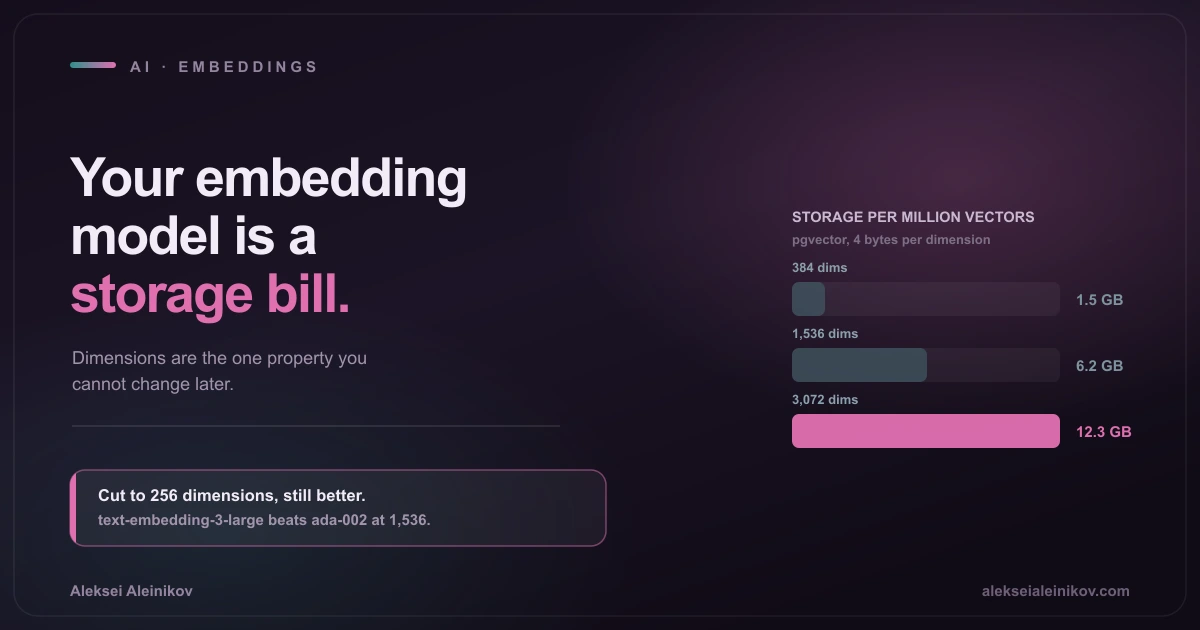 Fortgeschritten
Welches Embedding-Modell? API oder Self-Hosted im Jahr 2026
Die Wahl des Embedding-Modells ist kein API-Aufruf, sondern eine Schema-Entscheidung. Ein praktischer Leitfaden für 2026: Dimensionen als Speicherrechnung, die GPU-Frage, echte API-Preise und die Migration, die niemand einplant.
Artikel lesen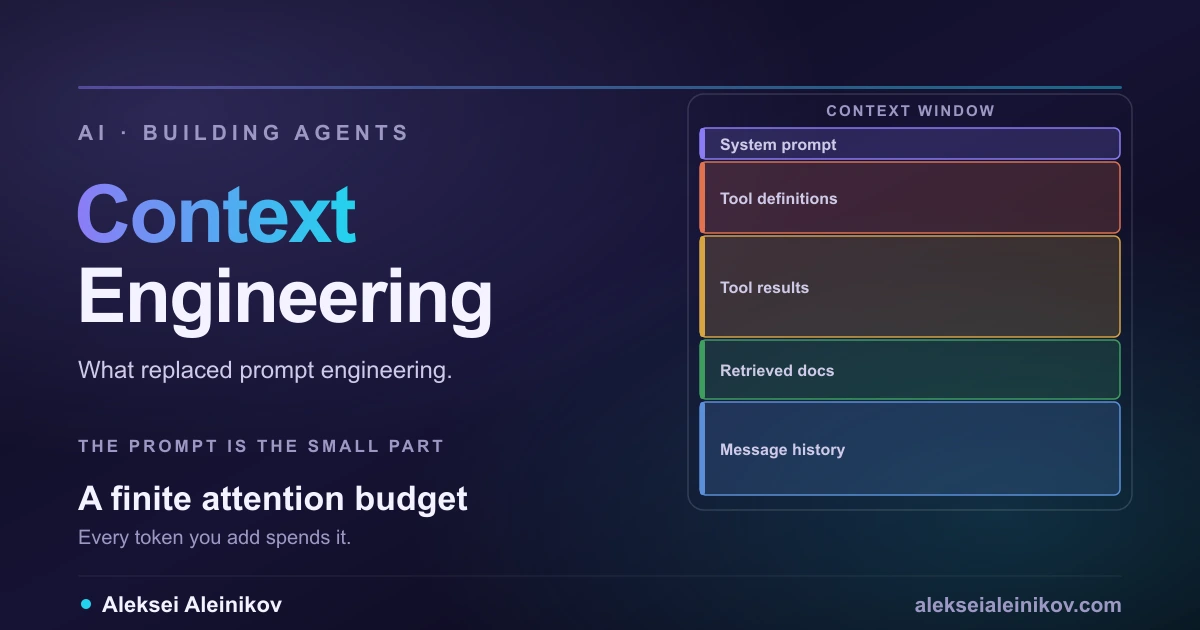 Fortgeschritten
Context Engineering 2026: Was Prompt Engineering abgelöst hat
Dein Prompt ist gut. Dein Agent verliert trotzdem den Faden. Context Engineering behandelt das Kontextfenster als endliches Budget — was hineingehört, warum größere Fenster nichts lösen und welche drei Techniken helfen.
Artikel lesen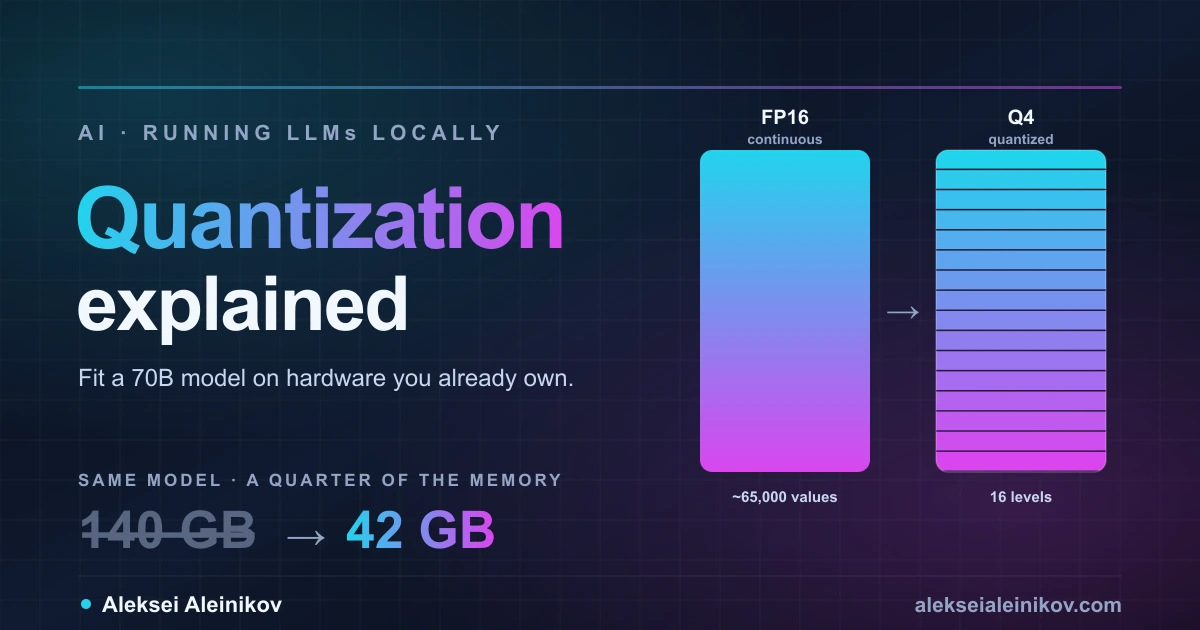 Fortgeschritten
Quantisierung erklärt: Wie man ein 70B-Modell auf normaler Hardware betreibt
Ein 70B-Modell braucht in voller Präzision 140 GB VRAM — bis man es quantisiert. Ein praxisnaher Leitfaden zu GGUF, K-Quants, Q4 vs. Q8, dem tatsächlichen Qualitätsverlust und dem genauen VRAM-Bedarf.
Artikel lesen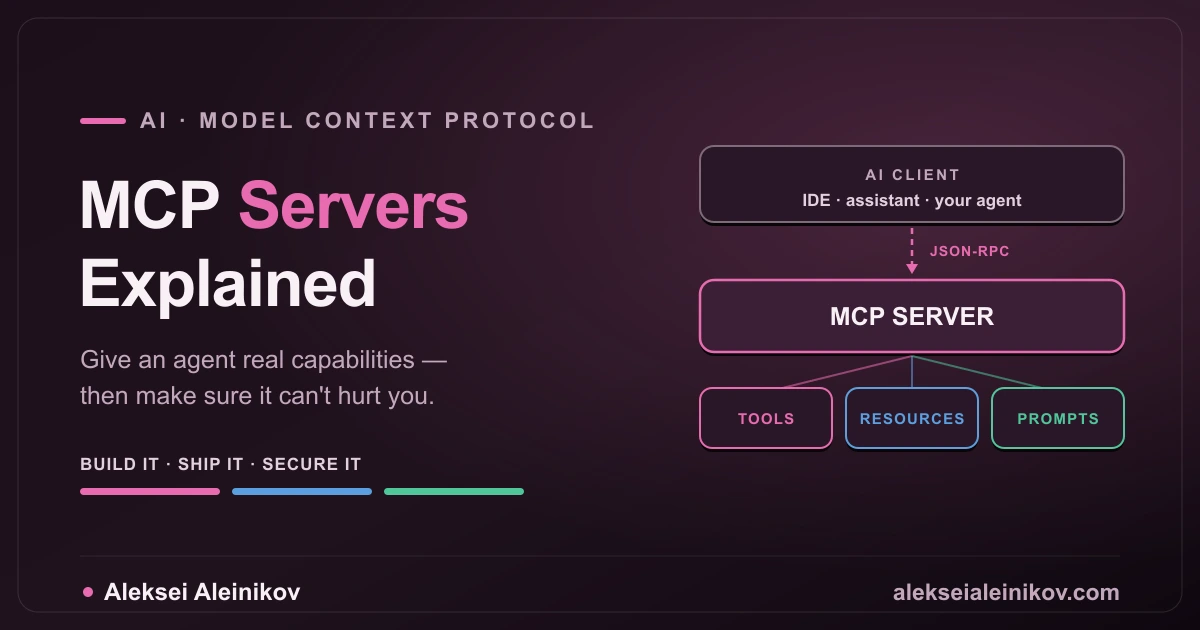 Einsteiger
MCP-Server erklärt: selbst bauen und sicher betreiben
Ein MCP-Server ist der Weg, einem KI-Agenten echte Fähigkeiten zu geben — sicher. Ein praktischer Leitfaden für 2026: was das Protokoll wirklich ist, wie man einen Server baut, was im Produktivbetrieb bricht und welche Sicherheitsregeln nicht verhandelbar sind.
Artikel lesen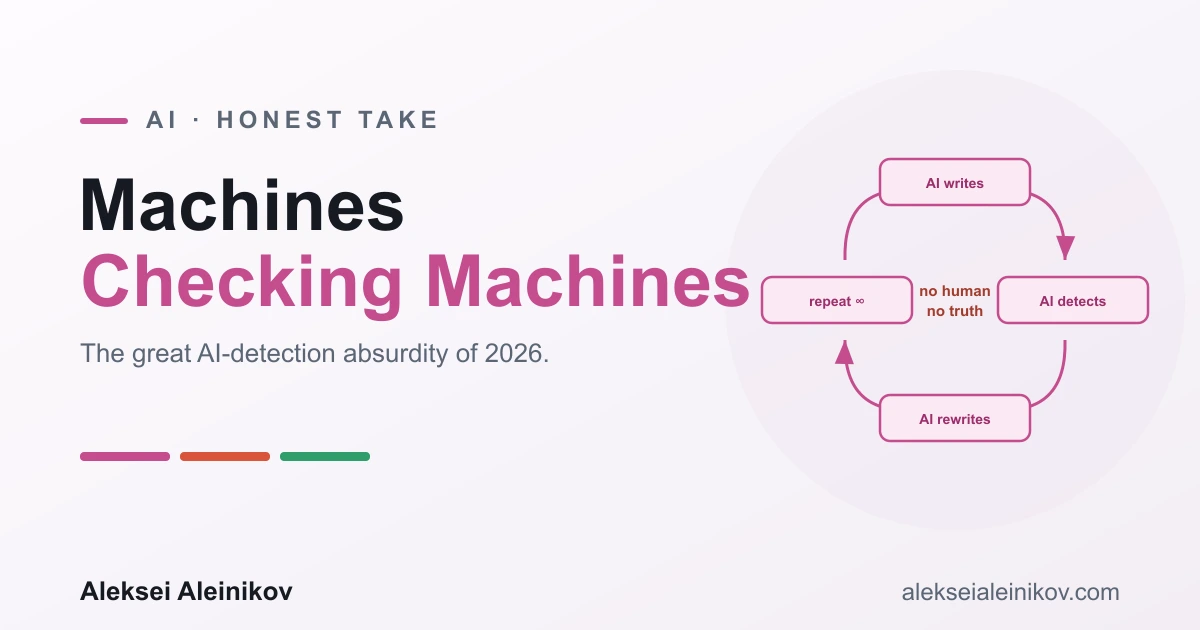 Einsteiger
Maschinen, die Maschinen prüfen: Die große KI-Erkennungs-Absurdität von 2026
Redakteure jagen Texte durch KI-Detektoren, Recruiter screenen KI-geschriebene Lebensläufe mit KI, Unis beschuldigen ehrliche Studierende fälschlich, und bezahlte 'Humanizer' schreiben KI um, um KI-Detektoren zu täuschen. Ein ehrlicher Ingenieurs-Blick auf die absurde Ökonomie von Maschinen, die Maschinen prüfen — warum KI-Texterkennung technisch unzuverlässig ist, wem sie schadet und was man stattdessen messen sollte.
Artikel lesen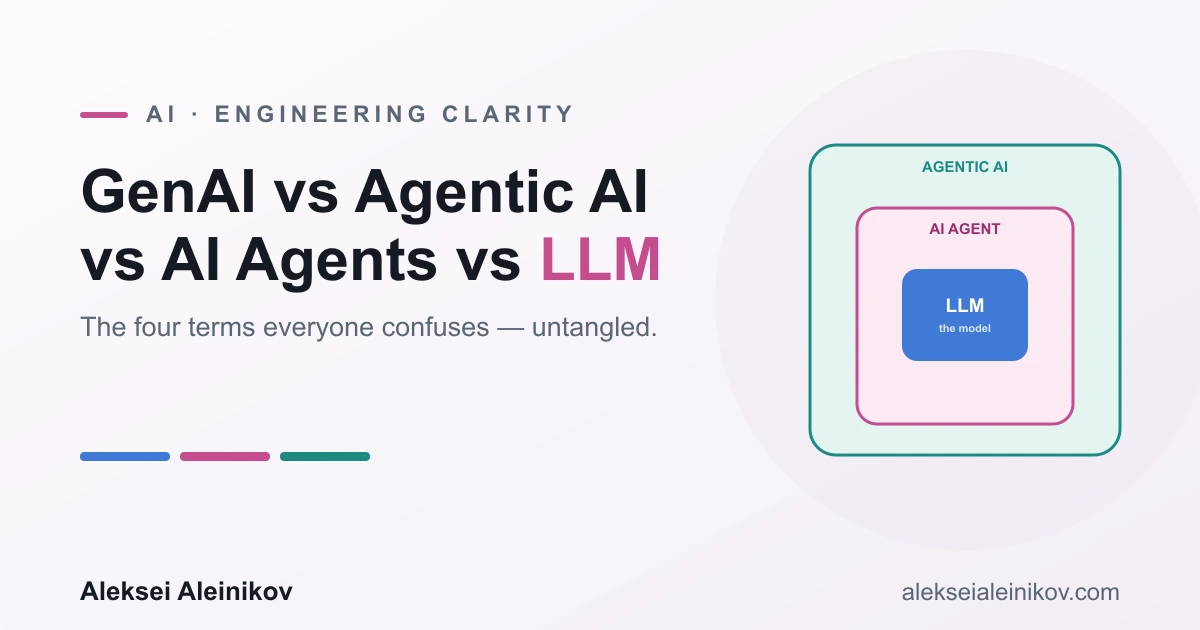 Einsteiger
GenAI vs. Agentic AI vs. KI-Agenten vs. LLM: Was ist der echte Unterschied?
GenAI vs. Agentic AI vs. KI-Agenten vs. LLM — die vier Begriffe, die alle synonym verwenden, von einem Ingenieur erklärt. Was jeder wirklich ist, wie sie ineinander verschachtelt sind, warum GenAI und 'agentic' auf verschiedenen Achsen liegen — mit Vergleichstabelle und Entscheidungshilfe.
Artikel lesen Fortgeschritten
KI-Coding-Agents 2026: Claude Code vs Codex vs opencode
Ein anbieterneutraler Vergleich der drei KI-Coding-Agents, die 2026 zählen — Claude Code, Codex und opencode: wie die Agent-Schleife funktioniert, wofür jeder passt, eine Entscheidungstabelle und wie man sie betreibt, ohne die Schlüssel abzugeben.
Artikel lesen Fortgeschritten
KI im Browser 2026: Modelle mit WebGPU und LiteRT.js on-device ausführen
KI-Modelle direkt im Browser auszuführen ist endlich schnell genug, um real zu sein. Ein praktischer Leitfaden 2026 für On-Device-Inferenz mit WebGPU und Googles neuem LiteRT.js — was sich geändert hat, wie es funktioniert und wann man es einsetzt.
Artikel lesen Experten-Level
Echtzeit-RAG in Python: Live-Google-Ergebnisse für dein LLM (2026)
Was wäre, wenn deine RAG-Pipeline kurz vor der Antwortgenerierung frischen Web-Kontext abrufen könnte? Eine praktische Anleitung zum Aufbau einer Live-Such-Retrieval-Schicht mit Bright Data SERP API und Python.
Artikel lesen
Häufige Fragen
Welchen KI-Engineering-Hintergrund haben Sie?
Sind Sie verfügbar für eine Zusammenarbeit?
Wie starten wir eine Zusammenarbeit?
KI vom Demo in die Produktion bringen?
Ich baue geerdete RAG-Pipelines und zuverlässige KI-Infrastruktur — die Daten- und MLOps-Schicht, die aus einem Demo ein verlässliches System macht.
KI-Engineering-Leistungen ansehen →