Daten12 ArtikelEN · DE
Datenbanken und Datenplattformen — den richtigen Speicher wählen, schnell halten
Datensysteme versagen leise: Eine Query, die bei tausend Zeilen schnell war, kriecht bei einer Million, und der falsche Speicher kostet über Jahre. Dieser Hub dreht sich um diese Entscheidungen — relational vs. NoSQL vs. Graph vs. Vektor, BigQuery vs. Snowflake vs. Bigtable, Iceberg vs. Delta Lake — dazu SQL-Query-Optimierung und Data Governance auf GCP. Aus Produktiv-Pipelines und Analytics-Workloads im Unternehmensmaßstab.
Hier starten
Ihr Weg durch Daten
Eine kurze Lesereihenfolge – von den Grundlagen bis zur Produktionspraxis.
Artikel in diesem Hub
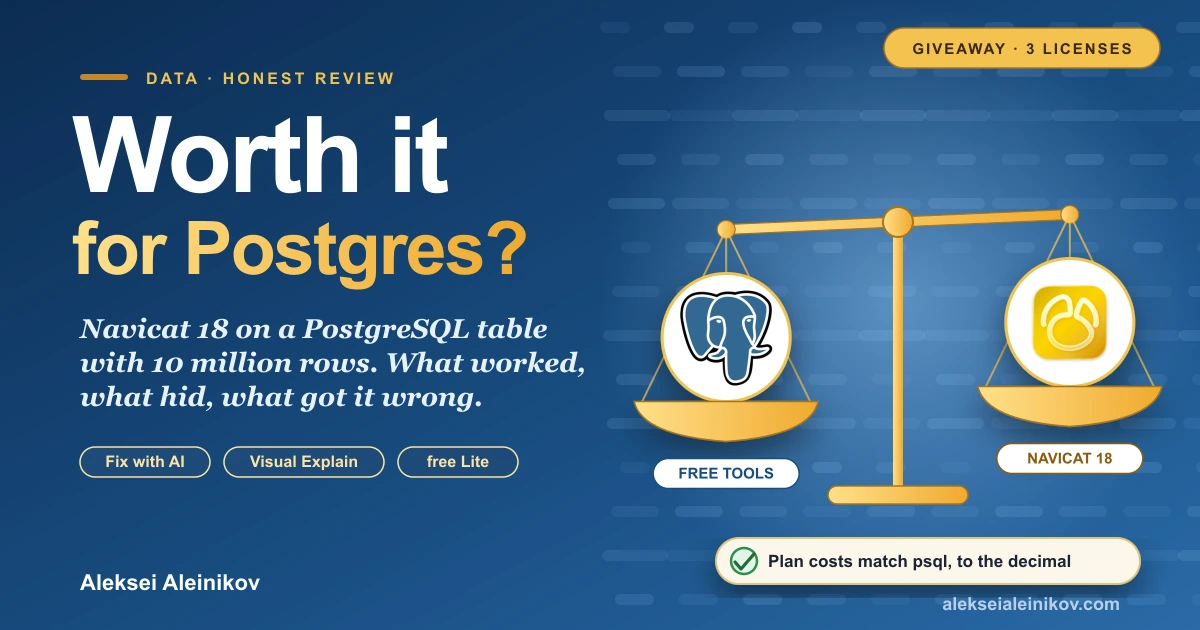
Navicat 18 im Test: Lohnt es sich für PostgreSQL? 10 Mio. Zeilen
Navicat 18 verspricht Code Insight, Refactoring, Data Masking und KI mit Vorschau vor dem Schreiben. Ich habe es an eine PostgreSQL-Tabelle mit 10 Millionen Zeilen gesetzt und notiert, was funktioniert, was versteckt ist und was Aufmerksamkeit braucht.
Artikel lesen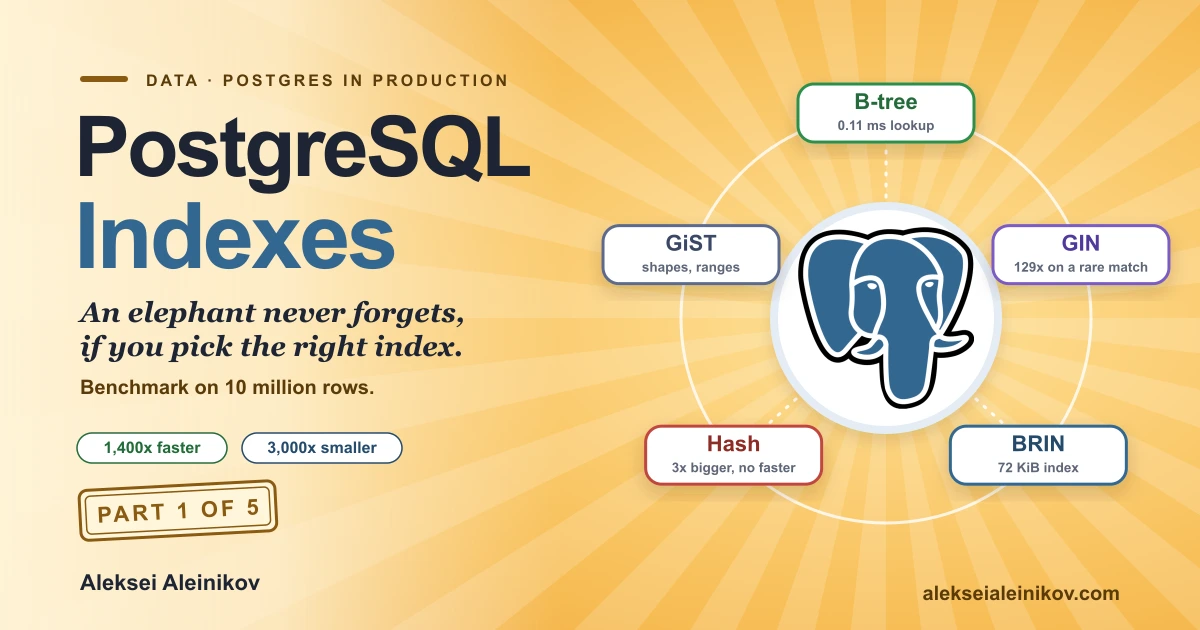
PostgreSQL-Indizes: Welcher Typ wann? (10-Mio-Zeilen-Benchmark)
Ein PostgreSQL-Index ist eine eigene Datenstruktur, mit der die Datenbank Zeilen findet, ohne die ganze Tabelle zu lesen. Welcher Typ wann passt, von B-tree und Hash bis BRIN, GIN sowie partiellen und abdeckenden Indizes, gemessen auf 10 Millionen Zeilen mit PostgreSQL 18.
Artikel lesen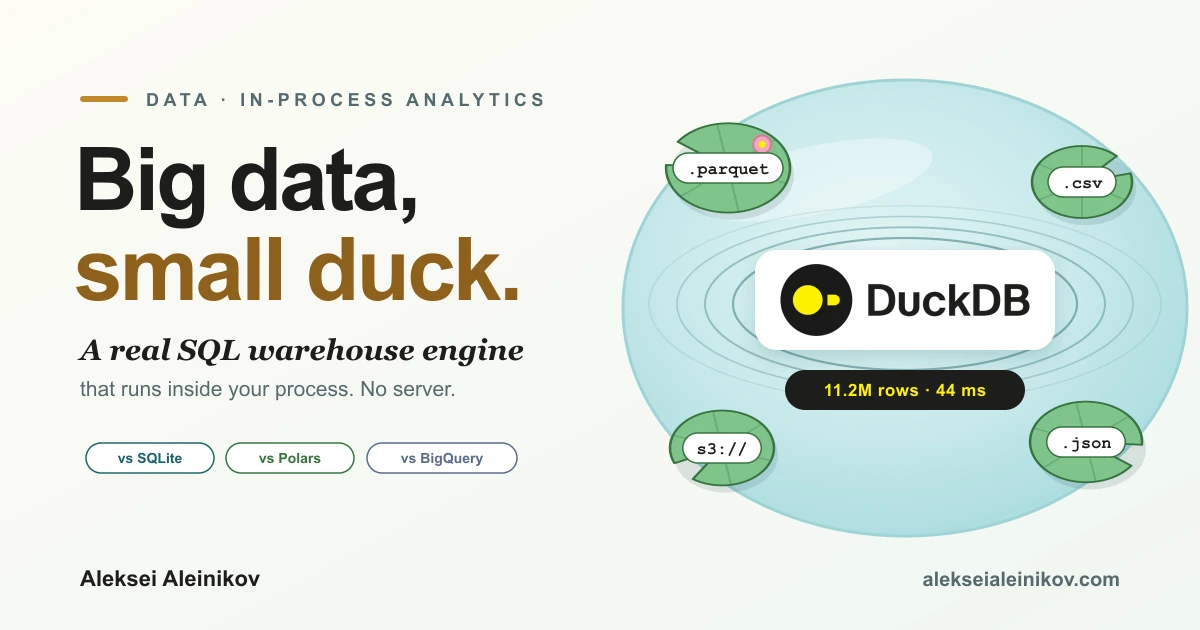
DuckDB erklärt: Wann eine Datenbank auf dem Laptop SQLite, Polars und BigQuery schlägt
DuckDB ist eine In-Process-SQL-Datenbank für Analysen: kein Server, spaltenorientiert, vektorisiert, und sie liest Parquet, CSV und S3 direkt. Was DuckDB ist, ein nachvollziehbarer Benchmark gegen SQLite, pandas und Polars mit 11,2 Millionen Taxifahrten, wo DuckDB BigQuery schlägt und wo nicht, dazu Quack, DuckLake, MotherDuck und DuckDB 2.0.
Artikel lesen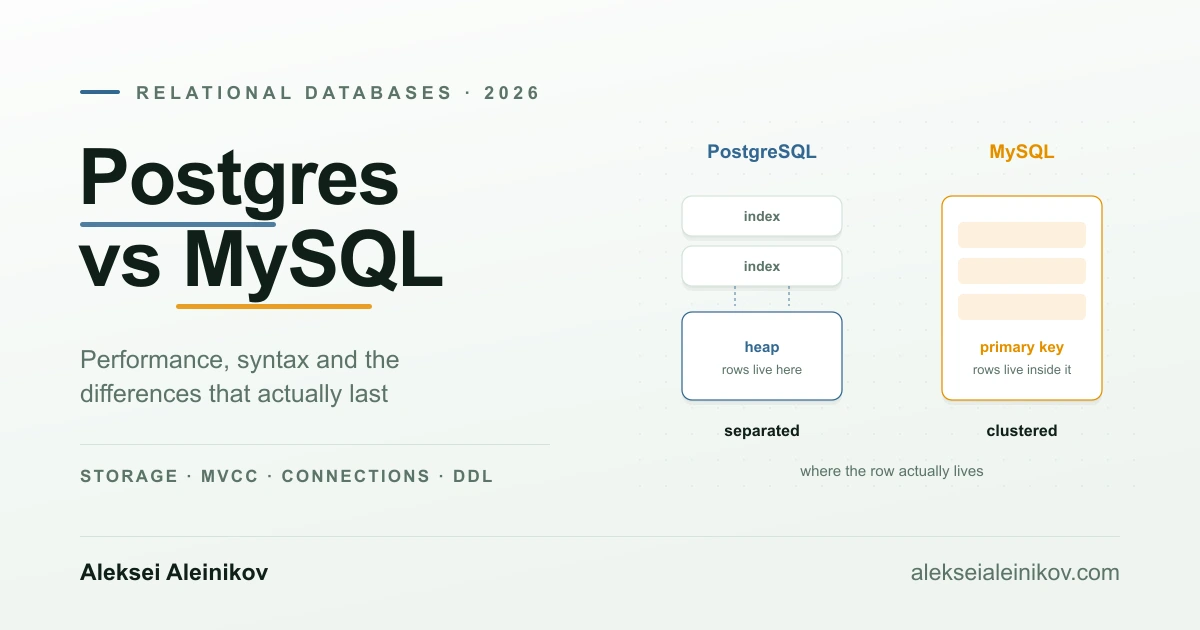
Postgres vs. MySQL 2026: Performance, Syntax und die echten Unterschiede
Worin sich Postgres und MySQL wirklich unterscheiden — Speicherung, MVCC, Verbindungsmodell, SQL-Syntax und Betrieb — plus wo SQLite und MariaDB hingehören und wie man tatsächlich wählt.
Artikel lesen
Iceberg vs. Delta Lake 2026: Ein verständlicher Leitfaden zur Auswahl
Was ein Tabellenformat wirklich ist, worin sich Iceberg und Delta Lake 2026 tatsächlich unterscheiden, und warum die Entscheidung von Ihrem Katalog und Ihrer Query-Engine getroffen wird statt vom Format selbst.
Artikel lesen
Brauchst du eine Graphdatenbank? Was die GA von BigQuery Graph wirklich ändert
BigQuery Graph ist seit dem 1. September 2026 allgemein verfügbar. Bevor Sie irgendetwas als Graph modellieren: der ehrliche Test, ob Sie überhaupt einen brauchen — und die Zeile in der Preisdokumentation, die entscheidet, ob Sie GQL ausführen dürfen.
Artikel lesen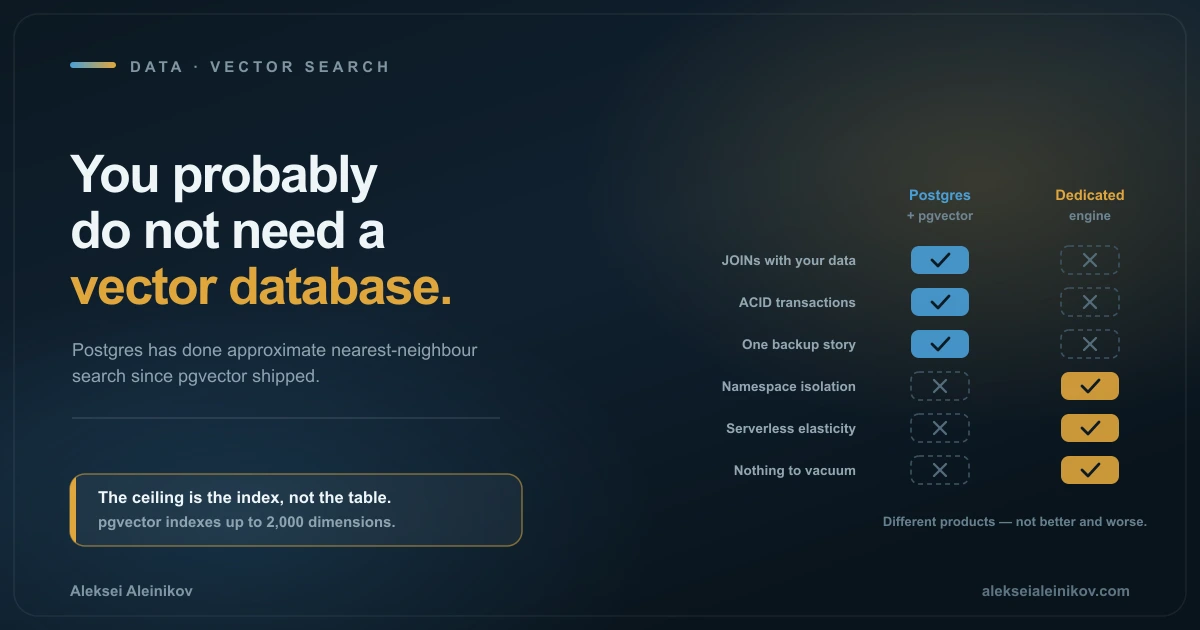
Brauchst du eine Vektordatenbank? Postgres vs. dedizierte Engines 2026
Die meisten Teams, die semantische Suche einbauen, brauchen keine separate Vektordatenbank. Ein praktischer Leitfaden 2026: was pgvector wirklich kann, an welchen vier Mechanismen es scheitert und wofür du bei einer dedizierten Engine tatsächlich bezahlst.
Artikel lesen
SQL vs. NoSQL 2026: Datenbanktypen, ACID vs. BASE und wie man richtig wählt
"SQL vs. NoSQL" ist die falsche erste Frage. Ein praxisnaher Leitfaden 2026 zu Datenbanktypen, was "relational" wirklich bedeutet, ACID vs. BASE und einem Entscheidungsrahmen, der nach Zugriffsmustern wählt — nicht nach Hype.
Artikel lesen
Data Governance auf GCP 2026: Wer darf diese Daten sehen?
Ein praktischer Leitfaden zu Data Governance auf Google Cloud 2026: die vier Fragen, die jedes Programm beantworten muss, und die Dienste, die sie beantworten — Knowledge Catalog (Dataplex), Sensitive Data Protection, BigQuery Policy Tags und VPC Service Controls — mit Vergleichstabelle und Entscheidungshilfe.
Artikel lesen
Cloud Bigtable 2026: Wann Wide-Column BigQuery, Spanner und Cassandra schlägt
Ein praktischer 2026-Leitfaden zu Cloud Bigtable: was Wide-Column-Speicher wirklich ist, wie Bigtable intern funktioniert, wann es BigQuery, Spanner, Cassandra und DynamoDB schlägt, und die eine Entscheidung — das Row-Key-Design — die alles bestimmt.
Artikel lesen
BigQuery vs Snowflake 2026: Ein ehrlicher Vergleich von einem GCP-Engineer
Ein praktischer Vergleich von BigQuery und Snowflake in 2026 ohne Marketing — wie sich Architektur, Abrechnung, Performance und KI wirklich unterscheiden und wie du das richtige Warehouse fuer deinen Workload waehlst.
Artikel lesen
SQL Query Optimization 2026: 7 einfache Techniken fuer schnellere Datenbank-Performance
Sieben praktische SQL-Query-Optimierungstechniken fuer schnellere Datenbank-Performance, mit PostgreSQL-Beispielen fuer JOINs, IN-Listen, EXISTS, Datumsbereiche, Aggregationen und Deduplizierung.
Artikel lesen
Häufige Fragen
Bevor Sie schreiben
Welchen Data-Engineering-Hintergrund haben Sie?
Ich baue produktive Datenpipelines und Analytics-Workloads im großen Maßstab — Query-Optimierung, Managed Messaging und große Datensammlung — gestützt auf über 12 Jahre Platform Engineering in großen Unternehmensumgebungen.
Sind Sie offen für eine Festanstellung?
Ja — ich suche eine unbefristete Festanstellung als Senior Data- oder Platform Engineer in der DACH-Region (Deutschland, Österreich, Schweiz): vor Ort, hybrid oder remote, und bin bereit umzuziehen. Ich arbeite fließend auf Englisch.
Wie kommen wir ins Gespräch?
Schicken Sie mir die Stelle über die Kontaktseite — Daten-Stack, Team und Aufgaben — und ich antworte mit meinem Lebenslauf und meinem Ansatz für die ersten Monate.
Offen für Festanstellung · DACH
Sie suchen einen Senior Data Platform Engineer in der DACH-Region?
Pipelines, Query-Performance und Analytics-Workloads in Produktion im großen Maßstab. Ich suche eine Festanstellung in Deutschland, Österreich oder der Schweiz — und bin bereit umzuziehen.
- Festanstellung, Vollzeit
- Deutschland · Österreich · Schweiz
- Bereit umzuziehen