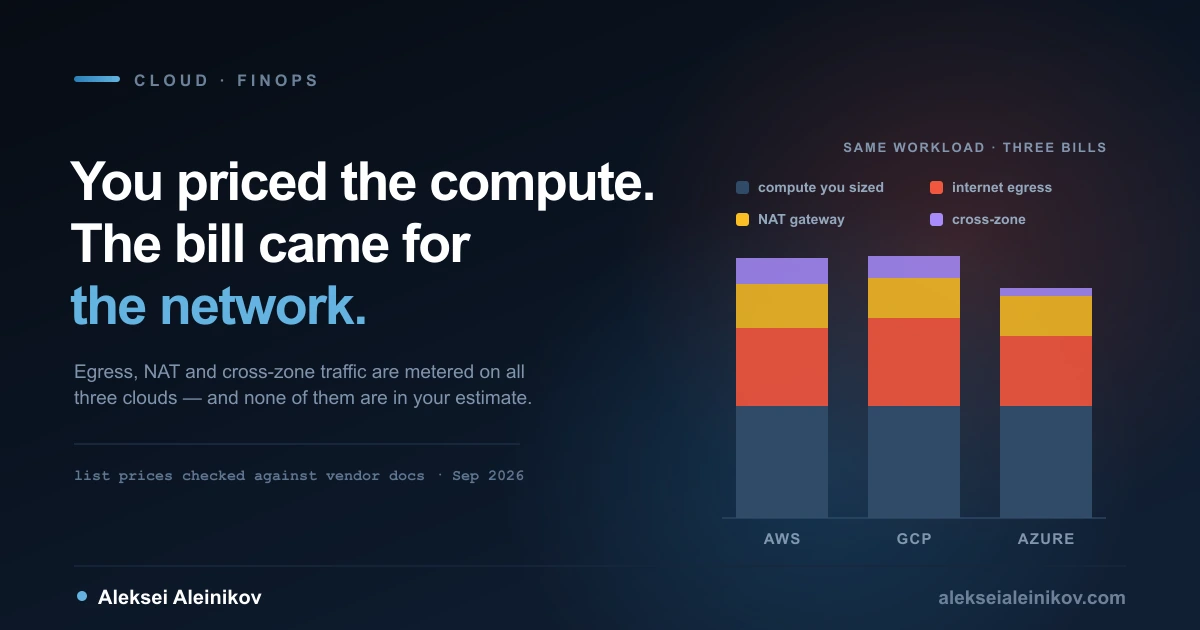
Jede Cloud-Kalkulation beginnt gleich. Jemand öffnet den Preisrechner, wählt einen Instanztyp, multipliziert mit Stunden, multipliziert mit Repliken, addiert einen Sicherheitsaufschlag und präsentiert eine Zahl.
Dann kommt die Rechnung und die Zahl stimmt nicht. Nicht katastrophal daneben — die Compute-Position liegt meist nah dran. Sie stimmt nicht wegen allem, was über der Compute-Position steht, und davon stand fast nichts im Rechner.
Das ist der Teil der Cloud-Kosten, der sich über Anbieter hinweg verallgemeinern lässt. Instanzpreise sind notorisch schwer zu vergleichen — andere Familien, andere Generationen, andere Rabattprogramme. Die Zähler, die Kalkulationen sprengen, sind deutlich vergleichbarer und deutlich konsistenter darin, wie sie Leute erwischen.
Hier steht, was diese Zähler bei AWS, Google Cloud und Azure kosten, entnommen den Preisseiten der Anbieter im September 2026, und in welcher Reihenfolge man vorgehen sollte.
Warum die Kalkulation falsch war
Eine Cloud-Rechnung hat eine Position, die mit deiner Auswahl skaliert, und mehrere, die mit dem Verhalten deines Systems skalieren.
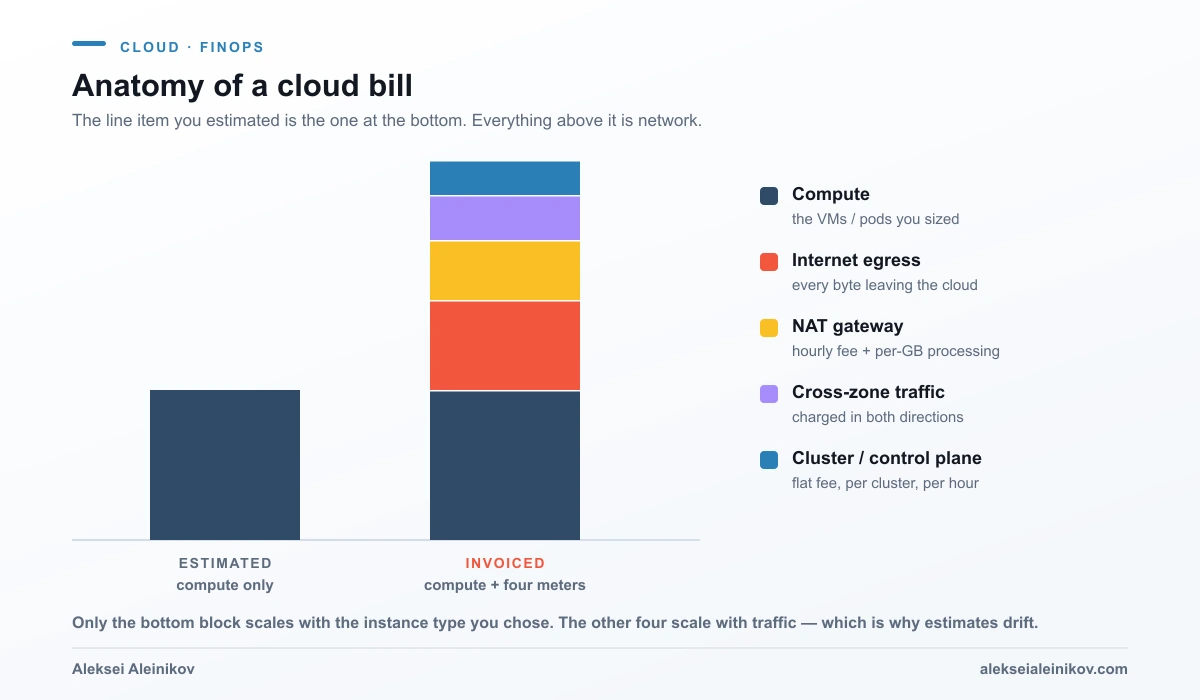
Compute kannst du vorhersagen, weil du es ausgewählt hast. Die anderen vier nicht, denn sie sind Folgen: davon, wo Dienste relativ zueinander liegen, wie gesprächig sie sind, wie viele Daten deine Nutzer ziehen und wie viele Cluster deine Teams angelegt haben, weil das einfacher war als teilen.
Genau deshalb wird aus „Cloud-Kosten senken” so oft „einen Rabatt kaufen”. Der Rabatt greift auf der vorhersagbaren Position. Die unvorhersagbaren brauchen Architekturänderungen — und die machen sich auf einer Folie schlechter.
Die vier Zähler, bepreist
Internet-Egress
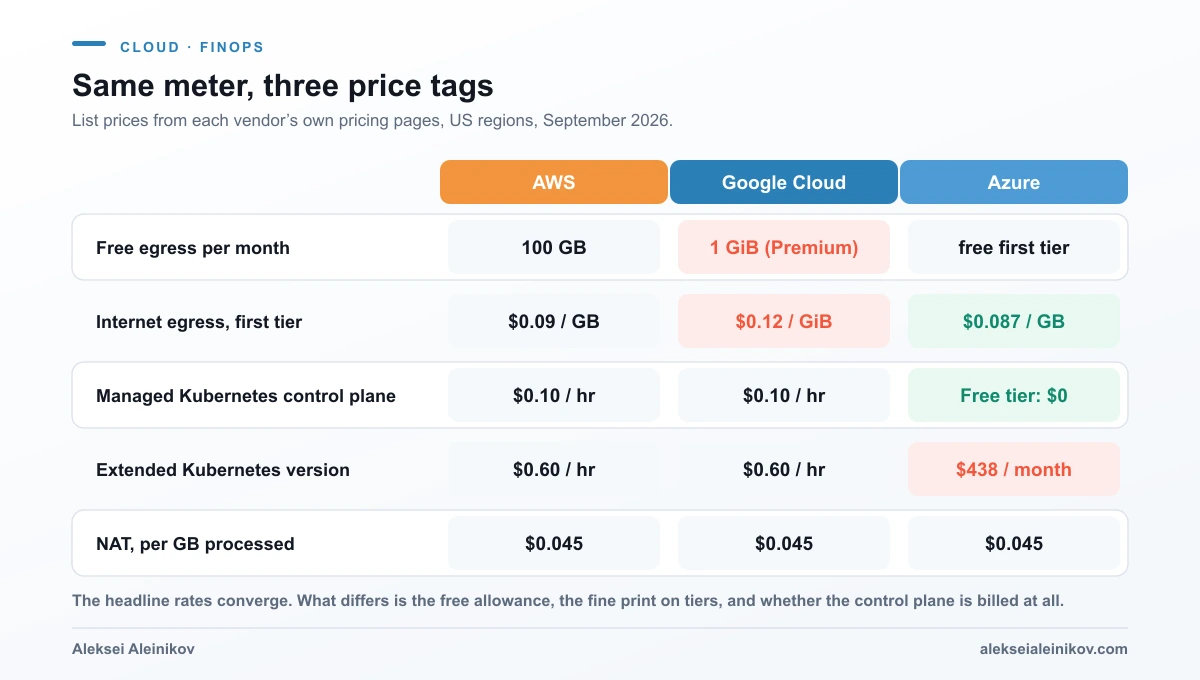
Die Schlagzeilenpreise liegen so eng beieinander, dass sie uninteressant sind. AWS nennt 0,09 $ pro GB für die erste Stufe aus us-east-1. Azure nennt 0,087 $ pro GB aus Nordamerika oder Europa über das Premium Global Network, fallend auf 0,05 $ in der obersten Volumenstufe. Googles Premium Tier liegt bei 0,12 $ pro GiB von 1 GiB bis 1 TiB, 0,11 $ bis 10 TiB und 0,08 $ darüber nach Nordamerika.
Zwei Dinge bewegen die reale Zahl stärker als der Preis.
Erstens das Freikontingent, und hier unterscheiden sie sich wirklich. AWS gibt 100 GB Datentransfer ins Internet pro Monat frei, aggregiert über alle AWS-Services und Regionen außer China und GovCloud. Googles Premium Tier gibt 1 GiB. Azures Preistabelle beginnt mit einer kostenlosen Stufe, bevor der Preis pro GB greift, nennt die Schwelle in dieser Tabelle aber nicht. Wer etwas Kleines betreibt, spürt den Abstand zwischen 100 GB und 1 GiB weit deutlicher als drei Cent pro Gigabyte.
Zweitens die Einheiten. Google rechnet in Gibibyte, AWS und Azure in Gigabyte. Ein Gibibyte sind rund 7,4 % mehr Bytes als ein Gigabyte — die Preise liegen also noch etwas enger beieinander, als sie aussehen, und jede Tabelle, die beides mischt, ist stillschweigend falsch.
Bei zwei von dreien gibt es zudem eine günstigere Tür. Googles Standard Tier kostet 0,085 $ pro GiB statt 0,12 $, und Azures Routing Preference über Transit-ISP kostet 0,08 $ pro GB statt 0,087 $. Beide tauschen das private Backbone des Anbieters gegen das öffentliche Internet. Für Massentransfer, bei dem Latenz egal ist, ist das ein echter Rabatt für eine Konfigurationsänderung. Für nutzernahen Traffic meist nicht.
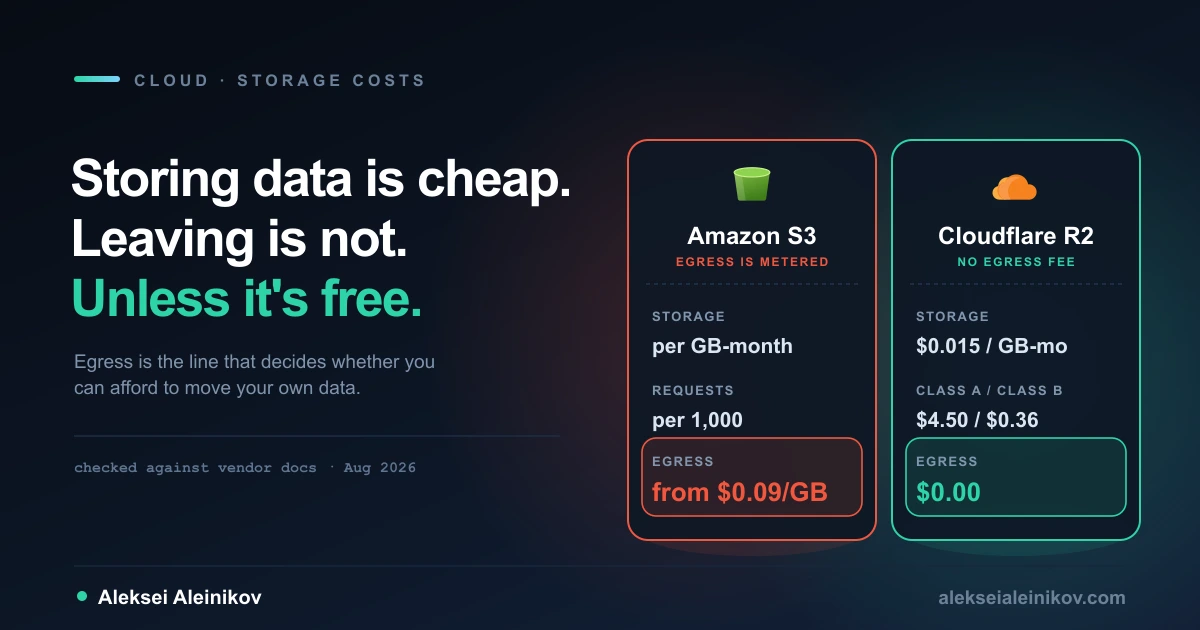
Wenn speziell Object-Storage-Egress schmerzt, lohnt sich ein genauerer Blick auf diese eine Position — den habe ich in Cloudflare R2 vs S3: Was Egress wirklich kostet durchgerechnet.
NAT-Gateways
Dieser Zähler überrascht am meisten, weil er doppelt abrechnet — und alle drei Clouds sind bei denselben zwei Zahlen gelandet.
AWS berechnet 0,045 $ pro NAT-Gateway-Stunde und 0,045 $ pro verarbeitetem GB. Azure trifft beide Zahlen exakt: 0,045 $ pro Ressourcenstunde und 0,045 $ pro verarbeitetem GB. Googles Cloud NAT berechnet 0,0014 $ pro VM und Stunde bis 32 Instanzen, pauschal 0,044 $ pro Stunde darüber, 0,045 $ pro verarbeitetem GiB und 0,005 $ pro Stunde für jede externe IP-Adresse des Gateways.
Zwei Details richten den Schaden an. Erstens läuft die Stundengebühr, ob Traffic fließt oder nicht — AWS rechnet angefangene Gateway-Stunden als volle Stunden ab, und Azure hält fest, dass die Abrechnung mit dem Anlegen der Ressource beginnt. Ein NAT-Gateway, das seit dem letzten Hackathon niemand benutzt hat, kostet rund 33 $ im Monat, bevor ein einziges Byte bewegt wird. Multipliziert mit jedem Nicht-Produktions-Account ist das kein Rundungsfehler mehr.
Zweitens kommt die Verarbeitungsgebühr zusätzlich zum Internet-Egress. Azures Preisseite sagt das ausdrücklich: Bandbreitengebühren fallen zusätzlich zur NAT-Datenverarbeitungsgebühr an. Ein Byte, das ein privates Subnetz Richtung Internet verlässt, wird von NAT gemessen und auf dem Weg hinaus nochmals. Zu AWS-Listenpreisen sind das 0,045 $ plus 0,09 $ — 0,135 $ pro GB für Traffic, von dem du 0,09 $ angenommen hattest.
Zonenübergreifender Traffic
AWS berechnet 0,01 $ pro GB für Traffic zwischen Availability Zones innerhalb derselben Region, und zwar in beide Richtungen — ein zwischen zwei AZs gesendetes Byte kostet 0,01 $ raus und 0,01 $ rein. Google berechnet 0,01 $ pro GiB für den entsprechenden Sprung zwischen Zonen derselben Region.
Das ist der Zähler, den man nicht sieht. Niemand deployt einen Dienst namens „zonenübergreifender Traffic”. Er entsteht, weil deine API mit einem Cache in einer anderen Zone spricht oder weil ein Kubernetes-Service per Round-Robin über einen mehrzonigen Node-Pool verteilt und die Hälfte der Aufrufe woanders landet. Die Architektur, die ihn erzeugt, ist dieselbe, die deine Verfügbarkeitsanforderungen verlangt haben — genau deshalb sollte man ihn messen statt annehmen.
Die Gegenmaßnahme ist nicht „alles in eine Zone” — das tauscht Geld gegen Verfügbarkeit. Sie besteht darin, bewusst zu entscheiden, welche konkreten Gespräche hohes Volumen haben, und diese lokal zu halten — mit topologiebewusstem Routing statt mit der Hoffnung, der Scheduler sei sparsam.
Die Control Plane
Die Preise für Managed Kubernetes sind fast exakt zusammengewachsen.
Amazon EKS berechnet 0,10 $ pro Cluster und Stunde für Versionen im Standard-Support. GKE berechnet pauschal 0,10 $ pro Cluster und Stunde für jeden Cluster, unabhängig von Modus und Topologie — zonal, regional, Autopilot, alles gleich — und legt ein Freikontingent von 74,40 $ pro Monat und Rechnungskonto obendrauf, das etwa einem zonalen Standard- oder Autopilot-Cluster entspricht. AKS tanzt aus der Reihe: Der Free-Tier kostet nichts, kommt aber ohne SLA; der Standard-Tier kostet 73 $ pro Cluster und Monat für das API-Server-Uptime-SLA; der Premium-Tier kostet 438 $ pro Cluster und Monat für Long-Term-Support.
0,10 $ pro Stunde sind 73 $ im Monat. Alle drei sind bei derselben Zahl für eine unterstützte Control Plane gelandet.
Richtig zubeißen tut diese Position beim Versions-Drift. EKS und GKE verlangen beide 0,60 $ pro Cluster und Stunde, sobald du auf einer Extended-Support-Version bist — das Sechsfache. Bei EKS greift das 14 Monate nach Erscheinen einer Version, und AWS’ eigenes Beispiel kommt auf durchschnittlich 0,33 $ pro Stunde über 26 Monate ohne Upgrade. AKS bepreist dieselbe Entscheidung mit 438 $ im Monat. Kubernetes-Upgrades sind nicht nur Hygiene; auf allen drei Clouds sind sie eine Position auf der Rechnung.
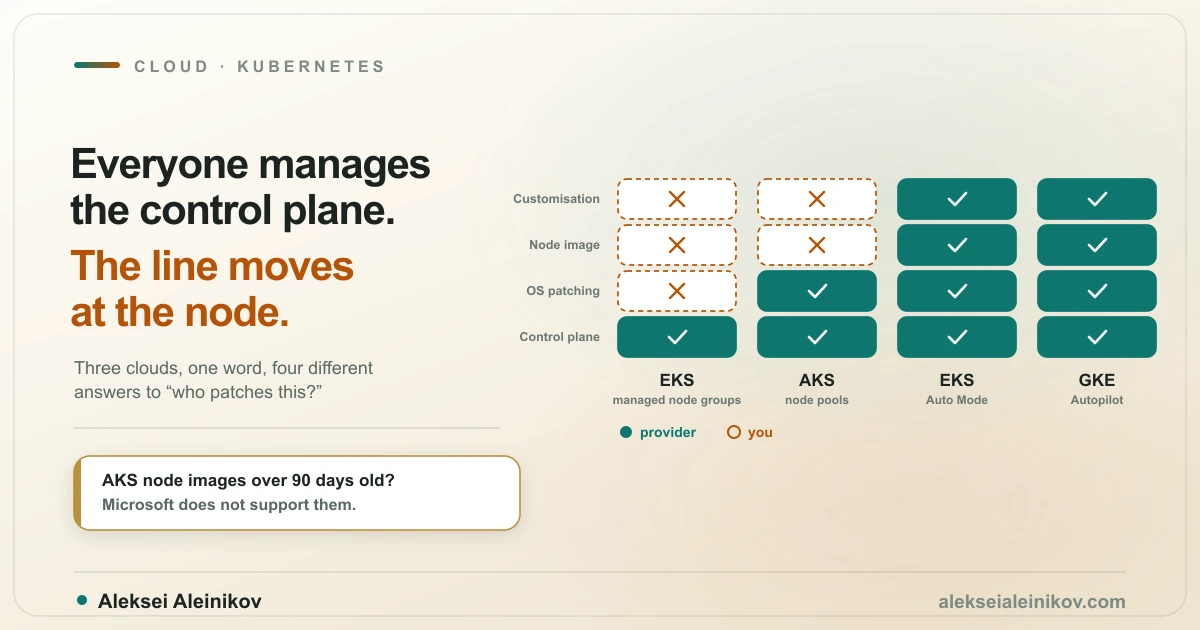
Die zweite Falle ist Cluster-Wildwuchs. Die Gebühr ist pauschal und pro Cluster — dreißig kleine Cluster kosten das Dreißigfache eines großen, und nichts davon ist Compute. Wenn deine Plattform Cluster als Isolationseinheit ausgibt, hat diese Entscheidung ein Preisschild, das man gegen Namespaces und Quotas abwägen sollte. Wie der Cluster-Modus selbst die Compute-Seite derselben Rechnung verändert, steht in GKE Autopilot vs Standard.
Das Kleingedruckte, das Summen bewegt
Einige Posten sind pro Einheit klein und in Summe groß, und sie teilen eine Eigenschaft: Sie berechnen Dinge, die nicht laufen.
Ungenutzte IP-Adressen. AWS berechnet 0,005 $ pro Adressstunde für öffentliche IPv4, ob in Benutzung oder nicht — rund 3,65 $ im Monat, pro Adresse, überall. Google berechnet 0,005 $ pro Stunde für eine genutzte externe IP an einer Standard-VM und das Doppelte, 0,01 $ pro Stunde, für eine reservierte, aber nicht zugewiesene statische Adresse. Die Strafe ist Absicht: Adressen zu horten kostet mehr, als sie zu benutzen.
Logging und Telemetrie. Google bepreist VPC Flow Logs, Firewall-Logging und Cloud-NAT-Logging als Vended Logs ab 0,25 $ pro GiB für die ersten 10 TiB, vor den Cloud-Logging-Speicherkosten. Flow Logs in voller Auflösung auf einer belebten VPC können den Traffic überholen, den sie beobachten. Sampling einschalten.
Load-Balancer-Datenverarbeitung. Google berechnet 0,008 $ pro GiB ein- und ausgehend verarbeitet, getrennt vom Egress. Die internen Application Load Balancer haben zudem ein Minimum von drei Proxy-Instanzen zu je 0,025 $ pro Stunde — rund 55 $ im Monat pro Forwarding Rule, ob eine Anfrage ankommt oder nicht.
Keiner dieser Posten wird die größte Zeile deiner Rechnung sein. Zusammen sind sie in einer Landschaft mit vielen Umgebungen der Unterschied zwischen einer aufgeräumten und einer undichten Plattform.
FinOps ist kein Dashboard
Der Begriff ist von Tool-Anbietern gründlich vereinnahmt worden, was schade ist, denn die eigentliche Praxis ist vor allem organisatorisch.
Die FinOps Foundation beschreibt drei sich wiederholende Phasen — Inform, Optimize, Operate — und die Reihenfolge zählt mehr als die Namen. Inform heißt: Ausgaben sind sichtbar und dem verursachenden Team zuordenbar. Optimize heißt: Architektur, Dimensionierung und Einkauf ändern. Operate heißt: das kontinuierlich tun, mit Verantwortlichen und Zielen, statt als Quartals-Feuerübung.
Fast alle starten bei Optimize, weil es sich nach Engineering anfühlt. Das funktioniert selten, aus einem einfachen Grund: Ohne Zuordnung siehst du, dass die Rechnung gestiegen ist, aber nicht, wessen Deployment das war. Also driftet die Sparerei zu dem, was am besten sichtbar ist, statt zu dem, was am teuersten ist — und das, was tatsächlich gewachsen ist, wächst weiter.
Zuordnung ist kein Tool-Kauf. Sie ist eine Tagging-Policy, die beim Deployment erzwungen wird, eine Projekt- und Account-Struktur, die auf Teams abbildet, und ein Standard-Labelsatz, den deine Plattform setzt statt Menschen ihn sich merken. Das gehört ins Fundament — ich habe es in Was gehört in eine Cloud Landing Zone genau dort verortet. Es nachträglich über eine laufende Landschaft zu ziehen, ist ausgesprochen unangenehm, was das beste Argument dafür ist, es früh zu tun.
Was zuerst reparieren
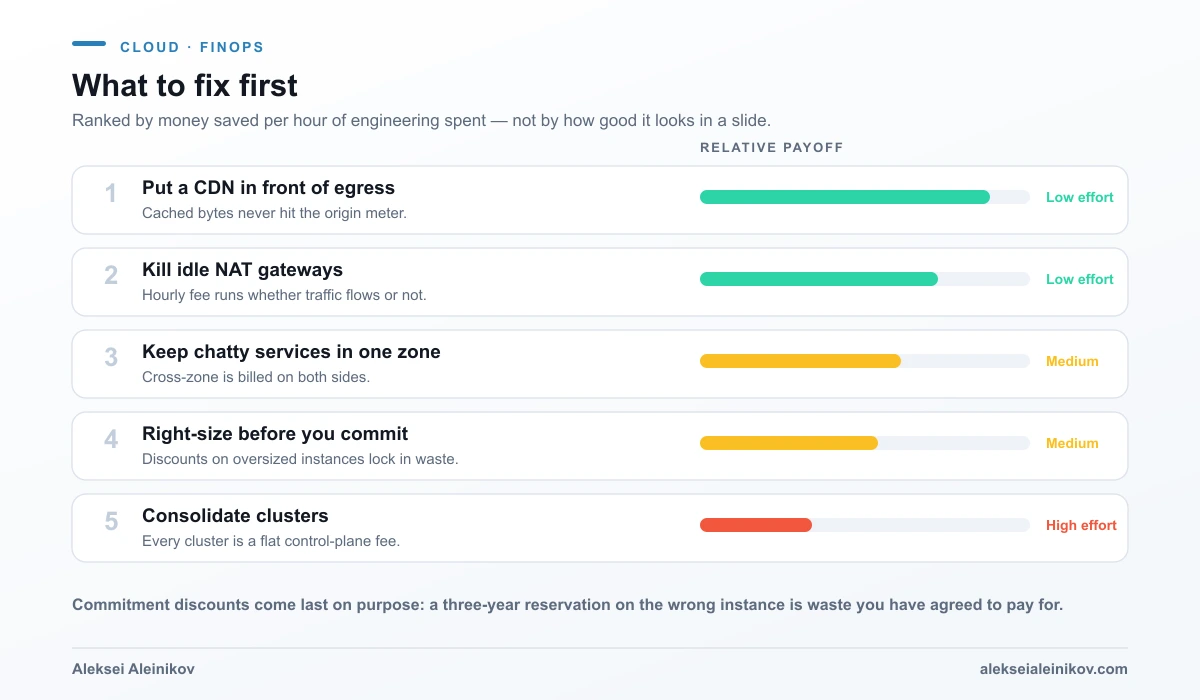
Ein CDN vor den Egress setzen. Gecachte Bytes erreichen den Origin-Zähler nie. Auf Google Cloud ist Datentransfer von Compute Engine und GKE zu Cloud CDN kostenlos, und Cache-Egress nach Nordamerika oder Europa beginnt bei 0,08 $ pro GiB mit Cache-Fill zu 0,01 $ — günstiger, als dieselben Bytes direkt auszuliefern. Azure berechnet in bestimmten Fällen keinen Transfer von einem Azure-Origin zu Azure CDN oder Front Door Standard/Premium — die Bedingungen stehen in der Preis-FAQ, prüfe deinen Fall, bevor du damit rechnest. Das ist der wirksamste Hebel der Liste, weil es Konfiguration ist und keine Architektur.
Ungenutzte NAT-Gateways abschalten. Eine Grundgebühr für eine unbenutzte Komponente ist die reinste verfügbare Form von Verschwendung. Prüfe zuerst die Nicht-Produktions-Accounts; dort sammeln sie sich an.
Gesprächige Dienste in eine Zone legen. Miss erst, welche Service-zu-Service-Gespräche hohes Volumen haben, bevor du etwas verschiebst. Ziel ist, die zwei oder drei gesprächigsten Pfade zonenlokal zu machen — nicht, mehrzonige Deployments aufzugeben.
Richtig dimensionieren, bevor du dich festlegst. Requests werden meist einmal gesetzt, auf dem Wert, mit dem der Lasttest durchging, und nie wieder angefasst. Vertikales Autoscaling und In-Place-Pod-Resizing existieren genau dafür, und man sollte die Mechanik verstehen, bevor man sie einschaltet — die Trade-offs habe ich in Kubernetes-Autoscaling: HPA vs VPA vs Cluster Autoscaler behandelt.
Cluster konsolidieren. Höchster Aufwand, echter Nutzen im großen Maßstab, und am ehesten von organisatorischem Widerstand betroffen — weil die Cluster-Grenze oft eine verkleidete Teamgrenze ist.
Commitment-Rabatte stehen bewusst unter all dem. Eine Dreijahresreservierung auf einer Instanz, die doppelt so groß ist wie nötig, ist keine Einsparung. Sie ist eine Mehrausgabe, die du unterschrieben hast und nicht mehr korrigieren kannst.
Die Ausstiegsklausel
Eine Asymmetrie verdient Erwähnung, weil sie Egress-Preise zu einer strategischen und nicht nur operativen Frage macht: Daten hinein sind auf allen drei Clouds kostenlos, Daten hinaus nicht. Der Zähler läuft am schnellsten genau dann, wenn du deine Daten woanders benutzt — auch wenn „woanders” ein anderer Anbieter ist.
Die Regulierung hat begonnen gegenzuhalten. Der EU Data Act — Verordnung (EU) 2023/2854 — trat am 11. Januar 2024 in Kraft und gilt seit dem 12. September 2025; er regelt den Wechsel zwischen Anbietern von Datenverarbeitungsdiensten. Die Anbieter haben mit Prozessen reagiert, nicht mit automatischen Preissenkungen. AWS schreibt inzwischen, dass EU-Kunden für geeignete Anwendungsfälle reduzierte Datentransferraten beantragen können, und bietet berechtigten Kunden separat kostenlosen Datentransfer ins Internet, wenn sie alle ihre Daten aus AWS oder aus einem bestimmten Service herausbewegen.
Lies die Form dieser Zusage genau. Es ist kein Tarif, den du bekommst, sondern ein Antrag, den du stellst — mit Genehmigung durch dein Account-Team, geliefert als temporäres Guthaben, und AWS gewährt derzeit ein 90-Tage-Fenster für die Migration. Der Ausstieg ist möglich. Er ist ein Projekt mit Deadline, keine Klausel, auf die man sich in Eile verlassen kann.
Das Fazit
Die drei großen Clouds sind bei bemerkenswert ähnlichen Listenpreisen für die Zähler gelandet, auf die es ankommt. Niemand gewinnt einen Kostenvergleich allein über Egress-Raten, und einen Anbieter zu wählen, weil er drei Cent pro Gigabyte günstiger ist, heißt auf der falschen Achse zu wählen.
Wirklich unterschiedlich ist, was du damit machst. Die Rechnung ist ein Auslesen deiner Architektur: wie viele Daten Grenzen überqueren, wie viele Grundgebühren du laufen lässt, wie viele Cluster existieren, weil Teilen schwerer war als Anlegen, und ob irgendjemand sagen kann, welches Team den Anstieg des letzten Monats verursacht hat.
Repariere die Architektur, dann folgen die Rabatte. Kaufe zuerst die Rabatte, und du hast nur die falsche Architektur billiger gemacht, um sie zu behalten.
Aus der Community
Diskussion im Fediverse
Antworten von Mastodon und Bluesky — direkt aus dem offenen Netz, ohne Tracking.
Antworten werden geladen …
Noch keine Antworten. Starte die Diskussion:
Antworten konnten gerade nicht geladen werden.