Platform Engineering ist gerade der meistgesuchte und meistmissverstandene Begriff der Infrastruktur. Anbieter verkaufen „eine Internal Developer Platform aus der Box”, Konferenzvorträge versprechen, sie werde DevOps ersetzen, und die halbe Branche vermutet still, es sei nur Kubernetes mit einem hübscheren Logo.
Ist es nicht. Nimm das Marketing weg, und Platform Engineering ist eine wirklich nützliche, konkrete Idee — und auf Kubernetes hat sie eine greifbare Form. Hier ist, was es wirklich ist, woraus es besteht und die ehrliche Antwort, ob du eine bauen solltest.
Aktualisiert im Oktober 2026: Dieser Leitfaden behandelt jetzt auch die Infrastruktur-Automatisierung unter dem Cluster — Terraform, OpenTofu und Ansible. Dieser Abschnitt enthält einen deutlich gekennzeichneten Werbeabsatz (Anzeige) von Spacelift; der Rest des Artikels ist unabhängig und unbezahlt.
Was Platform Engineering wirklich ist
Platform Engineering ist die Disziplin, eine Internal Developer Platform (IDP) als Produkt zu bauen — mit den eigenen Entwicklern als Kunden.
Diese Sichtweise ist das Ganze. Du baust nicht Infrastruktur um ihrer selbst willen; du baust ein Produkt, das andere Ingenieure wählen, weil es das Ausliefern von Software schneller und sicherer macht als von Hand. Das Plattform-Team betreibt sie wie jedes Produkt: mit Nutzern, Feedback, einer Roadmap und einer Erfolgsdefinition, die Entwickler-Adoption heißt, nicht Zeilen Terraform.
Der Mechanismus ist der Golden Path (oder „Paved Road”): ein meinungsstarker End-to-End-Weg für eine häufige Aufgabe — einen neuen Service hochziehen, eine Datenbank hinzufügen, in Produktion ausliefern — der standardmäßig das Richtige tut. Der einfache Weg wird zum sicheren, konformen, beobachtbaren.
Das gelöste Problem: kognitive Last
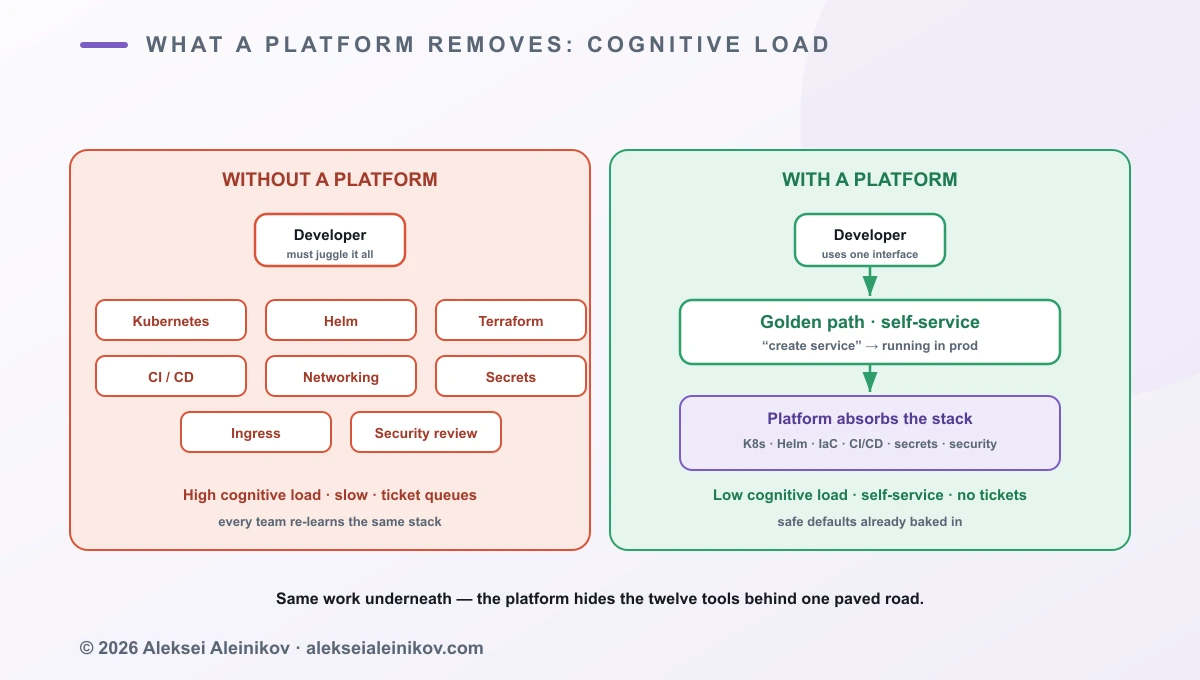
Hier ist, warum es das gibt. Um einen einzigen Service auf moderner cloud-nativer Infrastruktur auszuliefern, soll ein Entwickler implizit Kubernetes, Helm oder Kustomize, ein Ingress- und Networking-Modell, Terraform oder ein anderes IaC-Tool, ein CI/CD-System, Secrets-Management und einen Haufen Security-Controls verstehen. Und das, bevor er eine Zeile Geschäftslogik schreibt.
Das ist kognitive Last, und sie skaliert nicht. Jedes neue Team lernt entweder alles neu oder kopiert ein halb verstandenes Setup vom letzten Team. Eine Plattform nimmt diese Last ab: Der Entwickler arbeitet gegen eine saubere Self-Service-Schnittstelle, und die Plattform kümmert sich um die zwölf Werkzeuge darunter.
Es ist nicht DevOps 2.0 oder umbenanntes SRE
Die häufigste Verwechslung ist, Platform Engineering ersetze DevOps oder benenne SRE um. Es tut weder das eine noch das andere — die drei sind komplementäre Ebenen.
| DevOps | SRE | Platform Engineering | |
|---|---|---|---|
| Was es ist | Eine Kultur und Praxis | Eine Reliability-Engineering-Disziplin | Eine IDP als Produkt bauen |
| Kernidee | Dev/Ops-Wand einreißen — „you build it, you run it” | Zuverlässigkeit via SLOs und Error Budgets | Golden Paths und Self-Service im großen Maßstab |
| Besitzt | Wie Teams zusammenarbeiten | Uptime, Toil, Incident Response | Die Entwicklerplattform und ihre UX |
| Scheitert, wenn | Jedes Team muss allen Ops meistern | Als Umbenennung für Ops behandelt | Als Technik um ihrer selbst willen gebaut, nicht adoptiert |
| Der Einzeiler | Das Ziel | Hält es zuverlässig | Das Produkt, das beides skalieren lässt |
DevOps ist das Ziel — Teams, die ihre Software End-to-End besitzen. SRE hält es mit echter Engineering-Strenge zuverlässig. Platform Engineering ist das Produkt, das eine große Organisation beides erreichen lässt, ohne dass jedes Team dieselbe Infrastruktur neu erfindet. Du brauchst alle drei.
Die Anatomie einer IDP auf Kubernetes
Auf Kubernetes hat eine Internal Developer Platform einen wiedererkennbaren Stack. Von der Infrastruktur unten bis zum Entwickler oben:
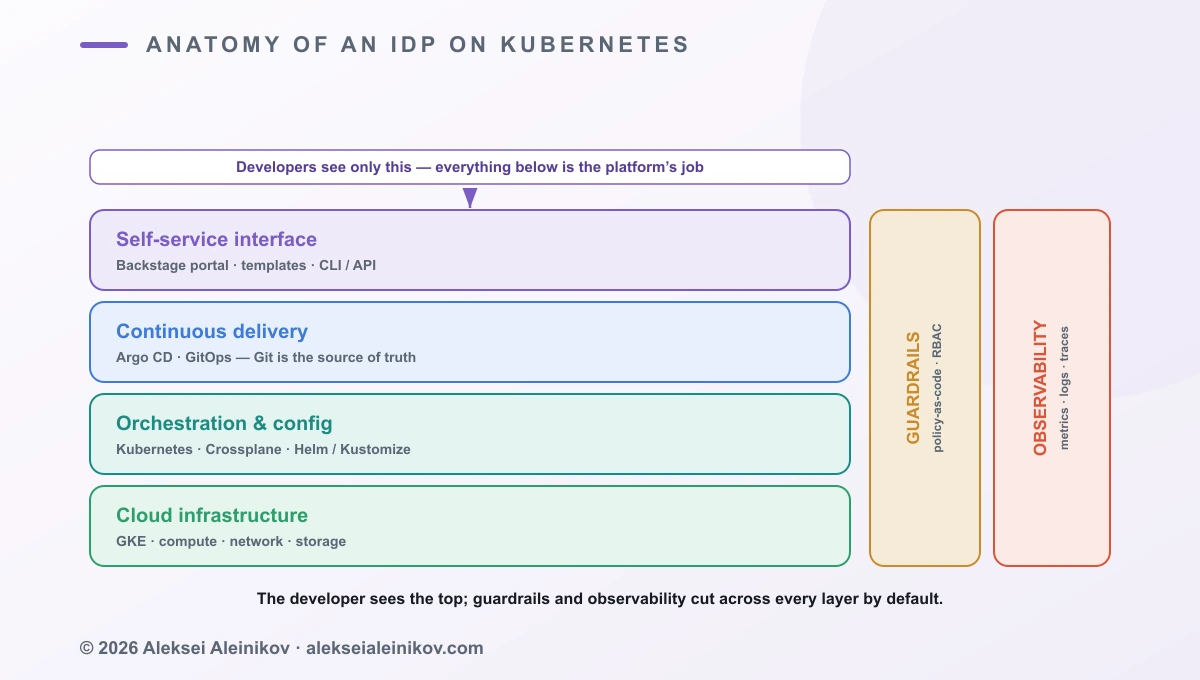
- Cloud-Infrastruktur — das Compute-, Netzwerk- und Storage-Fundament. Auf Google Cloud ist das GKE plus die umgebenden Primitive.
- Infrastruktur-Automatisierung — Terraform oder OpenTofu provisioniert dieses Fundament (einschließlich des Clusters selbst), Ansible konfiguriert, was außerhalb von Pods lebt, und eine IaC-Orchestrierungsschicht führt beides unter Policy aus. Sie bekommt unten einen eigenen Abschnitt, denn hier versickert in den meisten Plattformen still der Toil.
- Orchestrierung & Konfiguration — Kubernetes als Control Plane, mit Crossplane, um Infrastruktur als APIs bereitzustellen, und Helm oder Kustomize, um Workloads zu templaten.
- Continuous Delivery — GitOps mit Argo CD: Git ist die Quelle der Wahrheit, und der Cluster gleicht sich kontinuierlich darauf ab.
- Self-Service-Schnittstelle — der Teil, den Entwickler tatsächlich anfassen: ein Portal wie Backstage, Service-Templates (die Golden Paths) und eine Plattform-CLI oder -API.
Zwei Dinge schneiden durch jede Ebene und sind nicht optional:
- Leitplanken — Policy-as-Code mit Kyverno oder OPA Gatekeeper, RBAC und Security-Controls, die den befestigten Weg automatisch konform machen.
- Observability — Metriken, Logs und Traces standardmäßig verdrahtet, sodass jeder Service in dem Moment beobachtbar ist, in dem er geboren wird. In der Praxis heißt das: OpenTelemetry-Auto-Instrumentierung und ein Collector pro Node als fester Teil des Golden Path.
Die Ebenen zählen weniger als das Prinzip: Der Entwickler sieht nur die Spitze, und alles darunter ist Aufgabe der Plattform.
Die Ebene der Infrastruktur-Automatisierung: Terraform, OpenTofu und Ansible
Die meisten Plattform-Diagramme beginnen bei Kubernetes. Echte Plattformen nicht. Bevor Argo CD irgendetwas ausrollen kann, muss jemand die VPC, die IAM-Bindings, die verwalteten Datenbanken anlegen — und den GKE-Cluster selbst. Und rund um den Cluster gibt es meist eine Flotte von Dingen, die nie in einem Pod laufen: Bastion- und Build-VMs, Legacy-Dienste, Appliances, OS-Härtung, Monitoring-Agents.
Das ist die Ebene der Infrastruktur-Automatisierung, und 2026 besteht sie fast immer aus zwei Werkzeugen.
Provisionierung vs. Konfiguration
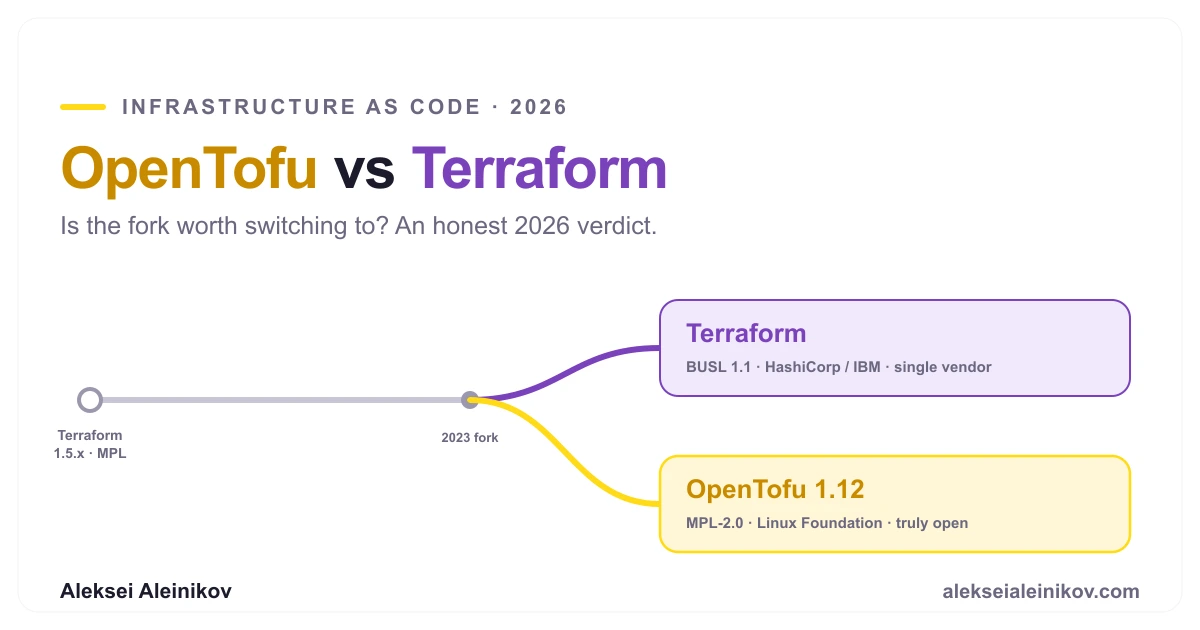
- Terraform oder OpenTofu provisioniert. Deklarativ, zustandsbehaftet, erst Plan, dann Apply: Du beschreibst die Ressourcen, das Tool berechnet den Diff und erstellt, ändert oder löscht sie. OpenTofu ist der Open-Source-Fork unter der Linux Foundation, entstanden, nachdem HashiCorp Terraform 2023 auf die Business Source License umgestellt hat. Er ist weitgehend drop-in-kompatibel — dasselbe HCL, dieselben Provider — und hat eigene Features ergänzt, etwa clientseitige State-Verschlüsselung. Für die meisten Teams entscheiden Lizenz und Governance, nicht die Syntax.
- Ansible konfiguriert. Prozedural, agentenlos, über SSH oder eine API: Es installiert Pakete, härtet das OS, verteilt Agents und Zertifikate und spricht mit Netzwerkgeräten. Es ist das richtige Werkzeug für alles, was nach dem Boot einer VM und außerhalb von Kubernetes existiert.
- Wo Crossplane hingehört. Crossplane ist stark bei Ressourcen auf App-Ebene, die aus einem laufenden Cluster heraus angefordert werden — „gib meinem Service einen Bucket und eine Datenbank” als Kubernetes-Claim. Den Cluster, auf dem es läuft, kann es aber nicht erstellen. Die übliche Aufteilung: Terraform/OpenTofu besitzt das Fundament, Crossplane bedient die entwicklernahen Ressourcen darüber.
Wo es bricht: zwei Werkzeuge, zwei Silos
Die Werkzeuge sind in Ordnung. Wie sie verdrahtet sind, meist nicht. Ein typisches Setup fährt Terraform in einer CI-Pipeline und Ansible aus einem anderen Job, einem AWX-Server oder von jemandes Laptop — das Inventory übergibt ein Skript oder eine kopierte IP-Liste. Die Symptome sind vorhersehbar:
- Keine End-to-End-Sicht. Eine logische Änderung („Node-Pool hinzufügen und seine Agents konfigurieren”) lebt in zwei Systemen, und niemand sieht, ob sie vollständig durchgelaufen ist.
- Zwei Reviews, zwei Audit-Trails. Security prüft Terraform-Pläne an einer Stelle und Ansible-Läufe an einer anderen. Auditoren bekommen zwei Geschichten für eine Änderung.
- Reihenfolge per Konvention. Ansible läuft, bevor die Provisionierung fertig ist, oder gegen das Inventory von gestern.
- Stiller Drift. Ein Hotfix in der Konsole weicht vom State ab, und niemand merkt es, bis das nächste, völlig andere
applyihn zurückdrehen will. - Self-Service wird wieder zum Ticket. Niemand traut der Kette einen unbeaufsichtigten Lauf zu, also geht jede Anfrage nach einer „neuen Umgebung” von Hand über das Plattform-Team.
Das Letzte ist das Scheitern von Platform Engineering im Kleinen: oben ein Golden Path, darunter Toil.
Was eine IaC-Orchestrierungsschicht hinzufügt
Die Lösung ist nicht, Terraform oder Ansible zu ersetzen. Sondern eine Orchestrierungsschicht zwischen Git und beide Werkzeuge zu setzen, sodass sie als ein gesteuerter Workflow laufen:
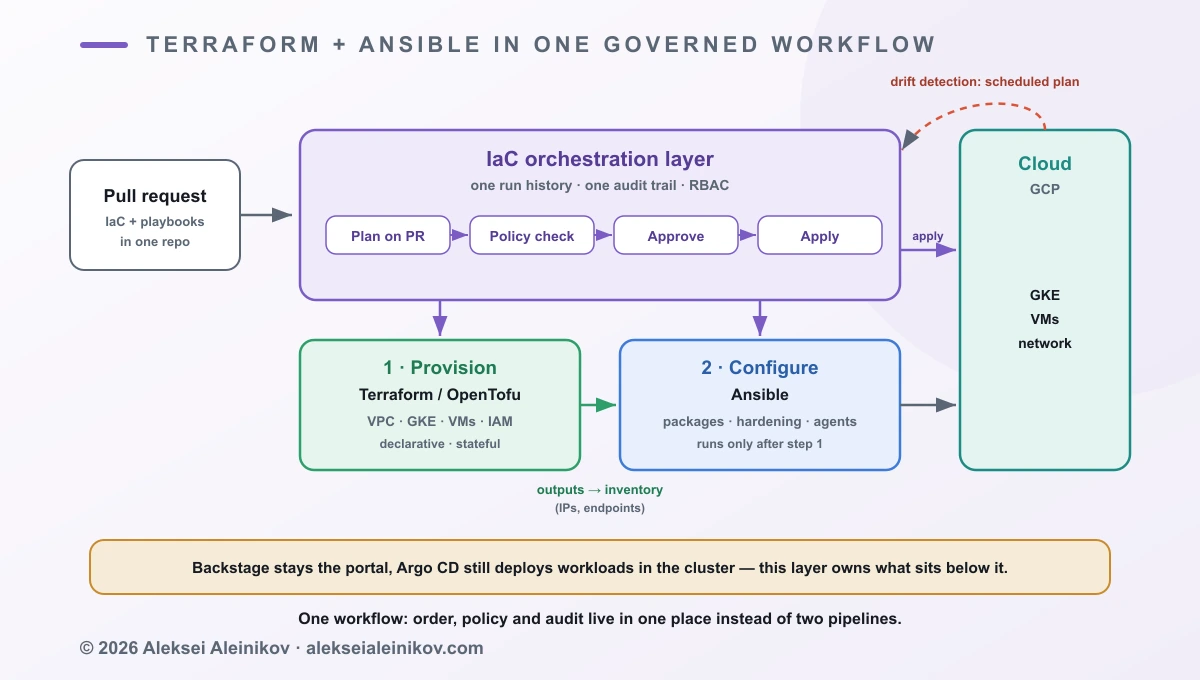
- Gesteuerte Läufe — Plan bei jedem Pull Request, Apply nur vom Main-Branch, Freigaben für riskante Änderungen, Locks, damit sich nie zwei Applies überholen.
- Policy-as-Code auf dem Plan — dieselbe Idee wie Kyverno im Cluster, eine Ebene tiefer: öffentlichen Bucket ablehnen, Labels erzwingen, einen zweiten Freigebenden verlangen, wenn ein Plan eine Datenbank löscht.
- Abhängigkeiten und Übergabe — die Outputs des Provisionierungs-Stacks (IPs, Endpoints, Cluster-Namen) fließen automatisch und in der richtigen Reihenfolge in den Konfigurations-Stack.
- Drift-Erkennung — geplante Pläne vergleichen die Realität mit dem deklarierten State und alarmieren oder gleichen ab.
- Self-Service mit RBAC — das Portal stößt einen Stack aus einem Template an; das Plattform-Team besitzt die Leitplanken, nicht jeden einzelnen Lauf.
- Ein Audit-Trail — wer was geändert hat, welche Policy es freigegeben hat, was angewendet wurde.
Eine Plan-Policy ist klein. Hier eine generische OPA/Rego-Regel (Rego-v1-Syntax), die gegen die JSON-Ausgabe von terraform show -json läuft — mit conftest im CI oder in jedem Orchestrator, der OPA auswertet:
package main
deny contains msg if {  rc := input.resource_changes[_]  rc.type == "google_storage_bucket_iam_member"  rc.change.after.member == "allUsers"  msg := sprintf("%s makes a bucket public", [rc.address])}
Deine Optionen
Du kannst diese Schicht selbst bauen oder kaufen. Der ehrliche Vergleich:
| Generisches CI (GitHub Actions, GitLab CI) | Atlantis | HCP Terraform / Terraform Enterprise | Spacelift | |
|---|---|---|---|---|
| IaC-Werkzeuge | Alles, was du skriptest | Terraform, OpenTofu | Terraform | Terraform, OpenTofu, Terragrunt, Pulumi, CloudFormation, Kubernetes, Ansible |
| Ansible im selben Workflow | Wenn du die Übergabe selbst baust | Nein | Nicht als nativer Workspace-Typ | Native Ansible-Stacks, verknüpft über Stack-Abhängigkeiten |
| Policy-as-Code | Eigenbau (conftest in der Pipeline) | Conftest-Policy-Checks | Sentinel und OPA | OPA/Rego (Plan-, Freigabe-, Trigger-Policies) |
| Drift-Erkennung | Eigenbau (geplanter Plan-Job) | Nicht eingebaut | Health Assessments (kostenpflichtige Tarife) | Geplante Erkennung, optionaler Abgleich (Private Worker) |
| Wo es läuft | Deine Runner | Selbst gehostet | SaaS oder selbst gehostet | SaaS oder selbst gehostet, Private Worker |
| Passt am besten zu | Kleinem Bestand, starkem CI-Know-how | PR-getriebenen Teams, die selbst hosten | Reinen Terraform-Shops nahe an HashiCorp | Gemischten Terraform/OpenTofu- + Ansible-Beständen |
Auch Scalr und env0 spielen in diesem Feld. Ist dein Bestand klein und rein Terraform, ist eine gut gebaute CI-Pipeline mit conftest eine völlig gute Antwort; das Argument für einen eigenen Orchestrator wächst mit der Zahl der Stacks, Teams und Werkzeuge.
Anzeige · Spacelift
Wenn du diese Orchestrierungsschicht nicht selbst warten willst, kann Spacelift als Terraform/OpenTofu-Orchestrierungs-Backend der Plattform dienen: gesteuerte Läufe, Policy und Drift-Handling an einem Ort. Das Besondere: Terraform/OpenTofu- und Ansible-Stacks laufen im selben Workflow. Stack-Abhängigkeiten bilden einen Graphen, und Outputs des Provisionierungs-Stacks werden an den Ansible-Stack übergeben — die Konfiguration läuft also erst, wenn die Infrastruktur existiert, auf die sie zielt. Eine Run-Historie und ein Audit-Trail statt zwei. Plan-, Freigabe- und Trigger-Policies schreibst du in OPA/Rego; die Drift-Erkennung läuft nach Zeitplan und kann automatisch abgleichen. Für Self-Service gibt es eine Backstage-Integration, über die Entwickler Stacks aus dem Portal anstoßen, das sie ohnehin nutzen.
Wie es zum Rest der Plattform passt
Die Orchestrierungsschicht nimmt niemandem seinen Job weg:
- Backstage bleibt das Portal. Ein Template öffnet entweder einen Pull Request gegen ein IaC-Repo oder stößt über die API des Orchestrators einen Stack an.
- Argo CD bleibt Continuous Delivery für Workloads im Cluster.
- Kubernetes und Crossplane kümmern sich weiter um Ressourcen im Cluster und auf App-Ebene.
Die Faustregel: Was vor dem Cluster oder außerhalb davon existiert, gehört in die IaC-Schicht; was im Cluster läuft, gehört zu GitOps.
Der Golden Path in Bewegung
Konkret: Das ersetzt ein Golden Path. Ohne Plattform bedeutet einen Service zu starten, dass ein Entwickler Kubernetes-Manifeste von Hand schreibt, eine Pipeline verdrahtet, Secrets anfordert, Networking um einen Ingress bittet und einen Security-Review bucht — oft über Tage und mehrere Tickets.
Mit Plattform führt der Entwickler eine Aktion aus — „Service erstellen” aus einem Template im Portal — und die Plattform gerüstet das Repo, verdrahtet CI (Build, Test, Scan), committet die GitOps-Konfiguration, rollt über Argo CD auf GKE aus und hängt Leitplanken und Observability automatisch an. Keine Tickets, kein Ops-Flaschenhals. Das ist das gesamte Wertversprechen: Self-Service, mit den sicheren Defaults bereits eingebaut.
Brauchst du wirklich eine Plattform?
Hier zählt Ehrlichkeit, denn eine Plattform zu bauen, die niemand adoptiert, ist einer der teuersten Fehler der Infrastruktur. Mehr Plattform ist nicht automatisch besser.
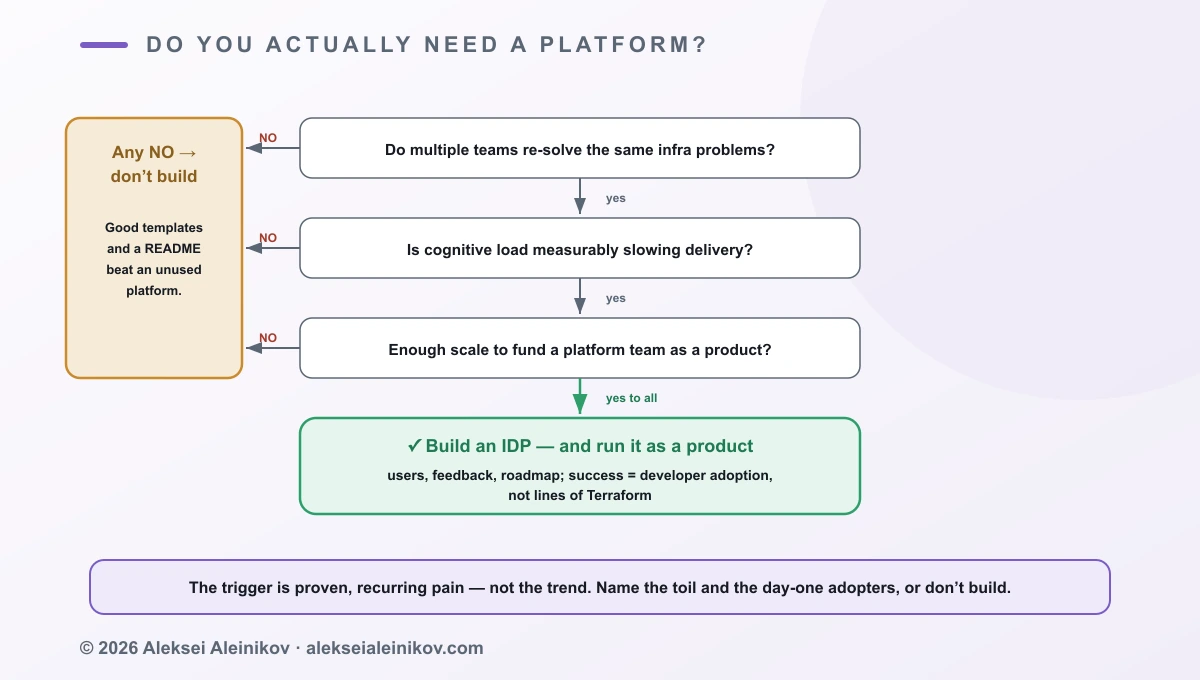
- Kleines Team, eine Handvoll Services? Du brauchst keine Plattform. Gute Templates, eine solide README und eine saubere CI-Pipeline schlagen eine maßgeschneiderte Plattform, für deren Wartung dir die Leute fehlen.
- Mehrere Teams lösen dieselben Infra-Probleme, kognitive Last bremst die Delivery, und genug Größe, um ein Plattform-Team zu besetzen? Jetzt zahlt sich eine Plattform aus — bau die IDP und betreib sie als Produkt.
Der Auslöser ist bewiesener, wiederkehrender Schmerz, nicht der Trend. Wenn du den konkreten Toil, den die Plattform beseitigt, und die Teams, die sie am ersten Tag adoptieren, nicht benennen kannst, baust du Technik um ihrer selbst willen — genau der Fehlermodus aus der Vergleichstabelle.
Werkzeuge und die Google-Cloud-Zuordnung
Das Platform-Engineering-Toolkit 2026 auf Kubernetes ist weitgehend CNCF-nativ: Backstage fürs Portal, Crossplane für Infrastructure-as-APIs, Argo CD für GitOps-Delivery, Kyverno oder OPA Gatekeeper für Policy und Kubernetes unter allem. Unter dem Cluster bilden Terraform oder OpenTofu plus Ansible die Infrastruktur-Automatisierung, ausgeführt über einen IaC-Orchestrator.
Auf Google Cloud bilden sich die Ebenen auf verwaltete Bausteine ab: GKE für den Cluster, Config Connector (oder Config Controller), um GCP-Ressourcen als Kubernetes-Objekte zu verwalten, Infrastructure Manager für verwaltete Terraform-Läufe, Cloud Deploy für Delivery-Pipelines und Cloud Build oder Artifact Registry für die Supply Chain — alle fügen sich sauber unter dieselbe Self-Service-Schnittstelle.
Das ehrliche Fazit
Platform Engineering ist nicht Kubernetes mit einem hübscheren Logo, und es ist kein Ersatz für DevOps oder SRE. Es ist die Disziplin, eine Internal Developer Platform als Produkt zu bauen: Golden Paths, die den einfachen Weg zum sicheren machen, eine Self-Service-Schnittstelle über der Infrastruktur, eine gesteuerte Automatisierungsschicht darunter und Leitplanken und Observability in jeder Ebene.
Bau sie, um echte, wiederkehrende kognitive Last zu beseitigen — und miss sie auf die einzige Weise, die zählt: ob deine Entwickler sie tatsächlich nutzen wollen. Eine Plattform, die niemand adoptiert, ist nur mehr Infrastruktur zum Warten. Eine, die sie lieben, ist die schnellste befestigte Straße zur Produktion, die du ihnen geben kannst.
Weiterführend: GitOps mit Argo CD ist die Delivery-Schicht einer IDP, und Secure-by-Default GKE ist die Leitplanken-Schicht, richtig gemacht.

Aus der Community
Diskussion auf Mastodon & Bluesky
Antworten auf diesen Artikel aus dem offenen Netz, live geladen. Keine Werbung, keine Tracking-Skripte.
Antworte dort — es erscheint hier automatisch.