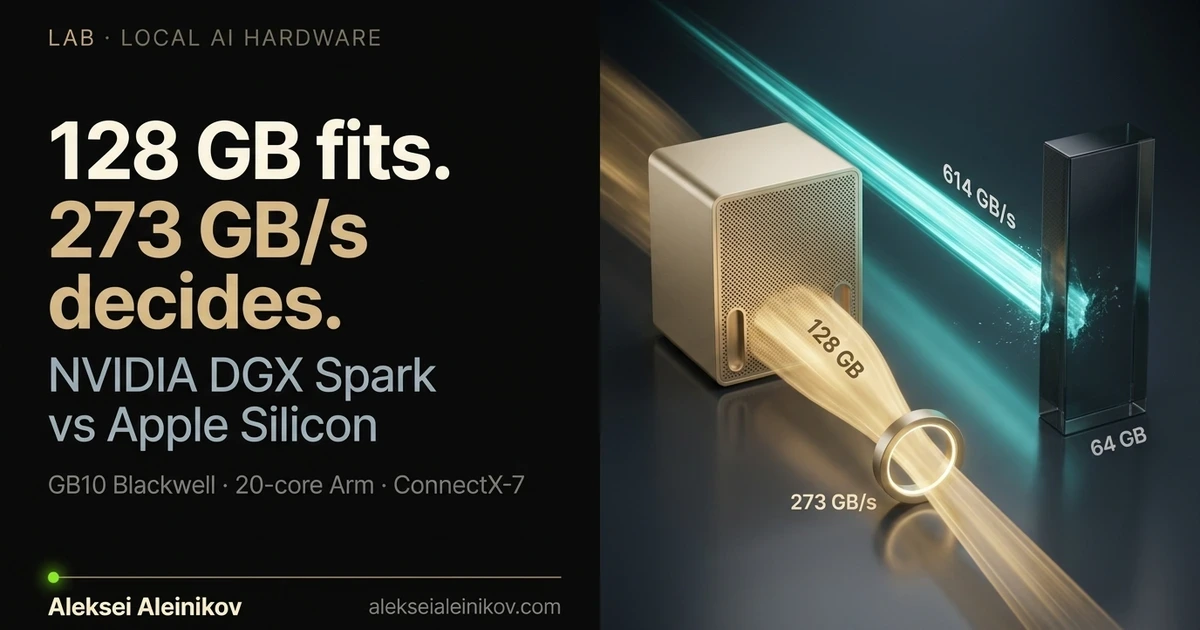
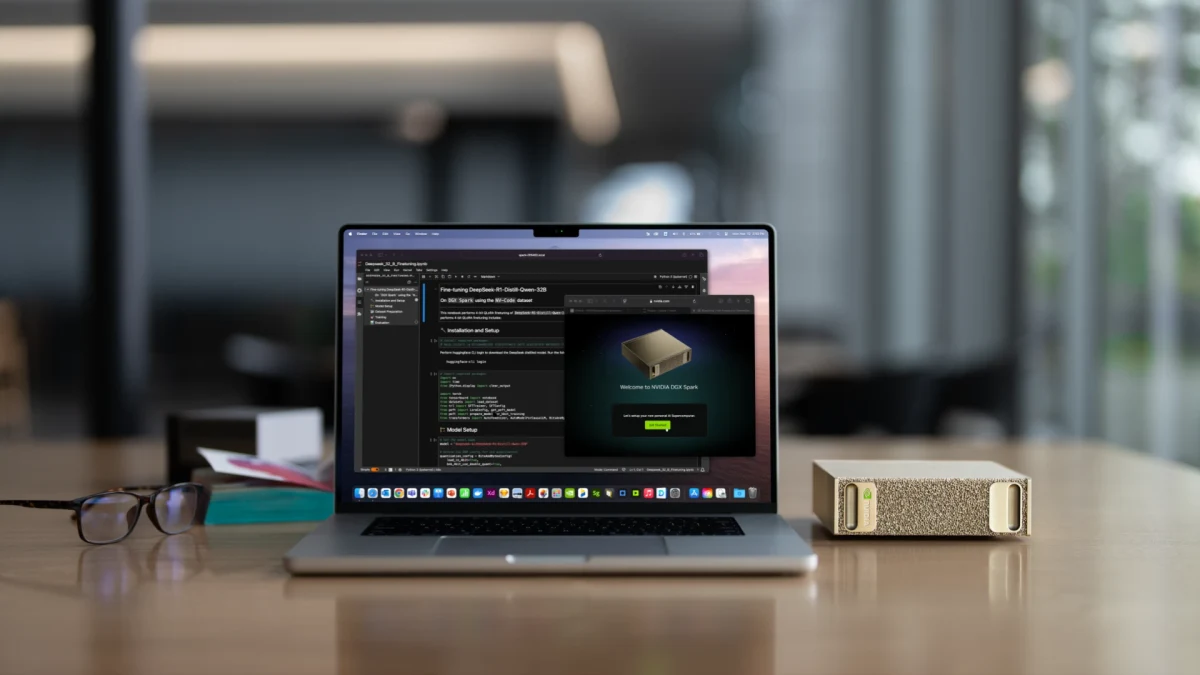
Lokale KI-Hardware erzwingt fast immer denselben Kompromiss: Diskrete GPUs sind extrem schnell, aber knapp beim VRAM; Unified-Memory-Workstations bieten viel Speicher, stoßen aber an die Busbreite. Der NVIDIA DGX Spark (auf Basis des GB10 Grace Blackwell Superchip) packt 128 GB kohärenten Unified Memory, 1 PetaFLOP sparse FP4-Rechenleistung und einen 200-Gb/s-ConnectX-7-SmartNIC in ein 150 × 150 mm kleines Desktop-Gehäuse.
Auf dem Papier wirkt das wie die perfekte Schreibtischlösung für 70B- bis 200B-Modelle. Ein Blick auf den Speicherbus zeigt jedoch ein differenzierteres Bild: 273 GB/s LPDDR5x-Bandbreite stehen Apple-Silicon-Konfigurationen mit 546 bis 819 GB/s gegenüber. Wer versteht, welcher Workload welches Limit trifft, vermeidet teure Fehlkäufe.
Unter der Haube: NVIDIA GB10 vs. Apple Silicon
Der NVIDIA GB10 Grace Blackwell Superchip verbindet eine 20-Kern-Armv9-CPU (10 Cortex-X925 Performance-Kerne + 10 Cortex-A725 Effizienz-Kerne) über einen kohärenten NVLink-C2C-Interconnect mit einer Blackwell-GPU samt Tensor Cores der 5. Generation. Statt diskretem GDDR-VRAM über PCIe teilen sich CPU und GPU 128 GB LPDDR5x-Speicher über ein 256-Bit-Interface mit 8,533 Gbps pro Pin — das ergibt 273 GB/s theoretische Spitzenbandbreite.
| Spezifikation | NVIDIA DGX Spark (GB10) | Apple M5 Max (40-Core GPU) | Apple M4 Max (Mac Studio) | RTX 5090 (Diskrete GPU) |
|---|---|---|---|---|
| Speicherkapazität | 128 GB Unified (64 GB OEM) | 64 GB Basis (48–128 GB BTO) | Bis 128 GB Unified | 32 GB GDDR7 |
| Speicherbandbreite | 273 GB/s (256-Bit LPDDR5x) | 614 GB/s | 546 GB/s | ~1.792 GB/s |
| KI-Rechenleistung | 1.000 TOPS FP4 (sparse) | Metal FP16 / BF16 | Metal FP16 / BF16 | ~3.352 TOPS FP4 (sparse) |
| Cluster-Interconnect | 200 Gb/s ConnectX-7 RDMA | Thunderbolt 5 (kein RDMA-NIC) | Thunderbolt 5 (kein RDMA-NIC) | PCIe / Host-Ethernet |
| Software-Ökosystem | CUDA, TensorRT-LLM, NIM, vLLM | Metal, MLX, llama.cpp | Metal, MLX, llama.cpp | CUDA, TensorRT-LLM, vLLM |
| Gehäuse & Leistung | 1,2 kg SFF · 240-W-Netzteil (~140 W TDP) | Laptop / Mobil-Envelope | Kompakt-Desktop | Full-ATX-Workstation (575 W GPU) |
| Referenzpreis | 3.999 $ Start / 4.699 $ UVP (Feb 2026) | Ab 3.599 $ Basis (64 GB BTO) | 3.699 $ (1 TB) / 4.699 $ (4 TB) | 1.999 $ UVP (nur GPU) |
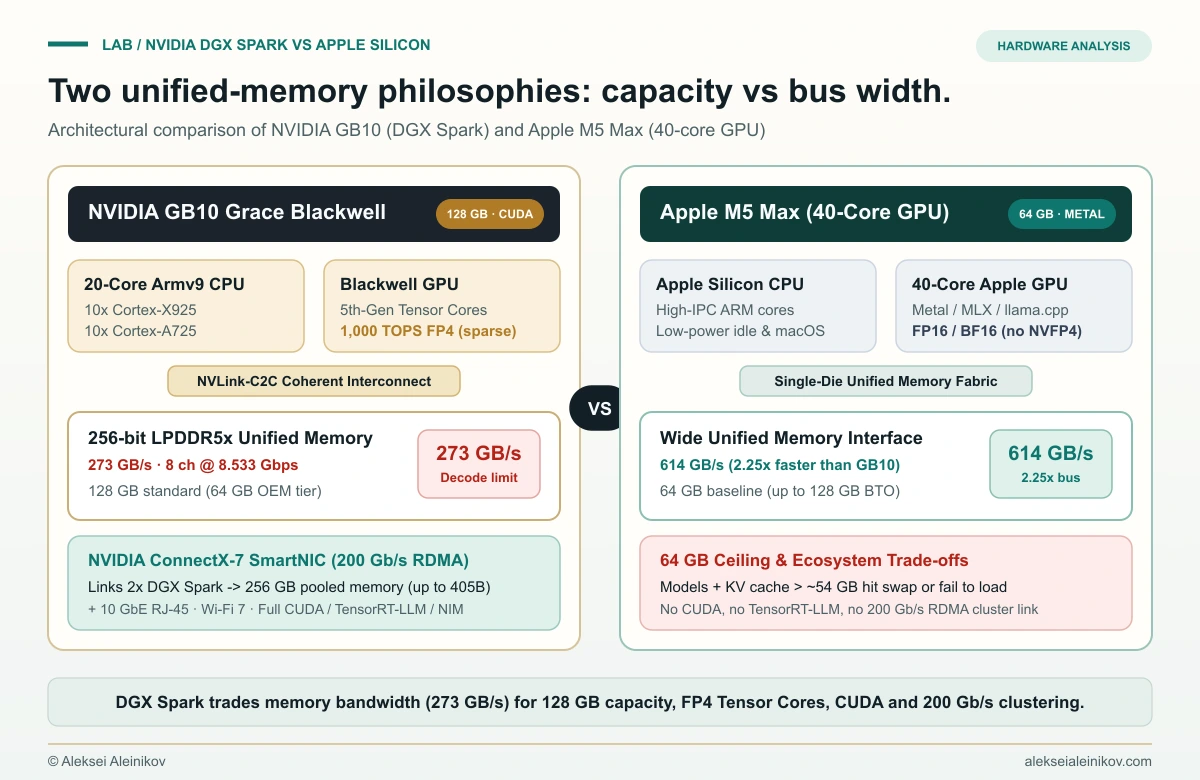
Diese einzige Designentscheidung — 256-Bit-LPDDR5x mit 273 GB/s — erklärt fast das gesamte Laufzeitverhalten des DGX Spark. NVIDIA hält Leistungsaufnahme (~140 W SoC-TDP) und Platinenfläche klein genug für einen 1,2-kg-Würfel, liefert aber gleichzeitig den vollständigen CUDA-, TensorRT-LLM- und NIM-Stack inklusive ConnectX-7.
Die Mathematik lokaler LLM-Inferenz: Speicher, Decode und Prefill
Für einen fairen Hardware-Vergleich müssen drei physikalische Limits getrennt betrachtet werden: Wie viel passt in den Speicher, wie schnell erscheinen neue Token (Decode) und wie schnell werden lange Prompts verarbeitet (Prefill).
1. Die Speicherbedarfs-Gleichung
Ein aktives LLM belegt Speicher für Modellgewichte, den Key-Value-(KV-)Cache und Laufzeitpuffer:
M_total = M_weights + M_KV(context_length, batch_size) + M_overhead
M_weights ≈ Parameters × (Bits_per_weight / 8)
Für ein dichtes 70B-Modell:
- Bei Q4_K_M (~4,6–4,8 Bit/Gewicht effektiv) belegen allein die Gewichte ~40,5 GB. Mit einem 32k-KV-Cache und Laufzeitpuffern landet man bei 48–52 GB — das passt gerade noch in 64 GB RAM (nach macOS/Linux-Overhead) und ist auf einer 32-GB-GPU unmöglich.
- Bei FP8 (~8 Bit/Gewicht) benötigen die Gewichte ~70 GB. Ein 64-GB-System scheitert komplett; die 128 GB des DGX Spark nehmen das Modell samt langem Kontext oder LoRA-Adaptern problemlos auf.
2. Warum 1 PetaFLOP den Einzelbenutzer-Chat nicht beschleunigt
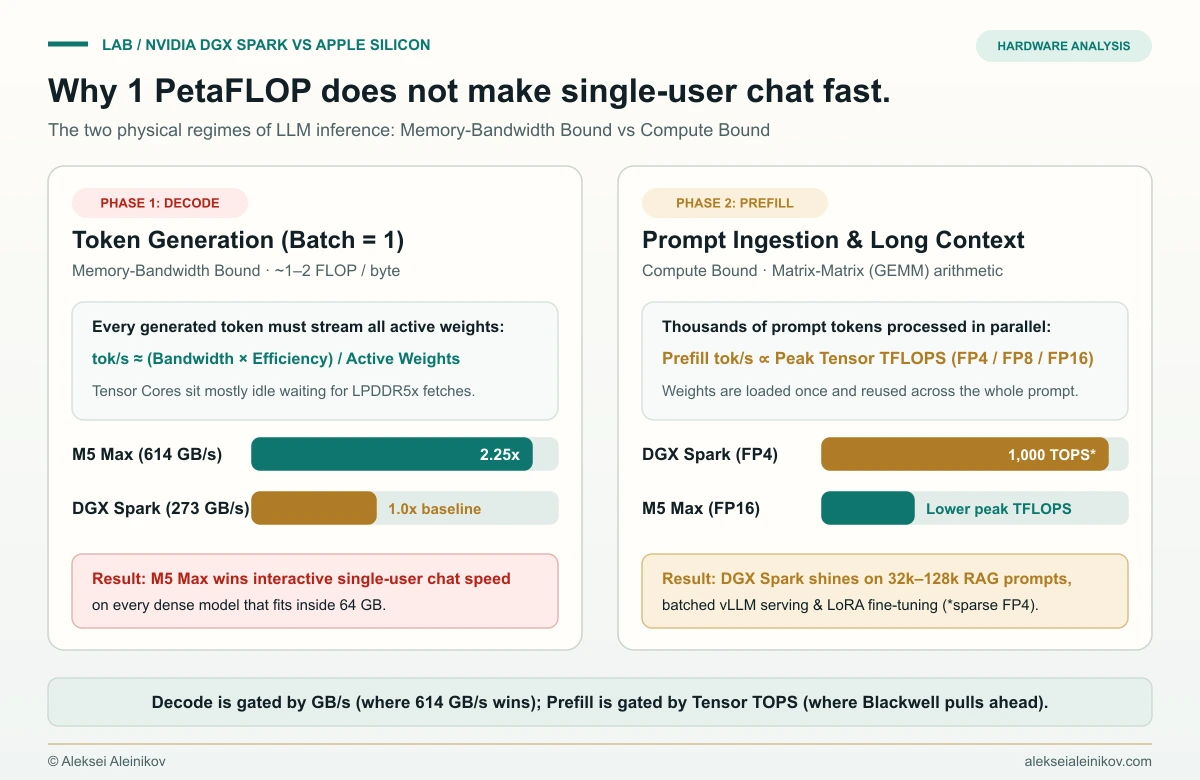
Bei der Einzelstream-Generierung (Batch-Größe = 1) liegt die arithmetische Intensität bei etwa 1 bis 2 FLOPs pro geladenem Byte. Die GPU kann das nächste Token erst berechnen, wenn alle aktiven Gewichte aus dem LPDDR5x-Speicher gestreamt wurden:
Decode Ceiling (tok/s) = (Memory Bandwidth × η) / Active_Weight_BytesDer Auslastungsfaktor η liegt in der Praxis meist zwischen 0,60 und 0,85 — abhängig von Kernel-Effizienz, Quantisierungsformat und KV-Cache-Zugriffen.
Rechnet man ein ~40,5 GB großes Q4_K_M-70B-Modell durch:
- DGX Spark (273 GB/s): Theoretische Obergrenze
273 / 40,5 = 6,74 tok/s. Mit realistischenη ≈ 0,65landet man bei ~4,4 tok/s — exakt im Bereich unabhängigerllama.cpp-Messungen von 4,0 bis 4,7 tok/s (und 2,7–3,0 tok/s in FP8vLLM). - Apple M5 Max (614 GB/s): Theoretische Obergrenze
614 / 40,5 = 15,16 tok/s. Mitη ≈ 0,78ergibt das ~11,8 tok/s (veröffentlichte Q4/Q5-Tests erreichen 15–18 tok/s) — mehr als doppelt so schnell für interaktives Lesen, solange Modell und Kontext unter ~54–56 GB nutzbarem Speicher bleiben.
3. Wo Blackwells 1.000 TOPS wirklich glänzen: Prefill & MoE
Beim Prefill (Einlesen eines 32k-Token-RAG-Prompts, einer Codebasis oder eines PDFs) werden tausende Eingabe-Token parallel als Matrix-Matrix-Multiplikationen (GEMM) berechnet. Die arithmetische Intensität steigt sprunghaft an — der Workload wird rechenlimitiert (compute-bound).
Hier spielen Blackwells Tensor Cores der 5. Generation (1.000 AI TOPS bei sparse FP4) ihre Stärke aus: Veröffentlichte Tests des DGX Spark erreichen ~800+ tok/s Prefill bei 70B-Modellen.
Der DGX Spark ist keine schnelle Einzelstream-Maschine für dichte 70B-Chats. Er ist eine Workstation für hohen Speicherbedarf, schnellen Prefill, Fine-Tuning und Mixture-of-Experts-(MoE)-Modelle — sowie Baustein für 256-GB-Cluster.
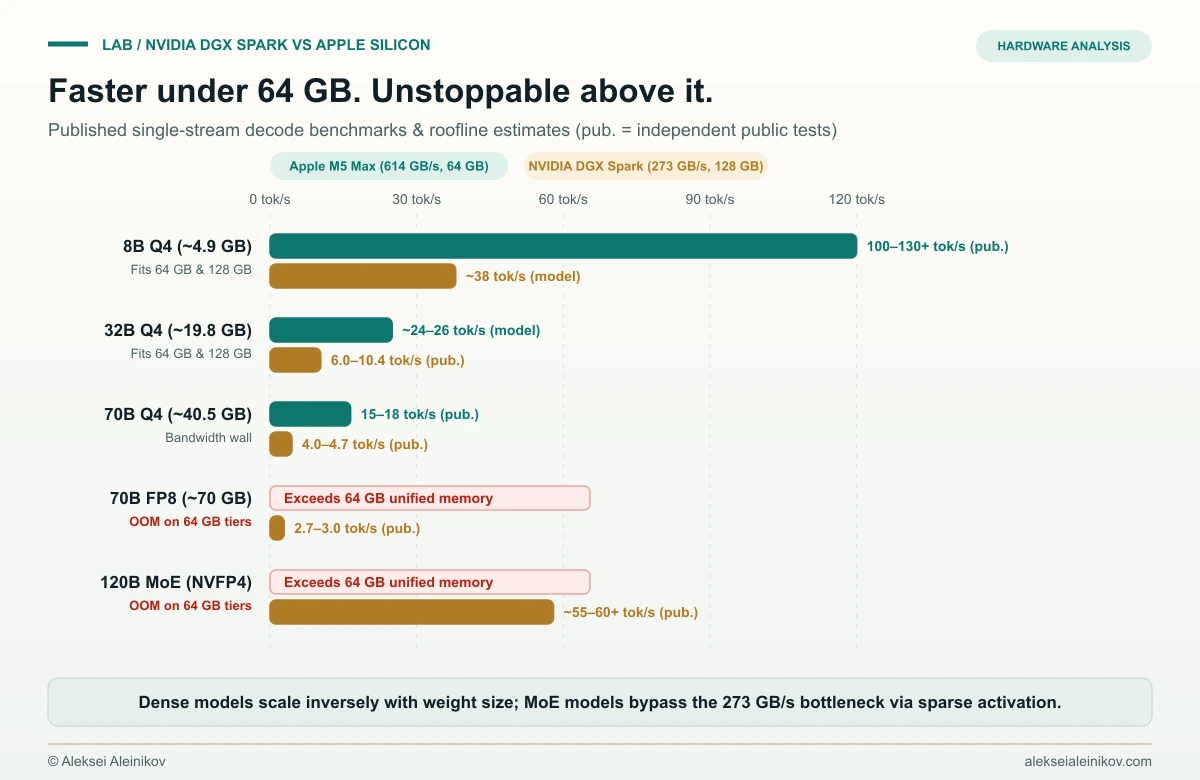
Genauso durchbrechen Mixture-of-Experts-(MoE)-Modelle (z. B. 120B-Klasse mit nur ~10–12B aktiven Parametern pro Token) das Decode-Limit. Alle 120B Gewichte liegen bequem in den 128 GB des DGX Spark, doch pro Token werden nur die aktiven Experten gestreamt — das katapultiert den DGX Spark auf 50–60+ tok/s, während 64-GB-Systeme das Modell gar nicht erst laden können.
Veröffentlichte Benchmarks vs. Roofline-Rechnung
Kombiniert man offizielle Bandbreitendaten mit veröffentlichten unabhängigen Tests (llama.cpp, MLX, vLLM), bestätigt sich die direkte Skalierung mit dem Speicherbus:
| Modellklasse | Gewichtsvolumen | Apple M5 Max (614 GB/s, 64 GB) | Apple M4 Max (546 GB/s) | NVIDIA DGX Spark (273 GB/s, 128 GB) |
|---|---|---|---|---|
| 8B Dense (Q4_K_M) | ~4,9 GB | 100–130+ tok/s (veröffentlicht) | 115–130 tok/s (veröffentlicht) | ~35–38 tok/s (Roofline-Schätzung, η ≈ 0,65) |
| 32B Dense (Q4_K_M) | ~19,8 GB | ~24–26 tok/s (Roofline, η ≈ 0,78) | ~21–23 tok/s (Roofline) | 6,0–10,4 tok/s (veröffentlicht Ollama/vLLM) |
| 70B Dense (Q4_K_M) | ~40,5 GB | 15–18 tok/s (veröffentlicht Q4/Q5) | 13–15,5 tok/s (veröffentlicht) | 4,0–4,7 tok/s (veröffentlicht llama.cpp) |
| 70B Dense (FP8) | ~70 GB | OOM (>64 GB Limit) | Passt in 128-GB-BTO-Tier | 2,7–3,0 tok/s (veröffentlicht vLLM; ~800+ tok/s Prefill) |
| 120B MoE (NVFP4 / Q4) | ~65–75 GB | OOM (>64 GB Limit) | Passt in 128-GB-BTO-Tier | ~55–60+ tok/s (veröffentlichte Community-Tests) |
Wie Quantisierungsstufen wie Q4_K_M, FP8 und NVFP4 den Speicherbedarf genau beeinflussen, ohne die Modellqualität zu zerstören, zeigt der vertiefende Leitfaden zur Modellkompression:
Quantisierung erklärt: Ein 70B-Modell auf normaler Hardware ausführen
ConnectX-7-Clustering und der CUDA-Vorteil
Unabhängig von der reinen GB/s-Zahl trennen zwei Eigenschaften den DGX Spark von jedem Mac:
- 200-Gb/s-ConnectX-7-Clustering: Jeder DGX Spark besitzt einen ConnectX-7-SmartNIC für 200 Gb/s RDMA über QSFP/DAC-Kabel. Zwei gekoppelte Geräte bündeln 256 GB Unified Memory und ermöglichen lokale Inferenz bis in die 405B-Klasse. Thunderbolt 5 bietet keine vergleichbare RDMA-Fabric für verteiltes Tensor-Parallel-Serving.
- Native CUDA-, TensorRT-LLM- und NIM-Parität: Läuft die Zielumgebung in der Produktion auf vLLM, TensorRT-LLM oder NVIDIA NIM, entfällt auf einer Linux-Blackwell-Maschine jede Portierung von Metal auf CUDA. Gerade beim Übergang vom Einzelchat zum parallelen Serving zeigt der Vergleich zwischen vLLM und Ollama als Inferenz-Server, wie Continuous Batching den Gesamtdurchsatz des DGX Spark unter Last vervielfacht.
Preisrealität und TCO: 3.999 $ Startpreis vs. 4.699 $ offizielle UVP
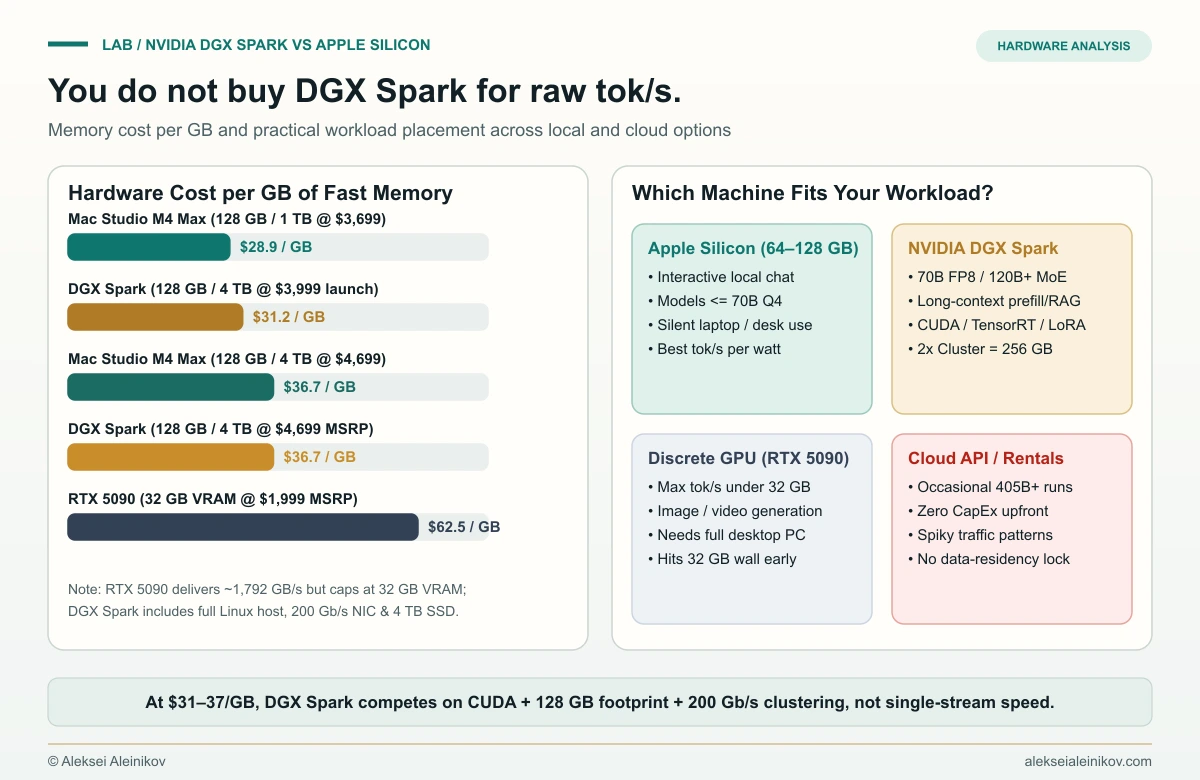
NVIDIA führte die 128-GB-/4-TB-Founders-Edition zu 3.999 US-Dollar UVP ein (~31,24 $ pro GB Unified Memory). Im Februar 2026 hob NVIDIA den offiziellen Store-Preis aufgrund weltweiter LPDDR5x-Engpässe auf 4.699 US-Dollar an, während regionale Händlerangebote teils bis auf 6.950 US-Dollar stiegen.
Bei 4.699 US-Dollar liegt der DGX Spark bei 36,71 $ pro GB — exakt auf dem Niveau eines Mac Studio M4 Max mit 128 GB und 4 TB SSD (4.699 $), der 546 GB/s (doppelte Bandbreite) liefert, dafür aber auf CUDA, FP4 Tensor Cores und ConnectX-7 verzichtet. Eine RTX 5090 (1.999 $ UVP) erreicht ~1.792 GB/s, kostet jedoch 62,47 $ pro GB VRAM (ohne Host-PC) und endet bei 32 GB.
Fazit: Für wen lohnt sich der DGX Spark wirklich?
- DGX Spark (128 GB) wählen, wenn 70B+-/120B+-MoE-Modelle, langer Context-Prefill, lokales QLoRA-Fine-Tuning, native CUDA/TensorRT-LLM/vLLM-Parität oder ein 256-GB-Zweiknoten-Cluster per ConnectX-7 gefragt sind.
- Apple Silicon (64–128 GB Mac Studio / MacBook Pro) wählen, wenn schneller, leiser Einzelbenutzer-Chat auf Modellen bis zum RAM-Limit im Vordergrund steht — hier liefern 546–819 GB/s grob doppelt so viele Token pro Sekunde und Watt.
- Diskrete GPU (RTX 5090) wählen, wenn das Modell sicher unter 32 GB VRAM bleibt und maximale Einzelstream-Geschwindigkeit oder Bild-/Videogenerierung zählt.
- Bei Cloud-APIs bleiben, wenn 405B+-Modelle nur sporadisch benötigt werden und sich 4.000–5.000 $+ CapEx nicht amortisieren.