Ein Jahrzehnt lang galt eine einfache Regel: Kleine Daten kommen in pandas, große in ein Data Warehouse, und alles dazwischen bekommt einen Spark-Cluster, den niemand pflegen will. DuckDB hat diese Regel leise gebrochen. Es ist eine vollwertige analytische SQL-Datenbank, die sich per pip installiert, in deinem Python-Prozess läuft und einen Ordner voller Parquet-Dateien schneller abfragt, als das Warehouse der meisten Teams eine Dashboard-Kachel liefert.
Genau deshalb wird DuckDB leicht überschätzt. Es ist kein BigQuery-Killer und auch kein schnelleres SQLite für deine App. Es ist etwas Spezifischeres, und sobald du seine Grenzen kennst, wird es zu einem der nützlichsten Werkzeuge im Datenstack. Dieser Leitfaden erklärt, was DuckDB ist, zeigt einen Benchmark, den du selbst wiederholen kannst, und zieht die Linie zwischen „nimm DuckDB“ und „du brauchst weiterhin das Warehouse“.
Was DuckDB eigentlich ist
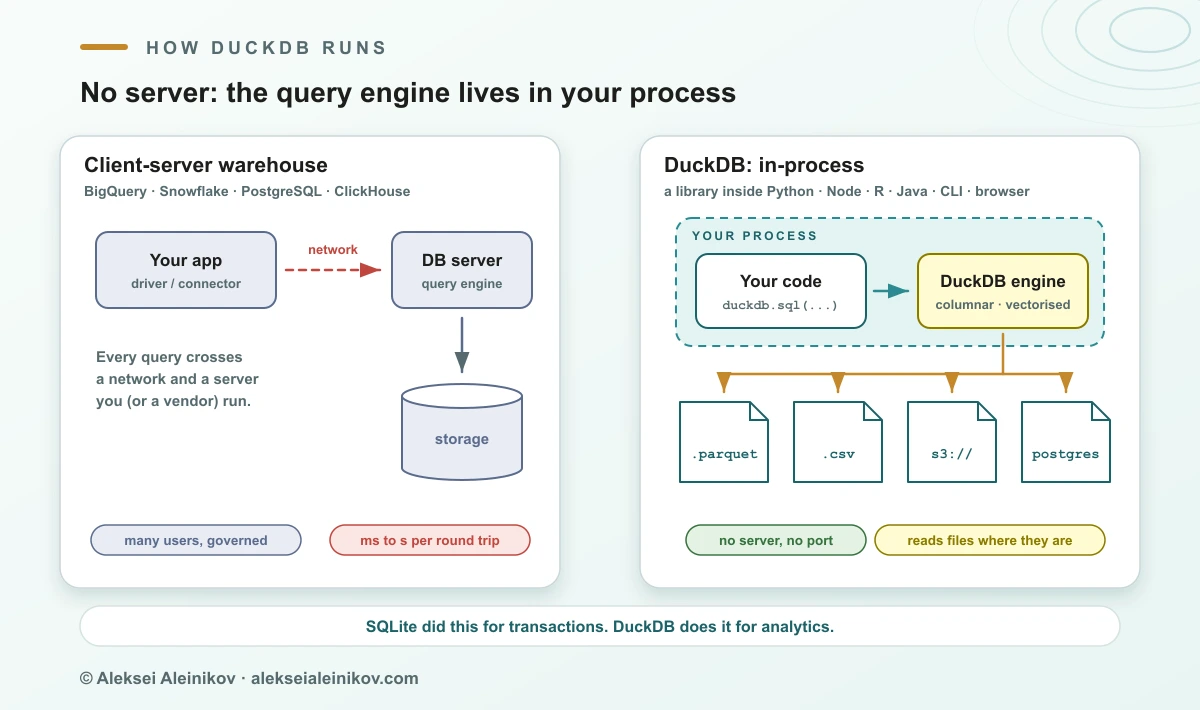
DuckDB ist eine In-Process-OLAP-Datenbank. Jedes dieser Wörter zählt:
- In-Process. Es gibt keinen Server. DuckDB ist eine Bibliothek, die in dein Programm eingebunden wird: Python, R, Node.js, Java, Go, Rust, die CLI, per WebAssembly sogar der Browser. Eine Datenbank ist eine einzige Datei oder liegt nur im Speicher. Nichts zu deployen, kein Port, kein Connection-Pool.
- OLAP. DuckDB ist für analytische Abfragen gebaut: Millionen Zeilen scannen, filtern, joinen, gruppieren, aggregieren. Daten werden spaltenweise gespeichert. Eine Abfrage, die fünf von hundert Spalten braucht, liest nur diese fünf.
- Vektorisiert. Statt Zeile für Zeile arbeitet die Engine auf Blöcken von Werten pro Spalte. Das hält die CPU-Caches gefüllt und nutzt alle Kerne.
DuckDB stammt aus der Datenbankforschung am CWI in Amsterdam, entwickelt von Mark Raasveldt und Hannes Mühleisen, erstmals 2019 veröffentlicht. Es steht unter der MIT-Lizenz und wird von der gemeinnützigen DuckDB Foundation verwaltet. Im August 2026 überschritt das Projekt 40.000 GitHub-Sterne, und im selben Monat kündigte DuckLabs, die Firma hinter der Entwicklung, an, zu AWS zu wechseln, mit dem ausdrücklichen Versprechen, dass DuckDB, DuckLake und Quack unter der Foundation MIT-lizenziert bleiben.
Die beste Kurzbeschreibung ist immer noch die alte: DuckDB ist SQLite für Analysen.
In fünf Minuten zur ersten Abfrage
Am schnellsten verstehst du DuckDB, wenn du es auf eine Datei richtest, die du ohnehin hast.
pip install duckdbimport duckdb
# Parquet-Dateien direkt abfragen: kein CREATE TABLE, kein Ladeschritt.duckdb.sql(""" SELECT payment_type, count(*) AS trips, avg(total_amount) AS avg_total FROM 'yellow_tripdata_2025-0*.parquet' GROUP BY payment_type ORDER BY trips DESC""").show()Was beim ersten Mal überrascht:
- Dateien sind Tabellen.
FROM 'data/*.parquet',FROM 'export.csv'undFROM 'events.json'funktionieren, mit Globbing und automatischer Schema-Erkennung. - DataFrames sind auch Tabellen. Liegt ein pandas- oder Polars-DataFrame namens
dfim Scope, fragtduckdb.sql("SELECT ... FROM df")ihn direkt ab, und.df()oder.pl()macht aus dem Ergebnis wieder einen. - Remote-Speicher ist nur ein Pfad. Mit der Erweiterung
httpfsfunktioniertFROM 's3://bucket/events/*.parquet'oder eine GCS- bzw. HTTPS-URL genauso, und DuckDB liest nur die Spalten und Row-Groups, die es braucht. - Es spricht Lakehouse. Erweiterungen lesen und schreiben Iceberg- und Delta-Tabellen und binden PostgreSQL-, MySQL- und SQLite-Datenbanken ein. Eine einzige SQL-Abfrage kann so eine Postgres-Tabelle mit Parquet auf S3 joinen.
Im Terminal macht die duckdb-CLI dasselbe, und duckdb -ui öffnet eine lokale Web-Oberfläche im Notebook-Stil.
Der Benchmark: 11,2 Millionen Taxifahrten auf dem Laptop
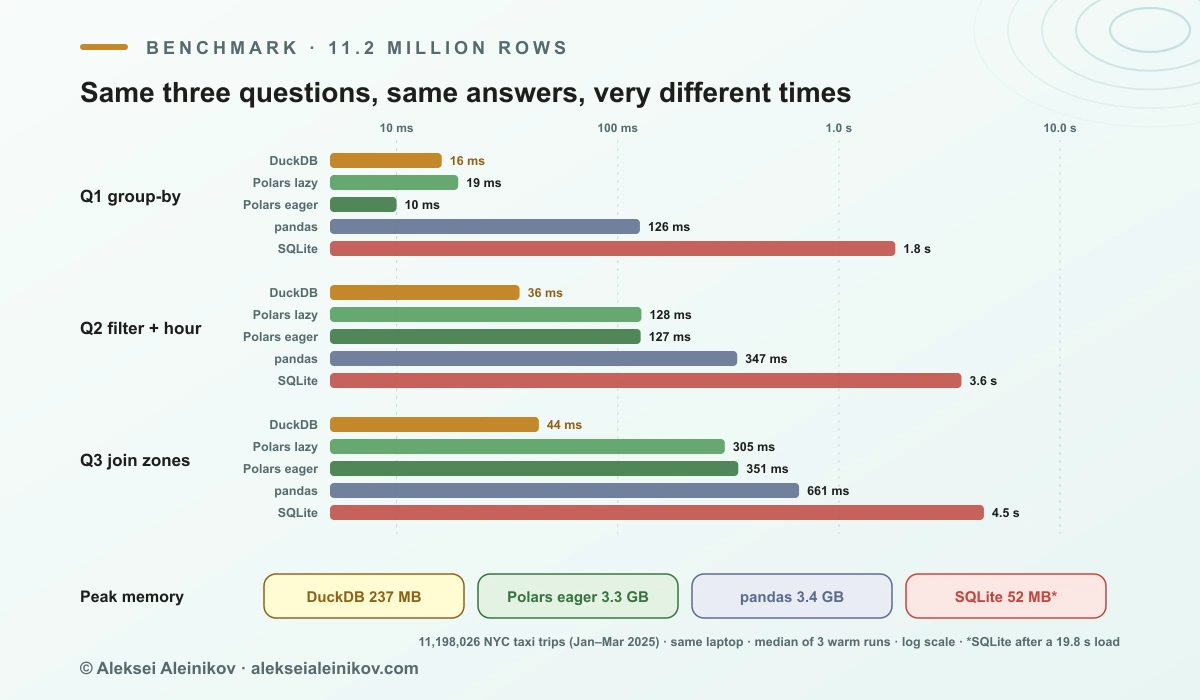
Aussagen wie „100-mal schneller“ sind billig, deshalb hier ein Test zum Nachmachen. Die Daten sind die öffentlichen Yellow-Taxi-Fahrten der New Yorker TLC von Januar bis März 2025: drei Parquet-Dateien, 189 MB, 11.198.026 Fahrten. Drei Fragen, die jede Analystin stellen würde:
- Q1: Fahrten und durchschnittlicher Betrag pro Zahlungsart (ein Group-by).
- Q2: Fahrten und durchschnittliche Strecke pro Tagesstunde, ohne Fahrten mit Strecke null (Filter, Zeitstempel-Funktion, Group-by).
- Q3: Die 10 umsatzstärksten Abholzonen (Join mit der Zonentabelle mit 265 Zeilen, Group-by, Sortierung).
Jede Engine lief in einem eigenen Prozess auf demselben Laptop. Jede Abfrage lief viermal; die Tabelle zeigt den Median der letzten drei Läufe. Alle Engines lieferten identische Ergebnisse (7.484.734 Kartenzahlungen mit durchschnittlich 28,47 $; JFK Airport vorn mit 31,4 Millionen $).
| Engine | Ladeschritt | Q1 | Q2 | Q3 | Speicher (Spitze) |
|---|---|---|---|---|---|
| DuckDB 1.5.6 (SQL auf Parquet) | keiner | 16 ms | 36 ms | 44 ms | 237 MB |
Polars 1.36 (lazy, scan_parquet) |
keiner | 19 ms | 128 ms | 305 ms | nicht gemessen |
| Polars 1.36 (eager, Daten im RAM) | 0,07 s | 10 ms | 127 ms | 351 ms | 3,3 GB |
| pandas 2.3 (Daten im RAM) | 1,5 s | 126 ms | 347 ms | 661 ms | 3,4 GB |
| SQLite 3.53 (Tabelle auf Disk) | 19,8 s | 1.800 ms | 3.584 ms | 4.529 ms | 52 MB |
Was die Zahlen ehrlich sagen:
- DuckDB vs. SQLite: etwa 100-mal schneller. Nicht weil SQLite schlecht ist, sondern weil es ein Zeilenspeicher für Transaktionen ist. Jede analytische Abfrage liest jede Spalte jeder Zeile. SQLite brauchte wenig Speicher, weil es von der Platte streamte, musste die Daten aber erst 20 Sekunden lang in eine 529-MB-Datei laden.
- DuckDB vs. pandas: 8- bis 15-mal schneller, ein Fünfzehntel des Speichers. pandas muss erst alle 11 Millionen Zeilen in den RAM holen (1,5 s, 3,4 GB). DuckDB streamt die Parquet-Dateien und hält nie den ganzen Datensatz.
- DuckDB vs. Polars: gleichauf bei Einfachem, vorn bei Joins. Polars lag bei Q1 gleichauf und ist eine hervorragende DataFrame-Bibliothek. Bei Q2 und Q3 war DuckDB in diesem Setup 3,5- bis 7-mal schneller. Deine Abfragen können anders aussehen; die ehrliche Erkenntnis ist, dass beide in einer anderen Liga spielen als pandas.
Die Speicherspalte ist die wichtigste. Ein Laptop mit 16 GB kann keine 50 GB in pandas laden, aber DuckDB fragt sie trotzdem ab: Es streamt, was passt, und lagert auf die Platte aus, was nicht passt. Im März 2026 ließ das DuckDB-Team alle 99 TPC-DS-Abfragen mit Skalierungsfaktor 300 auf dem günstigsten MacBook mit 8 GB RAM laufen: fertig in 79 Minuten.
DuckDB vs. SQLite, Polars, pandas, ClickHouse, Spark und BigQuery
Die meisten „DuckDB vs. X“-Fragen sind eigentlich die Frage: Welche Art von Problem liegt vor? Hier die ganze Familie auf einer Seite:
| DuckDB | SQLite | Polars | pandas | ClickHouse | Spark | BigQuery / Snowflake | |
|---|---|---|---|---|---|---|---|
| Was es ist | Eingebettete Analyse-SQL-DB | Eingebettete Transaktions-SQL-DB | DataFrame-Bibliothek (Rust) | DataFrame-Bibliothek | Spaltenorientierter DB-Server | Verteilte Compute-Engine | Verwaltetes Cloud-Warehouse |
| Läuft als | Bibliothek im Prozess | Bibliothek im Prozess | Bibliothek im Prozess | Bibliothek im Prozess | Server oder Cluster | Cluster | Cloud-Dienst |
| Stark bei | SQL-Analysen auf Dateien und DataFrames | Vielen kleinen Lese- und Schreibzugriffen | DataFrame-Pipelines | Kleinen Daten, großem Ökosystem | Echtzeit-Analysen, vielen Nutzern | ETL im Terabyte-Bereich | Gemeinsamen, kontrollierten Analysen in jeder Größe |
| Schwach bei | Vielen gleichzeitigen Schreibern | Scans und Aggregationen | SQL-orientierten Teams | Speicher, Tempo bei Größe | Einbettung, Betriebsaufwand | Kleinen Daten (Overhead) | Latenz, Kosten häufiger Scans |
| Daten größer als RAM | Ja, lagert auf Disk aus | Ja (zeilenweise) | Ja, Streaming-Engine | Nein | Ja | Ja | Ja |
| Wählen, wenn | Eine Person oder ein Job, MB bis Hunderte GB | Die eigenen Daten einer App | Du in DataFrames denkst | Daten locker in den RAM passen | Dashboards für Hunderte Nutzer | Daten nicht auf eine große Maschine passen | Eine Firma eine gemeinsame Wahrheit teilt |
Drei Unterscheidungen erledigen den Großteil:
- DuckDB vs. SQLite ist OLAP vs. OLTP. Behalte SQLite (oder PostgreSQL) für den Zustand deiner Anwendung, nimm DuckDB, um ihn zu analysieren. DuckDB kann die SQLite-Datei sogar per
ATTACHeinbinden und direkt abfragen. - DuckDB vs. Polars ist vor allem SQL vs. DataFrame-API. Beide sind schnell, beide streamen, und sie tauschen Daten über Arrow ohne Kopien aus. Nimm das, was dein Team leichter liest.
- DuckDB vs. ClickHouse ist eingebettet vs. Server. ClickHouse bedient aus einem Cluster Hunderte gleichzeitige Dashboard-Nutzer; DuckDB sitzt in einem einzigen Programm.
Wo DuckDB das Warehouse schlägt und wo nicht
Der nützlichste Rahmen für DuckDB ist nicht „statt BigQuery“, sondern „vor und neben BigQuery“.
DuckDB gewinnt, wenn:
- eine Person oder ein Job die Fragen stellt: eine Analystin im Notebook, ein nächtlicher Batch-Job, ein CI-Test.
- die Daten eine Datei oder ein Extrakt sind: Parquet auf S3 oder GCS, ein CSV-Export, ein Ausschnitt des Warehouse.
- Latenz wichtiger ist als Skalierung: 40 ms in einer Notebook-Schleife schlagen jeden Zwei-Sekunden-Roundtrip zu einem Cloud-Dienst.
- du Tests für Datencode willst. Ein dbt-Projekt oder eine SQL-Transformation läuft in der CI in Sekunden gegen eine DuckDB-Datei, ohne Cloud-Zugangsdaten. dbt v2 (September 2026) bringt den DuckDB-Adapter direkt mit.
Das Warehouse gewinnt weiterhin, wenn:
- viele Menschen und Dienste gleichzeitig dieselben Daten brauchen, mit Rollen, Audit-Logs, Row-Level-Security und Freigaben.
- die Daten viele Terabyte erreichen oder Abfragen regelmäßig mehr scannen, als eine große Maschine schnell lesen kann.
- du verwalteten Betrieb brauchst: Backups, Hochverfügbarkeit, Governance und jemand anderes in Rufbereitschaft.
Und das Kostenargument ist subtiler, als der Hype nahelegt. Die fünf oben genutzten Spalten ergeben für 11,2 Millionen Zeilen weniger als ein halbes Gigabyte. In BigQuery On-Demand kostet eine Abfrage über alle fünf bei 6,25 $ pro gescanntem TiB, nach dem kostenlosen ersten TiB pro Monat, etwa einen Viertelcent. Bei dieser Größe spart DuckDB kein Geld, sondern den Roundtrip. Das Kostenargument beginnt, wenn Dashboards und geplante Jobs den ganzen Tag Terabytes neu scannen. Dann kann ein stabiler Extrakt als Parquet, abgefragt mit DuckDB, eine echte Zeile von der Rechnung streichen. Wenn du noch beim Warehouse selbst schwankst, lies BigQuery vs. Snowflake: Ein ehrlicher Vergleich.
DuckDB ersetzt nicht das Warehouse. Es ersetzt den Cluster, den du gerade für Daten bauen wolltest, die auf eine Maschine passen, und die hundert kleinen Abfragen, die du nur zum Anschauen in die Cloud geschickt hast.
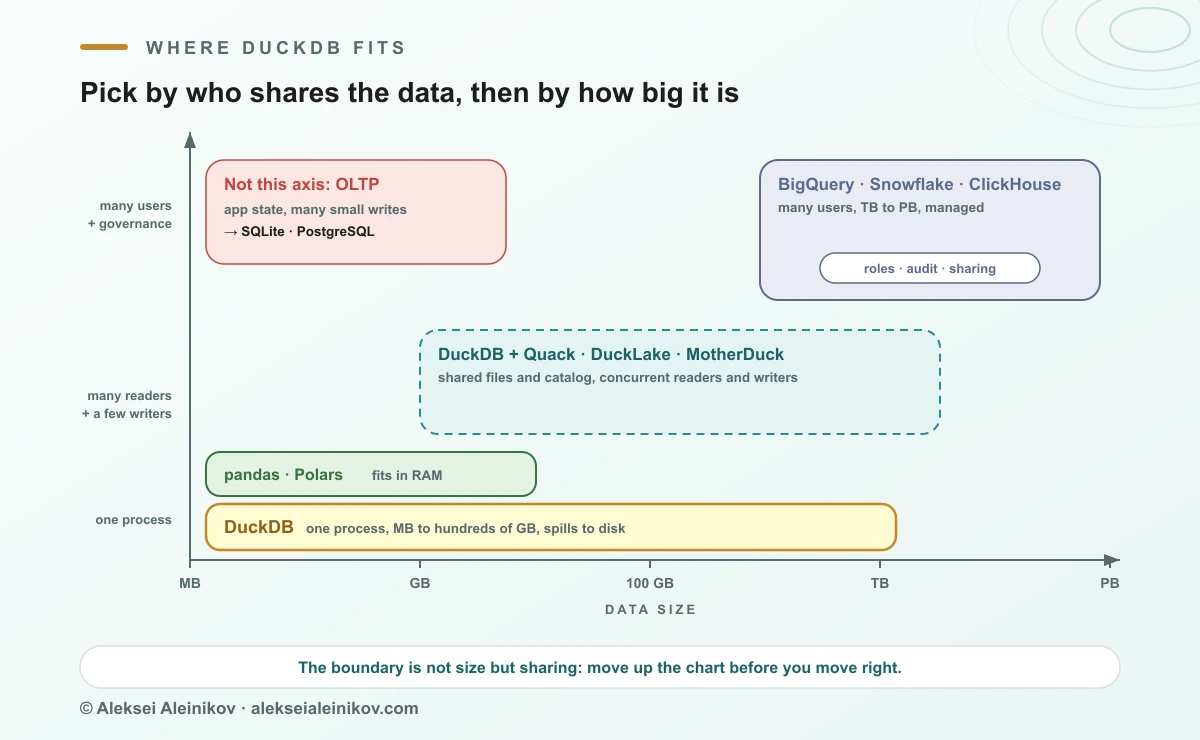
Die echte Grenze ist Nebenläufigkeit, nicht Größe
Die meisten erwarten, dass DuckDB an der Datenmenge scheitert. In der Praxis ist die Grenze: Wer schreibt sonst noch?
Im reinen In-Process-Modus kann ein Prozess eine Datenbankdatei lesend und schreibend öffnen, mit beliebig vielen Threads, oder viele Prozesse öffnen sie nur lesend. Zwei Dienste können nicht gleichzeitig in dieselbe .duckdb-Datei schreiben. Das ist ein bewusster Kompromiss: Den Zustand im Speicher eines Prozesses zu halten, ist ein Grund für das Tempo.
Zwei Entwicklungen aus 2026 verschieben diese Grenze:
- Quack, DuckDBs eigenes Client-Server-Protokoll. Seit Mai 2026 als Vorschau verfügbar, lässt es jeden DuckDB-Prozess seine Datenbanken per HTTP bereitstellen, und jede andere DuckDB bindet sie per
ATTACHein. In den Benchmarks des Teams übertrug Quack 60 Millionen Zeilen in 4,9 Sekunden, das PostgreSQL-Protokoll brauchte 158, und schaffte mit acht Threads rund 5.400 kleine Schreibtransaktionen pro Sekunde, mehr als PostgreSQL auf denselben Maschinen. Mit DuckDB 2.0 wird Quack stabil. - DuckLake, ein Lakehouse-Format auf SQL-Basis. Die Daten liegen als Parquet im Objektspeicher; der Katalog (welche Dateien welche Tabellenversion bilden) liegt in einer echten Datenbank wie PostgreSQL. Viele DuckDB-Instanzen können dann gleichzeitig dieselben Tabellen lesen und schreiben. DuckLake 1.0 wurde im April 2026 für produktionsreif erklärt. Es löst dasselbe Problem wie Iceberg und Delta, mit einem einfacheren Katalog; die Abwägung zwischen diesen beiden steht in Iceberg vs. Delta Lake: Ein verständlicher Leitfaden.
Wer nichts davon selbst betreiben will, nimmt MotherDuck: DuckDB in der Cloud mit Speicher, Rechenleistung pro Nutzer, Freigaben und Zugriffskontrolle. Die Preise umfassen einen kostenlosen Lite-Plan (10 GB Speicher, 10 Stunden Rechenzeit pro Monat) und einen Business-Plan für 250 $ pro Organisation und Monat plus Nutzung. Die EU-Regionen Frankfurt und Dublin sind für DSGVO-bewusste Teams in Deutschland ein wichtiger Punkt.
Was neu ist in DuckDB 2.0
DuckDB 2.0 mit dem Codenamen „Cyanoptera“ steht im Release-Kalender für den 21. Oktober 2026, ein Bugfix-Release 2.0.1 ist für November geplant. Die Vorschau nennt über 10.000 Commits seit Version 1.5. Die Neuerungen, die die Nutzung verändern:
- DuckDB als Server. Quack wird stabil, und die neue Anweisung
CONNECTrichtet deine Sitzung auf eine entfernte DuckDB oder auf PostgreSQL bzw. MySQL aus und schiebt das SQL dorthin, wo es ausgeführt wird. VARIANTals vollwertiger Typ. Semistrukturierte Daten (etwa JSON-Logs) werden automatisch in Spalten zerlegt. Sie komprimieren und lassen sich abfragen wie typisierte Daten, ohne dass du ein Schema deklarierst.- Trigger,
BEFOREundAFTER, pro Zeile oder pro Anweisung: Audit-Tabellen ohne Anwendungscode. - Asynchrones I/O in der ganzen Engine, mit den größten Gewinnen auf S3 und anderem Netzwerkspeicher.
NEAREST-Joins für Top-k-Ähnlichkeitssuche über Embeddings, nützlich, wenn du abwägst, ob du überhaupt eine eigene Vektordatenbank brauchst.- Ein neues Speicherformat und ein neuer PEG-basierter SQL-Parser, dazu wenige Breaking Changes. Von 2.0 geschriebene Dateien nutzen standardmäßig das neue Format; pinne also Versionen, bevor du gemeinsam genutzte Dateien aktualisierst.
Wenn dir Stabilität wichtiger ist als Features: Die Linie 1.4 ist das Long-Term-Support-Release mit Support bis November 2026; ab 1.4 ist jede zweite Minor-Version LTS.
Ein praktischer Einstieg
Du brauchst keinen Migrationsplan, um von DuckDB zu profitieren. Fang klein an:
- Ersetze den langsamsten pandas-Schritt in einem Notebook durch
duckdb.sql(...)auf demselben DataFrame oder derselben Parquet-Datei und lass den Rest, wie er ist. - Exportiere eine stabile Warehouse-Tabelle einmal täglich als Parquet und richte explorative Arbeit auf die Datei statt aufs Warehouse.
- Lass deine SQL-Transformationen in der CI gegen DuckDB laufen, damit ein kaputtes Modell im Pull Request scheitert und nicht in Produktion.
- Erst dann entscheide, ob du gemeinsamen Zugriff über MotherDuck, Quack oder DuckLake brauchst oder ob das Warehouse einfach die gemeinsame Wahrheit bleibt.
Behalte das Modell im Kopf: ein Prozess, spaltenorientiert, vektorisiert, liest Dateien dort, wo sie liegen. Alles, worin DuckDB glänzt, folgt daraus, und ebenso alles, wofür es nicht gebaut ist. Wenn du es zuerst in die großen Datenbankfamilien einordnen willst, beginne mit SQL vs. NoSQL: Datenbanktypen richtig wählen.
Fazit
DuckDB verdient seinen Hype bei einem engen, aber sehr häufigen Problem: Eine Person oder ein Job stellt analytische Fragen an Daten, die auf eine Maschine passen. Dort ist es schneller als pandas, weit schneller als SQLite, bei den meisten Aufgaben mindestens so schnell wie Polars, und es braucht keinerlei Infrastruktur. Es ist kein gemeinsames Warehouse, und wer das ignoriert, landet bei Dateisperren-Fehlern. Nutze es vor und neben BigQuery oder Snowflake, nicht statt ihnen, und behalte die Nebenläufigkeit im Blick: Mit Quack und DuckLake verschiebt sich die Grenze zwischen „Laptop-Datenbank“ und „richtiger Datenbank“ schneller als jeder andere Teil des Datenstacks.
Aus der Community
Diskussion auf Mastodon & Bluesky
Antworten auf diesen Artikel aus dem offenen Netz, live geladen. Keine Werbung, keine Tracking-Skripte.
Antworte dort — es erscheint hier automatisch.