
Während PostgreSQL 18 mit dem asynchronen I/O-Subsystem (io_uring und Worker-Threads) vor allem die rohe Storage-Geschwindigkeit verbessert hat, liefert PostgreSQL 19 genau die Betriebs- und Entwickler-Features, auf die DBA- und Backend-Teams seit Jahren gewartet haben.
Statt für Online-Wartung externe Extensions pflegen zu müssen oder bei jedem Major-Upgrade Plan-Regressionen zu fürchten, bringt PostgreSQL 19 natives REPACK (CONCURRENTLY), pg_plan_advice, INSERT ... ON CONFLICT DO SELECT, paralleles Index-Autovacuum und automatisch skalierendes Async I/O direkt im Core – zusammen mit einigen neuen Defaults und pg_upgrade-Blockern, die eine blind übernommene postgresql.conf aus v18 sofort stoppen.
Das kurze Urteil: Lohnt sich das Upgrade von 18 auf 19? Ja – besonders für schreibintensive OLTP-Cluster mit Tabellen-Bloat (
REPACK (CONCURRENTLY)+ paralleles Index-Autovacuum) und hohe Concurrency (ON CONFLICT DO SELECT). Prüfe jedoch vorab deinepostgresql.conf: Der alte v18-Parameterio_workersführt beim Start zuFATAL,jitsteht jetzt aufoff– und SQL/PGQ-Graphabfragen haben es doch nicht in den Release geschafft.
PostgreSQL 19 vs. 18 im direkten Überblick
Die meisten Upgrade-Entscheidungen hängen davon ab, ob der Mehrwert ein pg_upgrade-Wartungsfenster rechtfertigt. Im direkten Vergleich zu PostgreSQL 18 punktet Version 19 vor allem bei Betrieb, SQL-Komfort und Defaults:
| Bereich | PostgreSQL 18 | PostgreSQL 19 | Auswirkung in Produktion |
|---|---|---|---|
| Async I/O (AIO) | Festes io_workers (io_uring / Worker, ~3× schnellere Cold-Scans) |
Auto-Scaling io_min_workers / io_max_workers + EXPLAIN (ANALYZE, IO) |
Passt sich Cloud-Storage-Lastspitzen an; altes io_workers entfernt |
| Online-Komprimierung | VACUUM FULL (blockiert R/W) oder externes pg_repack |
Natives REPACK & REPACK (CONCURRENTLY) |
Bloat-Bereinigung ohne Downtime direkt im Core |
| Autovacuum | Sequenzielle Index-Bereinigung pro Tabelle | Paralleles Index-Autovacuum + gewichtetes Bloat-/Alters-Scoring | Weniger Wartungsrückstau auf großen Multi-Index-Tabellen |
| Plan-Stabilität | Externes pg_hint_plan oder SQL-Umbau |
Core pg_plan_advice + pg_stash_advice |
JOIN_ORDER / HASH_JOIN gezielt fixieren ohne Code-Deploy |
| Upsert / Get-or-Create | ON CONFLICT DO NOTHING + zweites SELECT |
INSERT ... ON CONFLICT DO SELECT [FOR UPDATE] RETURNING |
Atomar in einem Round-Trip, weniger Race Conditions |
| JIT-Standard | jit = on (seit v12) |
jit = off |
Verhindert zufällige JIT-Latenzspitzen bei kurzem OLTP |
| TOAST-Kompression | pglz Standard |
lz4 Standard (default_toast_compression) |
Schnelleres Packen/Entpacken von JSONB und Text |
| Lock-Diagnose | log_lock_waits = off |
log_lock_waits = on |
Sofortige Sichtbarkeit bei Lock-Wartezeiten > 1 s |
| Logical Replication | Neustart nötig für wal_level-Wechsel |
Aktivierung aus wal_level = replica ohne Neustart + Sequences |
Zero-Downtime-CDC und sauberer Failover |
1. Natives REPACK (CONCURRENTLY): Das Ende von pg_repack?
Jahrelang gab es bei massivem Table Bloat nur zwei unbequeme Wege: VACUUM FULL / CLUSTER (sperrt mit ACCESS EXCLUSIVE sämtliche Lese- und Schreibzugriffe) oder externe Tools wie pg_repack / pg_squeeze.
PostgreSQL 19 integriert die Online-Komprimierung nativ über REPACK und REPACK (CONCURRENTLY):
-- Online-Komprimierung ohne Blockade laufender Reads oder WritesREPACK (CONCURRENTLY) orders;
-- Tabelle physisch entlang eines Index neu ordnen (ersetzt blockierendes CLUSTER)REPACK (CONCURRENTLY) orders USING INDEX orders_created_at_idx;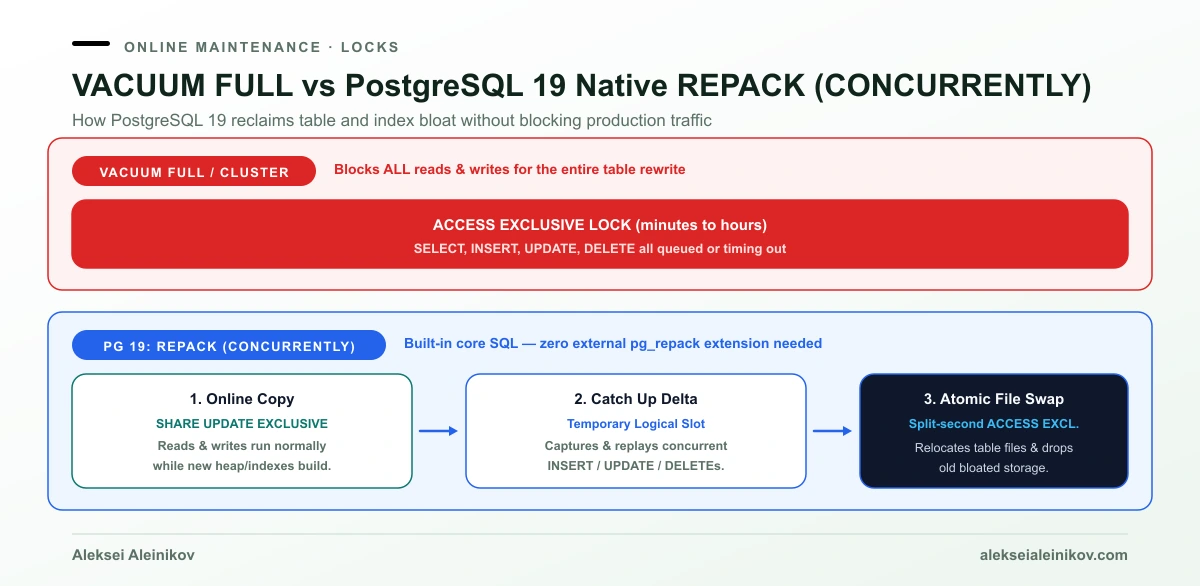
Unter der Haube arbeitet REPACK (CONCURRENTLY) sauber nach dem Online-Migrations-Muster:
- Setzt nur ein leichtes
SHARE UPDATE EXCLUSIVELock, sodassSELECT,INSERT,UPDATEundDELETEnormal weiterlaufen. - Nutzt einen temporären Logical-Replication-Slot, um Änderungen während der Kopierphase aufzufangen.
- Hält
ACCESS EXCLUSIVEnur für den Sekundenbruchteil des finalen Dateitauschs.
Zusammen mit dem parallelen Index-Autovacuum und dem neuen gewichteten Autovacuum-Scoring (Tabellenalter, Bloat-Anteil, Zeit seit dem letzten Lauf) bleiben große Tabellen deutlich länger sauber – besonders in Kombination mit der passenden Wahl der PostgreSQL-Indextypen (B-tree, GIN, BRIN).
2. pg_plan_advice: Stabile Ausführungspläne ohne Code-Änderung
Jeder DBA kennt das Risiko nach einem Major-Upgrade: 99 % der Queries werden schneller, aber eine zentrale Abfrage kippt nach ANALYZE vom Hash Join in einen Nested Loop und legt die CPU lahm.
Mit pg_plan_advice und pg_stash_advice liefert PostgreSQL 19 erstmals offizielle Core-Module für Plan-Stabilität. Über Query-IDs lassen sich gezielte Plan-Vorgaben (JOIN_ORDER, HASH_JOIN, SEQ_SCAN, INDEX_SCAN) hinterlegen, ohne ORM-Queries im Anwendungscode umschreiben zu müssen.
3. INSERT ... ON CONFLICT DO SELECT: Atomares Get-or-Create
Beim klassischen Get-or-Create-Muster musste man bislang entweder ON CONFLICT DO NOTHING mit einem zweiten SELECT kombinieren oder Savepoints gegen unique_violation nutzen.
PostgreSQL 19 löst das mit INSERT ... ON CONFLICT DO SELECT nativ in einem Statement:
INSERT INTO api_clients (external_id, tier)VALUES ('tenant-42', 'pro')ON CONFLICT (external_id) DO SELECT FOR UPDATERETURNING id, tier, created_at;Das spart Netzwerk-Round-Trips, verhindert Race Conditions und vermeidet unnötigen Subtransaktions-Overhead unter hoher Last.
Zusätzlich vereinfacht PostgreSQL 19 JSON-Exporte mit COPY ... TO ... (FORMAT JSON) (wahlweise als NDJSON-Stream oder per FORCE_ARRAY als einzelnes JSON-Array) und macht row_to_json()-Workarounds überflüssig:
-- Zeilen als NDJSON streamen oder mit FORCE_ARRAY als JSON-Array ausgebenCOPY (SELECT id, tier FROM api_clients) TO STDOUT (FORMAT JSON, FORCE_ARRAY);(Hinweis: FORMAT JSON gilt vorerst nur für COPY TO, noch nicht für COPY FROM.)
4. Neue Produktions-Defaults: jit = off, lz4-TOAST & Live Logical Replication
Mehrere stille Standard-Änderungen in PostgreSQL 19 wirken sich direkt auf Latenz, CPU und Betrieb aus:
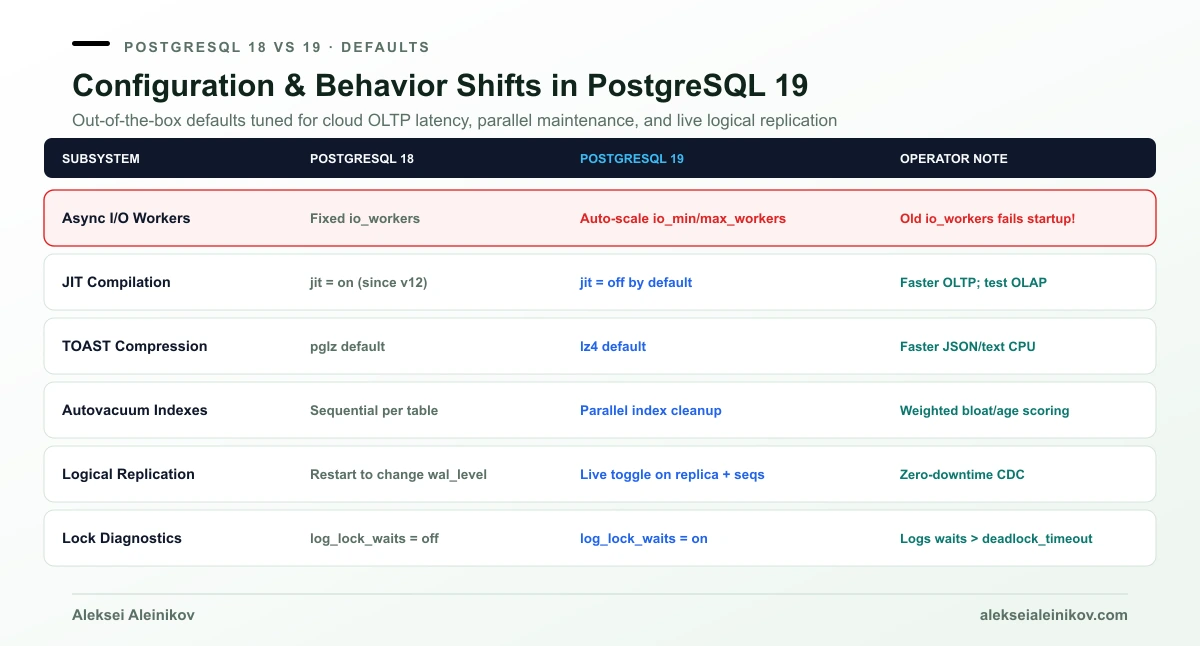
jit = offals Standard: Seit v12 aktiv, führte LLVM-JIT bei kurzen OLTP-Queries oft zu Latenzspitzen statt Tempo. Der neue Standard schützt OLTP-Systeme – wer schwere OLAP-Aggregationen fährt, solltejit = onnach dem Upgrade gezielt testen.default_toast_compression = lz4: Neue TOAST-Daten (jsonb, lange Texte) nutzen nunLZ4stattpglzund entlasten die CPU bei minimalem Kompressionsunterschied. Bestehende Zeilen bleiben bis zum Update unverändert.log_lock_waits = on& prozessspezifischeslog_min_messages: Lock-Wartezeiten überdeadlock_timeout(1 Sekunde) landen nun automatisch im Log, undlog_min_messagesakzeptiert kommaseparierte Prozess-Level (etwa getrennt fürcheckpointerund normalebackend-Prozesse).- Logical Replication ohne Neustart + Sequences: Aus
wal_level = replicalässt sich Logical Replication im laufenden Betrieb aktivieren – inklusive logischer Replikation von Sequence-Werten. - Schnellere Foreign-Key-Prüfungen & skalierendes AIO: Schreibintensive Foreign-Key-Workloads laufen spürbar schneller,
io_min_workers/io_max_workersskalieren Async-I/O-Worker automatisch undEXPLAIN (ANALYZE, IO)zeigt exakte I/O-Werte.
5. Der Graph-Mythos: Warum SQL/PGQ wieder aus PostgreSQL 19 flog
Wer nach PostgreSQL-19-Features sucht, stößt häufig auf frühe Beta-Artikel zu CREATE PROPERTY GRAPH und GRAPH_TABLE (SQL/PGQ aus SQL:2023).
Die Faktenlage: Zwar war SQL/PGQ in frühen Betas enthalten, doch vor Beta 4 zogen die Core-Committer rund 47 Commits komplett zurück, um Katalog-Komplexität und langfristige Standard-Fallen zu vermeiden.
SQL/PGQ ist in PostgreSQL 19.0 nicht enthalten und frühestens für PostgreSQL 20 vorgesehen. Wer heute Graph-Abfragen braucht, greift weiterhin zu Apache AGE oder prüft anhand unseres Leitfadens Brauchst du eine Graphdatenbank?, ob ein dediziertes System sinnvoll ist.
Checkliste vor pg_upgrade (18 → 19): Blocker & Breaking Changes
Bevor du pg_upgrade auf einem v18-Cluster startest, solltest du diese sechs Punkte abarbeiten:
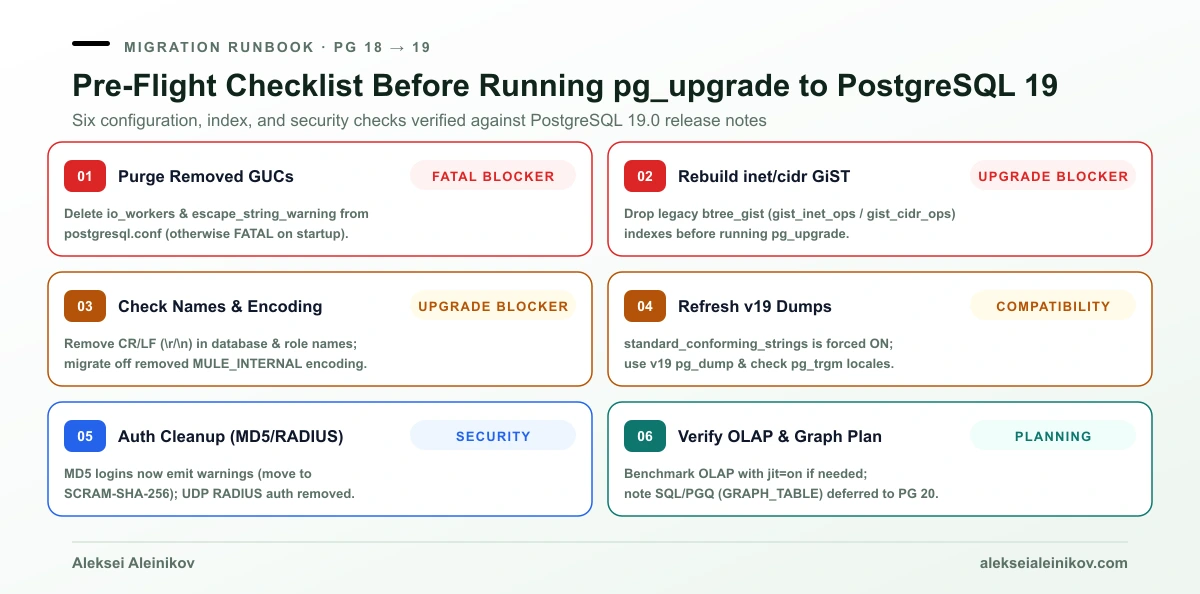
io_workersundescape_string_warningauspostgresql.confentfernen:io_workersaus v18 wurde durchio_min_workers/io_max_workersersetzt. Bleiben die alten Parameter stehen, bricht der Start mitFATAL: configuration file contains errorsab.- Alte
btree_gist-Indizes aufinet/cidrprüfen:pg_upgradestoppt, wenn noch Indizes mit altengist_inet_ops- odergist_cidr_ops-Operatorklassen existieren. Vorher auf die eingebauten Operatorklassen umstellen. - Keine
\r/\nin Datenbank- oder Rollennamen: Steuerzeichen in Namen werden blockiert (ebenso wurdeMULE_INTERNALentfernt). - Dumps mit v19-Tools aktualisieren:
standard_conforming_stringsist fest aufonerzwungen; ältere Dumps mitoffschlagen beim Einspielen fehl. Beipg_trgm/tsvectorggf. Locale-Provider prüfen und reindizieren. - OLAP-Performance mit
jit = offtesten: Bei analytischen Workloadsjit = ongezielt pro Datenbank oder Rolle wieder setzen. - Security-Aufräumen (
MD5&RADIUS): ErfolgreicheMD5-Logins erzeugen nun Server-Warnungen (md5_password_warnings, zusätzlich gibt espassword_expiration_warning_thresholdmit 7 Tagen) – aufSCRAM-SHA-256migrieren. UDP-RADIUSwurde komplett gestrichen.
Wann sich das Upgrade jetzt lohnt
- Früh umsteigen, wenn du schreibintensive OLTP-Cluster unter v17/v18 (oder Container-Setups wie PostgreSQL in Docker für Produktion) betreibst, regelmäßig mit Bloat kämpfst (
REPACK (CONCURRENTLY)) oder viele Get-or-Create-Upserts (ON CONFLICT DO SELECT) fährst. - Auf
19.1/19.2warten bei hochkonservativen Core-Systemen – und die Zeit nutzen, umio_workersaus Terraform/Helm-Templates zu entfernen undMD5-Rollen aufSCRAM-SHA-256umzustellen.
Aus der Community
Diskussion auf Mastodon & Bluesky
Antworten auf diesen Artikel aus dem offenen Netz, live geladen. Keine Werbung, keine Tracking-Skripte.
Antworte dort — es erscheint hier automatisch.