Apples Open-Source-Projekt apple/container startete als schlanke Swift-Runtime, um Linux-Container als leichtgewichtige Micro-VMs direkt auf Apple Silicon auszuführen. Mit container cluster (ursprünglich als container k8s gestartet und ab Release 1.6.1 zu container cluster umbenannt) liefert Apple nun native Kubernetes-Cluster auf macOS – ganz ohne Docker Desktop.
Viele Social-Media-Posts belassen es bei der Schlagzeile „Apple schafft Docker Desktop ab“. Für DevOps- und Platform-Teams steckt der eigentliche Mehrwert jedoch in den technischen Details: wie die Micro-VM-Topologie pro Node funktioniert, wie sich heterogene Worker und Cilium CNI konfigurieren lassen, warum Apple vor --shared-image-store warnt und welche Grenzen im Alltag noch gelten.
Das kurze DevOps-Fazit.
container clusterist schnell, nativ und sauber für ephemere Multi-Node-Tests, eigene CNI-Labs (wie Cilium) und Versions-Checks mit verschiedenenkindest/node-Images auf Apple Silicon + macOS 26+. Für langlebige lokale Umgebungen taugt es aber noch nicht: Gestoppte Cluster lassen sich nicht wieder aufnehmen, sondern müssen neu angelegt werden – und--shared-image-storegehört nicht in Cluster mit nicht vertrauenswürdigen Manifesten.
Wie sich Apples Architektur von Docker Desktop und Lima unterscheidet
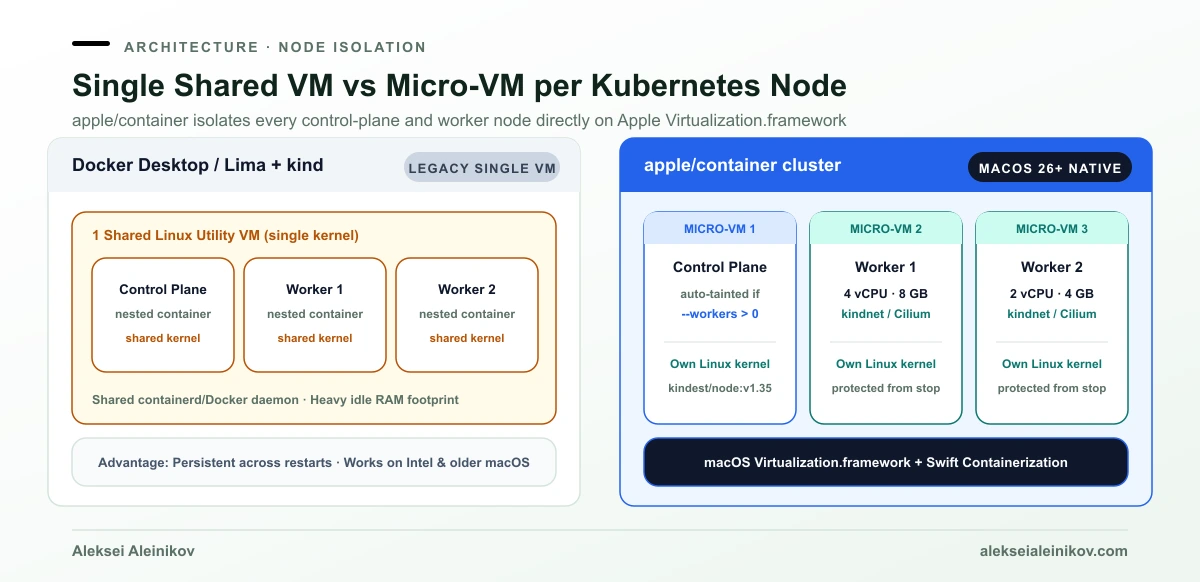
Klassische Mac-Container-Tools (Docker Desktop, Colima, Lima, Rancher Desktop) starten eine einzige große Linux-VM und betreiben darin containerd oder Docker. Ein 3-Node-kind-Cluster schachtelt dann Kubernetes-Nodes als Container innerhalb derselben VM.
apple/container dreht dieses Prinzip über macOS’ natives Virtualization.framework und Apples Swift-Paket Containerization um (ähnlich der Micro-VM-Isolation aus unserem Vergleich microVMs: Firecracker vs. gVisor):
- Eigene Micro-VM pro Node (
vminitd, kein Idle-RAM-Ballast): Control Plane und jeder Worker-Node starten mit Apples schlankem Swift-Init (vminitd) als isolierte Linux-Micro-VM direkt überVirtualization.framework– ohne QEMU, ohne Lima-Wrapper, ohne geteilten Kernel und ohne dauerhaft laufende Monolith-VM, die im Leerlauf 2–4 GB RAM blockiert. - Schutz vor versehentlichem
container stop: Technisch ist jeder Node ein Container, dochcontainer listblendet Cluster-Nodes selbst mit--allaus.container stopodercontainer deleteauf einen Node-Namen melden „not found“, damit die Control Plane nicht aus Versehen abgeschossen wird. (Lese- und Debug-Befehle wiecontainer logs,container exec,container inspectundcontainer statsfunktionieren weiterhin.) - Standard-
kindest/node-Kompatibilität: Standardmäßig nutzt der Clusterkindest/node:v1.35.5und schreibt den Kontext automatisch in~/.kube/config, sodasskubectl,helmundk9ssofort funktionieren.
Voraussetzungen und Einrichtung (geprüfte Befehle)
Apple beschränkt apple/container ausdrücklich auf Macs mit Apple Silicon ab macOS 26 – Intel-Macs und ältere macOS-Releases werden nicht unterstützt, da neue Virtualisierungs- und Netzwerk-APIs von macOS 26 vorausgesetzt werden.
1. Installation und Start des Systemdienstes
Lade das signierte .pkg-Paket von der apple/container Release-Seite herunter, installiere es unter /usr/local und starte den Dienst:
container system start2. Ersten Cluster starten
# Standard-Cluster anlegen (Name: "cluster-dev")container cluster create
# Cluster-Status prüfen (--nodes zeigt einzelne Nodes)container cluster list --nodes
# Automatisch eingetragenen kubectl-Kontext testenkubectl --context cluster-dev get nodes -o wide
Ohne weitere Flags kombiniert der Standard-Node Control Plane und Worker und erhält 1/4 der Host-CPUs (mindestens 2) sowie 1/4 des Host-RAMs (mindestens 2 GB).
3. Multi-Node-Cluster mit unterschiedlich dimensionierten Workern
Für Platform-Engineers, die Taints, Pod-Scheduling oder Affinity realistisch testen wollen, ist --workers besonders praktisch. Sobald --workers > 0 gesetzt ist, taintet apple/container die Control Plane automatisch, sodass Pods nur auf Workern eingeplant werden:
# Control Plane (2 vCPU, 4 GB) + 2 große Worker + 1 kleiner Workercontainer cluster create --name staging \  --cpus 2 --memory 4g \  --workers count=2,cpus=4,memory=8g \  --workers count=1,cpus=2,memory=4g
# Taints und Node-Größen prüfenkubectl --context staging get nodes -o wide
# Cluster-Node direkt inspizieren (stop/delete sind blockiert, logs/stats/exec funktionieren)container stats staging-worker-1container logs staging-control-plane
Worker-Nodes heißen <cluster-name>-worker-<n> und übernehmen das --node-image der Control Plane. Für kurzlebige Wegwerf-Runs empfiehlt sich --rm (container cluster create --name temp --rm). Zudem pflegt Apple im offiziellen Repository ein Referenz-Setup für eine Three-Tier-App hinter einem Gateway (container-cluster-gateway).
4. Mehrere Kubernetes-Versionen parallel testen
Um Helm-Charts oder API-Deprecations gegen verschiedene Kubernetes-Releases zu prüfen, lässt sich --node-image pro Cluster überschreiben:
container cluster create --name k8s-134 --node-image docker.io/kindest/node:v1.34.11container cluster create --name k8s-135 --node-image docker.io/kindest/node:v1.35.5
kubectl config get-contexts
kindnet durch Cilium CNI ersetzen
Standardmäßig installiert container cluster das einfache CNI kindnet. Wer in Produktion Cilium als CNI nutzt und eBPF-NetworkPolicies lokal testen möchte, kann über --cni ein eigenes Manifest übergeben.
Wichtiger Stolperstein: --cni erwartet eine fertige Kubernetes-YAML-Datei (kein Helm-Chart), und Ciliums Standard-IPAM (cluster-pool, 10.0.0.0/8) kollidiert mit den Pod-/Service-CIDRs von kubeadm. Deshalb muss das Chart vorab mit ipam.mode=kubernetes gerendert werden:
helm repo add cilium https://helm.cilium.io/helm repo update
helm template cilium cilium/cilium \  --version 1.20.1 \  --namespace kube-system \  --set ipam.mode=kubernetes > cilium.yaml
container cluster create --name cilium-lab --cni ./cilium.yamlkubectl --context cilium-lab get pods -n kube-system
Die --shared-image-store-Sicherheitsfalle
Ein oft genannter Vorteil von apple/container ist die direkte Nutzung lokal gebauter Images (container build) im Cluster – ohne Push in Docker Hub, GHCR oder eine lokale Registry.
Dafür muss beim Anlegen des Clusters explizit --shared-image-store gesetzt werden:
container cluster create --name dev --shared-image-storecontainer build -t my-service:dev .kubectl --context dev run my-service --image=my-service:dev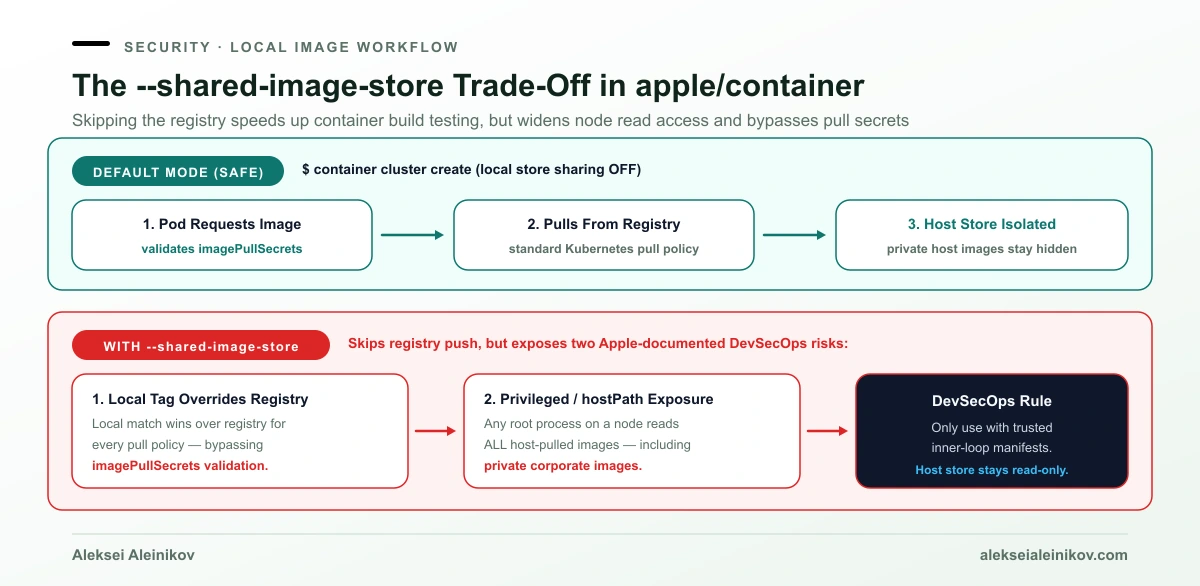
Aus gutem Grund ist diese Option standardmäßig deaktiviert. Apples Dokumentation nennt zwei kritische Risiken:
- Alle privaten lokalen Images werden für Root auf dem Node lesbar: Jeder privilegierte Pod oder Pod mit
hostPath-Mount kann sämtliche Images in deinem lokalen Image-Store auslesen – inklusive privater Images, die zuvor mit Firmen-Credentials gepullt wurden. - Lokale Tags übersteuern Registry-Pulls ohne Secrets: Existiert ein Image mit gleichem Namen im lokalen Store, zieht der Node immer zuerst das lokale Image – unabhängig von der
imagePullPolicyund ohne Prüfung vonimagePullSecrets. - Tag-Wiederverwendung: Wird
my-service:devunter demselben Tag neu gebaut, behalten Nodes beiimagePullPolicy: IfNotPresentdie alte Version. Entweder einen neuen Tag vergeben oderimagePullPolicy: Alwayssetzen.
Faustregel: --shared-image-store nur in vertrauenswürdigen Inner-Loop-Clustern verwenden, in denen du jedes Manifest selbst kontrollierst.
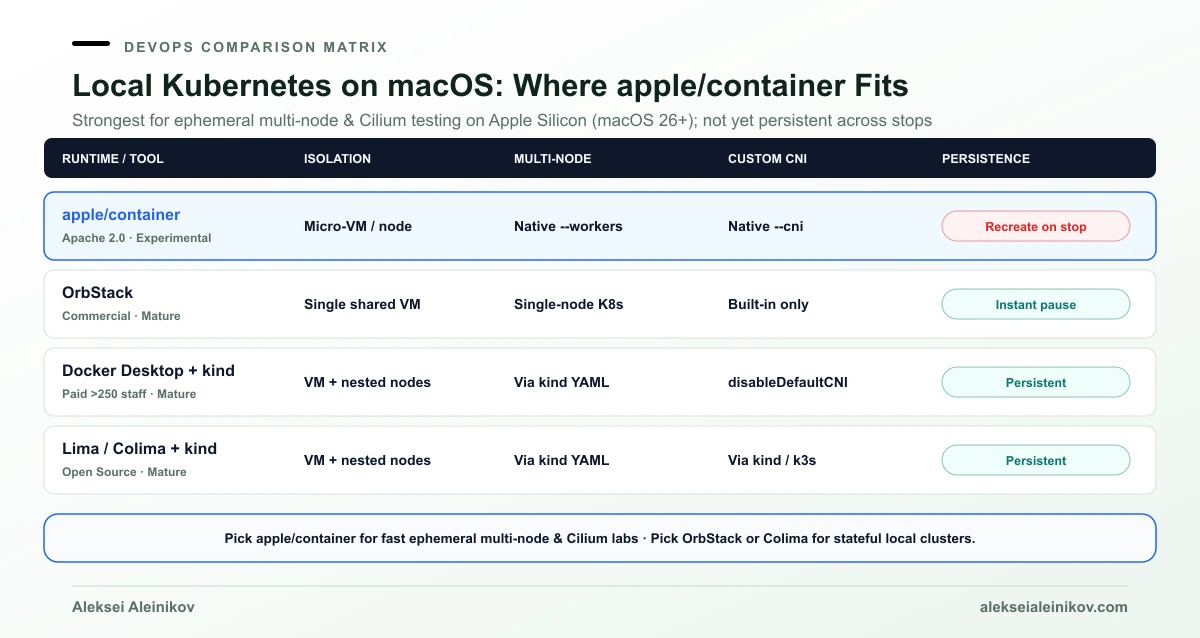
Ehrlicher Vergleich: apple/container vs. OrbStack vs. Docker Desktop + kind vs. Lima
Wie schlägt sich apple/container im Vergleich zu den etablierten Mac-Werkzeugen (oder Rootless-Alternativen wie Podman)?
| Kriterium | apple/container (cluster) |
OrbStack | Docker Desktop + kind |
Lima / Colima |
|---|---|---|---|---|
| Isolationsmodell | Eigene Micro-VM pro Kubernetes-Node (Virtualization.framework) |
Eine extrem schnelle Linux-VM | Eine schwere Linux-VM + verschachtelte kind-Container |
Eine Linux-VM (VZ oder QEMU) |
| OS-Anforderung | Apple Silicon + macOS 26+ | macOS 12.3+ (Apple Silicon & Intel) | macOS 12+ | macOS 12+ |
| Multi-Node & Sizing | Nativ über --workers count=...,cpus=...,memory=... + Auto-Taint |
Single-Node-K8s | Multi-Node über kind-Config |
Eine VM (Multi-Node über kind) |
| Eigenes CNI (Cilium) | Nativ via --cni ./cilium.yaml |
Begrenzte Anpassung | Über kind (disableDefaultCNI) |
Über k3s / kind |
| Stop / Resume (Persistenz) | Nein (gestoppter Cluster muss gelöscht & neu erstellt werden) | Ja (sofortiges Pausieren) | Ja (übersteht Neustarts) | Ja |
| Lizenz & Reifegrad | Open Source (Apache 2.0) · Experimentell | Kommerziell (privat kostenlos) · Ausgereift | Kommerziell (kostenpflichtig >250 MA / >10 Mio. $) · Ausgereift | Open Source (Apache 2.0 / MIT) · Ausgereift |
Vier reale Einschränkungen vor dem Umstieg
- Kein Pause/Resume für Cluster: Nach
container system stop, einem Reboot oder einem Stopp der Control Plane lässt sich ein Cluster nicht einfach fortsetzen – er muss percontainer cluster deleteundcontainer cluster createneu aufgebaut werden. Auch--rm-Cluster hinterlassen nach dem Stopp zunächst einenstopped-Eintrag bis zum Löschen oder Überschreiben. - Experimenteller Status: Apple garantiert für
container clusternoch keine CLI-Abwärtskompatibilität über Major-Releases hinweg (wie bereits die Umbenennung voncontainer k8szucontainer clusterin Version1.6.1zeigte). - Harte Grenze macOS 26+: Gemischte Teams mit Intel-Macs oder älteren macOS-Versionen können
apple/containernoch nicht als einheitlichen Standard ausrollen. - Kein eingebauter LoadBalancer / Ingress (und kein natives Compose): Wie bei reinem
kindstehen zunächst nur Cluster, DNS undkindnet(bzw. das eigene--cni) bereit – fürLoadBalancer-Services oder Ingress braucht es weiterhin Tools wie Envoy Gateway, ingress-nginx oder Community-Wrapper wiekiac. Ebenso fehlt außerhalb von Kubernetes ein eingebautesdocker compose-Äquivalent (nötig sind Drittanbieter-Wrapper wiecontainer-compose).
Was Entwickler in der Praxis berichten
In Erfahrungsberichten auf Reddit (r/MacOS, r/kubernetes, r/docker), Dev.to und Substack zeichnen frühe Nutzer ein sehr klares Bild zwischen Begeisterung und typischen V1-Kanten:
- Was gelobt wird: Wegfall der Docker-Desktop-Lizenzkosten und der schweren Dauer-VM, schnelle Bootzeiten auf Apple Silicon, saubere Kernel-Isolation pro Node sowie das schnelle Wachstum von Community-Projekten wie
kiac(Multi-Node-k3s/kubeadm mit Cilium eBPF und LoadBalancer) undrke2-silicon. - Was im Alltag stört: Eigenheiten beim Host-Container-Netzwerk und Dateisystem-Mounts im Vergleich zum extrem runden OrbStack, fehlendes Pause/Resume nach einem Neustart sowie CLI-Umbrüche im experimentellen Stadium (wie die Umbenennung von
container k8szucontainer clusterin1.6.1).
Wann sich der Einsatz jetzt schon lohnt
- Ideal für: schnelle, wegzwerfbare Multi-Node-Tests auf Apple Silicon, Kubernetes-Versionsvergleiche (
v1.34vs.v1.35), Cilium-CNI-Labs und Inner-Loop-Entwicklung ohne Docker-Desktop-Lizenzkosten. - Noch bei OrbStack oder Colima +
kindbleiben, wenn lokale Cluster Neustarts überdauern müssen, das Team noch auf älteren macOS-Versionen/Intel arbeitet oder stabile Compose- und K8s-Workflows ohne experimentelle CLI-Änderungen Pflicht sind.