Ihr Pager geht um drei Uhr nachts: Die Checkout-Latenz hat sich verdoppelt. Das Dashboard zeigt die Spitze, die Logs aus zwölf Services zeigen nichts Auffälliges, und niemand kann sagen, welcher der vierzig Aufrufe hinter einem Checkout langsam ist. Diese Lücke – zwischen irgendetwas stimmt nicht und genau das stimmt nicht – schließt Observability, und OpenTelemetry ist das Werkzeug, mit dem die meisten Teams sie heute schließen.
Gleichzeitig gehört es zu den am häufigsten missverstandenen Projekten der Cloud-native-Welt. Viele installieren es in der Erwartung eines Monitoring-Produkts und finden eine Spezifikation, ein Dutzend SDKs und einen Collector mit Hunderten Komponenten. Dieser Leitfaden zeigt, wie die Teile zusammenpassen, wie Daten tatsächlich vom Code ins Backend gelangen, wie Sie das Ganze auf Kubernetes betreiben, ohne in Konfiguration zu ertrinken, und welche Entscheidungen es in der Produktion günstig oder teuer machen. Alle Konfigurationen und Codebeispiele wurden gegen OpenTelemetry Collector Contrib v0.162.0 ausgeführt.
Was ist OpenTelemetry?
OpenTelemetry (oft kurz OTel) ist ein Open-Source-Framework für Observability, mit dem Sie Telemetrie erzeugen, sammeln und exportieren – Traces, Metriken und Logs. Es ist herstellerneutral: Dieselbe Instrumentierung kann Daten an Jaeger, Prometheus, Grafana, Google Cloud, Datadog oder jedes andere Backend senden, das sein Protokoll versteht.
Genauso wichtig ist, was es nicht ist. Nach eigener Aussage des Projekts ist OpenTelemetry kein Observability-Backend: Speicherung und Visualisierung überlässt es bewusst anderen Werkzeugen. Wer Dashboards sucht, sucht in der falschen Schicht.
Das Projekt beruht auf zwei Versprechen: Die Daten, die Sie erzeugen, gehören Ihnen – ohne Vendor-Lock-in – und Sie lernen einen Satz APIs und Konventionen statt einen pro Anbieter. Es entstand 2019 aus der Fusion von OpenTracing und OpenCensus, zwei älteren Projekten, die dasselbe Problem getrennt lösen wollten. Im Mai 2019 kam es in die CNCF, im August 2021 auf die Stufe Incubating und am 11. Mai 2026 auf Graduated – dieselbe Reifestufe wie Kubernetes und Prometheus.
OpenTelemetry besteht aus:
- Einer Spezifikation für alle Komponenten und einem Protokoll, OTLP, für den Datentransport.
- Semantic Conventions – Standardnamen wie
http.request.methododerk8s.pod.name, damit jede Bibliothek dasselbe gleich benennt. - APIs und SDKs für C++, .NET, Erlang, Go, Java, JavaScript, PHP, Python, Ruby, Rust, Swift und Kotlin.
- Instrumentierungsbibliotheken und Zero-Code-Instrumentierung, die Telemetrie aus gängigen Frameworks erzeugen, ohne dass Sie Code ändern.
- Dem Collector, einem Proxy, der Telemetrie empfängt, verarbeitet und exportiert.
- Dem Kubernetes Operator und Helm Charts, um all das im Cluster zu betreiben.
Monitoring vs. Observability
Beide Begriffe werden oft synonym verwendet, beantworten aber unterschiedliche Fragen.
Monitoring sagt Ihnen, ob etwas nicht stimmt. Sie legen vorher fest, was Sie beobachten – CPU, Fehlerrate, Queue-Länge – und alarmieren, wenn ein Wert eine Schwelle überschreitet. Das funktioniert gut für Ausfälle, die man vorhersehen kann.
Observability lässt Sie herausfinden, warum etwas nicht stimmt, auch bei Ausfällen, die niemand vorhergesehen hat. Die Definition von OpenTelemetry ist kurz: Observability ist die Fähigkeit, den inneren Zustand eines Systems anhand seiner Ausgaben zu verstehen. In Software sind diese Ausgaben Telemetrie, und das System muss instrumentiert sein, um sie zu erzeugen.
| Monitoring | Observability | |
|---|---|---|
| Frage | Ist das System gesund? | Warum verhält es sich so? |
| Vorab bekannt | Die Fehlerbilder | Nur die zu sammelnden Ausgaben |
| Typische Daten | Dashboards und Schwellwert-Alerts auf Metriken | Traces, Metriken und Logs, filterbar nach jedem Attribut |
| Stark bei | Vorhersehbaren Ausfällen: Platte voll, Pod im Crash-Loop | Neuen Ausfällen: ein Mandant langsam auf einem Endpunkt nach einem Deploy |
Sie brauchen beides. Monitoring weckt Sie auf, Observability zeigt Ihnen, wo Sie suchen müssen. OpenTelemetry kümmert sich um den zweiten Teil – reichhaltige, zusammenhängende Daten in einer Standardform aus dem System zu holen.
Traces, Metriken und Logs: die drei Signale
OpenTelemetry nennt jede Art von Telemetrie ein Signal. Drei sind heute stabil; ein viertes, Profile, ist noch in Entwicklung.
Traces und Spans
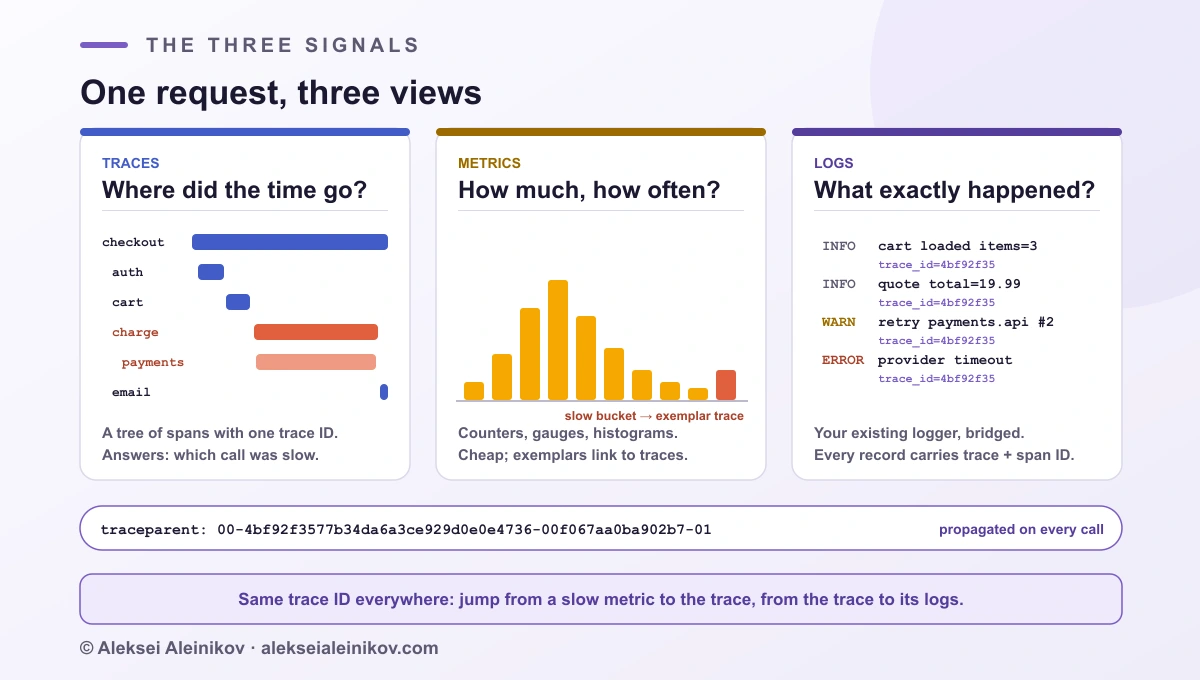
Ein Trace ist der Weg einer Anfrage durch Ihr System. Er besteht aus Spans: ein Span pro Arbeitseinheit – ein HTTP-Handler, eine Datenbankabfrage, ein Aufruf beim Zahlungsdienstleister. Jeder Span hat einen Namen, Start- und Endzeit, eine Span-Art (Server, Client, Producer, Consumer oder intern), Attribute, optionale Events und einen Status.
Spans bilden einen Baum. Der erste Span ist der Root Span; jeder andere verweist über eine Parent-Span-ID auf seinen Parent, und alle teilen sich eine Trace-ID. So zeichnet ein Tracing-Backend den Wasserfall mit den 40 Aufrufen hinter einem Checkout – und zeigt, welcher davon 1,8 Sekunden gedauert hat.
Context Propagation
Ein Trace funktioniert über Service-Grenzen nur, wenn die Trace-ID mit der Anfrage mitreist. Das nennt man Context Propagation. OpenTelemetry nutzt standardmäßig den W3C-Trace-Context-Standard: Jede ausgehende HTTP-Anfrage trägt einen traceparent-Header.
traceparent: 00-4bf92f3577b34da6a3ce929d0e0e4736-00f067aa0ba902b7-01Die vier Felder sind die Version (00), die Trace-ID mit 32 Hex-Zeichen, die Parent-Span-ID mit 16 Hex-Zeichen und die Trace Flags (01 bedeutet gesampelt). Ein zweiter Header, baggage, transportiert Schlüssel-Wert-Paare, die jeder nachgelagerte Service sehen soll, etwa eine Mandanten-ID. Für unterstützte HTTP- und gRPC-Bibliotheken setzen und lesen die SDKs beide Header automatisch.
Metriken
Metriken sind über die Zeit aggregierte Zahlen: Anzahl der Anfragen, Latenzverteilungen, Queue-Längen. OpenTelemetry bietet Counter (steigen nur), Up-Down-Counter, Histogramme (Verteilungen wie die Antwortzeit) und Gauges (aktueller Wert), jeweils synchron zum Aufruf aus dem Code und asynchron, vom SDK abgefragt.
Metriken sind günstig zu speichern, weil sie aggregiert sind – ein Histogramm fasst Millionen Anfragen zusammen. Ihre Schwäche ist die Kardinalität, dazu unten ein eigener Abschnitt. Exemplars verbinden beide Welten: Ein Latenz-Histogramm kann die Trace-ID einer Beispielanfrage mitführen, sodass Sie von einem langsamen Bucket direkt zu einem echten Trace springen.
Logs
OpenTelemetry verlangt nicht, dass Sie Ihr Logging umschreiben. Eine Logs Bridge verbindet stattdessen vorhandene Bibliotheken – logging in Python, Log4j oder Logback in Java und so weiter – mit dem SDK. Jeder Eintrag wird als OTLP-Log mit Trace-ID und Span-ID des aktiven Spans exportiert, sodass Sie in einem Trace genau die Logzeilen sehen, die währenddessen geschrieben wurden.
Der Collector kann außerdem Logs lesen, die nie durch ein SDK gingen, etwa Container-Logdateien auf einem Node, und sie ins selbe Format bringen.
Wie OpenTelemetry funktioniert: API, SDK, OTLP und Collector
Die Architektur hat vier Schichten, und wer sie verwechselt, wird schnell frustriert.
- Die API ist das, was Ihr Code und Ihre Bibliotheken aufrufen: einen Tracer holen, einen Span starten, eine Metrik erfassen. Allein bewirkt sie nichts – Aufrufe sind No-ops, bis ein SDK installiert ist. Das ist Absicht: Eine Bibliothek kann mit der API instrumentiert werden, ohne jeden Nutzer zu Telemetrie zu zwingen.
- Das SDK implementiert die API. Es sampelt Spans, aggregiert Metriken, ergänzt Resource-Attribute, die den Prozess beschreiben (
service.name,service.version,k8s.pod.name), bündelt die Daten und übergibt sie an einen Exporter. - OTLP ist das Protokoll, das der Exporter spricht.
- Der Collector ist ein optionaler, aber fast immer vorhandener Zwischenschritt zwischen Anwendungen und Backends.
OTLP, das Übertragungsprotokoll
OTLP überträgt alle drei stabilen Signale über zwei Transportwege:
| OTLP/gRPC | OTLP/HTTP | |
|---|---|---|
| Standardport | 4317 | 4318 |
| Kodierung | Protobuf | Binäres Protobuf oder JSON |
| Pfade | gRPC-Services | /v1/traces, /v1/metrics, /v1/logs |
| Gut für | Service zu Collector, Collector zu Collector | Browser, Proxys, Firewalls, die nur HTTP erlauben |
Das Protokoll legt fest, wie man sich bei Fehlern verhält – wichtig, wenn Telemetrie während eines Vorfalls sprunghaft ansteigt. Über HTTP sind 429, 502, 503 und 504 wiederholbar, und ein Retry-After-Header muss beachtet werden; ein 400 heißt, die Daten sind fehlerhaft und werden verworfen, nicht wiederholt. Ein Server kann auch nur einen Teil eines Batches annehmen und melden, wie viele Einträge er abgelehnt hat. Die Spezifikation empfiehlt eine Grenze von 64 MiB pro Anfrage und nimmt in Kauf, dass ein Retry nach einem Netzwerkfehler Duplikate erzeugen kann – ein bewusster Kompromiss für Telemetrie.
OTLP lässt sich mit nichts außer curl ausprobieren. Mit einem lokalen Collector auf Port 4318 erzeugt diese Anfrage einen Span:
curl -X POST http://127.0.0.1:4318/v1/traces \ -H 'Content-Type: application/json' \ -d '{"resourceSpans":[{"resource":{"attributes":[ {"key":"service.name","value":{"stringValue":"checkout"}}]}, "scopeSpans":[{"scope":{"name":"manual-test"},"spans":[{ "traceId":"5b8efff798038103d269b633813fc60c", "spanId":"eee19b7ec3c1b174", "name":"POST /checkout","kind":2, "startTimeUnixNano":"1760425200000000000", "endTimeUnixNano":"1760425200250000000"}]}]}]}'# → {"partialSuccess":{}} HTTP 200Beachten Sie die Details der JSON-Kodierung: Trace- und Span-IDs sind Hex-Strings, nicht Base64, und kind ist die Zahl 2 (Server), kein Name.
Der OpenTelemetry Collector
Der Collector ist ein einzelnes Go-Binary, konfiguriert mit YAML. Er ist der Teil von OpenTelemetry, den Betriebsteams tatsächlich betreiben, und es lohnt sich, ihn richtig zu verstehen.
Receiver, Prozessoren, Exporter und Connectoren
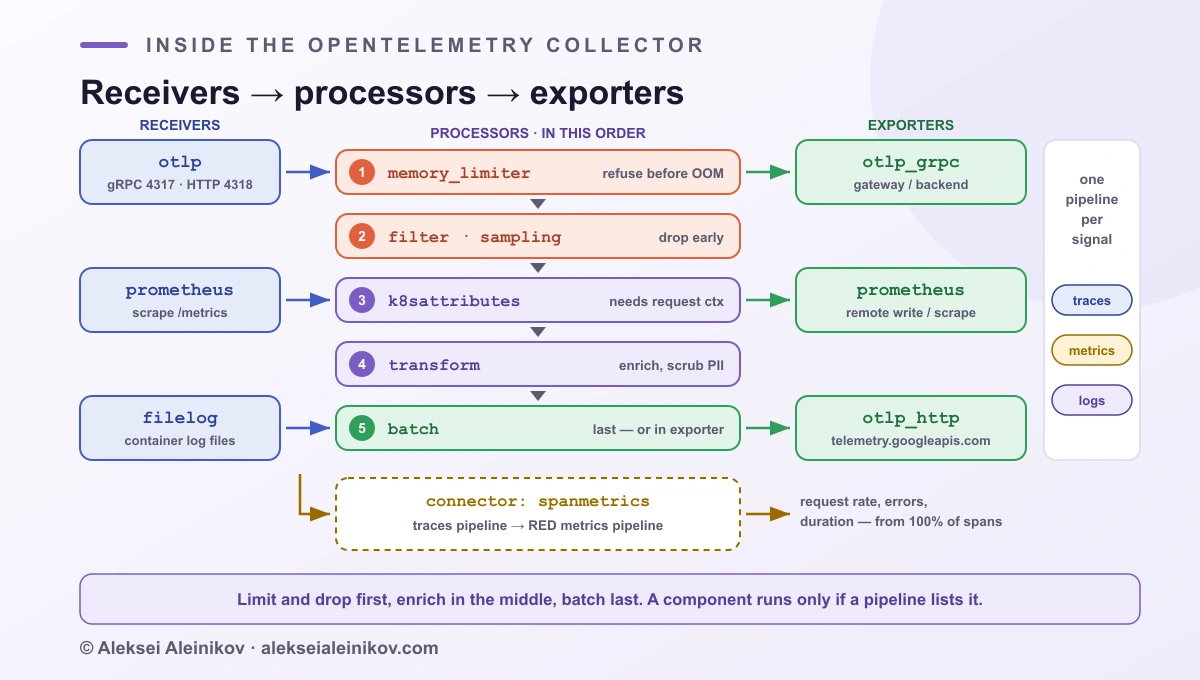
Eine Konfiguration kennt vier Arten von Pipeline-Komponenten:
- Receiver holen Daten herein.
otlpist der wichtigste; andere scrapen Prometheus-Endpunkte, lesen Kafka-Topics, folgen Logdateien oder sammeln Host-Metriken. - Prozessoren verändern Daten unterwegs: Speicher begrenzen, filtern, Attribute ergänzen oder löschen, sampeln, bündeln.
- Exporter senden Daten hinaus – an einen anderen Collector, Prometheus, Google Cloud, Datadog, eine Datei oder an den
debug-Exporter, der auf die Konsole schreibt. - Connectoren verbinden zwei Pipelines und sind auf der einen Seite Exporter, auf der anderen Receiver. Der
spanmetrics-Connector etwa macht aus Spans Metriken für Anfragerate, Fehler und Dauer.
Eine Komponente zu definieren, bewirkt allein nichts. Sie läuft erst, wenn Sie sie unter service.pipelines in einer Pipeline aufführen, getrennt für traces, metrics und logs.
Die Reihenfolge der Prozessoren ist keine Kosmetik
Prozessoren laufen in der Reihenfolge, in der Sie sie auflisten, und das Projekt dokumentiert eine empfohlene Reihenfolge:
memory_limiterzuerst, damit der Collector Daten ablehnen kann, bevor ihm der Speicher ausgeht.- Sampling und Filter als Nächstes, damit keine CPU für Daten verloren geht, die gleich verworfen werden.
- Prozessoren, die den Request-Kontext brauchen, etwa
k8sattributes, vor dem Batching – das Batching löscht diesen Kontext. - Anreicherung und Transformation:
attributes,transform,resource. - Batching zuletzt, am besten im Exporter selbst über seine Sending Queue statt über einen eigenen
batch-Prozessor.
Hier eine vollständige Agent-Konfiguration, wie sie auf jedem Kubernetes-Node laufen würde:
receivers:  otlp:    protocols:      grpc:        endpoint: 0.0.0.0:4317      http:        endpoint: 0.0.0.0:4318
processors:  memory_limiter:    check_interval: 1s    limit_percentage: 80    spike_limit_percentage: 20  k8sattributes:    extract:      metadata: [k8s.namespace.name, k8s.deployment.name, k8s.pod.name, k8s.node.name]  resourcedetection:    detectors: [env, gcp]    timeout: 5s  attributes/scrub:    actions:      - key: http.request.header.authorization        action: delete      - key: user.email        action: hash
exporters:  otlp_grpc/gateway:    endpoint: otel-gateway.observability.svc.cluster.local:4317    sending_queue:      batch:
extensions:  health_check:    endpoint: 0.0.0.0:13133
service: extensions: [health_check] pipelines: traces: receivers: [otlp] processors: [memory_limiter, k8sattributes, resourcedetection, attributes/scrub] exporters: [otlp_grpc/gateway] metrics: receivers: [otlp] processors: [memory_limiter, k8sattributes, resourcedetection] exporters: [otlp_grpc/gateway] logs: receivers: [otlp] processors: [memory_limiter, k8sattributes, resourcedetection, attributes/scrub] exporters: [otlp_grpc/gateway]In dieser Datei stecken zwei Sicherheitsdetails. Der Collector bindet standardmäßig an localhost; 0.0.0.0 ist in einem Pod nötig, damit andere Pods ihn erreichen, und sollte dann per NetworkPolicy abgesichert werden. Und der Prozessor attributes/scrub ist die günstigste Stelle in Ihrem gesamten Stack, um zu verhindern, dass ein Authorization-Header oder eine E-Mail-Adresse in einem fremden Backend landet.
Welche Collector-Distribution?
Der Collector wird aus Komponenten gebaut, und mehrere Distributionen bündeln unterschiedliche Sätze:
otelcol(Core) – eine kleine Auswahl an Upstream-Komponenten.otelcol-contrib– fast alle Community-Komponenten; bequem zum Lernen, für die Produktion größer als nötig.otelcol-k8s– für Kubernetes ausgewählte Komponenten.- Hersteller-Distributionen wie der Google-Built OpenTelemetry Collector oder Grafana Alloy, getestet gegen eine Plattform.
- Ihr eigener Build mit dem OpenTelemetry Collector Builder (
ocb), der genau die Komponenten enthält, die Sie nutzen – die kleinste Angriffsfläche.
Agent oder Gateway: wie Sie den Collector betreiben
Es gibt zwei Bausteine, und die meisten Produktionsumgebungen nutzen beide.
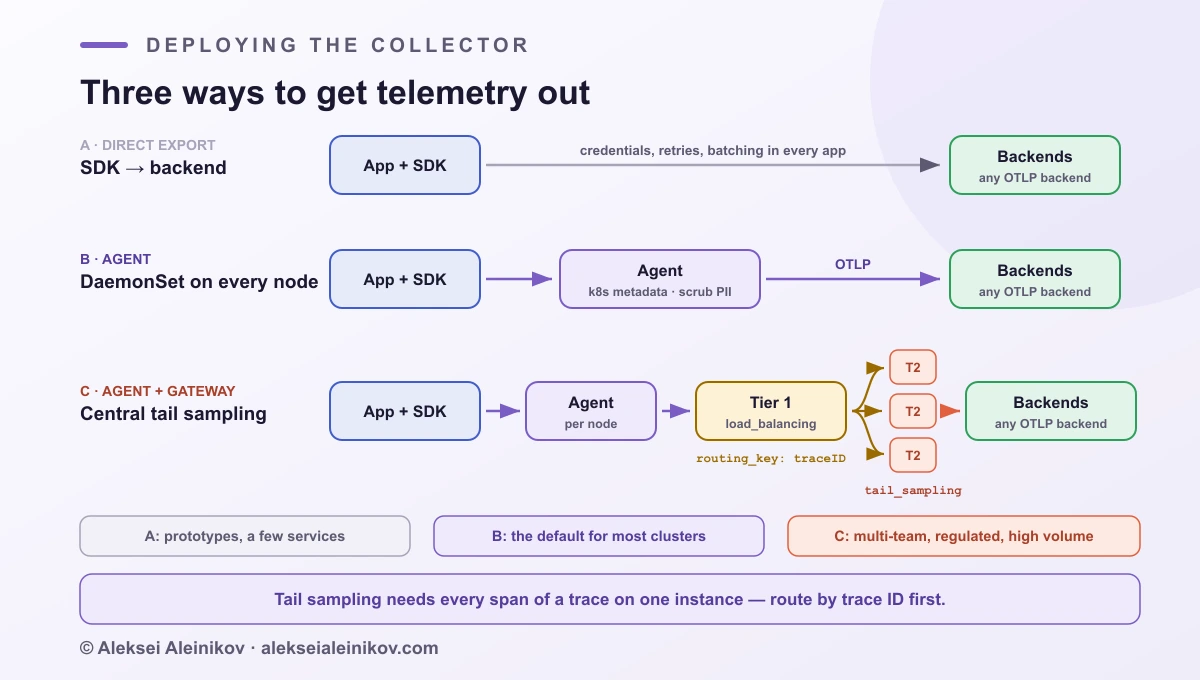
Ein Agent läuft nah an der Anwendung – als DaemonSet auf jedem Kubernetes-Node oder als Sidecar. Anwendungen senden an einen lokalen Endpunkt, was ihre Konfiguration trivial hält, und der Agent ergänzt Host- und Pod-Metadaten günstig, weil er auf demselben Node läuft.
Ein Gateway ist ein zentraler, horizontal skalierter Pool von Collectoren hinter einem OTLP-Endpunkt – meist einer pro Cluster oder Region. Die offizielle Deployment-Anleitung nennt als Vorteile zentral verwaltete Credentials und zentrale Regeln wie Filter und Sampling, als Kosten eine weitere Komponente, die gewartet werden muss und ausfallen kann, zusätzliche Latenz und mehr Ressourcenverbrauch.
| Direkter Export | Nur Agent | Agent + Gateway | |
|---|---|---|---|
| Bewegliche Teile | Keine | Ein DaemonSet | DaemonSet + Deployment |
| Backend-Credentials | In jeder Anwendung | Auf jedem Node | An einer Stelle |
| Kubernetes-Metadaten | Vom SDK | Ja, günstig | Ja, vom Agent ergänzt |
| Tail Sampling | Nein | Nein | Ja |
| Fan-out an mehrere Backends | Pro Anwendung | Pro Node | Zentral |
| Geeignet für | Prototypen, wenige Services | Die meisten Cluster | Plattformen mit vielen Teams, regulierte Daten, hohes Volumen |
Tail Sampling braucht alle Spans an einer Stelle
Tail Sampling ist der Hauptgrund für ein Gateway, und es hat einen Haken: Ein Sampler kann einen Trace nur beurteilen, wenn er alle seine Spans sieht, während diese Spans von vielen Pods kommen. Die dokumentierte Lösung sind zwei Schichten. Die erste nutzt den load_balancing-Exporter mit routing_key: traceID, um alle Spans eines Traces an dieselbe Instanz der zweiten Schicht zu senden, die den Prozessor tail_sampling ausführt.
Die folgende Konfiguration der zweiten Schicht behält jeden Fehler, jeden Trace über zwei Sekunden und 10 % vom Rest – und berechnet Metriken für Anfragerate, Fehler und Dauer aus allen Spans vor dem Sampling, sodass Dashboards korrekt bleiben, obwohl nur ein Teil der Traces gespeichert wird:
receivers:  otlp:    protocols:      grpc:        endpoint: 0.0.0.0:4317
connectors:  spanmetrics:          # RED metrics from 100% of spans, before sampling  forward/sample:       # hands the same spans to the sampling pipeline
processors:  memory_limiter:    check_interval: 1s    limit_percentage: 80    spike_limit_percentage: 20  tail_sampling:    decision_wait: 10s    num_traces: 100000    policies:      - name: keep-errors        type: status_code        status_code: { status_codes: [ERROR] }      - name: keep-slow        type: latency        latency: { threshold_ms: 2000 }      - name: sample-the-rest        type: probabilistic        probabilistic: { sampling_percentage: 10 }  resource/gcp:    attributes:      - key: gcp.project_id        value: ${env:GOOGLE_CLOUD_PROJECT}        action: insert
exporters:  otlp_http/gcp:    endpoint: https://telemetry.googleapis.com    encoding: proto    auth: { authenticator: googleclientauth }    sending_queue:      batch:
extensions:  googleclientauth:
service:  extensions: [googleclientauth]  pipelines:    traces/in:      receivers: [otlp]      processors: [memory_limiter]      exporters: [spanmetrics, forward/sample]    traces/sampled:      receivers: [forward/sample]      processors: [tail_sampling, resource/gcp]      exporters: [otlp_http/gcp]    metrics/red:      receivers: [spanmetrics]      processors: [resource/gcp]      exporters: [otlp_http/gcp]
Die Regeln werden gemeinsam ausgewertet: Ein Trace bleibt erhalten, wenn irgendeine von ihnen zustimmt. decision_wait legt fest, wie lange das Gateway einen Trace puffert, bevor es entscheidet, und num_traces begrenzt, wie viele es im Speicher hält – dimensionieren Sie beides nach Ihrem Verkehr, denn diese Schicht ist zustandsbehaftet.
Eine Regel für Metriken: ein einziger Writer
Exportieren mehrere Collectoren denselben Metrik-Stream, können sie sich gegenseitig überschreiben und in Prometheus Lücken, Sprünge und Fehler wie „out-of-order sample” erzeugen. Das OpenTelemetry-Datenmodell verlangt für jeden Metrik-Stream einen einzigen Writer. In der Praxis heißt das: Jeder Stream braucht Attribute, die seine Herkunft eindeutig machen – k8sattributes und resourcedetection liefern sie –, und zwei Collectoren dürfen nicht dasselbe Ziel scrapen.
Code instrumentieren
Es gibt zwei Wege, eine Anwendung Telemetrie erzeugen zu lassen, und Sie werden beide nutzen.
Zero-Code-Instrumentierung
Zero-Code-Instrumentierung (auch automatische Instrumentierung) hängt sich zur Laufzeit in gängige Frameworks und Clients – Webserver, HTTP-Clients, Datenbanktreiber, Message Queues – und erzeugt dafür Spans und Metriken, ohne dass Sie den Quellcode anfassen.
pip install opentelemetry-distro opentelemetry-exporter-otlpopentelemetry-bootstrap -a install # adds instrumentation for installed librariesOTEL_SERVICE_NAME=checkout \OTEL_EXPORTER_OTLP_ENDPOINT=http://127.0.0.1:4317 \opentelemetry-instrument python app.pynpm install --save @opentelemetry/api @opentelemetry/auto-instrumentations-nodeexport OTEL_SERVICE_NAME=checkoutexport OTEL_EXPORTER_OTLP_ENDPOINT=http://127.0.0.1:4317export NODE_OPTIONS="--require @opentelemetry/auto-instrumentations-node/register"node app.jsFür Java ist das Gegenstück der OpenTelemetry-Java-Agent, eingebunden mit -javaagent:opentelemetry-javaagent.jar. Python arbeitet per Monkey Patching der Bibliotheken zur Laufzeit, der Java-Agent per Bytecode-Umschreibung beim Laden der Klassen.
Manuelle Spans dort, wo die Geschäftslogik liegt
Automatische Instrumentierung sieht HTTP und SQL. Sie sieht nicht, dass eine Anfrage eine Erstattung war, zu welchem Mandanten sie gehörte oder dass der Zahlungsdienstleister beim dritten Versuch in ein Timeout lief. Das ergänzen Sie mit wenigen Zeilen API:
from opentelemetry import tracefrom opentelemetry.sdk.resources import Resourcefrom opentelemetry.sdk.trace import TracerProviderfrom opentelemetry.sdk.trace.export import BatchSpanProcessorfrom opentelemetry.exporter.otlp.proto.http.trace_exporter import OTLPSpanExporter
provider = TracerProvider(resource=Resource.create({"service.name": "checkout"}))provider.add_span_processor(BatchSpanProcessor(OTLPSpanExporter()))trace.set_tracer_provider(provider)tracer = trace.get_tracer("checkout.payments")

def charge(order_id: str, amount_cents: int) -> None:    with tracer.start_as_current_span("charge card") as span:        span.set_attribute("order.id", order_id)        span.set_attribute("payment.amount_cents", amount_cents)        try:            call_payment_provider(order_id, amount_cents)        except TimeoutError as exc:            span.record_exception(exc)            span.set_status(trace.Status(trace.StatusCode.ERROR, "provider timeout"))            raise
Läuft der Zahlungsdienstleister in ein Timeout, erhält der Collector einen Span namens charge card mit Status Error, der Meldung provider timeout, beiden Attributen und einem Exception-Event mit dem Stacktrace. Nutzen Sie zusätzlich Zero-Code-Instrumentierung, lassen Sie die Provider-Zeilen weg – der Agent konfiguriert das SDK, und Ihr Code braucht nur trace.get_tracer.
Halten Sie sich bei allem, was bereits einen Standardnamen hat (http.request.method, db.system.name, messaging.system), an die Semantic Conventions, und nutzen Sie für den Rest einen eigenen Namensraum wie payment.amount_cents.
Reifegrad nach Sprache
Traces sind in fast allen Sprachen stabil, Metriken in den meistgenutzten, Logs nur in einigen. Die offizielle Statustabelle:
| Sprache | Traces | Metriken | Logs |
|---|---|---|---|
| Java, .NET, C++, PHP | Stabil | Stabil | Stabil |
| Go | Stabil | Stabil | Release Candidate |
| Python, JavaScript | Stabil | Stabil | Development |
| Rust | Beta | Stabil | Stabil |
| Ruby, Swift, Erlang/Elixir | Stabil | Development | Development |
| Kotlin | Development | Development | Development |
Development heißt nicht unbrauchbar – viele Teams verschicken Python-Logs über OpenTelemetry –, aber APIs können sich zwischen Releases noch ändern. Pinnen Sie die Versionen.
OpenTelemetry auf Kubernetes betreiben
Der OpenTelemetry Operator verwaltet im Cluster zweierlei: Collectoren über eine OpenTelemetryCollector-Ressource, die als Deployment, DaemonSet, StatefulSet oder Sidecar laufen kann, und die automatische Instrumentierung über eine Instrumentation-Ressource. Für seinen Admission Webhook braucht er meist cert-manager.
Die Instrumentation-Ressource beschreibt, wohin Daten gehen und wie gesampelt wird:
apiVersion: opentelemetry.io/v1alpha1kind: Instrumentationmetadata: name: default namespace: shopspec: exporter: endpoint: http://otel-agent.observability.svc.cluster.local:4318 propagators: [tracecontext, baggage] sampler: type: parentbased_traceidratio argument: "0.25"Anwendungen melden sich mit einer Annotation am Pod-Template an:
spec: template: metadata: annotations: instrumentation.opentelemetry.io/inject-python: "true"Läuft der Agent als DaemonSet, geben Sie seinem Service internalTrafficPolicy: Local, damit jeder Pod an den Agent auf seinem eigenen Node sendet statt an einen beliebigen im Cluster.
Beim Start des Pods ergänzt der Operator einen Init-Container, der die Instrumentierung in den Pod kopiert und die Umgebungsvariablen setzt. Drei Details verursachen die meisten gescheiterten Rollouts:
- Die Reihenfolge zählt. Die
Instrumentation-Ressource muss existieren, bevor die Pods starten; vorher erzeugte Pods werden erst nach einem Neustart instrumentiert. - Die Annotation gehört nach
spec.template.metadata.annotations, nicht in die Metadaten des Deployments selbst. - Die Protokolle unterscheiden sich je Sprache. Die Python-Injektion unterstützt nur OTLP über HTTP, der Endpunkt braucht also Port 4318; Node.js nutzt standardmäßig gRPC auf 4317. Go wird über einen privilegierten eBPF-Sidecar instrumentiert und ist hinter einem Feature Gate standardmäßig deaktiviert.
Auf GKE können Sie auf eigene Collectoren verzichten: Google bietet Managed OpenTelemetry for GKE an und veröffentlicht außerdem den Google-Built OpenTelemetry Collector mit einer geprüften Konfiguration, falls Sie lieber selbst betreiben. Der Rest des Cluster-Designs – Workload Identity, NetworkPolicies, Platz des Gateways – fügt sich in dieselbe Struktur wie die Secure-by-default-Referenzarchitektur für GKE.
Wohin die Daten gehen: ein Backend wählen
OpenTelemetry endet beim Exporter. Alles danach ist eine Backend-Entscheidung, und weil jedes ernsthafte Backend inzwischen OTLP annimmt, können Sie es sich später anders überlegen.
| Backend | Signale | Wie es OpenTelemetry empfängt | Gut zu wissen |
|---|---|---|---|
| Prometheus | Metriken | Nativer OTLP-Receiver unter /api/v1/otlp/v1/metrics, aktiviert mit --web.enable-otlp-receiver; oder per Scraping über den Collector |
Nur HTTP; Out-of-order-Ingestion aktivieren (30 Minuten sind ein guter Start), wenn mehrere Collectoren schreiben |
| Grafana Tempo / Loki / Mimir | Traces / Logs / Metriken | OTLP | Loki speichert die meisten Attribute als Structured Metadata und erlaubt standardmäßig 15 Index-Labels – k8s.pod.name gehört nicht in die Labels |
| Jaeger v2 | Traces | OTLP; Jaeger v2 baut selbst auf dem Collector-Framework auf | All-in-one mit In-Memory-Speicher nur für Entwicklung |
| Google Cloud Observability | Alle drei | Telemetry (OTLP) API unter telemetry.googleapis.com, gRPC oder HTTP |
Verlangt gcp.project_id an der Resource; Metriken landen als Prometheus-Zeitreihen |
| Datadog, New Relic, Dynatrace, Honeycomb | Alle drei | OTLP-Endpunkte oder Collector-Exporter | Ihre Analyse bleibt, der proprietäre Agent fällt weg |
Speziell auf Google Cloud nimmt die Telemetry API alle drei Signale über einen Endpunkt an. Der Schreibende braucht die Rolle roles/telemetry.writer plus Service Usage Consumer im Quota-Projekt, und die Authentifizierung im Collector läuft über die Extension googleclientauth – idealerweise mit Workload Identity statt einer Schlüsseldatei, aus den Gründen, die in Service-Account-Schlüssel abschaffen mit Workload Identity Federation stehen. Das Standardkontingent für Metriken liegt bei 60.000 Anfragen pro Minute und Region mit bis zu 200 Punkten pro Anfrage – rund 200.000 Samples pro Sekunde –, und die Metrik-Ingestion darüber braucht Collector 0.140.0 oder neuer.
OpenTelemetry vs. Prometheus vs. Hersteller-Agents
Nach diesem Vergleich wird oft gesucht, und die ehrliche Antwort lautet: Die drei konkurrieren nicht auf derselben Ebene.
| OpenTelemetry | Prometheus | Hersteller-Agent (Datadog, Dynatrace …) | |
|---|---|---|---|
| Was es ist | Standard + SDKs + Collector | Metrik-Datenbank, Abfragesprache und Alerting | Proprietäre Erfassung für ein Backend |
| Signale | Traces, Metriken, Logs (Profile folgen) | Metriken | Meist alle, plus Extras des Herstellers |
| Modell | Meist Push über OTLP | Meist Pull (Scraping) | Push zum Hersteller |
| Speicherung und UI | Keine – Ihre Wahl | Ja | Die des Herstellers |
| Lock-in | Keiner | Gering | Hoch |
| Ersetzt | Hersteller-SDKs und -Agents | Nichts in OpenTelemetry; es ist ein Backend | — |
Die praktische Antwort auf „OpenTelemetry oder Prometheus?“ lautet daher meist beides: mit OpenTelemetry instrumentieren und Metriken in Prometheus oder einem Managed-Prometheus-Dienst speichern. Und die Antwort auf „OpenTelemetry oder Datadog?” lautet: OpenTelemetry ersetzt den Datadog-Agent, nicht Datadog – Sie behalten das Produkt und gewinnen die Freiheit, es zu verlassen.
Sampling: die Traces behalten, die zählen
Im großen Maßstab können Sie sich nicht leisten, jeden Trace zu speichern, und Sie müssen es auch nicht. Die OpenTelemetry-Dokumentation empfiehlt, Sampling ab etwa 1.000 Traces pro Sekunde in Betracht zu ziehen, und weist darauf hin, dass bei hohem Volumen eine Stichprobe von 1 % oder weniger den Rest zuverlässig abbilden kann.
- Head Sampling entscheidet, wenn der Root Span beginnt. Die übliche Wahl ist
parentbased_traceidratio: Der Root-Service behält einen festen Anteil der Traces, ausgewählt nach Trace-ID, und jeder nachgelagerte Service folgt der Entscheidung des Parents – so entstehen nie halbe Traces. Das ist günstig und zustandslos, weiß aber nicht, ob der Trace mit einem Fehler endet. - Tail Sampling entscheidet nach Abschluss des Traces und kann daher jeden Fehler und jede langsame Anfrage behalten. Es braucht die oben beschriebene zustandsbehaftete Gateway-Schicht und ist schwerer zu dimensionieren und zu betreiben.
Viele Teams kombinieren beides: ein großzügiges Head Sampling, um die Pipeline vor Überlast zu schützen, und danach Tail Sampling im Gateway, um auszuwählen, welche Traces das Geld wert sind. Eine Regel macht beide Wege sicher – berechnen Sie Metriken, bevor Sie Traces sampeln, wie es der spanmetrics-Connector in der Gateway-Konfiguration tut, damit Dashboards und SLOs auf 100 % der Anfragen beruhen.
Fehler in der Produktion, die OpenTelemetry teuer machen
Fast jedes Kostenproblem mit OpenTelemetry geht auf eine Handvoll Fehler zurück.
Metrik-Kardinalität. Jede eindeutige Kombination von Attributwerten ist eine eigene Zeitreihe. Ein Latenz-Histogramm mit http.route und http.response.status_code ist in Ordnung; fügen Sie user.id oder order.id hinzu, entsteht eine Zeitreihe pro Kunde. Halten Sie Kennungen auf Spans und Logs – dort sind sie nützlich – und aus Metriken heraus. Entfernen Sie problematische Attribute im Collector mit dem Prozessor attributes oder transform.
Jeden gesunden Trace behalten. Ein erfolgreicher GET /health, der zu 100 % getraced wird, ist reine Kosten. Filtern Sie Health Checks ganz heraus und sampeln Sie den Rest.
Personenbezogene Daten in Attributen. Instrumentierung kann URLs mit Query-Strings, Header und SQL-Statements erfassen. Bereinigen oder hashen Sie alles Personenbezogene im Agent, bevor es den Node verlässt – die günstigste DSGVO-Maßnahme, die Sie je einführen werden.
Logs, die in jeden Eintrag kopiert werden. Manche Backends kopieren Resource- und Scope-Attribute in jeden gespeicherten Logeintrag, sodass eine große Resource das Logvolumen vervielfacht. Die Dokumentation von Google Cloud weist ausdrücklich darauf hin; kürzen Sie Resource-Attribute vor dem Export.
Ein Collector ohne Grenzen. Ohne memory_limiter kann ein Vorfall, der den Verkehr verdoppelt, den Collector genau dann zum Absturz bringen, wenn Sie ihn brauchen. Beobachten Sie seine eigenen Metriken – abgelehnte, verworfene und wartende Einträge – und dimensionieren Sie das Gateway für Verkehr wie im Vorfall, nicht für einen durchschnittlichen Tag.
Abgerissener Kontext an asynchronen Grenzen. Traces, die an einer Queue enden, bedeuten meist einen Producer, der keinen Kontext mitgibt. Für Batch-Consumer, die viele Nachrichten auf einmal verarbeiten, verbinden Sie einen Consumer-Span über Span Links mit vielen Producer-Spans, statt einen einzigen Parent zu erzwingen.
Telemetrie ist eine Datenpipeline wie jede andere. Geben Sie ihr ein Budget, begrenzen Sie die Rate, bereinigen Sie sie und überwachen Sie sie – sonst wird sie unbemerkt zum teuersten und am wenigsten vertrauenswürdigen System, das Sie betreiben.
Checkliste für die Produktion
Instrumentierung:
service.name,service.versionunddeployment.environment.namean jedem Service gesetzt- Zero-Code-Instrumentierung aktiv, manuelle Spans um Geschäftsvorgänge
- Semantic Conventions für Standardattribute; eigener Namensraum für den Rest
- Kontext über HTTP, gRPC und Message Queues weitergegeben
- Versionen von SDK und Instrumentierung gepinnt
Collector:
- Agent als DaemonSet; Gateway nur dort, wo zentrale Regeln oder Tail Sampling nötig sind
memory_limiterzuerst, Batching zuletzt,k8sattributesvor dem Batching- PII im Agent bereinigt; Credentials nur im Gateway oder über Workload Identity
- Konfigurationen in der CI mit
otelcol validategeprüft; eigener schlanker Build in der Produktion - Eigene Metriken und Health Check des Collectors überwacht und alarmiert
Daten und Kosten:
- Keine Nutzer- oder Anfrage-IDs in Metrik-Attributen
- Health Checks gefiltert; Head und/oder Tail Sampling eingerichtet
- Span-Metriken vor dem Sampling berechnet
- Ein Writer pro Metrik-Stream
- Backend pro Signal gewählt; überall OTLP, damit es später wechseln kann
Fazit
OpenTelemetry ist kein Produkt, das Sie kaufen, und kein Dashboard, das Sie installieren. Es ist die Verrohrung: eine gemeinsame Art, wie jeder Service beschreibt, was er tut, ein gemeinsames Protokoll, um diese Beschreibung zu transportieren, und ein Collector, der entscheidet, was bleibt, was bereinigt wird und wohin es geht.
Der Gewinn ist Hebelwirkung. Einmal instrumentiert, können Sie das Backend wechseln, während einer Migration an zwei gleichzeitig senden oder Tail Sampling für das ganze Unternehmen einführen, indem Sie eine Gateway-Konfiguration ändern – ohne den Anwendungscode anzufassen. Machen Sie die langweiligen Teile richtig – Namen, Kardinalität, Sampling und einen Collector, der nicht umfallen kann –, und die Frage um drei Uhr nachts ändert sich von „Wo fangen wir überhaupt an?“ zu „Klick auf den langsamen Span.”
Observability ist die Datenseite der Arbeit eines Plattformteams – Platform Engineering auf Kubernetes beschreibt den Rest des Paved Road.

Aus der Community
Diskussion auf Mastodon & Bluesky
Antworten auf diesen Artikel aus dem offenen Netz, live geladen. Keine Werbung, keine Tracking-Skripte.
Antworte dort — es erscheint hier automatisch.