
Auf der Microsoft Ignite (17. November) tat Microsoft den Schritt, auf den die gesamte Cloud-Branche seit zwei Jahren gewartet hatte – und sorgte trotzdem für Aufsehen. In San Francisco präsentierte Microsoft-AI-Chef Mustafa Suleyman sieben eigene kommerzielle KI-Modelle auf Microsofts selbst entwickeltem 3-nm-Inferenzchip Maia 200 und griff damit offen die Preisgestaltung von Anthropic und OpenAI an.
Die Schlagzeile sorgte auf Hacker News sofort für über 500 Punkte und 330 Kommentare: MAI Code 2 soll 96 % der Coding-Qualität von Claude Opus 5.5 zu rund 5 % der Kosten erreichen – und 98 % von GPT-6.1 Sol zu 40 % der Kosten.
Diese Aussage ist zur Hälfte ein echter Ingenieurserfolg und zur Hälfte geschicktes Framing. Dieser Artikel zeichnet nach, wie sich Microsoft vom exklusiven OpenAI-Finanzier zum vertikalen KI-Labor entwickelte, ordnet alle sieben Modelle ein, zerlegt die exakten MSBench-Zahlen (inklusive der 14,4-Punkte-Lücke bei SWE-Atlas) und trennt den Promo-Tarif von der regulären Listenpreis-Rechnung.
Das kurze Urteil. Microsoft verkauft nicht mehr nur OpenAI-APIs weiter. Mit Maia 200 + MAI Code 2 + Decision 1.1 besitzt der Konzern nun wie Google einen geschlossenen vertikalen Stack.
MAI Code 2ist eine starke Kostenwaffe für alltägliches Enterprise-Coding in GitHub Copilot (0,50 $/2,50 $Promo →1 $/5 $Liste), aber kein vollwertiger Opus-5.5-Ersatz bei komplexen Repository-Aufgaben (SWE-Atlas:43,1 %vs.57,5 %) oder langen autonomen Agentenläufen.
Wie Microsoft dorthin kam: Vom OpenAI-Bankier zum eigenen KI-Labor
Viele fragen sich, ob Microsoft zur Ignite erstmals eigene neuronale Netze veröffentlicht hat. Streng genommen nein – Microsoft Research pflegt seit Jahren die kompakte Phi-Reihe, und Microsoft AI zeigte bereits zuvor sowie auf der Microsoft Build erste MAI-Generationen. Neu an der Ignite-Welle sind kommerzielle Breite und volle vertikale Integration.
Fünf Jahre lang hatte Microsofts KI-Marge ein strukturelles Problem: Jeder Wachstumsschub bei GitHub Copilot oder Microsoft 365 Copilot bedeutete hohe Ausgaben für NVIDIA-Hardware oder Umsatzbeteiligungen an OpenAI und Anthropic. Als OpenAI seine Konzernstruktur in Richtung voller kommerzieller Unabhängigkeit umbaute, zog Microsoft vier Schritte konsequent durch:
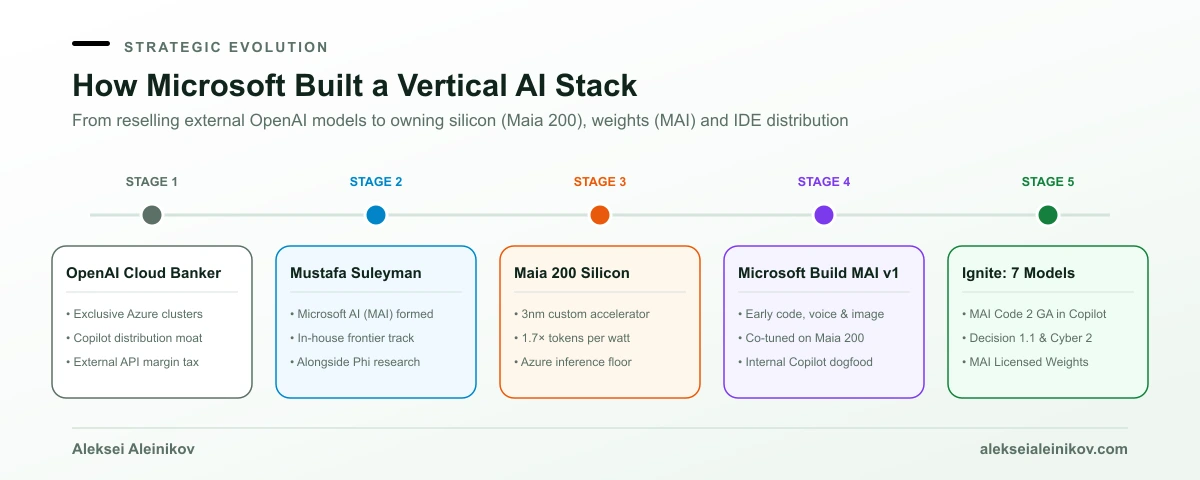
- Exklusiver Cloud-Partner von OpenAI (2019–2023): Milliarden-Investments, Azure-Supercomputer und tiefe Integration von GPT in Copilot und Office. Der Burggraben war der Vertrieb, nicht die eigenen Modellgewichte.
- Aufbau von Microsoft AI (März 2024): Verpflichtung von DeepMind-Mitgründer Mustafa Suleyman, um neben der Forschungssparte Phi eine eigene Frontier-Modellorganisation aufzubauen.
- Eigene Hardware (
Maia 200): Einführung des 3-nm-Inferenzbeschleunigers Maia 200 mit rund 1,7× mehr Tokens pro Watt. Ähnlich wie Googles TPUs den Preisvorteil von Gemini 4 Neon und Gemini 4 Hydrogen tragen, schafft Maia 200 Microsofts eigene Kostenbasis. - Kommerzielle Ignite-Welle: Sieben produktionsreife MAI-Modelle auf einen Schlag, optimiert auf Maia 200 – ergänzt um MAI Licensed Weights, mit denen Großkunden angepasste Gewichte isoliert in dedizierten Azure-Umgebungen betreiben können.
Die sieben neuen Ignite-Modelle im Überblick
Statt alles auf ein einziges riesiges Universalmodell zu setzen, zielt Microsoft jedes MAI-Modell auf einen konkreten Enterprise-Kostenblock:
| Modell | Rolle & Architektur | Zentrale Aussage / Metrik | Verfügbarkeit |
|---|---|---|---|
| MAI Code 2 | Flaggschiff-Coding-MoE (1,05M Kontext: 922K in / 128K out) |
63,2 % MSBench-Schnitt (96 % von Opus 5.5, 98 % von GPT-6.1 Sol) |
GA in GitHub Copilot |
| MAI Code 2 Flash | Schnelles Coding-MoE (~12B aktive Parameter, 1M Kontext) |
Niveau GPT-6 Luna / Haiku 5.5 zu 20–65 % der Kosten |
GA in Copilot; Private Preview in Foundry |
| MAI Cyber 2 Flash | AppSec- & SOC-Schwachstellenanalyse / Patching | Schlägt GPT-6 Astra auf CyberGym-E2E; Basis für Defender ISOC | Security-Partner-Preview; Defender ab Mitte Dez. |
| Decision 1.1 | Schnelles Routing, Klassifizierung & Prüfung (Gemma-MoE) | Bis zu 50× schneller und 79× günstiger als GPT-6.1 Sol | GA in Microsoft Foundry |
| MAI Image 2.7 (+ Flash) | Bildgenerierung & -bearbeitung | #1 bei Artificial Analysis für Image Editing (1/5 Preis von GPT Image 2.6 Sunburst max) |
Preview in Microsoft Foundry |
| MAI Realtime 1 | Natives Speech-to-Speech-Audio | Schlägt GPT-Realtime 2.1, ab 0,01 $ / Audiominute | Rollout in Foundry |
| MAI Transcribe 2 | Mehrsprachige Transkription (Dragon Copilot) | Halbiert mehrsprachige Fehlerraten bei 10 Mio. Arzt-Patienten-Gesprächen/Monat | Produktion (Dragon Copilot) |
Auffällig ist, dass bisher nur MAI Image 2.7 (#1 auf Artificial Analysis für Bildbearbeitung) extern auf dem großen Leaderboard steht. Bei MAI Code 2 stammen alle Zahlen derzeit aus Microsofts eigener MSBench-Auswertung – umso wichtiger ist der genaue Blick auf die übrigen fünf MAI-Modelle sowie auf die Rohdaten der Coding-Benchmarks.
Detailblick: Was Microsoft jenseits von MAI Code 2 ausliefert
Die meisten Schlagzeilen bleiben bei MAI Code 2 stehen, doch Microsofts offizielle Ankündigung zeigt klar, dass die übrigen fünf Modelle gezielt teure Enterprise-Workloads angreifen, bei denen allgemeine Frontier-Modelle unnötig teuer sind:
- MAI Cyber 2 Flash (Security & Patching –
0,45 $vs.34,38 $pro Aufgabe): Mit1M-Token-Kontext auf defensive Schwachstellensuche, Threat-Triage und automatisches Patching spezialisiert. Auf Microsofts CyberGym-E2E-Benchmark erreicht es 92,3 % Erfolgsquote gegenüber 91,5 % bei GPT-6 Astra – zu weniger als 2 % der Kosten pro Aufgabe (0,45 $vs.34,38 $offline). Um Missbrauch zu begrenzen, liefert Microsoft das Modell nicht als offene Token-API aus, sondern über verifizierte Defender-Umgebungen (u. a. Codename MDASH und Defender ISOC). - Decision 1.1 (Enterprise-Routing –
0,042 $ / 1MTokens): Auf Basis von Google DeepMinds Open-Weight-Architektur Gemma (Gemma-MoE) ist Decision 1.1 bereits GA in Microsoft Foundry als dedizierter Klassifizierer, Verifizierer und Traffic-Router. Laut Microsoft arbeitet es bis zu 50× schneller und 79× günstiger als GPT-6.1 Sol – ideal, um Anfragen zu filtern, bevor teure Frontier-Modelle überhaupt angesprochen werden. - MAI Image 2.7 & Flash (Bildgenerierung –
~35 $/~10 $pro 1.000 Bilder): Im Public Preview auf Microsoft Foundry setzt MAI Image 2.7 auf konsistente, lokale Bildbearbeitung (#1 auf Artificial Analysis für Image Editing bei rund1/5der Kosten von GPT Image 2.6 Sunburst max), während MAI Image 2.7 Flash (~10 $ / 1.000Bilder) den interaktiven Canvas-Workspace mit niedriger Latenz antreibt. - MAI Realtime 1 (Native Sprachagenten – ab
0,01 $ / Audiominute): Microsofts erstes natives Speech-to-Speech-Modell beherrscht Unterbrechungen, Hintergrundgeräusche und steuerbare Prompts und schlägt GPT-Realtime 2.1. Wichtig im Kleingedruckten:0,01 $ / Audiominutegilt für die reine Audioschicht; Aufrufe eines dahinterliegenden Reasoning-Modells werden separat nach Tokens abgerechnet. - MAI Transcribe 2 (60-Sprachen-ASR im Produktivbetrieb): Unterstützt 60 Sprachen samt Sprechertrennung (Diarization), wortgenauen Zeitstempeln und hoher Robustheit bei Störgeräuschen. Microsoft nutzt es bereits produktiv in Dragon Copilot Transcribe und meldet eine Halbierung der mehrsprachigen Fehlerrate bei 10 Millionen Arzt-Patienten-Gesprächen pro Monat.
Exakte MSBench-Benchmarks: Die 14,4-Punkte-Lücke bei SWE-Atlas
Microsoft testete MAI Code 2, GPT-6.1 Sol und Claude Opus 5.5 auf MSBench über die GitHub Copilot CLI ohne Subagenten und mit maximalem Reasoning Effort:
| Benchmark | MAI Code 2 | GPT-6.1 Sol | Claude Opus 5.5 | MAI vs. Opus |
|---|---|---|---|---|
| DeepSWE 1.1 | 73,2 % | 74,6 % | 69,0 % | +4,2 Pkt. |
| Terminal-Bench 2.1 | 84,6 % | 85,0 % | 78,7 % | +5,9 Pkt. |
| SWE-Atlas | 43,1 % | 47,4 % | 57,5 % | −14,4 Pkt. |
| FrontierCode v1.1 | 52,0 % | 49,4 % | 56,0 % | −4,0 Pkt. |
| Durchschnitt (Pass Rate) | 63,2 % | 64,1 % | 65,3 % | −2,1 Pkt. |
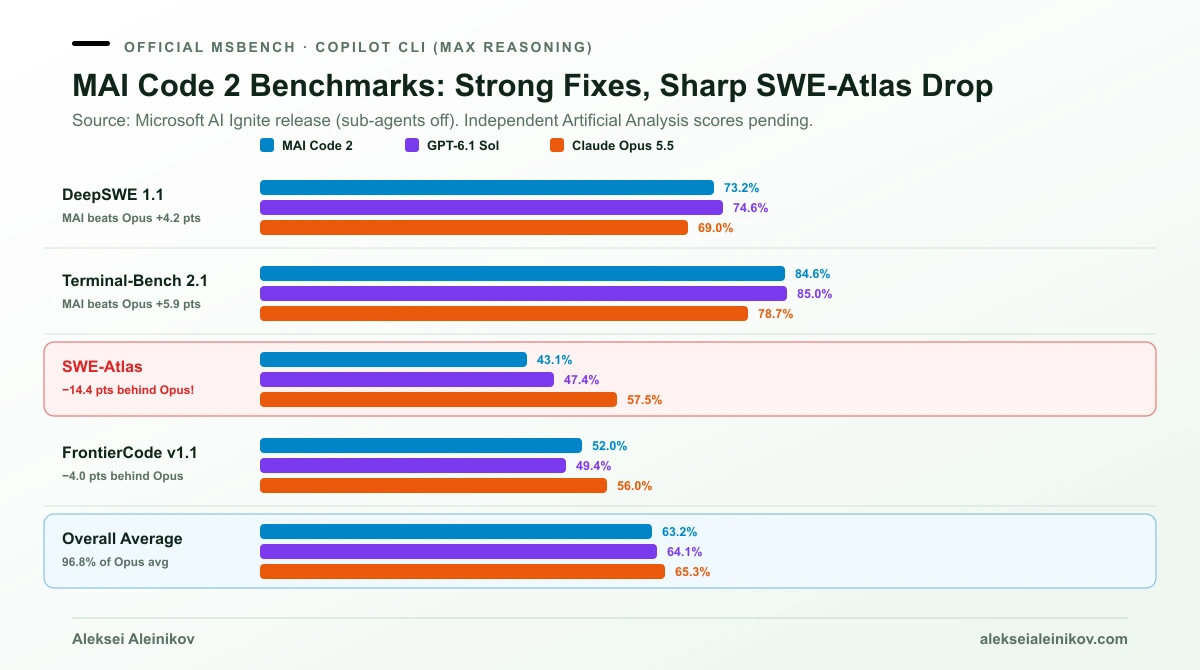
Die vier Einzelbalken erzählen eine deutlich ehrlichere Geschichte als der Durchschnitt „96 % von Opus“:
- Wo MAI Code 2 stark ist (
DeepSWE 1.1&Terminal-Bench 2.1): Bei klar abgegrenztem Debugging, Shell-Befehlen und gezielten Fixes liegtMAI Code 2um +4,2 bis +5,9 Punkte vor Opus 5.5 und fast gleichauf mit GPT-6.1 Sol. Erste Entwickler auf Hacker News, die das Modell direkt in Copilot getestet haben, bestätigen genau diesen Eindruck für den Arbeitsalltag. - Wo das Modell abfällt (
SWE-Atlas): Auf SWE-Atlas rutscht MAI Code 2 auf 43,1 % ab – ganze 14,4 Prozentpunkte hinter Opus 5.5 (57,5 %). Das deckt sich mit Microsofts eigener Einschränkung: MAI Code 2 ist noch nicht auf autonome Long-Horizon-Agenten oder tiefe Forschungsaufgaben ausgelegt. - Warum „4 % Rückstand im Schnitt“ im Alltag wehtun können: Wie Entwickler auf Reddit und HN anmerken, glättet ein Vier-Benchmark-Mittelwert harte Ausreißer. In großen Repositories kosten 14 % weniger gelöste Cross-File-Abhängigkeiten schnell mehr Review-Zeit, als man bei den Token-Kosten spart.
Preis-Realitätscheck: Promo-Tarif vs. Listenpreis ab 2027
Selbst ohne Einführungsrabatt sind die Preise aggressiv. Hier die veröffentlichten API-Sätze (inklusive des 50-%-Promo-Fensters bis 17. Mai 2027) im Vergleich zur Konkurrenz:
| Modell | Input / 1M | Output / 1M | Cache-Read / 1M | MSBench-Schnitt / Aufgabe |
|---|---|---|---|---|
| MAI Code 2 Flash (Promo → Liste) | 0,05 $ → 0,10 $ | 0,25 $ → 0,50 $ | 0,005 $ → 0,01 $ | Extrem günstig |
| MAI Code 2 (Promo bis Mai 2027) | 0,50 $ | 2,50 $ | 0,025 $ | 0,309 $ |
| MAI Code 2 (Liste ab Mai 2027) | 1,00 $ | 5,00 $ | 0,050 $ | ~0,618 $ |
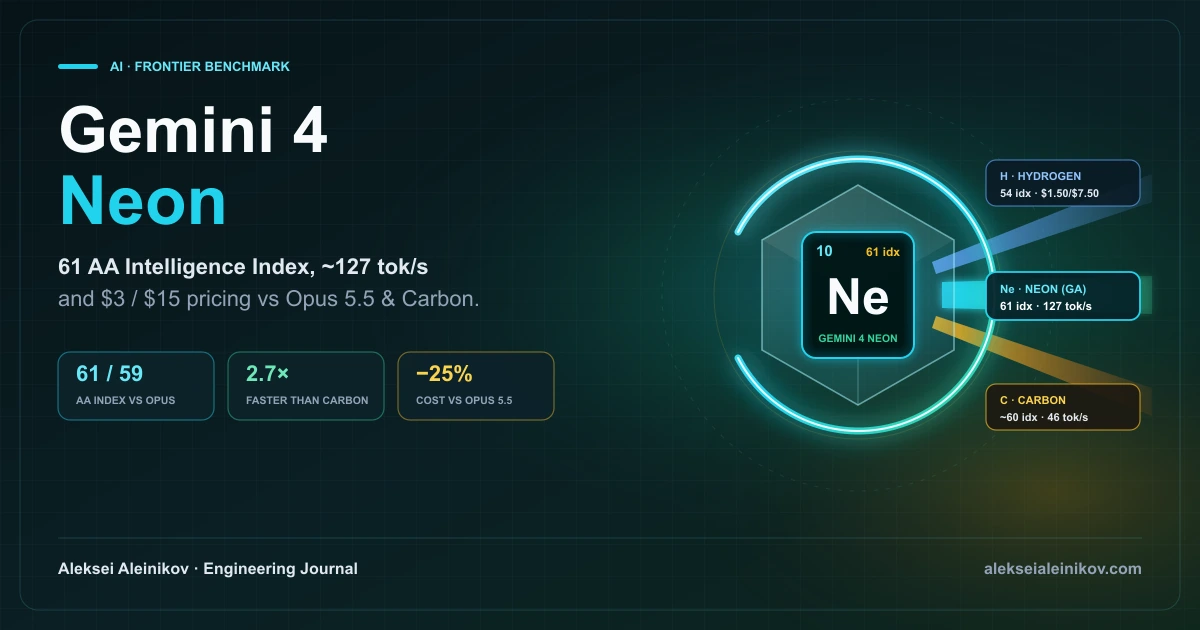
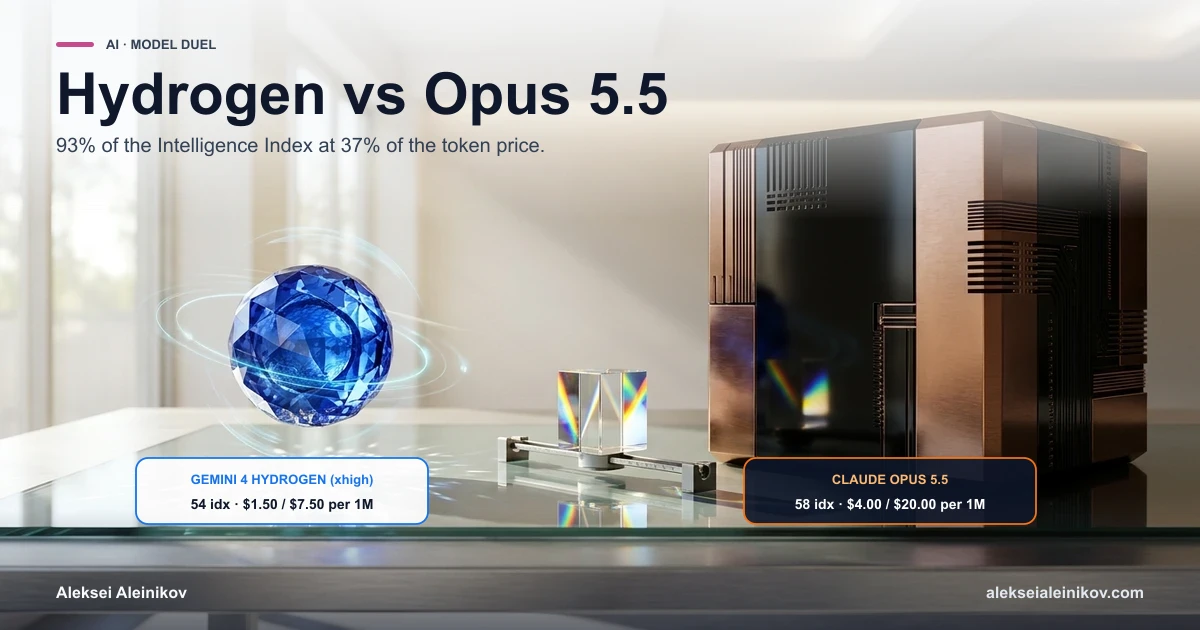
| Gemini 4 Hydrogen | 1,50 $ | 7,50 $ | 0,075 $ | Schnelles Arbeitstier |
| GPT-6.1 Sol | ~2,00 $ | ~10,00 $ | Cached-Tarif | 0,761 $ |
| Gemini 4 Neon | 3,00 $ (1,50 $ Flex) | 15,00 $ (7,50 $ Flex) | 0,15 $ | Frontier-Mitte (61 AA-Index) |
| Claude Opus 5.5 | 4,00 $ | 20,00 $ | 0,20 $ | 6,306 $ |
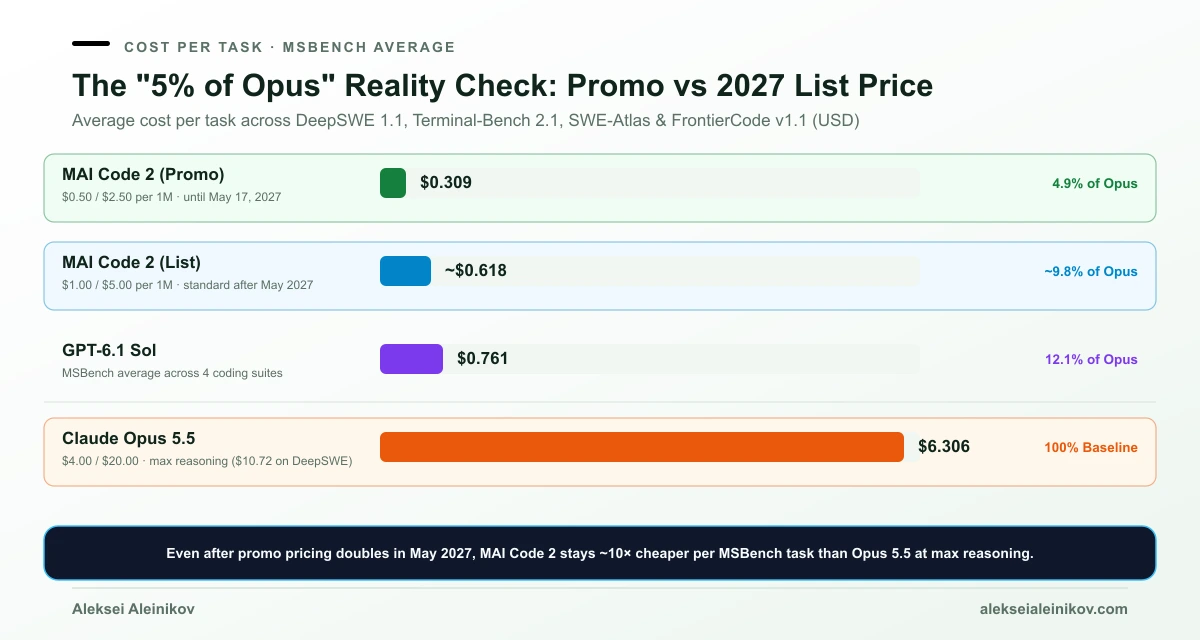
Zwei Punkte stechen sofort ins Auge:
- „5 % von Opus“ stimmt im Promo-Zeitraum – ab Mai 2027 sind es ~10 %: Auf MSBench kostete Opus 5.5 im Schnitt 6,306 $ pro Aufgabe (bis zu 10,72 $ bei DeepSWE 1.1), weil maximales Reasoning bei 20 $/1M Output extrem viele Tokens frisst. MAI Code 2 lag bei 0,309 $ (
4,9 %von Opus) – und selbst nach der Verdopplung auf1,00 $ / 5,00 $im Mai 2027 bleibt~0,618 $pro Aufgabe rund 10× günstiger als Opus 5.5. - Der Ökosystem-Haken: Anders als Gemini 4 Neon (ab Tag eins auf OpenRouter und Google AI Studio) stecken die MAI-Modelle fest in GitHub Copilot und Microsoft Foundry / Azure. Wer außerhalb von Azure arbeitet, hat aktuell wenig Grund, auf geschlossene Modelle ohne unabhängige Artificial-Analysis-Werte umzusteigen.
Was das für Engineering-Teams bedeutet
- Wenn ihr bereits GitHub Copilot nutzt: Routine-Coding, Tests und Terminal-Debugging lassen sich sofort auf MAI Code 2 (und MAI Code 2 Flash für Boilerplate) umstellen – bei enormer Kostenersparnis, während Opus 5.5 oder Gemini 4 Neon für komplexe Architektur bleiben.
- Wenn ihr ein AI Gateway auf Azure / Foundry betreibt: Decision 1.1 (
GA, bis zu 50× schneller und 79× günstiger als GPT-6.1 Sol) ist der heimliche Star der Ignite – ein eigener Gemma-MoE-Router vor teuren 15–20-$-Modellen rechnet sich ab Tag eins. - Für kritische autonome Agenten erst externe Tests abwarten: Solange
MAI Code 2nicht auf unabhängigen Leaderboards (Artificial Analysis, Vals.ai) bestätigt ist und dieSWE-Atlas-Lücke schließt, gehört es in die Rolle des günstigen Tages-Arbeitstiers, nicht des autonomen Chefarchitekten.
Aus der Community
Diskussion auf Mastodon & Bluesky
Antworten auf diesen Artikel aus dem offenen Netz, live geladen. Keine Werbung, keine Tracking-Skripte.
Antworte dort — es erscheint hier automatisch.