Ein Coding-Agent öffnet ein Repository, liest einen fehlgeschlagenen Test, ändert eine Datei und versucht es erneut. Seine abschließende Antwort umfasst vielleicht fünf Zeilen. Dahinter liegt ein wachsendes Lager aus Quellcode, Logs und verworfenen Plänen. Mit jedem neuen Schritt landet dieses Lager wieder beim Modell.
DeepSeek V4.1 Flash ist wegen des Umgangs mit diesem Lager interessant. Die zugrunde liegende Architektur benötigt weniger Rechenaufwand beim Einlesen und teilt komprimierten Attention-Speicher zwischen Schichten. Wer diese Mechanik versteht, kann besser einschätzen, wann günstige Agenten möglich werden und warum die Rechnung trotzdem aus dem Ruder laufen kann.
Was ändert das jüngste Update?
Der Release-Zusatz 1017 kennzeichnet ein bestimmtes Update und keine neue Architekturversion. DeepSeek beschreibt es als Update von V4.1 Flash mit Verbesserungen bei Agentenaufgaben, Programmierung und Bildverarbeitung. Repository und Gewichte stehen unter MIT-Lizenz. Die folgende Architekturerklärung betrifft das Basismodell V4.1 Flash, keine separat dokumentierte neue 1017-Architektur. Offizielle Modellkarte.
Bei einem Release helfen drei getrennte Fragen:
| Frage | Passende Grundlage |
|---|---|
| Was lässt sich einsetzen? | Lizenz, Gewichte, Eingabeformate und Serving-Dokumentation |
| Warum könnte der Betrieb effizient sein? | Architektur und genaue Speicherbilanz |
| Löst es die eigenen Aufgaben wirtschaftlich? | Akzeptierte Ergebnisse, Laufzeit und Gesamtkosten bei eigenen Aufgaben |
Die dritte Antwort ergibt sich nicht automatisch aus den ersten beiden. Ein Lager kann günstiger betrieben werden, während seine Mitarbeiter weiterhin zu viele Wege zurücklegen.
Warum lange Agentenverläufe Speicher kosten
Beim Serving sind zwei Phasen wichtig. Prefill verarbeitet den übergebenen Kontext. Decode erzeugt anschließend Schritt für Schritt die Fortsetzung. Der KV-Cache hält Attention-Schlüssel und -Werte früherer Token vor. Spätere Schritte können darauf zugreifen, ohne sämtliche Repräsentationen erneut aufzubauen.
Die Gewichte entsprechen den installierten Maschinen einer Fabrik, der KV-Speicher den laufenden Aufträgen auf ihren Werkbänken. Ein weiterer Kunde braucht nicht jede Maschine ein zweites Mal, aber Platz für seinen Auftrag. Lange Gespräche und gleichzeitige Nutzer belegen diese Arbeitsflächen.
Mixture-of-Experts setzt an einer anderen Stelle an: Ein Router wählt aus, welche Expertennetze ein Token verarbeiten. Das reduziert Rechenarbeit, ohne alle gespeicherten Gewichte verschwinden zu lassen. „Aktive Parameter“ sind deshalb weder Downloadgröße noch vollständige Hardwareanforderung. Die Serving-Seite dieser Unterscheidung erklärt vLLM vs Ollama.
Die Architektur: einlesen und mehr gemeinsam nutzen
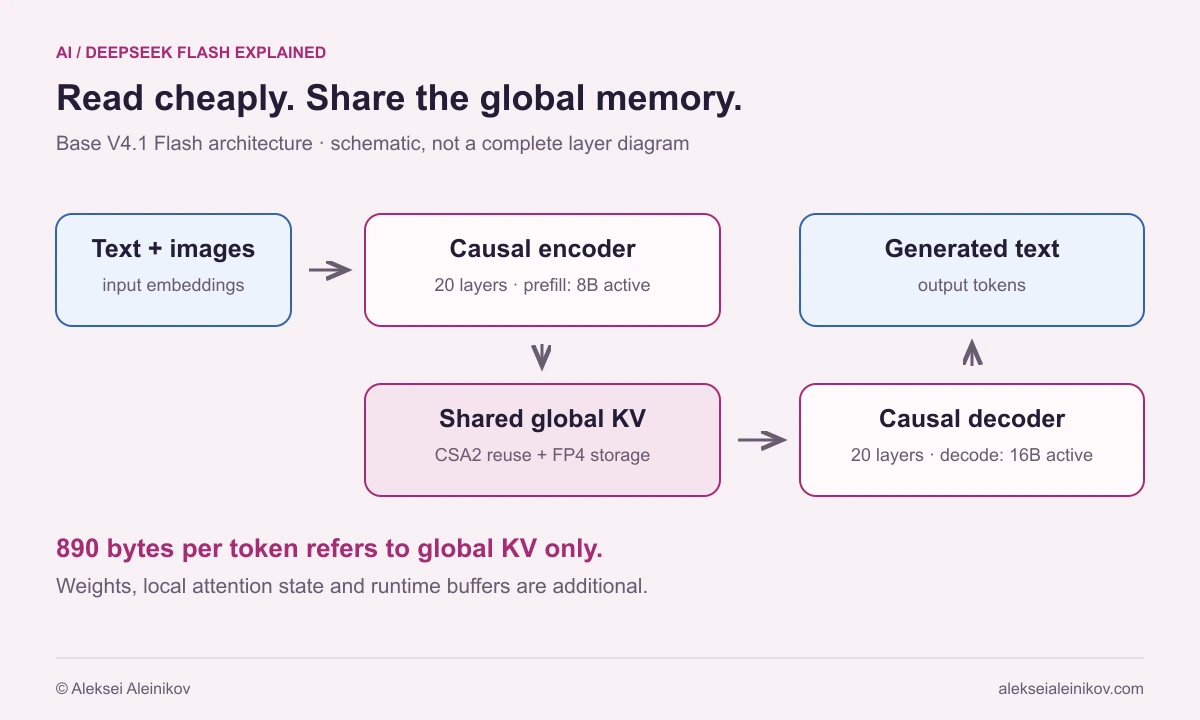
Das Basismodell hat 552 Milliarden Backbone-Parameter; beim Prefill sind 8 Milliarden, beim Decode 16 Milliarden aktiv. Der Causal Encoder-Decoder teilt 40 Schichten in zwei Gruppen zu je 20. Der globale KV-Speicher des Decoders wird aus den letzten Encoder-Zuständen projiziert. CSA2 teilt KV- und Indexierungsarbeit zwischen Schichten, FP4 reduziert die Präzision des Haupt-KV-Speichers. Dokumentation des Basismodells.
Drei Einsparungen sind auseinanderzuhalten:
- Günstigeres Einlesen. Die Verarbeitung einer großen Anfrage muss nicht genauso viel Berechnung aktivieren wie die Erzeugung der Antwort.
- Weniger doppelte Zustände. Schichten nutzen Informationen gemeinsam, anstatt jeweils eine eigene globale Repräsentation vorzuhalten.
- Kleinere Zahlenformate. Weniger Präzision reduziert die Bytes pro gespeichertem Wert.
Speicher gemeinsam zu nutzen bedeutet dabei nicht, die Hälfte des Prompts wegzulassen. Eine geringere numerische Präzision garantiert umgekehrt keine unveränderte Antwortqualität. Der Effizienzgewinn muss sich bei der tatsächlich benötigten Aufgabe bewähren.
Der technische Bericht nennt 890 Byte globalen KV-Speicher pro Token, ungefähr ein Viertel von V4 Flash. Separat rekonstruiert SWA Bounded Replay die jüngsten Sliding-Window-Zustände und reduziert den persistenten KV-Speicher auf ungefähr ein Achtel des Vorgängers. Diese Angaben betreffen unterschiedliche Speicherkomponenten. Technischer Bericht von DeepSeek.
Die Rechnung: 1.000.000 Token × 890 Byte = 890.000.000 Byte, also 890 MB oder etwa 849 MiB. Das ist nur die genannte Komponente. Gewichte, lokale Attention-Zustände, temporäre Puffer und weiterer Laufzeitspeicher fehlen. Unabhängige parallele Verläufe bringen zusätzlichen Zustand mit, sofern das Serving-System keinen identischen Präfix gemeinsam nutzen kann.
Deshalb zeigt die Titelgrafik ein Archiv, das als schmaler Faden durch ein Nadelöhr läuft: eine Metapher für einen verkleinerten Engpass. Daraus wird kein winziges ausführbares Modell.
Weniger Speicher kann lange Gespräche günstiger machen. Ob das Modell darin die richtigen Belege verwendet, beantwortet die Speicherbilanz nicht.
Was die Benchmarkgewinne belegen
Ein Ausschnitt aus DeepSeeks Release-Tabelle:
| Benchmark | Basis V4.1 Flash | 1017 | Veränderung in Prozentpunkten |
|---|---|---|---|
| Terminal-Bench 4.0 | 31.2 | 42.3 | +11.1 |
| DeepSWE v1.1 | 74.2 | 77.0 | +2.8 |
| ProgramBench | 20.3 | 29.1 | +8.8 |
Das sind Herstellerwerte. DeepSeek nennt Claude Code als Harness für Terminal-Bench und Mini-SWE-V2 für DeepSWE. Release-Tabelle mit Testumgebungen.
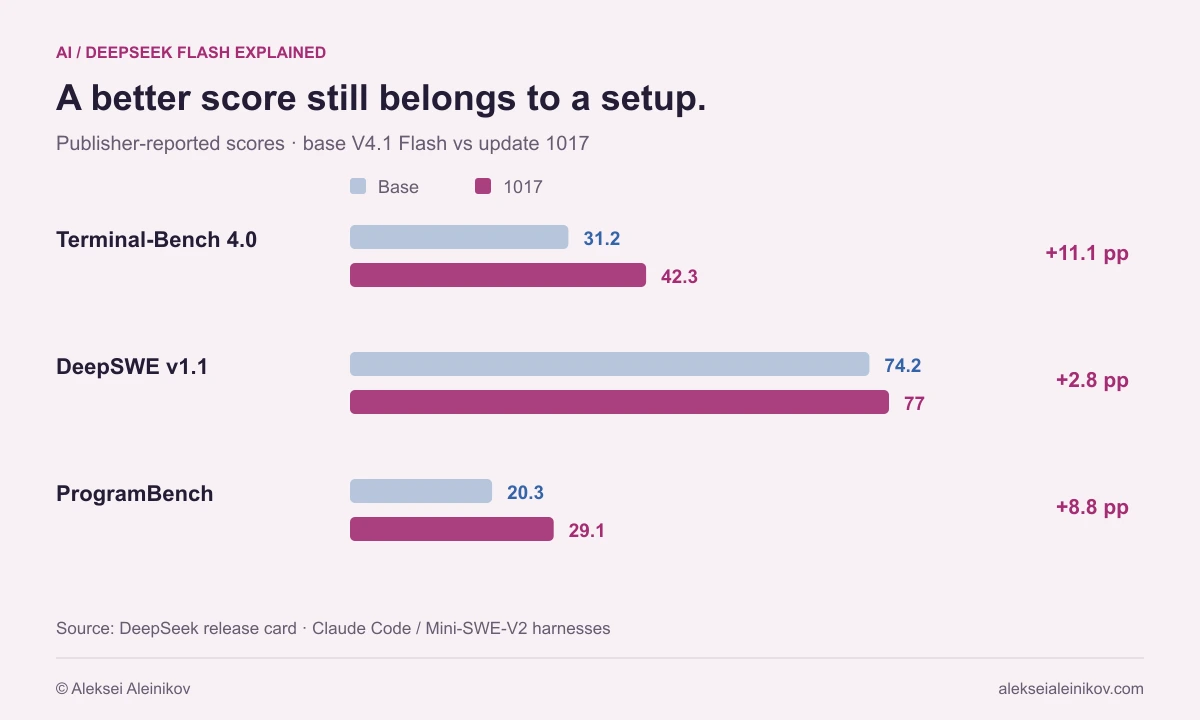
Die Einheit zählt: 42,3 minus 31,2 ergibt 11,1 Prozentpunkte. Eine „Verbesserung um 11,1 Prozent“ wäre eine andere Rechnung.
Der Agenten-Harness ist die Umgebung um das Modell: Tooldefinitionen, Prompts, Kontextverwaltung, Abbruchregeln und Fehlerbehandlung. Ein leistungsfähiges Modell kann mit einem schlechten Harness unnötige Schleifen drehen. Ein guter Harness kann mit denselben Gewichten mehr Aufgaben lösen. Das Ergebnis gehört zu dieser Kombination.
Nutzen lässt sich die Tabelle als Wegweiser für eigene Tests. Bei einem Terminal-Agenten gehören typische Probleme des eigenen Ablaufs hinein: eine mehrdeutige Fehlermeldung, ein hängender Befehl, eine fehlende Abhängigkeit oder eine Änderung, die einen Test repariert und einen anderen beschädigt. Ein Gesamtscore zeigt nicht, welcher Fall weiterhin teuer bleibt.
Preise: Cache-Rabatt und Ausgabefalle
Die offizielle gehostete API bietet ein Kontextfenster von einer Million Token. Beim Preis unterscheidet sie Haupt- und Nebenzeiten:
| Pro Million Token | Hauptzeit | Nebenzeit |
|---|---|---|
| Eingabe, Cache Miss | $0.30 | $0.15 |
| Eingabe, Cache Hit | $0.006 | $0.003 |
| Ausgabe | $1.20 | $0.60 |
Hauptzeiten sind Montag bis Freitag 01:00–04:00 und 06:00–10:00 UTC, ausgenommen chinesische Feiertage. Alle übrigen Zeiten gelten als Nebenzeiten. Das sind DeepSeeks Tarife; andere Anbieter können anders abrechnen. Offizielle Preisseite.
Ein Cache Hit ist zum selben Tarif 50-mal günstiger als ein Miss. Kostenlos ist er trotzdem nicht. Bei einem häufig wiederverwendeten Präfix kann die Ausgabe die Rechnung bestimmen.
Ein hypothetischer Aufruf mit 100.000 Eingabetoken und 10.000 abgerechneten Ausgabetoken kostet zur Hauptzeit:
Ungecachte Eingabe: 0,100 × $0,30  = $0,0300Ausgabe:           0,010 × $1,20  = $0,0120Gesamt:                              $0,0420
Vollständig gecachte Eingabe (idealisiert):Cache-Eingabe:     0,100 × $0,006 = $0,0006Gleiche Ausgabe:                     $0,0120Gesamt:                              $0,0126
Die Gesamtrechnung sinkt ungefähr um den Faktor 3,3, nicht 50. Der Rabatt betrifft die Eingabe, die Ausgabekosten bleiben gleich. Reale Folgeschritte enthalten neue Token; der vollständig gecachte Fall ist eine Rechengrenze, keine zugesicherte Trefferquote.
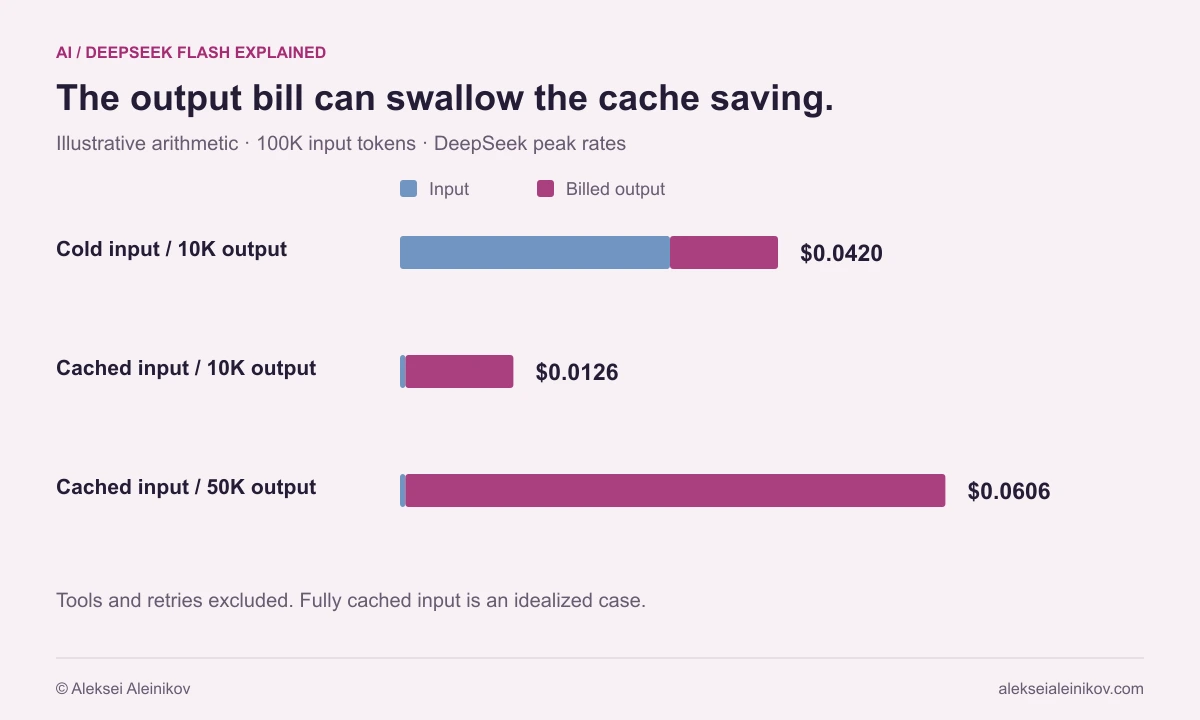
Steigt die Ausgabe auf 50.000 Token, kostet selbst der ideal gecachte Fall $0,0606. Das übersteigt den ursprünglichen Aufruf ohne Cache. Günstige Token können also durchaus teure Arbeit erzeugen.
Die passende Betriebskennzahl lautet:
Kosten pro akzeptiertem Ergebnis = (alle Modellaufrufe + Tools + Fehlversuche) / akzeptierte ErgebnisseWas „akzeptiert“ heißt, muss vorher feststehen: Ein Patch besteht die relevanten Tests, ein Bericht belegt seine Aussagen mit den richtigen Textstellen, eine Extraktion liefert korrektes Schema und korrekte Werte. Sonst misst man nur, wie günstig etwas fertig aussieht. Ein AI-Gateway kann die dafür nötige Abrechnung pro Aufruf sammeln.
Richtigen Alias aufrufen, richtigen Zustand erhalten
Die offizielle API ordnet deepseek-flash aktuell dem Update 1017 zu. Bei einer Evaluation gehören Alias und Datum ins Protokoll: Ein gleichbleibender Name kann später andere Gewichte bedienen. Dokumentation zum ersten API-Aufruf.
Diese minimale Anfrage folgt DeepSeeks dokumentiertem Chat-Completions-Format. Sie wurde für diesen Artikel nicht ausgeführt:
curl https://api.deepseek.com/chat/completions \ -H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \ -H "Content-Type: application/json" \ -d '{ "model": "deepseek-flash", "messages": [{"role": "user", "content": "Explain this failing test."}], "thinking": {"type": "enabled"}, "reasoning_effort": "high", "max_tokens": 4096 }'Ein wichtiges Integrationsdetail: Anfragen mit tools müssen bisheriges reasoning_content erhalten, auch aus Schritten ohne Toolaufruf. DeepSeek dokumentiert andernfalls einen 400-Fehler. Ohne tools wird bisheriges Reasoning ignoriert. Die gehostete API bietet die Effort-Stufen low, high und max; numerische Regler lokaler Modellwerkzeuge sind damit nicht automatisch austauschbar. Thinking-Mode-Dokumentation.
Ein Kontextfenster ist zunächst Kapazität. Der Harness entscheidet, welche Informationen diese Kapazität verdienen. Wer jedes alte Log behält, kann die relevante Fehlermeldung unter überholter Historie begraben. Context Engineering behandelt genau diese Auswahl.
So lässt sich der Einsatz im eigenen Agenten bewerten
Eine kleine Sammlung echter Aufgaben ist der Ausgangspunkt. Beim Modellvergleich bleibt der Harness unverändert. In die Sammlung gehören ein klar lösbarer Fall, eine unvollständige Anfrage, die eine Rückfrage verlangt, und eine Aufgabe, bei der der Agent vor einer nicht erlaubten Aktion stoppen muss.
Pro Lauf werden Ergebnis, Token nach Abrechnungskategorie, Gesamtdauer, Toolfehler und Wiederholungen erfasst. Die Akzeptanzkriterien gelten für alle Kandidaten gleich. Anschließend werden Reasoning-Aufwand und Kontextstrategie einzeln variiert. So wird sichtbar, ob eine günstigere Einstellung wirklich spart oder nur mehr Fehlversuche produziert.
Offene Gewichte sind eine Betriebsoption, keine Hardwarekalkulation. Ein Benchmarkgewinn belegt ein bestimmtes Setup, rechtfertigt aber keine zusätzlichen Zugriffsrechte. Aktionen brauchen explizite Berechtigungen; Ergebnisse sollten außerhalb des erzeugenden Modells geprüft werden.
DeepSeek Flash verfolgt eine nützliche architektonische Idee: Die Arbeit von gestern günstiger in den nächsten Schritt mitnehmen. Ob daraus ein wirtschaftlicher Agent entsteht, entscheidet sich nach dem Einlesen. Wer erledigte Arbeit zählt, macht aus dem attraktiven Tokenpreis eine überprüfbare Rechnung.
Aus der Community
Diskussion auf Mastodon & Bluesky
Antworten auf diesen Artikel aus dem offenen Netz, live geladen. Keine Werbung, keine Tracking-Skripte.
Antworte dort — es erscheint hier automatisch.