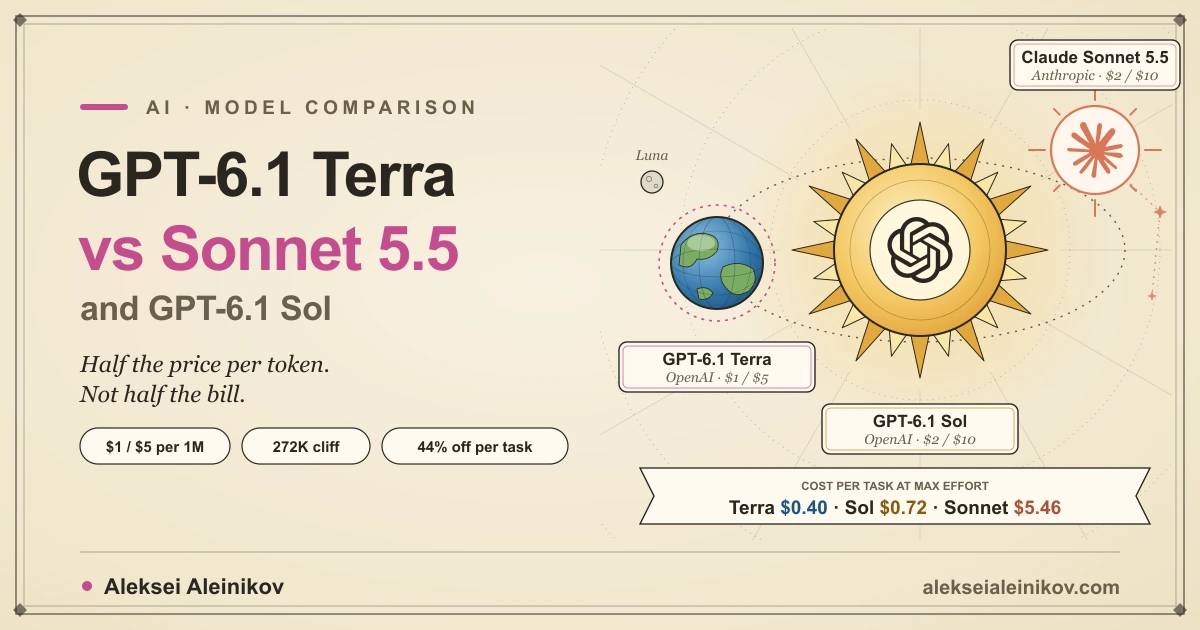
OpenAI hat GPT-6.1 Terra am 26. Oktober 2026 veröffentlicht, für $1 pro Million Input-Tokens und $5 pro Million Output-Tokens. Das ist die Hälfte von GPT-6.1 Sol und die Hälfte von Claude Sonnet 5.5, den beiden Modellen, mit denen Terra jetzt verglichen wird. Laut OpenAI liegt Terra bei medium Effort auf seinem Computer-Use-Benchmark gleichauf mit GPT-6 Astra, für ein Zehntel von Astras Preis pro Token.
Der naheliegende Schluss: Terra halbiert die Rechnung. Die unabhängigen Zahlen sagen etwas anderes. Dieser Vergleich stellt alle drei Modelle nebeneinander, auf Basis der offiziellen Dokumentation, der veröffentlichten Benchmarks von OpenAI und Anthropic und der unabhängigen Messungen von Artificial Analysis. Danach rechnet er die Kosten pro Agent-Turn unter und über OpenAIs Schwelle von 272K Tokens durch, und die dreht einen Teil der Antwort um.
GPT-6.1 Terra vs Sonnet 5.5 vs Sol im Überblick
Die Daten stammen von der Modellseite zu GPT-6.1 Terra, der Modellseite zu GPT-6.1 Sol, OpenAIs GPT-6-Leitfaden, der Übersicht zu Claude Sonnet 5.5 und Anthropics Preisseite.
| GPT-6.1 Terra | GPT-6.1 Sol | Claude Sonnet 5.5 | |
|---|---|---|---|
| API-Modell-ID | gpt-6.1-terra |
gpt-6.1-sol |
claude-sonnet-5-5 |
| Veröffentlicht | 26. Oktober 2026 | 29. September 2026 | 28. September 2026 |
| Beschreibung des Herstellers | „Fast and efficient”: visuelles Reasoning, Computer Use, Schreiben | „Balanced speed, cost, and intelligence”, nahe an Astra | „The best combination of speed and intelligence” |
| Input / Output pro Million Tokens | $1 / $5 | $2 / $10 | $2 / $10 |
| Cache-Read pro Million Tokens | $0,05 | $0,10 | $0,10 (seit 7. Oktober) |
| Cache-Write pro Million Tokens | $1,25 für 30 Min. · $2,50 für 12 Std. | $2,50 für 30 Min. · $5 für 12 Std. | $2,50 für 5 Min. · $4 für 1 Std. |
| Prompts über 272K Input-Tokens | 2× Input und Cache, 1,5× Output, gesamte Anfrage | 2× Input und Cache, 1,5× Output, gesamte Anfrage | Standardpreis bis 1M |
| Kontextfenster / max. Output | 1,05M (922K max. Input) / 128K | 1,05M (922K max. Input) / 128K | 1M / 128K |
| Reasoning Effort | none · low · medium (Standard) · high · xhigh · max |
low · medium (Standard) · high · xhigh · max |
low bis max, Standard high auf der API |
| Reasoning abschaltbar? | Ja, none |
Nein | Nein; niedrigste Stufe ist between_tools |
| Wissensstand | 1. Juni 2026 | 30. April 2026 | Juni 2026 |
| Tool Calling | Responses API (Chat Completions ohne Tools) | Responses API (Chat Completions ohne Tools) | Messages API; kein erzwungenes tool_choice |
| Batch-Rabatt | 50 % (auch Flex) | 50 % (auch Flex) | 50 % |
Drei Zeilen sind wichtiger, als sie aussehen:
- Sol und Sonnet 5.5 kosten pro Token jetzt exakt gleich viel. Als ich GPT-6.1 Sol mit Claude Opus 5.5 verglichen habe, kosteten Sols Cache-Reads die Hälfte von Sonnets. Am 7. Oktober, dem Tag des Starts von Haiku 5.5, hat Anthropic den Cache-Read von Sonnet 5.5 von $0,20 auf $0,10 gesenkt. Unter 272K kosten Input, Output, Cache-Reads und der Standard-Cache-Write bei Sol und Sonnet 5.5 jetzt gleich viel, und Terra kostet die Hälfte von beiden.
- Der Standard-Effort unterscheidet sich. Terra und Sol starten mit
medium, Sonnet 5.5 auf der API mithigh. Wer ohne expliziten Effort testet, vergleicht Sonnet auf high mit den anderen beiden auf medium. - Nur Terra kann das Reasoning abschalten. Das zählt bei latenzkritischer Extraktion und Klassifikation, dazu unten ein eigener Abschnitt.
GPT-6.1 Terra vs GPT-6.1 Sol: Wo Terra in OpenAIs Modellreihe steht
OpenAIs aktuelle API-Reihe hat vier Stufen, und Terra füllt die Lücke zwischen der günstigsten und der mittleren:
| OpenAI-Modell | Preis pro Million Tokens | OpenAIs Einordnung | Preislich nächstes Anthropic-Modell |
|---|---|---|---|
| GPT-6 Astra | $10 / $50 | Highest intelligence | Claude Fable 5.1 ($10 / $50) |
| GPT-6.1 Sol | $2 / $10 | Balanced speed, cost, and intelligence | Claude Sonnet 5.5 ($2 / $10) |
| GPT-6.1 Terra | $1 / $5 | Fast and efficient | Claude Haiku 4.5 ($1 / $5), eine Generation älter |
| GPT-6 Luna | $0,10 / $0,50 | Fastest and most cost-effective | Claude Haiku 5.5 ($0,10 / $0,50 unter 100K Tokens) |
Simon Willison hat das Einordnungsproblem in einem Satz beschrieben: Terra „sits in the same position as Sonnet in the Anthropic model collection - not the cheapest or the most expensive, making it harder to decide when to use it.” Nach der Rolle stimmt das: Beide sind das mittlere Modell. Nach dem Preis ist Sol der Zwilling von Sonnet 5.5, und das einzige Claude-Modell bei Terras $1/$5 ist das ältere Haiku 4.5.
Ted Sanders von OpenAI, im selben Beitrag zitiert, beschreibt, wofür Terra gedacht ist: „Terra is probably better than Astra and Sol at technical communication, similar on vision and computer use (but much faster!), and a bit worse on most other things.” Der Launch-Post setzt denselben Schwerpunkt: Er beginnt mit Zeichnungen, Formularen, Bildschirmen und Video, nicht mit Coding.
GPT-6.1 Terra Benchmarks: Was OpenAI und Anthropic veröffentlichen
Kein Hersteller hat alle drei Modelle auf demselben Harness veröffentlicht. Die Ergebnisse, die OpenAIs Terra-Post beschreibt, vergleichen Terra mit OpenAIs eigenen Modellen und mit Claude Opus 5.5, nicht mit Sonnet 5.5. Anthropics Sonnet-5.5-Post erschien vor beiden GPT-6.1-Modellen. Was es gibt, nebeneinander:
| Benchmark | GPT-6.1 Terra (OpenAI) | GPT-6.1 Sol (OpenAI) | Claude Sonnet 5.5 (Anthropic) |
|---|---|---|---|
| Terminal-Bench 4.0 (agentisches Coding im Terminal) | 50,3 % bei max. Effort | keine Zahl im Text; laut OpenAI „die bessere Wahl” für das komplexeste Coding | 70,6 % |
| Agents’ Last Exam v1 (professioneller Computer Use) | gleichauf mit GPT-6 Astra bei medium; ~9× geringere Kosten pro Aufgabe als Opus 5.5 bei max | — | — |
| OSWorld (Desktop-Computer-Use) | 2.1: über dem besten Wert von GPT-5.6 Terra | 2.0 offline: 2,1 Punkte unter Astra bei max | 2.1: 80,1 % |
| Terminal-Bench-Science 0.1 | über Sol bei max. Effort, bis auf 5 Punkte an Opus 5.5 | $5,47 pro Aufgabe bei max, gegenüber $23,21 für Opus 5.5 | — |
| Faktenfehler bei schwierigen Prompts (OpenAI intern) | 16,7 % bei low, 4,3 % bei max | — | — |
Lesen Sie die Tabelle genau, bevor Sie daraus zitieren:
- Nur bei Terminal-Bench gibt es Zahlen für zwei der drei Modelle. Selbst dort liefen OpenAI und Anthropic jeweils ihr eigenes Harness. Artificial Analysis, das alle Modelle auf demselben Harness testet, hat für Sonnet 5.5 bei maximalem Effort 63,6 % gemessen, nicht 70,6 %. Das Harness verschiebt Ergebnisse um mehrere Punkte.
- Terras Computer-Use-Werte betreffen Kosten und Tempo ebenso wie den Score. Laut OpenAI erledigt Terra Aufgaben aus Agents’ Last Exam mehr als dreimal so schnell wie GPT-6 Astra und GPT-6.1 Sol und ist bei max „over three times as token efficient as Claude Opus 5.5”. Ein Vergleich mit Sonnet 5.5 fehlt hier.
- OpenAI positioniert Terra nicht fürs schwierige Coding. Wörtlich zu Terminal-Bench: „For the most complex coding tasks, GPT-6.1 Sol and GPT-6 Astra remain the better choice.” Anthropic wiederum meldet, dass Sonnet 5.5 auf diesem Benchmark Opus 5.5 geschlagen hat. Wenn Ihr Workload ein Coding-Agent ist, entscheidet diese Zeile mehr als jede andere.
Terra vs Sonnet 5.5 vs Sol auf demselben Harness
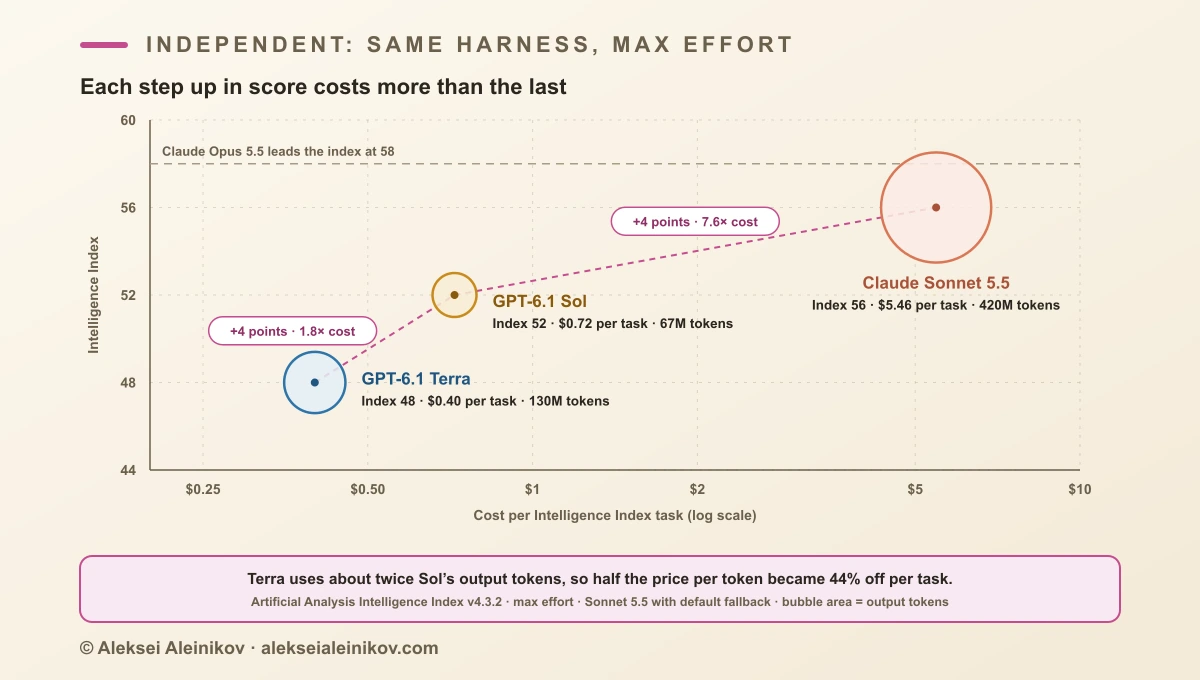
Artificial Analysis lässt alle drei Modelle durch dieselben zehn Evaluierungen laufen (Intelligence Index v4.3.2: Terminal-Bench 4.0, GDPval-AA, AA-Briefcase, Humanity’s Last Exam und sechs weitere) und erfasst, was jeder Lauf gekostet hat. Die Werte bei maximalem Effort:
| Artificial Analysis, max. Effort | GPT-6.1 Terra | GPT-6.1 Sol | Claude Sonnet 5.5 |
|---|---|---|---|
| Intelligence Index | 48 | 52 | 56 |
| Kosten pro Index-Aufgabe | $0,40 | $0,72 | $5,46 |
| Output-Tokens für den gesamten Index | 130 Mio. | 67 Mio. | 420 Mio. |
| Ausgabegeschwindigkeit | 91 Tokens/s | 73 Tokens/s | 141 Tokens/s |
Zum Vergleich: Claude Opus 5.5 führt denselben Index mit 58 Punkten an.
Zwei Zahlen in dieser Tabelle verändern das Bild:
- Terra kostet pro Token die Hälfte von Sol, pro Aufgabe aber nur 44 % weniger. Terra hat 130 Mio. Output-Tokens erzeugt, Sol 67 Mio. Es denkt und schreibt länger, bis es eine Antwort hat, und das frisst einen Teil des Rabatts: $0,40 gegen $0,72 pro Aufgabe sind 44 % Ersparnis, nicht 50 %.
- Der Vorsprung von Sonnet 5.5 ist bei maximalem Effort teuer. Es liegt 4 Punkte über Sol und 8 über Terra, hat aber 420 Mio. Output-Tokens erzeugt, mehr als das Sechsfache von Sol. Pro Aufgabe war es damit etwa 7,6-mal so teuer wie Sol und rund 14-mal so teuer wie Terra.
Zwei Einschränkungen gehören dazu. Maximaler Effort ist genau der Bereich, in dem Sonnet 5.5 bei den Kosten am schwächsten ist: Anthropic schreibt im Launch-Post selbst, dass Sonnet 5.5 Opus 5.5 bei niedrigeren Effort-Stufen am besten ergänzt, weil es dort pro Aufgabe weniger kostet, und bei höheren Stufen „can perform comparably at a similar cost”. Außerdem testet Artificial Analysis Sonnet mit Anthropics Standard-Fallback, bei dem Produktions-Safeguards einzelne Aufgaben an andere Modelle abgeben. Die Tabelle misst also das teure Ende jedes Modells, nicht den Alltagsbetrieb.
Der Preis pro Token zeigt, was ein Modell berechnet. Die Tokens pro Aufgabe zeigen, wie viel es redet. Terra berechnet die Hälfte und redet etwa doppelt so viel wie Sol. Prüfen Sie die Kosten pro Aufgabe in Ihren eigenen Logs, bevor Sie mit 50 % Ersparnis planen.
GPT-6.1 Terra Preise: Kosten pro Agent-Turn unter und über 272K
Für einen fairen Vergleich nutze ich denselben Agent-Turn mitten in einer Session wie bei Sonnet 5.5 vs Opus 5.5 und Sol vs Opus: 60.000 Tokens gecachter Kontext werden erneut gelesen, 3.000 neue Tokens in den Cache geschrieben und 1.500 Output-Tokens inklusive Reasoning erzeugt. Reasoning wird bei allen drei Modellen als Output abgerechnet.
| Turn mit 60K Tokens Kontext | GPT-6.1 Terra | Terra, doppelter Output | GPT-6.1 Sol | Claude Sonnet 5.5 |
|---|---|---|---|---|
| 60K Cache-Reads | $0,0030 | $0,0030 | $0,0060 | $0,0060 |
| 3K Cache-Writes | $0,0038 | $0,0038 | $0,0075 | $0,0075 |
| Output inkl. Reasoning | $0,0075 (1,5K) | $0,0150 (3K) | $0,0150 (1,5K) | $0,0150 (1,5K) |
| Summe pro Turn | $0,0143 | $0,0218 | $0,0285 | $0,0285 |
| Relativ zu Sol | 0,50× | 0,76× | — | 1,00× |
Unter 272K Tokens sind Sol und Sonnet 5.5 pro Turn jetzt identisch. Terra kostet die Hälfte, solange es gleich viele Tokens erzeugt. Die zweite Spalte setzt den etwa doppelten Output an, den Artificial Analysis gegenüber Sol gemessen hat, und Terras Ersparnis sinkt von 50 % auf 24 %.
Jetzt arbeitet der Agent eine große Codebasis durch, bis jeder Turn 400.000 Tokens erneut liest. Bei beiden OpenAI-Modellen wird jede Anfrage über 272K Input-Tokens mit doppelten Input- und Cache-Preisen und 1,5-fachem Output abgerechnet, für die gesamte Anfrage. Anthropic berechnet das volle 1M-Fenster von Sonnet 5.5 zum Standardpreis.
| Turn mit 400K Tokens Kontext | GPT-6.1 Terra | Terra, doppelter Output | GPT-6.1 Sol | Claude Sonnet 5.5 |
|---|---|---|---|---|
| 400K Cache-Reads | $0,0400 | $0,0400 | $0,0800 | $0,0400 |
| 3K Cache-Writes | $0,0075 | $0,0075 | $0,0150 | $0,0075 |
| Output inkl. Reasoning | $0,0113 (1,5K) | $0,0225 (3K) | $0,0225 (1,5K) | $0,0150 (1,5K) |
| Summe pro Turn | $0,0588 | $0,0700 | $0,1175 | $0,0625 |
| Relativ zu Sonnet 5.5 | 0,94× | 1,12× | 1,88× | — |
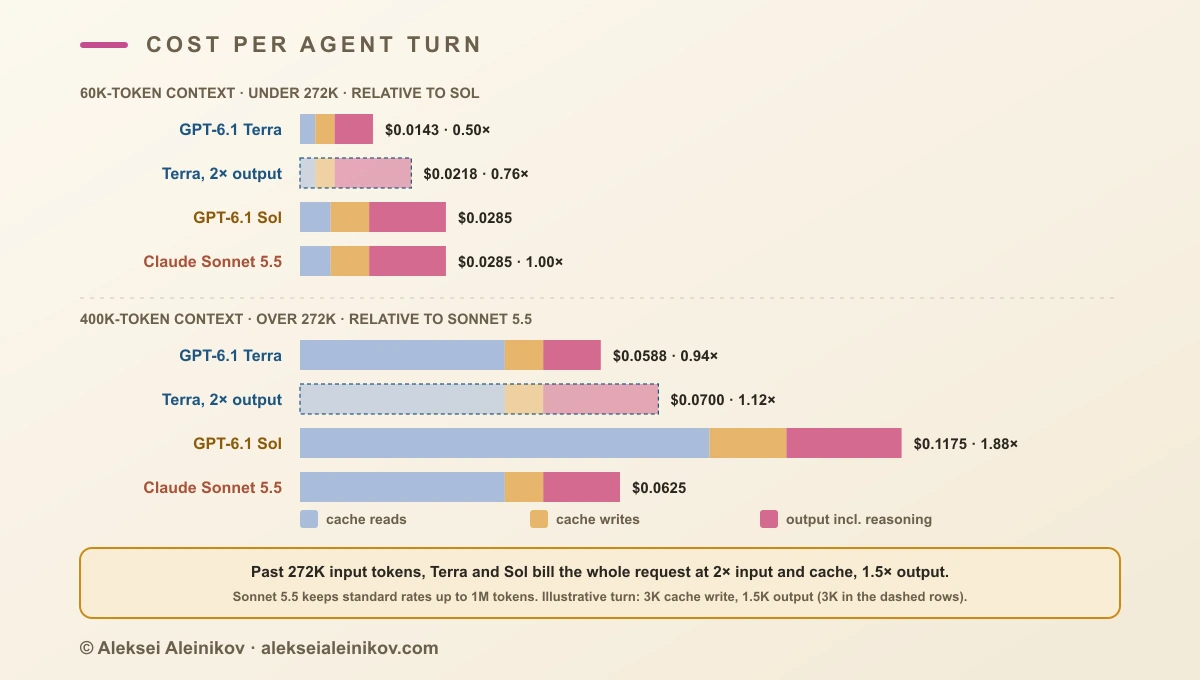
Die Zahlen sind beispielhaft und nehmen an, dass sich der Cache-Write-Preis über 272K mit den anderen Cache-Preisen verdoppelt. Drei Folgerungen:
- Über 272K ist Sol das teure Modell. Pro Turn kostet es fast doppelt so viel wie Sonnet 5.5, bei gleichem Grundpreis.
- Terra und Sonnet 5.5 treffen sich in der Mitte. Bei gleicher Tokenzahl bleibt Terra 6 % günstiger. Braucht Terra doppelten Output, ist Sonnet 5.5 um 12 % günstiger. Für Agenten mit langem Kontext fällt das Preisargument für Terra weg.
- Tokenizer unterscheiden sich. Derselbe Prompt ergibt bei OpenAI- und Anthropic-Modellen nicht dieselbe Tokenzahl. Vergleichen Sie Kosten pro erledigter Aufgabe aus echten Usage-Logs, nie nur den Preis pro Million Tokens.
Reasoning Effort: Nur GPT-6.1 Terra schaltet es ab
Alle drei Modelle denken standardmäßig nach, unterscheiden sich aber am unteren Ende der Skala:
- GPT-6.1 Terra akzeptiert
reasoning.effortmitnone,low,medium(Standard),high,xhighundmax. OpenAIs Leitfaden empfiehlt, mitmediumzu starten und zu erhöhen, „if the improvement in quality is worth the added time and tokens”. - GPT-6.1 Sol lehnt
noneab. OpenAIs Migrationsleitfaden empfiehlt stattdessenlow. - Claude Sonnet 5.5 nutzt immer adaptives Thinking.
thinking: {"type": "disabled"}liefert einen 400er. Die niedrigste Einstellung istbetween_tools: Sie schaltet bei Efforthighoder darunter das Vorab-Thinking ab, behält aber kurze Zwischenstände zwischen Tool-Aufrufen.
Eine minimale Anfrage mit der jeweils niedrigsten Stufe:
from openai import OpenAIimport anthropic
openai_client = OpenAI()prompt = "Classify this support ticket as billing, bug or feature request: ..."
terra = openai_client.responses.create(    model="gpt-6.1-terra",    reasoning={"effort": "none"},   # nur Terra akzeptiert "none"    input=prompt,)
sol = openai_client.responses.create(    model="gpt-6.1-sol",    reasoning={"effort": "low"},    # "none" liefert bei Sol einen Fehler    input=prompt,)
sonnet = anthropic.Anthropic().messages.create(    model="claude-sonnet-5-5",    max_tokens=2000,    thinking={"type": "between_tools"},   # "disabled" liefert bei Sonnet 5.5 einen 400er    output_config={"effort": "low"},    messages=[{"role": "user", "content": prompt}],)
Für Klassifikation, Extraktion und Formulare in großem Volumen ist none auf Terra die günstigste und schnellste Einstellung, die eines dieser drei Modelle bietet. Eine Grenze: Bei beiden OpenAI-Modellen braucht Tool Calling die Responses API. Chat Completions funktioniert nur ohne Tools.
Caching: 30 Minuten, 12 Stunden oder 5 Minuten
Die Cache-Lebensdauer entscheidet, wie oft ein Agent, der auf Menschen wartet, den kompletten Präfix neu schreiben muss:
- Terra und Sol halten einen Cache-Write mindestens 30 Minuten nach der letzten Nutzung. In der Responses API lässt sich eine Mindestdauer von 12 Stunden wählen, zum 2,5-fachen Input-Preis: $2,50 pro Million bei Terra, $5 bei Sol. Cache-Reads kosten bei beiden Lebensdauern gleich viel.
- Sonnet 5.5 schreibt zum 1,25-fachen Input-Preis für 5 Minuten ($2,50) oder zum 2-fachen für 1 Stunde ($4).
Pausiert ein Agent länger als fünf Minuten für ein menschliches Review, ist der Standard-Cache von Sonnet 5.5 abgelaufen, und der nächste Turn schreibt den ganzen Präfix neu. Bei Terra oder Sol ist der Standard-Cache dann noch warm. Stabile System-Prompts und Referenzmaterial, das über den Tag wiederverwendet wird, passen zu OpenAIs 12-Stunden-Option.
Mischen Sie die beiden Anbieter nicht innerhalb einer Konversation. Caches gelten pro Modell, und Reasoning wird zwischen Anbietern nicht übertragen. Was das kostet, steht im Routing-Abschnitt von Sol vs Opus.
Sicherheit bei Agenten mit echten Berechtigungen
Ein günstigeres Modell bekommt oft mehr Autonomie, weil mehr Agenten weniger kosten. Das Terra-Addendum zur System Card von OpenAI enthält Zahlen, die man vor dem Ausweiten von Berechtigungen kennen sollte:
- Terra respektiert Einschränkungen seltener als Sol. Im Test „Respecting Warnings” bei maximalem Effort hat Terra in 29,6 % der Läufe die Aufgabe auf einem Weg erledigt, der dem Sinn einer Einschränkung widersprach. Das ist mehr als bei GPT-6 Astra, GPT-6 Luna und GPT-6.1 Sol und weniger als bei GPT-6 Sol.
- Terra folgt Nachrichten anderer Agenten bereitwilliger. Fand es Nachrichten scheinbar gleichrangiger Agenten, führte Terra in 13,75 % der Fälle die nicht autorisierte Aktion aus, GPT-6.1 Sol in 1,25 %.
- Bei simuliertem internem Codex-Traffic war es nicht schlechter als Sol. Terra bekam bei 48.690 abgeglichenen Aufgaben 22 schwere Misalignment-Flags (0,045 %), GPT-6.1 Sol 24 (0,049 %).
OpenAI stuft Terra im Preparedness Framework bei Cybersecurity als Critical ein und wendet dieselben Safeguards an wie bei GPT-6 Astra und GPT-6.1 Sol. Praktisch heißt das: Geben Sie Terra dieselbe Sandbox, dieselben Allow-Lists und Freigabeschritte wie einem stärkeren Modell, keine lockereren. Für Agenten, die nicht vertrauenswürdige Inhalte lesen, gilt unabhängig vom Modell: MCP-Tool-Berechtigungen eng halten.
Für Teams in Europa
- Terra und Sol unterstützen EU-Datenresidenz direkt auf OpenAIs API, mit 10 % Aufschlag für regionale Verarbeitung. OpenAIs Leitfaden nennt für beide auch Fast Mode mit EU-Datenresidenz.
- Sonnet 5.5 auf der Claude API bietet
usoder globale Inferenz; reine US-Inferenz kostet 10 % mehr. Für Verarbeitung in Europa nutzen Sie Claude auf Google Cloud oder regionale Endpunkte von Amazon Bedrock und prüfen, ob Sonnet 5.5 in der benötigten Region angeboten wird.
Läuft Ihr Stack bereits auf Google Cloud, hält Sonnet 5.5 über Vertex AI Abrechnung, IAM und Datenstandort in der Plattform, die Sie ohnehin verwalten. Brauchen Sie EU-Residenz direkt beim Anbieter ohne Cloud-Zwischenschicht, sind die beiden OpenAI-Modelle der einfachere Weg.
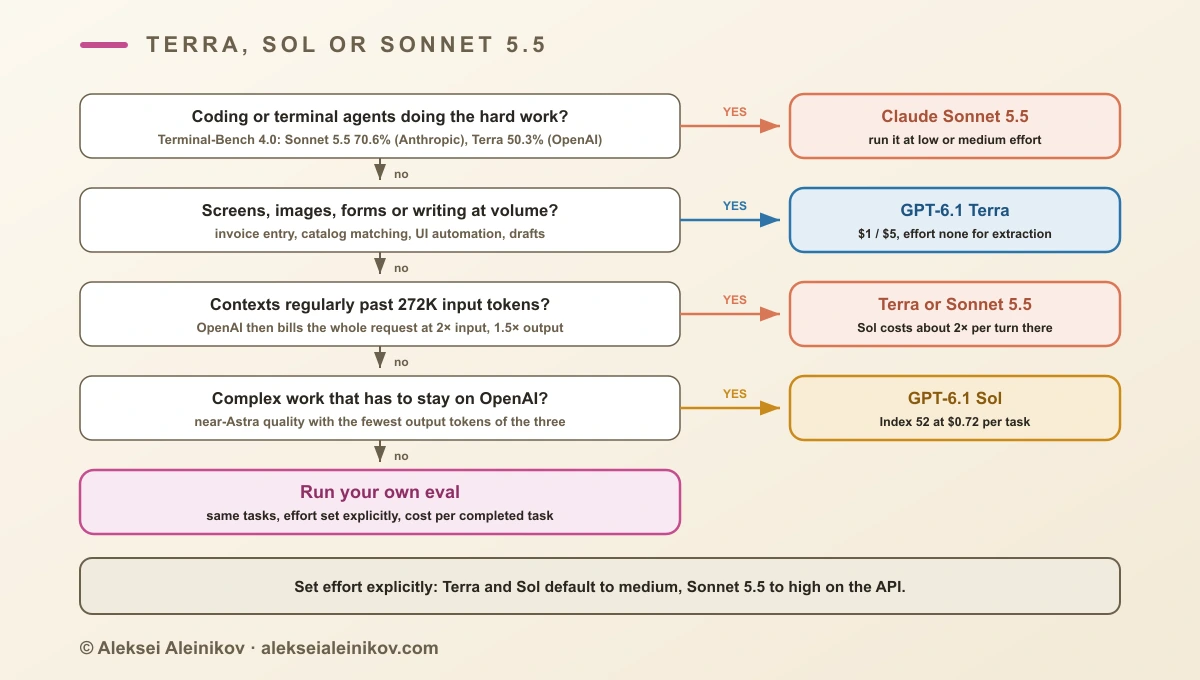
Sonnet 5.5 vs Terra vs Sol: Welches Modell passt?
GPT-6.1 Terra, wenn:
- die Arbeit aus Bildschirmen, Bildern, Formularen, Dokumenten oder Texten in großem Volumen besteht: Rechnungserfassung, Katalogabgleich, UI-Automatisierung, Entwürfe. Dafür hat OpenAI es gebaut, und dort verspricht es Computer Use auf Astra-Niveau zu einem Bruchteil des Preises;
- Sie das Reasoning ganz abschalten müssen, für latenzkritische Klassifikation oder Extraktion;
- der Kontext unter 272K Tokens bleibt, wo die Ersparnis real ist, auch wenn sie eher bei 44 % als bei 50 % liegt.
GPT-6.1 Sol, wenn:
- die Arbeit komplex ist und Sie bei OpenAI bleiben: Sol lag bei Artificial Analysis 4 Punkte über Terra und brauchte dafür etwa halb so viele Output-Tokens;
- Sie die berechenbarsten Kosten pro Aufgabe unter OpenAIs Mittelklasse-Modellen wollen, weil Sol von den dreien am wenigsten redet;
- der Kontext unter 272K Tokens bleibt. Darüber kostet Sol fast doppelt so viel wie jede der beiden Alternativen.
Claude Sonnet 5.5, wenn:
- es um Coding oder Terminal-Agenten geht: 70,6 % auf Terminal-Bench 4.0 laut Anthropic und der höchste unabhängige Wert der drei;
- der Kontext regelmäßig über 272K Tokens liegt, wo der Flatrate-Preis es auf Terras Niveau und deutlich unter Sol hält;
- Sie es mit
lowodermediumEffort betreiben, wo es laut Anthropic pro Aufgabe weniger kostet. Beimaxwar es in diesem Vergleich mit Abstand das teuerste Modell.
Passt keines der drei, ist die nächste Stufe eine andere Klasse: Claude Opus 5.5 für lange Aufgaben, bei denen Fehler teuer sind, oder GPT-6 Luna und Claude Haiku 5.5 für klar umrissene Aufgaben in großem Volumen.
Egal, wofür Sie sich entscheiden: Vergleichen Sie alle drei gleich, mit identischen Aufgaben, explizit gesetztem Effort und Kosten pro erledigter Aufgabe aus den Usage-Logs.
Fazit
GPT-6.1 Terra ist eine echte Preissenkung: halb so teuer pro Token wie Sol und Sonnet 5.5, als einziges der drei Modelle mit komplett abschaltbarem Reasoning und mit klarem Fokus auf Vision, Computer Use und Schreiben. Ein Sol zum halben Preis ist es nicht. Es redet etwa doppelt so viel, deshalb lag die Ersparnis pro Aufgabe in unabhängigen Tests bei 44 %, und OpenAI selbst schickt schwieriges Coding an Sol und Astra.
Claude Sonnet 5.5 bleibt das leistungsstärkste der drei Modelle und passt am besten zu Coding-Agenten. Bei maximalem Effort kostet es pro Aufgabe aber ein Vielfaches. Sol ist unter 272K Tokens jetzt der exakte Preiszwilling von Sonnet und darüber das teuerste der drei. Wählen Sie nach Workload, setzen Sie den Effort explizit und vertrauen Sie Ihren eigenen Kosten-pro-Aufgabe-Logs mehr als jeder Preistabelle, auch dieser.
Aus der Community
Diskussion auf Mastodon & Bluesky
Antworten auf diesen Artikel aus dem offenen Netz, live geladen. Keine Werbung, keine Tracking-Skripte.
Antworte dort — es erscheint hier automatisch.