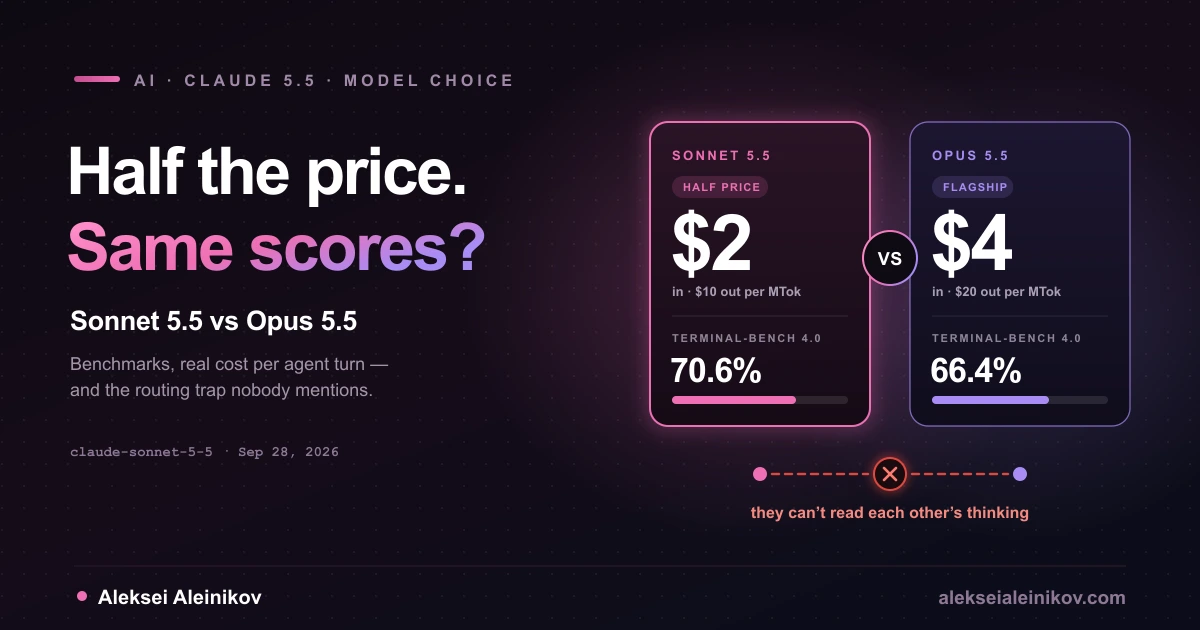
Anthropic hat Claude Sonnet 5.5 am 28. September 2026 veröffentlicht, und eine Zahl aus dem Launch-Beitrag erklärt die Aufmerksamkeit: Bei Terminal-Bench 4.0, einem Benchmark für agentisches Coding in der Kommandozeile, erreicht Sonnet 5.5 70,6 %. Opus 5.5, das eine Woche zuvor erschienene Flaggschiff zum doppelten Preis, kommt auf seiner besten Effort-Stufe auf 66,4 %.
Der naheliegende Plan schreibt sich also von selbst: Routinearbeit an Sonnet, die schweren Teile an Opus eskalieren, Differenz einstreichen. Dieser Leitfaden vergleicht beide Modelle anhand der von Anthropic veröffentlichten Zahlen, rechnet den tatsächlichen Preisabstand pro Agent-Turn aus und zeigt dann die Zeile in der Dokumentation, die genau diesen naheliegenden Router still und leise schlechter macht als jedes der beiden Modelle allein.
Sonnet 5.5 vs. Opus 5.5 auf einen Blick
Die Angaben stammen von der Modellseite zu Sonnet 5.5 und der Modellübersicht.
| Claude Sonnet 5.5 | Claude Opus 5.5 | |
|---|---|---|
| API-Modell-ID | claude-sonnet-5-5 |
claude-opus-5-5 |
| Input / Output pro Million Tokens | 2 $ / 10 $ | 4 $ / 20 $ |
| Cache Read pro Million Tokens | 0,20 $ | 0,20 $ |
| 5-Minuten-Cache-Write | 2,50 $ | 5 $ |
| Kontextfenster / max. Output | 1M / 128K | 1M / 128K |
| Thinking | Adaptiv; reduzierbar auf between_tools |
Adaptiv, immer aktiv |
| Standard-Effort auf der Claude API | high |
medium |
| Relative Latenz | Schnell | Mittel |
| Wissensstand | Juni 2026 | Juni 2026 |
| Anthropics eigene Beschreibung | „Die beste Kombination aus Geschwindigkeit und Intelligenz“ | „Für langlaufendes agentisches Coding und Wissensarbeit“ |
Zwei Zeilen dieser Tabelle sind wichtiger, als sie aussehen:
- Cache Reads kosten dasselbe. Opus 5.5 liest seinen Cache zu 5 % seines Input-Preises, Sonnet 5.5 zu 10 % seines – beide landen bei 0,20 $. In Agent-Loops, die in jedem Turn einen langen gecachten Präfix neu lesen, ist das der Großteil der Input-Rechnung. Warum das so viel ausmacht, habe ich in der Cache-Read-Regel bei den Preisen von Fable und Mythos beschrieben.
- Der Standard-Effort unterscheidet sich. Sonnet 5.5 startet auf der API mit
high, Opus 5.5 mitmedium. Wer beide ohne gesetztesoutput_config.effortim A/B-Test vergleicht, vergleicht Sonnet auf high mit Opus auf medium. In Claude Code und den Claude-Apps läuft Sonnet 5.5 standardmäßig aufmedium.
Beide Modelle gibt es auf der Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry und Claude Platform on AWS. Ein kleineres Haiku 5.5 ist „in den kommenden Wochen“ angekündigt.
Die Benchmarks: Wo das günstigere Modell gewinnt
Das sind die von Anthropic im Launch-Beitrag veröffentlichten Zahlen. Der Terminal-Bench-Wert von Opus 5.5 ist sein höchster, gemessen auf xhigh.
| Benchmark | Sonnet 5.5 | Opus 5.5 | Sonnet 5 | Sonnet vs. Opus |
|---|---|---|---|---|
| Terminal-Bench 4.0 (agentisches Coding im Terminal) | 70,6 % | 66,4 % | 10,3 % | +4,2 |
| FrontierCode 1.1 Main (mergefähige Änderungen) | 52,1 % auf xhigh · 46,2 % auf max | 54,4 % | 42,4 % | −2,3 |
| CursorBench 4.0 (echte Cursor-Sessions) | 55,5 % | 57,8 % | 34,1 % | −2,3 |
| GDPval-AA v2.1 (44 Berufe, Elo) | 1844 | 1846 | 1449 | −2 |
| AA-Briefcase v1.1 (Wissensarbeit, Elo) | 1811 | 1822 | 1359 | −11 |
| Humanity’s Last Exam, mit Tools | 64,5 % | 67,7 % | 54,9 % | −3,2 |
| OSWorld 2.1 (Computer Use) | 80,1 % | 81,8 % | 57,0 % | −1,7 |
| Chartography, ohne Tools | 61,6 % | 64,4 % | 15,6 % | −2,8 |
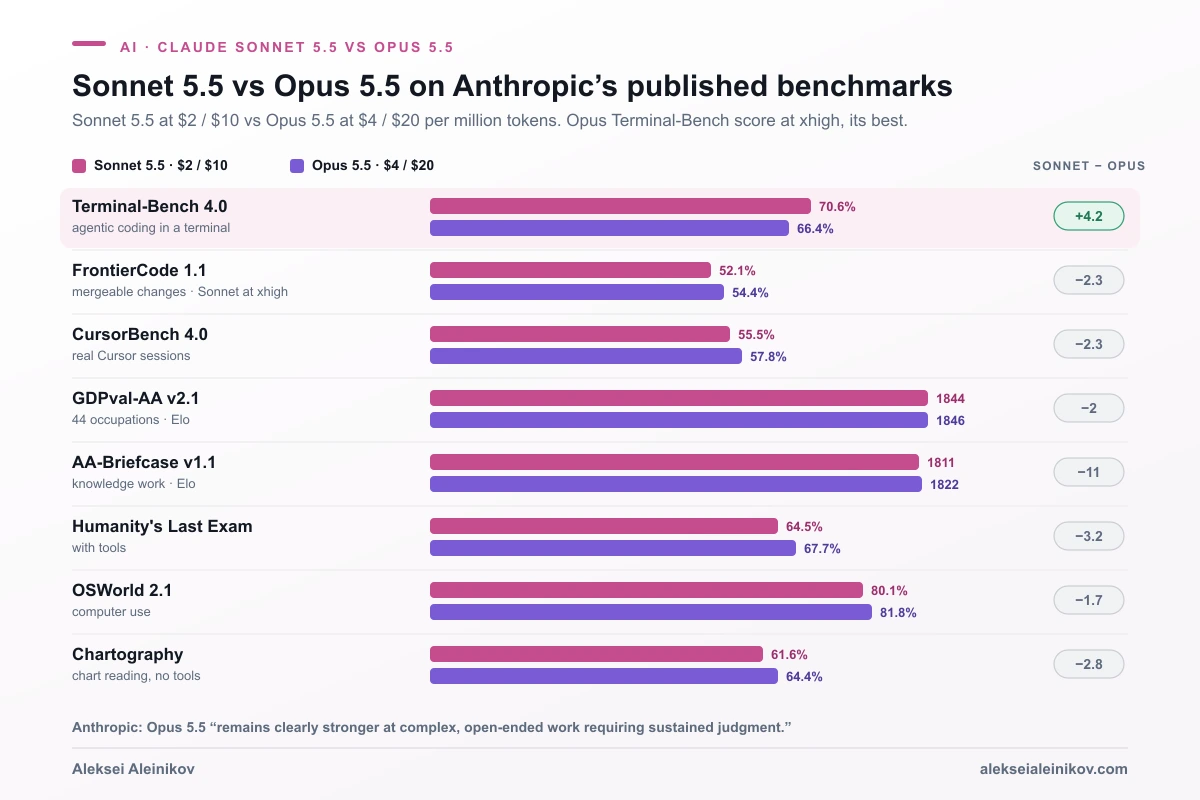
Drei Dinge sollten Sie aus dieser Tabelle mitnehmen, bevor Sie Ihre Routing-Konfiguration umschreiben:
- Der Terminal-Bench-Sieg ist echt, aber eng gefasst. Gemessen wird mehrstufige Arbeit in der Kommandozeile – genau das, was Coding-Agents den ganzen Tag tun. Eine allgemeine Aussage, Sonnet 5.5 sei das stärkere Modell, ist das nicht, und Anthropic macht sie auch nicht: Im Beitrag heißt es, Opus 5.5 bleibe „bei komplexer, offener Arbeit, die anhaltendes Urteilsvermögen erfordert, klar stärker“, und der Sicherheitsabschnitt stellt fest, dass Sonnet 5.5 „die Grenze der Fähigkeiten unserer Modelle nicht verschiebt“.
- Mehr Effort hat einen Wert verschlechtert. Bei FrontierCode erreichte Sonnet 5.5 auf
xhigh52,1 %, aufmaxnur 46,2 %. FrontierCode bestraft Änderungen außerhalb des Aufgabenumfangs; auf max startete Sonnet häufiger den Code-Review-Skill von Claude Code, der sich auf viele Subagents verteilt, und in den von Cognition untersuchten Fällen führte das zu einem Timeout oder zu zusätzlichen Änderungen. Max-Effort ist kein kostenloses Upgrade. - Der Sprung gegenüber Sonnet 5 ist die größere Geschichte. GDPval-AA stieg um rund 400 Elo-Punkte, OSWorld um 23 Punkte. Wer noch auf Sonnet 5 ist, wechselt ohnehin; die einzige Frage ist, wo Opus seinen Preis noch verdient.
Zwei Einschränkungen zur Herkunft: Das alles sind Herstellerangaben, und Artificial Analysis hat GDPval-AA und AA-Briefcase auf einem Pre-Release-Deployment mit einem Structured-Outputs-Bug gemessen, der Sonnets Werte laut Anthropic leicht unterschätzt haben könnte. Verstehen Sie die Tabelle als Landkarte, wo Sie Ihre eigenen Evals laufen lassen sollten – nicht als Ersatz dafür.
Der Preisabstand ist nicht 2×
Laut Listenpreis kostet Opus 5.5 genau doppelt so viel. Was ein Agent pro Turn tatsächlich zahlt, hängt von seinem Token-Mix ab – und in einem langen Agent-Loop dominieren Cache Reads, die, wie die Tabelle oben zeigt, bei beiden Modellen gleich viel kosten.
Nehmen Sie einen typischen Coding-Agent-Turn mitten in einer Session: 60.000 Tokens gecachter Kontext werden neu gelesen, 3.000 neue Tokens in den Cache geschrieben (das letzte Tool-Ergebnis und die nächste Anweisung), und 1.500 Output-Tokens inklusive Thinking. Thinking wird bei beiden Modellen als Output berechnet.
| Pro Turn | Sonnet 5.5 | Opus 5.5 | Sonnet 5.5, doppelter Output |
|---|---|---|---|
| 60K Cache Reads × 0,20 $/M | 0,0120 $ | 0,0120 $ | 0,0120 $ |
| 3K Cache Writes (5 Min.) | 0,0075 $ | 0,0150 $ | 0,0075 $ |
| Output inkl. Thinking | 0,0150 $ (1,5K) | 0,0300 $ (1,5K) | 0,0300 $ (3K) |
| Summe pro Turn | 0,0345 $ | 0,0570 $ | 0,0495 $ |
| Opus-Aufpreis | 1,65× | — | 1,15× |
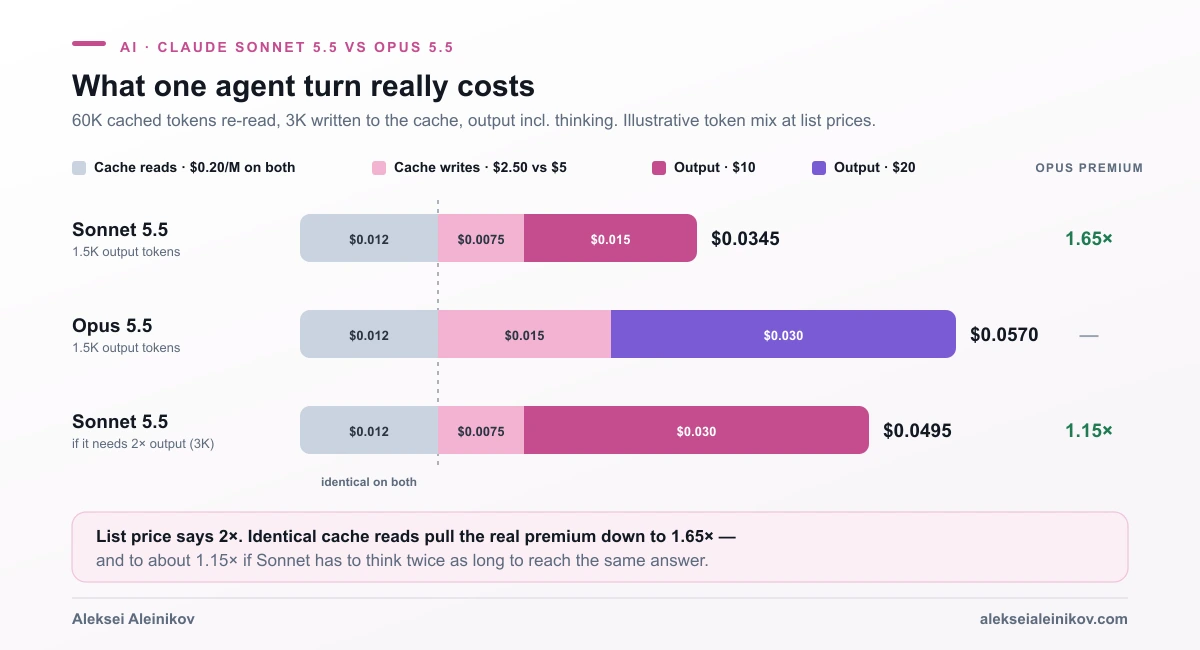
Die Zahlen sind illustrativ – Ihr Token-Mix wird anders aussehen –, aber die Form gilt für jeden cachelastigen Agent. Der Aufpreis schrumpft von 2× auf etwa 1,65×, und wenn Sonnet länger nachdenken muss, um zur selben Antwort zu kommen, schrumpft er weiter.
Genau das zeigen auch Anthropics eigene Diagramme zu den Kosten pro Aufgabe. Auf niedrigem oder mittlerem Effort übertrifft Sonnet 5.5 bei mehreren Benchmarks den besten Wert von Sonnet 5 für etwa ein Zehntel der Kosten pro Aufgabe, und bei FrontierCode liegt es auf high zehn Punkte über Sonnet 5 auf derselben Stufe, für etwa ein Fünfzehntel der Kosten pro Aufgabe. Zum oberen Ende ist der Launch-Beitrag aber offen: Sonnet 5.5 „ergänzt Opus 5.5 am besten auf niedrigeren Effort-Stufen, wo es pro Aufgabe weniger kostet. Auf höheren Stufen kann es vergleichbare Leistung zu ähnlichen Kosten erbringen.“
Mit anderen Worten: Die Ersparnis liegt bei low und medium. Wer Sonnet 5.5 auf max laufen lässt, um die letzten Punkte herauszuholen, zahlt ungefähr Opus-Preise ohne Opus-Urteilsvermögen.
Die Routing-Falle: Sie können das Thinking des anderen nicht lesen
Hier kommt der Teil, den die Benchmark-Threads übersehen. Seit Claude Fable 5.1 verschärft Anthropic, wie Thinking-Blöcke über Turns hinweg erhalten bleiben – vor allem, um Distillation zu verhindern. Für Sonnet 5.5 legt die Dokumentation fest, welches Modell wessen Reasoning lesen kann:
- Sonnet 5.5 liest Thinking-Blöcke von Sonnet 5, Opus 4.8, Haiku 4.5 und älteren Modellen – aber nicht von Opus 5, Opus 5.5 oder einem Fable- oder Mythos-Modell.
- Kein anderes Modell liest Thinking-Blöcke von Sonnet 5.5.
Wechselt eine Konversation zu einem Modell, das einen Block nicht lesen kann, verwirft die API diesen Block, bevor der Prompt das Modell erreicht. Die Anfrage gelingt trotzdem mit 200, und die verworfenen Blöcke werden nicht berechnet. Ohne einen optionalen Beta-Header geschieht das lautlos.
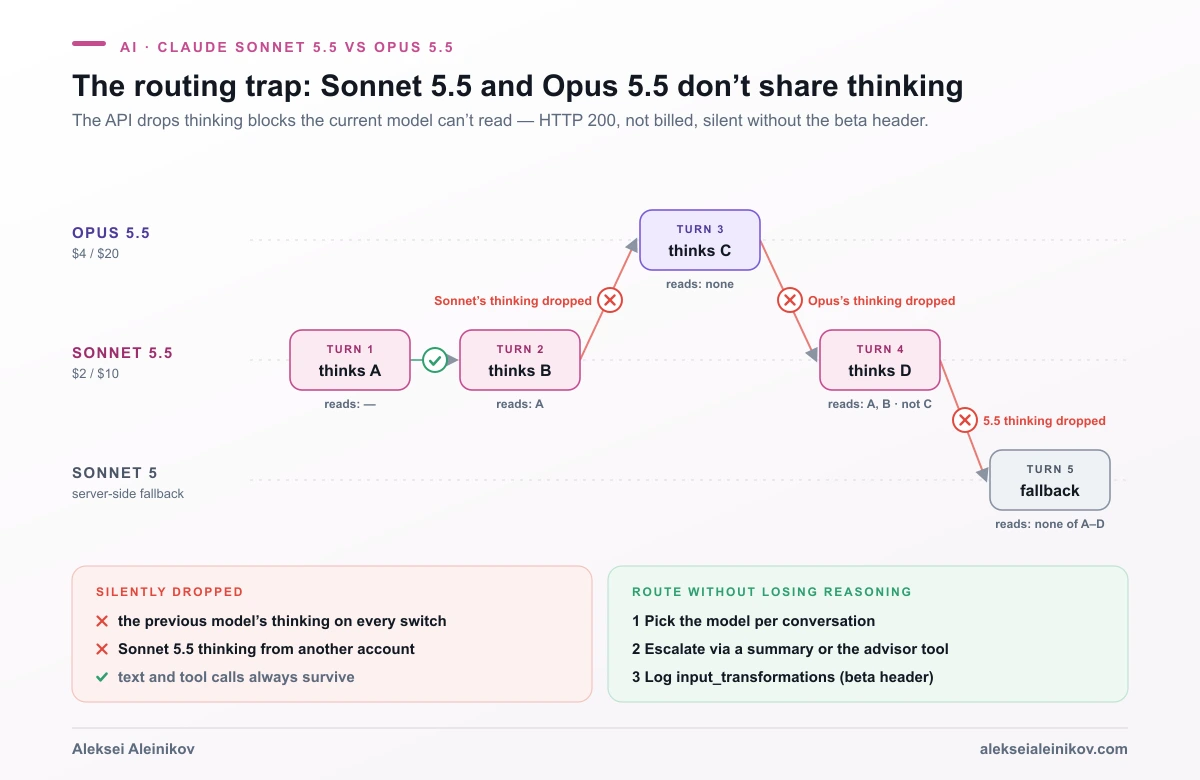
Spielen Sie jetzt den Router durch, den gerade alle bauen:
- Sonnet 5.5 arbeitet die ersten Turns ab und baut Reasoning über Ihre Codebasis auf.
- Der Router hält den nächsten Schritt für schwer und schickt ihn an Opus 5.5. Opus startet ohne Sonnets Reasoning. Es sieht weiterhin Text und Tool-Aufrufe, nur nicht das Denken dahinter.
- Der Router geht für die einfache Folgefrage zurück zu Sonnet 5.5. Sonnet sieht nicht, was Opus gedacht hat.
- Eine Cyber-bezogene Anfrage löst den serverseitigen Fallback auf Sonnet 5 aus. Auch Sonnet 5 kann das Reasoning von Sonnet 5.5 nicht lesen.
Dasselbe gilt für jedes Setup, das auf Opus plant und auf Sonnet ausführt, sobald der Sonnet-Slot auf 5.5 zeigt: Der Ausführende bekommt den Plan, aber nicht das Reasoning, das ihn hervorgebracht hat. Verworfene Blöcke kosten direkt nichts, aber für den eng verwandten Fall der Präfix-Prüfung warnt die Dokumentation, dass Claude manchmal mehr nachdenkt, um verlorenes Reasoning zu rekonstruieren – der Token-Verbrauch einer Session kann also trotzdem steigen.
Zwei weitere Bindungen kommen zur Modellprüfung hinzu:
- Thinking ist an das Konto gebunden. Die Thinking-Blöcke von Sonnet 5.5 funktionieren nur in dem Konto, das sie erzeugt hat, oder in einem verknüpften. Eine Session, die unter dem API-Key eines anderen Nutzers fortgesetzt wird, gemeinsame Session-Speicher über Organisationen hinweg oder ein Kontowechsel mitten in einer Claude-Code-Session laufen alle in ein lautloses Verwerfen mit dem Grund
organization_binding_mismatch. - Thinking ist an den Präfix der Konversation gebunden. Ein Thinking-Block bleibt nur gültig, solange der
system-Prompt, dietools-Liste und alle früheren Nachrichten unverändert sind. Für Konten, die am oder nach dem 31. August 2026, 00:00 UTC, angelegt wurden, erzwingt die API das bei Sonnet 5.5, Opus 5.5 und Fable 5.1 standardmäßig und liefert bei einem bearbeiteten Verlauf einen 400. Ältere Konten erzwingen es nur auf Anfrage – Code, der mit Ihrem alten Key funktioniert, kann also bei einem Kunden mit neuem Konto scheitern.
So routen Sie, ohne den Faden zu verlieren
- Routen Sie pro Konversation, nicht pro Turn. Entscheiden Sie zu Beginn, ob eine Aufgabe Sonnet- oder Opus-Arbeit ist.
- Eskalieren Sie mit einem Neustart. Wenn Sonnet hängen bleibt, fassen Sie den Stand zusammen und eröffnen eine neue Konversation auf Opus. Die Dokumentation nennt das Simple Compaction und empfiehlt es; nichts Früheres wird erneut gesendet, also wird auch nichts verworfen.
- Oder lassen Sie Sonnet führen und Opus beraten. Mit dem Advisor-Tool kann ein Sonnet-5.5-Executor einen Opus-5.5-Advisor konsultieren, ohne das Modell der Konversation zu wechseln. Beachten Sie, dass der Rat verschlüsselt als
advisor_redacted_result-Block zurückkommt und in der Antwort nicht lesbar ist. - Machen Sie Verwerfungen sichtbar. Senden Sie den Beta-Header
thinking-binding-controls-2026-08-01und loggen Sieinput_transformationsbei jeder Antwort:
response = client.beta.messages.create(    model="claude-sonnet-5-5",    max_tokens=16000,    thinking={        "type": "adaptive",        "block_binding": {"prefix_mismatch_behavior": "drop_block"},    },    messages=messages,  # nur anhängen: frühere Turns nie bearbeiten    betas=["thinking-binding-controls-2026-08-01"],)
for t in response.input_transformations or []:    # reason: model_binding_mismatch | organization_binding_mismatch | prefix_binding_mismatch    log.warning("thinking dropped at %s: %s", t.path, t.reason)
Bei Sonnet 5.5 funktioniert block_binding nur mit adaptivem Thinking; zusammen mit between_tools gibt es einen 400-Fehler.
Fünf Breaking Changes beim Upgrade von Sonnet 5
Sonnet 5.5 kostet dasselbe wie Sonnet 5 und hat eine Modell-ID ohne Datumssuffix – die Versuchung ist groß, einfach den String zu tauschen und auszuliefern. Der Migrationsleitfaden nennt fünf Dinge, die brechen:
| Was Sie heute senden | Bei Sonnet 5.5 | Lösung |
|---|---|---|
thinking: {"type": "disabled"} |
400-Fehler | {"type": "between_tools"} – nur bei low, medium oder high |
tool_choice vom Typ any oder tool |
400-Fehler | auto plus strict: true am Tool, und im Prompt sagen, wann es aufzurufen ist |
computer_20251124 auf der Claude API oder Google Cloud |
400-Fehler | computer_toolset_20260801 |
| Advisor-Tool mit Sonnet 5, Opus 4.8 und einigen älteren Advisors | 400-Fehler | Mit Opus 5, Opus 5.5, Sonnet 5.5, Fable oder Mythos kombinieren |
Frühere Nachrichten, system oder tools mitten in der Session ändern |
400 bei Konten ab dem 31.08.2026 | Verlauf nur anhängen; System-Nachrichten mitten im Gespräch nutzen |
Dazu drei Änderungen, die keine Anfrage scheitern lassen, Sie aber überraschen werden:
- Text zwischen Tool-Aufrufen wandert in Thinking-Blöcke. Notizen, die länger als ein, zwei Sätze sind und die das Modell zwischen Tool-Aufrufen schreibt, kommen jetzt als Fortschritts-
thinking-Blöcke zurück, die bei der Standardanzeige leer sind. Eine Oberfläche, die diese Notizen an Nutzer streamt, verstummt, bis Siedisplayauf"updates"(Beta) oder"summarized"setzen oderbetween_toolsverwenden. - Die Effort-Stufen sind neu kalibriert. Eine Stufe erzeugt nicht mehr dieselbe Menge Thinking wie bei Sonnet 5. Anthropic empfiehlt
mediumals Start für klar umrissenes agentisches Coding undhighfür schwierigere Aufgaben – wiederholen Sie Ihren Effort-Sweep und messen Sie die Kosten neu. - Prompt Caching lohnt sich früher. Der minimale cachebare Prompt sinkt von 1.024 auf 512 Tokens.
Auf Amazon Bedrock gibt es eine zusätzliche Falle: Strict Tool Use ist dort für Sonnet 5.5 nicht verfügbar. Aus dem Ersatz auto plus strict für erzwungene Tool-Nutzung wird dort auto plus Ihre eigene Eingabevalidierung. Auf Google Cloud und der Claude API funktioniert strict.
Wer von Sonnet 4.6 oder älter kommt, hat zusätzlich die älteren Breaking Changes: Nicht-Standardwerte für temperature, top_p oder top_k liefern einen 400, budget_tokens ist zugunsten von Effort entfallen, derselbe Text ergibt rund 30 % mehr Tokens, und ein Bild mit 2000×1500 Pixeln kostet etwa 2,5-mal so viele Tokens. Ab Sonnet 4.5 oder älter liefern zusätzlich vorausgefüllte Assistant-Turns einen 400.
Am schnellsten kommen Sie in einer echten Codebasis mit dem mitgelieferten Claude-API-Skill in Claude Code durch all das:
/claude-api migrate this project to claude-sonnet-5-5Eine minimale Anfrage, die mit Sonnet 5.5 so funktioniert:
response = client.messages.create(    model="claude-sonnet-5-5",    max_tokens=16000,    thinking={"type": "between_tools"},      # ersetzt {"type": "disabled"}    output_config={"effort": "medium"},      # explizit setzen; API-Standard ist high    tools=[{**weather_tool, "strict": True}],    tool_choice={"type": "auto"},            # "any" und "tool" liefern jetzt 400    messages=messages,)
for block in response.content:               # nie blind content[0].text lesen    if block.type == "text":        print(block.text)
Für Security-Teams: der Cyber-Fallback
Laut Anthropic sind die Cyber-Fähigkeiten von Sonnet 5.5 ein großer Schritt gegenüber Sonnet 5, deshalb wird es mit Echtzeit-Schutzmaßnahmen ähnlich denen von Opus 5.5 ausgeliefert – als erstes Sonnet-Modell. In der Praxis liefert eine Ablehnung stop_reason: "refusal", und stop_details kann eine von fünf Kategorien nennen: cyber, bio, frontier_llm, reasoning_extraction oder general_harms.
Zwei Details sind für Engineering-Teams wichtig:
- Riskantere Cyber-Arbeit fällt auf Sonnet 5 zurück. Mit aktiviertem serverseitigem Fallback (
fallbacks: "default", Beta, nur Claude API) werden Ablehnungen der Kategoriencyberundfrontier_llmauf Sonnet 5 wiederholt. Routinemäßiges Finden und Beheben von Bugs ist nicht betroffen. Verteidiger, die mehr brauchen, können sich für das Cyber Verification Program bewerben; einen erweiterten, gestuften Zugang für Sonnet 5.5 kündigt Anthropic für bald an. Und denken Sie an die Routing-Falle: Dieser Fallback läuft ohne das Reasoning von Sonnet 5.5. - Nach der Chain of Thought zu fragen ist jetzt eine Ablehnung. Sonnet 5.5 ist das erste Sonnet-Modell mit Klassifikatoren gegen Reasoning-Extraktion. Ein Prompt, der das Modell auffordert, sein internes Reasoning im Antworttext wiederzugeben, bekommt eine Ablehnung der Kategorie
reasoning_extraction. Tools, die „das Denken des Modells zeigen“, indem sie danach fragen, müssen aufdisplay: "summarized"umstellen.
Es gibt auch eine gute Nachricht für alle, die Agents in Containern betreiben. In Anthropics Containment-Evaluationen kam Sonnet 5.5 nah an Opus 5.5 heran, was die Seltenheit von Ausbruchsversuchen aus der Sandbox angeht, und war von allen Anthropic-Modellen am wenigsten geneigt, die Grenzen seiner Container auszutesten. Das ist eine nützliche Eigenschaft, keine Garantie – jüngste Vorfälle mit autonomen Agents zeigen, warum die Grenze in Ihre Infrastruktur gehört und nicht ins Modell.
Welches Modell sollten Sie nutzen?
- Sonnet 5.5 auf
medium– Ihr neuer Standard für agentisches Coding bei klar umrissenen Aufgaben, Bugfixes, Terminal-Arbeit, CI-Jobs, Computer Use sowie Dokumente und Folien. Hier ist der Benchmark-Abstand am kleinsten und der Kostenabstand am größten. - Sonnet 5.5 auf
lowoder mitbetween_tools– Chat und latenzkritische Arbeit. Für Klassifikation und Extraktion in großem Volumen sind ein kleines Entscheidungsmodell oder das angekündigte Haiku 5.5 noch günstiger. - Opus 5.5 – mehrdeutige, langlaufende oder offene Arbeit, Architekturentscheidungen, große Refactorings und alles, wo eine falsche Antwort mehr kostet als die Tokens. Sein Standard-Effort
mediumist bereits ein vernünftiger Ausgangspunkt. - Sonnet 5.5 auf
xhighodermax– nur, wenn Ihre eigenen Evals es belegen. Die Kosten nähern sich Opus an, und FrontierCode zeigt, dass Max-Effort schlechter abschneiden kann als xhigh. - Beide – pro Konversation routen, über eine Zusammenfassung oder das Advisor-Tool eskalieren und
input_transformationsloggen, damit Sie jeden verworfenen Block sehen.
Wenn Sie diese Modelle über einen Coding-Agent statt direkt über die API nutzen, taucht dieselbe Wahl in /model und /effort auf. Die Agent-Seite dieser Abwägung beschreibe ich in wie KI-Coding-Agents wie Claude Code, Codex und opencode wirklich funktionieren, und was der Agent tun darf, sobald er ein Modell gewählt hat, in den Berechtigungsmodi von Claude Code im Vergleich.
Fazit
Sonnet 5.5 ist das seltene Release, bei dem das günstigere Modell die Standardantwort ist. Es liegt bei den meisten von Anthropic gemessenen Aufgaben nur ein, zwei Punkte hinter Opus 5.5, schlägt es bei terminalbasierter Agent-Arbeit und kostet den halben Listenpreis – mit einem realen Abstand pro Turn eher bei 1,65×, sobald man Cache Reads mitrechnet.
Die günstigste Architektur ist aber nicht „Sonnet für leichte Turns, Opus für schwere Turns“. Diese beiden Modelle teilen ihr Reasoning nicht, die API sagt Ihnen nicht, wann sie es verwirft, und bei neuen Konten ist ein bearbeiteter Verlauf ein harter Fehler. Wählen Sie das Modell pro Konversation, halten Sie diese Konversation append-only und lassen Sie Opus über einen Neustart oder das Advisor-Tool hinein – nicht mitten in einen Gedanken.
Aus der Community
Diskussion im Fediverse
Antworten von Mastodon und Bluesky — direkt aus dem offenen Netz, ohne Tracking.
Antworten werden geladen …
Noch keine Antworten. Starte die Diskussion:
Antworten konnten gerade nicht geladen werden.