Zwei Launches im Abstand einer Woche haben einen Vergleich zum Suchtrend gemacht. Anthropic hat Claude Opus 5.5 am 22. September 2026 veröffentlicht und empfiehlt es als Startmodell für die meisten Workloads. Am 29. September folgte OpenAI mit GPT-6.1 Sol zu 2 $/10 $ pro Million Tokens – exakt die Hälfte von Opus 5.5 mit 4 $/20 $. Die Frage, die jetzt in die Suche getippt wird, ist kurz: Sol 6.1 oder Opus 5.5?
Die ehrliche Antwort beginnt mit einer Korrektur. Die beiden Modelle spielen nicht in derselben Klasse, der Name „Sol“ bedeutet nicht mehr dasselbe wie im Juli, und einen Benchmark, der beide auf demselben Harness laufen lässt, habe ich nicht gefunden. Präzise vergleichen lässt sich, was jedes Modell pro Agent-Turn kostet – und dieser Vergleich hat bei 272.000 Tokens eine Kante, die die Antwort verändert.
GPT-6.1 Sol vs. Claude Opus 5.5 auf einen Blick
Die Angaben stammen von der Modellseite zu GPT-6.1 Sol, der Claude-Modellübersicht und den Preisseiten beider Anbieter.
| GPT-6.1 Sol | Claude Opus 5.5 | |
|---|---|---|
| API-Modell-ID | gpt-6.1-sol |
claude-opus-5-5 |
| Veröffentlicht | 29. September 2026 | 22. September 2026 |
| Einordnung durch den Anbieter | „Leistung nahe an Astra für komplexe Arbeit zu geringeren Kosten“ | „Für langlaufendes agentisches Coding und Wissensarbeit“ |
| Input / Output pro Million Tokens | 2 $ / 10 $ | 4 $ / 20 $ |
| Cache Read pro Million Tokens | 0,10 $ (5 % des Inputs) | 0,20 $ (5 % des Inputs) |
| Cache Write pro Million Tokens | 2,50 $, mindestens 30 Minuten gültig | 5 $ für 5 Minuten · 8 $ für 1 Stunde |
| Prompts über 272K Input-Tokens | 2× Input und Cache, 1,5× Output für die gesamte Anfrage | Standardpreise bis 1M |
| Kontextfenster / max. Output | 1,05M (max. 922K Input) / 128K | 1M / 128K |
| Reasoning-Stufen | low · medium (Standard) · high · xhigh · max |
Dieselben fünf Stufen, Standard medium |
| Lässt sich Reasoning abschalten? | Nein – none und minimal werden abgelehnt |
Nein – Thinking ist immer aktiv |
| Minimaler cachebarer Prompt | 1.024 Tokens | 512 Tokens |
| Wissensstand | 30. April 2026 | Juni 2026 |
| Tool Calling | Responses API (Chat Completions ohne Tools) | Messages API; kein erzwungenes tool_choice |
| Batch-Rabatt | 50 % (auch Flex) | 50 % |
| EU-Datenresidenz über die eigene API des Anbieters | Ja (+10 % Regionalaufschlag) | Nein – die Claude API bietet us oder global |
Drei Zeilen verdienen einen zweiten Blick:
- Beide Anbieter berechnen Cache Reads mit 5 % des Inputs. Das klingt nach Gleichstand, doch 5 % von 2 $ sind die Hälfte von 5 % von 4 $. Beim Vergleich von Sonnet 5.5 und Opus 5.5 ließen identische Cache-Read-Preise den echten Abstand deutlich unter die 2× des Listenpreises schrumpfen. Hier passiert das Gegenteil: Das günstigere Modell ist auch bei dem Posten günstiger, der Agent-Rechnungen dominiert.
- Der Standard-Effort ist jetzt gleich. Beide APIs starten bei
medium. Die Namen der fünf Stufen sind identisch, aber es sind getrennte Skalen getrennter Anbieter –highbei Sol ist nichthighbei Opus. Setzen Sie Effort in jeder Vergleichsanfrage explizit. - Die 272K-Zeile entscheidet bei langem Kontext. Sie bekommt unten einen eigenen Abschnitt.
Welches Sol? Der Name hat in drei Monaten die Klasse gewechselt
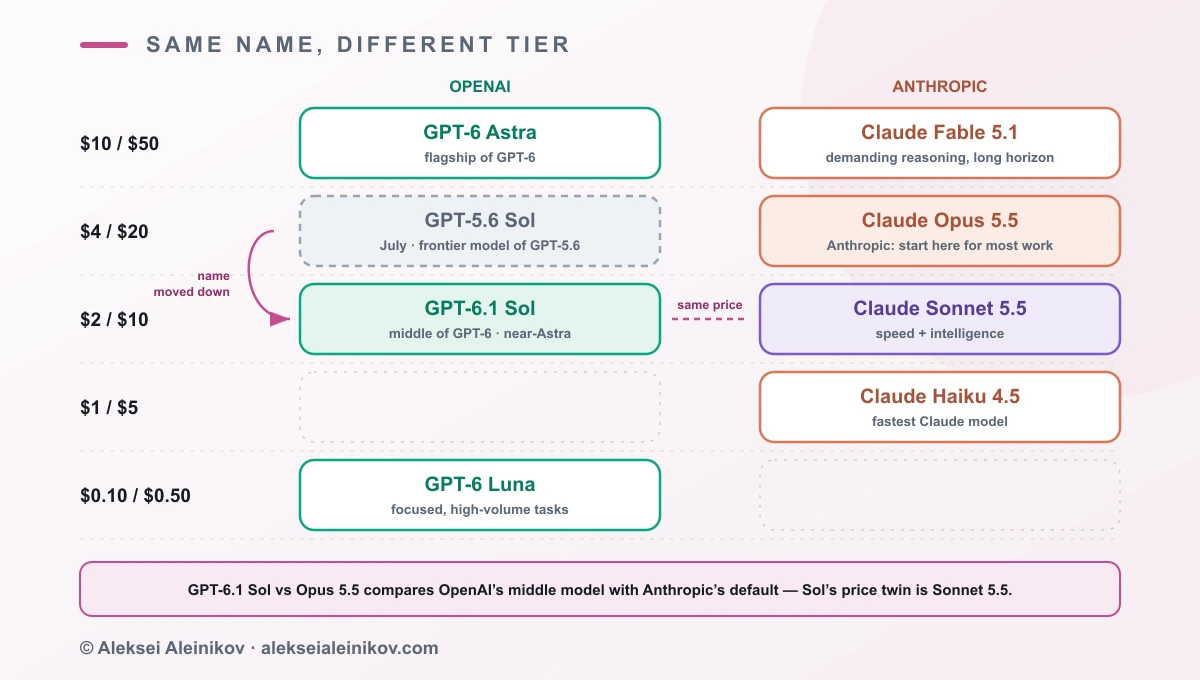
Wer nach „Sol vs. Opus“ sucht, findet drei verschiedene Modelle namens Sol – und sie stehen nicht an derselben Stelle:
| Modell | Veröffentlicht | Rolle in der Familie | Preis pro Million Tokens |
|---|---|---|---|
| GPT-5.6 Sol | 9. Juli 2026 | Frontier-Modell von GPT-5.6 (über Terra und Luna) | 4 $ / 20 $ seit dem Aktionspreis vom 21. August |
| GPT-6 Sol | 22. September 2026 | Mitte von GPT-6 (unter Astra) | 2 $ / 10 $, Cache Read 0,20 $ |
| GPT-6.1 Sol | 29. September 2026 | Mitte von GPT-6, „nahe an Astra“ | 2 $ / 10 $, Cache Read 0,10 $ |
Zwei praktische Folgen:
- Mit „Sol“ beschriftete Benchmarks können das alte Flaggschiff meinen. Anthropics Launch-Beitrag zu Opus 5.5 vergleicht mit GPT-5.6 Sol – dem Frontier-Modell aus dem Juli – und nicht mit GPT-6.1 Sol. Diese Zahlen als „Opus schlägt das neue Sol“ zu lesen, ist in beide Richtungen falsch.
- GPT-6 Sol und GPT-6.1 Sol sind verschiedene API-Modelle. GPT-6.1 Sol halbiert den Preis für gecachten Input, streicht die Reasoning-Stufe
noneund verlangt für Tool Calling die Responses API. GPT-6 Sol unterstütztnoneweiterhin und erlaubt Function Calling in Chat Completions, wenn Effort aufnonesteht. Pinnen Sie die exakte ID.
GPT-6.1 Sol vs. Opus 5.5 ist kein Duell der Flaggschiffe. Es ist OpenAIs Mittelklasse-Modell gegen das Modell, mit dem Anthropic den meisten den Einstieg empfiehlt – und preislich gehört Sol neben Sonnet 5.5.
GPT-6.1 Sol Benchmarks: Was es gibt und was nicht
Einen veröffentlichten Vergleich von GPT-6.1 Sol und Claude Opus 5.5 auf demselben Harness – weder vom Anbieter noch von einem unabhängigen Labor – habe ich nicht gefunden. Was es gibt, ist Anthropics Tabelle zu Opus 5.5 mit OpenAIs Flaggschiff GPT-6 Astra und dem älteren GPT-5.6 Sol:
| Benchmark | Opus 5.5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|
| Terminal-Bench 4.0 (agentisches Coding im Terminal) | 66,4 % | 57,9 % | 37,3 % |
| FrontierCode v1.1 Main | 54,4 % | 53,3 % | 47,5 % |
| CursorBench 4.0 | 57,8 % | – | 41,7 % |
| GDPval-AA v2.1 (Wissensarbeit, Elo) | 1846 | 1542 | 1588 |
| AutomationBench (Geschäftsabläufe) | 40,0 % | 41,4 % | 28,8 % |
| Humanity’s Last Exam, mit Tools | 67,7 % | 57,2 % | – |
| Terminal-Bench-Science 0.1 | 58,7 % | 64,6 % | 22,4 % |
Lesen Sie die Tabelle mit ihren Fußnoten. Opus 5.5 lief auf Max-Effort, außer bei Terminal-Bench: Dort meldet Anthropic den xhigh-Wert von Opus und den von OpenAI gemeldeten high-Wert von Astra, jeweils den Bestwert. Opus lief mit aktiven Produktions-Safeguards, die einige Cybersecurity- und Biologie-Aufgaben an ältere Modelle weiterreichen – laut Anthropic drückt das vermutlich die Werte. AutomationBench hat Zapier ohne Fallback-Modelle gemessen, Safeguard-Eingriffe zählten also als Fehlschlag. Und jede Zahl hier stammt vom Anbieter.
Anthropic nennt außerdem Kosten pro Aufgabe im Vergleich zu Astra: Auf dem Standard-Effort medium schlägt Opus 5.5 bei GDPval-AA GPT-6 Astra auf Max-Effort für etwa ein Fünftel der Kosten pro Aufgabe und erreicht bei Terminal-Bench 4.0 Astras Niveau für etwa 40 % der Kosten.
Was das über Sol aussagt, ist eine Schlussfolgerung, keine Messung. OpenAIs eigener Modell-Leitfaden ordnet GPT-6.1 Sol unterhalb von Astra ein und empfiehlt, beide zu vergleichen, um den Kompromiss zwischen Qualität und Kosten abzuwägen. Bei den Zeilen, in denen Opus 5.5 deutlich vor Astra liegt – Terminal-Bench um 8,5 Punkte, GDPval-AA um rund 300 Elo, Humanity’s Last Exam um 10,5 Punkte –, dürfte ein unterhalb von Astra positioniertes Modell den Abstand kaum schließen. In den zwei Zeilen, in denen Astra führt, könnte auch Sol führen. Nehmen Sie die Tabelle als Karte, wo Sie eigene Evals fahren sollten, nicht als die Evals selbst.
GPT-6.1 Sol vs. Opus 5.5 Preise: volle 2× bis 272K Tokens
Laut Listenpreis kostet Opus 5.5 doppelt so viel. Anders als beim Vergleich Sonnet gegen Opus hält das pro Agent-Turn, weil auch der Cache Read – der Posten, der lange Agent-Loops dominiert – genau die Hälfte kostet.
Nehmen wir denselben Coding-Agent-Turn mitten in einer Session wie beim Sonnet-Vergleich: 60.000 Tokens gecachter Kontext werden erneut gelesen, 3.000 neue Tokens in den Cache geschrieben und 1.500 Output-Tokens inklusive Reasoning erzeugt. Reasoning wird bei beiden Modellen als Output abgerechnet.
| Turn mit 60K Tokens Kontext | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| 60K Cache Reads | 0,0060 $ | 0,0120 $ |
| 3K Cache Writes | 0,0075 $ | 0,0150 $ |
| 1,5K Output inkl. Reasoning | 0,0150 $ | 0,0300 $ |
| Summe pro Turn | 0,0285 $ | 0,0570 $ |
| Aufpreis für Opus | – | 2,0× |
Lassen Sie denselben Agenten nun eine große Codebasis durcharbeiten, bis jeder Turn 400.000 Tokens erneut liest. Bei Sol wird jede Anfrage mit mehr als 272K Input-Tokens mit 2× Input- und Cache-Preisen und 1,5× Output abgerechnet – für die gesamte Anfrage, nicht nur für die Tokens oberhalb der Schwelle. Anthropic rechnet das volle 1M-Token-Fenster von Opus 5.5 zum Standardpreis ab; eine Anfrage mit 900K Tokens kostet pro Token dasselbe wie eine mit 9K.
| Turn mit 400K Tokens Kontext | GPT-6.1 Sol | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|---|
| 400K Cache Reads | 0,0800 $ | 0,0800 $ | 0,0800 $ |
| 3K Cache Writes | 0,0150 $ | 0,0150 $ | 0,0075 $ |
| 1,5K Output inkl. Reasoning | 0,0225 $ | 0,0300 $ | 0,0150 $ |
| Summe pro Turn | 0,1175 $ | 0,1250 $ | 0,1025 $ |
| Relativ zu Sol | – | 1,06× | 0,87× |
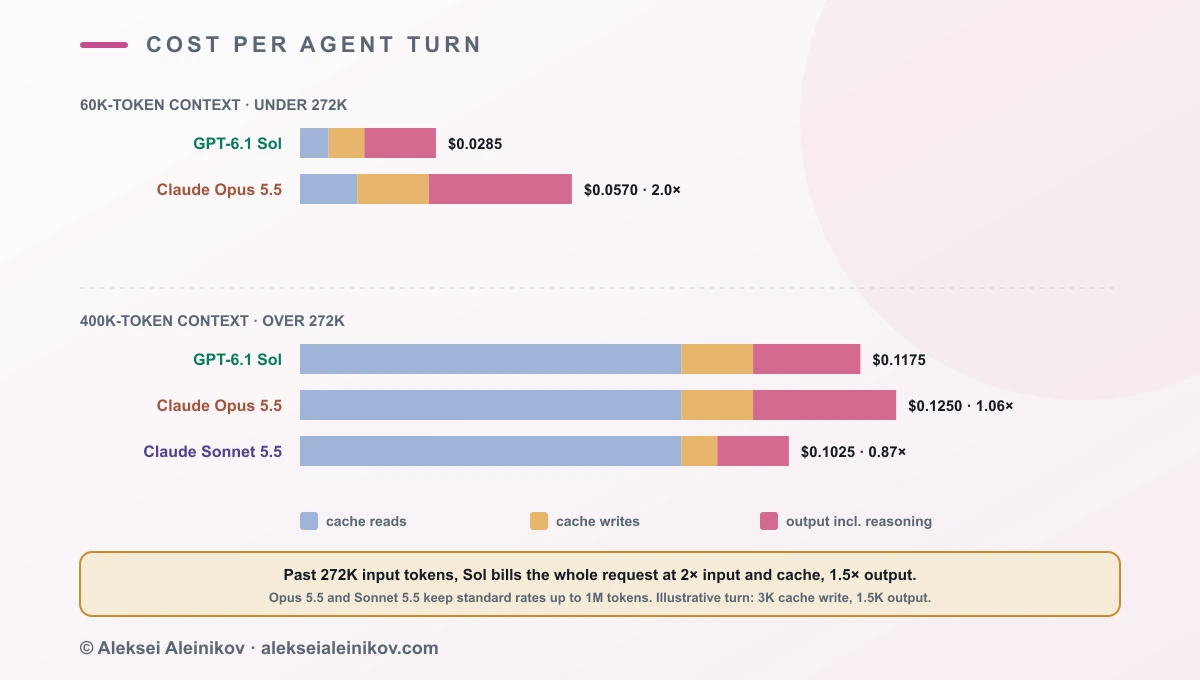
Die Zahlen sind illustrativ und nehmen an, dass sich der Cache-Write-Preis zusammen mit den anderen Cache-Preisen verdoppelt. Zwei Dinge verändern Ihre eigene Rechnung stärker als der genaue Token-Mix:
- Tokenizer unterscheiden sich. Derselbe Prompt ergibt nicht bei beiden Modellen dieselbe Token-Zahl. Anthropic weist darauf hin, dass sein Tokenizer seit Claude Opus 4.7 für denselben Text etwa 30 % mehr Tokens erzeugt als der ältere. Vergleichen Sie Kosten pro Aufgabe aus echten Usage-Logs, nie nur den Preis pro Million Tokens.
- Die Cache-Lebensdauer unterscheidet sich. Ein Cache Write bei Sol bleibt mindestens 30 Minuten nach der letzten Nutzung wiederverwendbar. Ein 5-Minuten-Write bei Opus 5.5 verfällt nach fünf Minuten Leerlauf; damit er überlebt, während ein Mensch einen Diff prüft, zahlen Sie den 1-Stunden-Write mit 8 $ statt 5 $ pro Million. Für Agenten, die auf Menschen warten, ist das ein weiterer Posten, bei dem Sol spart.
Überschreitet Ihr Agent regelmäßig 272K Tokens, verschwindet das Preisargument für Sol weitgehend – und Sonnet 5.5 wird das günstigste der drei Modelle, weil es bei Sols Basispreisen flach abrechnet.
Reasoning: Bei keinem der beiden abschaltbar
Beide Anbieter haben bei diesen Modellen den Schalter für „kein Reasoning“ entfernt, und beide liefern einen Fehler, statt die alte Einstellung stillschweigend zu ignorieren:
- GPT-6.1 Sol akzeptiert
reasoning.effortmitlow,medium(Standard),high,xhighodermax.noneundminimalwerden nicht unterstützt; OpenAIs Migrationsleitfaden empfiehlt stattdessenlow. Tool Calling erfordert die Responses API. - Claude Opus 5.5 nutzt immer adaptives Thinking.
thinking: {"type": "disabled"}oder ein manuellesbudget_tokensliefern einen 400invalid_request_error; gesteuert wird überoutput_config.effort. Laut Anthropic denkt Opus 5.5 bei gleichem Effort pro Turn mehr als Opus 5, vor allem beixhighundmax.
Eine minimale Anfrage für jedes Modell, mit explizit gesetztem Effort, damit ein A/B-Test Gleiches mit Gleichem vergleicht:
from openai import OpenAIimport anthropic
sol = OpenAI().responses.create(    model="gpt-6.1-sol",    reasoning={"effort": "medium"},   # "none" liefert bei diesem Modell einen Fehler    input="Refactor the retry logic in payments/client.py",)
opus = anthropic.Anthropic().messages.create(    model="claude-opus-5-5",    max_tokens=16000,    output_config={"effort": "medium"},   # Thinking selbst lässt sich nicht abschalten    messages=[{"role": "user", "content": "Refactor the retry logic in payments/client.py"}],)
Beide Modelle können den Effort auch mitten in der Konversation ändern, ohne den Cache zu entwerten: Sol über ein configuration_update-Input-Item, Opus 5.5 über Effort pro Nachricht (Beta). Nutzen Sie das für den Fall „bei diesem Schritt gründlicher nachdenken“, statt das Modell zu wechseln.
Ein Wechsel mitten in der Aufgabe kostet doppelt
Verlockend ist ein Router: Sol für Routine-Turns, Opus für die schweren, innerhalb derselben Session. Über Anbietergrenzen hinweg kostet das bei jedem Wechsel an zwei Stellen.
- Das Reasoning wird nicht übertragen. Die Reasoning-Elemente gehören dem jeweiligen Anbieter; das Zielmodell sieht Text und Tool-Aufrufe, aber nichts von dem Reasoning dahinter. Schon innerhalb von Anthropics eigener Modellreihe sind Thinking-Blöcke an das erzeugende Modell gebunden; über Anbieter hinweg gibt es nichts zu binden.
- Der Cache wird nicht übertragen. Prompt-Caches gelten pro Modell und pro Anbieter. Die erste Anfrage beim anderen Modell verarbeitet den gesamten Präfix als Cache Write neu. Bei einer Session mit 200K Tokens sind das rund 0,50 $ bei Sol und 1,00 $ bei Opus 5.5, bevor überhaupt neue Arbeit passiert – und bei Sol oberhalb von 272K das Doppelte.
Routen Sie pro Konversation: Entscheiden Sie zu Beginn, ob eine Aufgabe Sol- oder Opus-Arbeit ist, und eskalieren Sie über eine neue Konversation mit Zusammenfassung, statt Turn für Turn das Modell zu wechseln.
Für Teams in Europa
Wo das Modell läuft, zählt unter DSGVO oder Branchenvorgaben so viel wie der Preis – und hier unterscheiden sich die Anbieter auf eine Weise, die in den Datenblättern nicht hervorsticht.
- GPT-6.1 Sol unterstützt EU-Datenresidenz über OpenAIs eigene API, mit 10 % Aufschlag für regionale Verarbeitung. Fast Mode ist mit EU-Datenresidenz nicht verfügbar.
- Claude Opus 5.5 auf der Claude API bietet nur
usoderglobalals Inferenz-Region und nurusals Workspace-Geo. Für Verarbeitung in Europa nutzen Sie Claude auf Google Cloud (regionale und Multi-Region-Endpunkte) oder regionale Endpunkte bei Amazon Bedrock, jeweils mit 10 % Aufschlag gegenüber globalen Endpunkten – und prüfen Sie, ob Opus 5.5 in der benötigten Region angeboten wird. Fast Mode für Opus 5.5 gibt es nur auf der Claude API. - Opus 5.5 bringt Anthropics Wasserzeichen-Maßnahmen für den EU AI Act mit und ist wie frühere Opus-Modelle mit Zero Data Retention verfügbar.
Wenn Sie bereits auf Google Cloud arbeiten, hält Opus 5.5 über Vertex AI Abrechnung, IAM und Datenstandort in der Plattform, die Sie ohnehin steuern. Brauchen Sie EU-Datenresidenz direkt beim Anbieter ohne Cloud-Zwischenschicht, ist Sol der einfachere Weg.
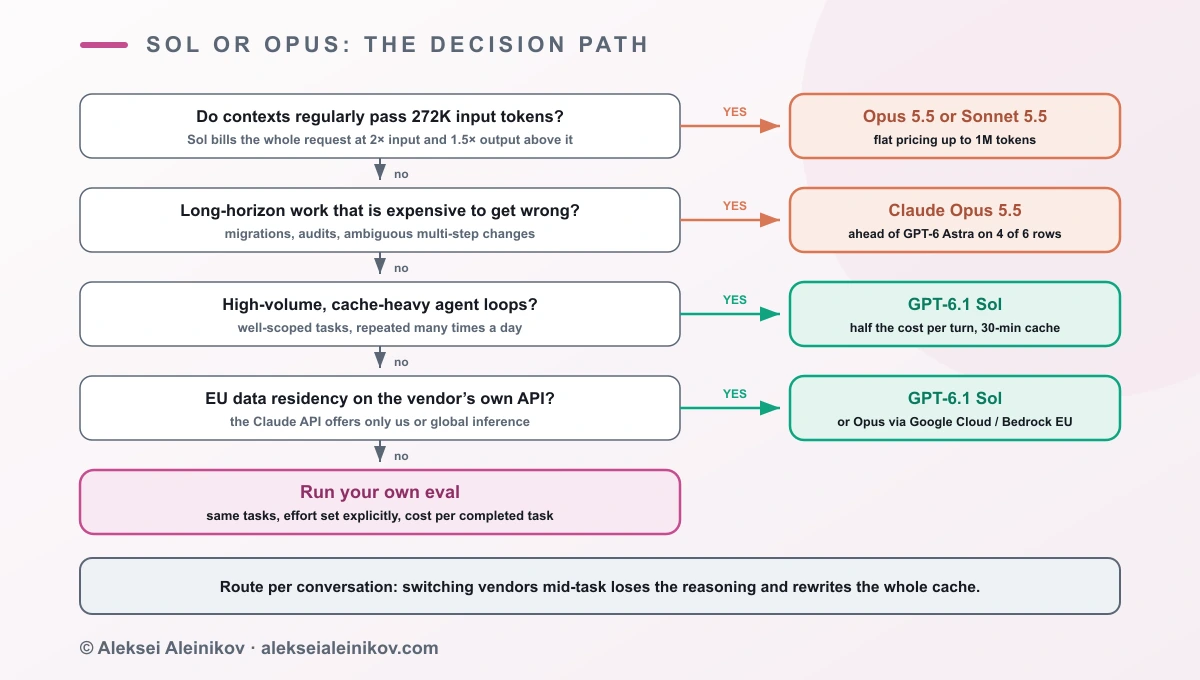
Welches Modell sollten Sie wählen?
Wählen Sie GPT-6.1 Sol, wenn:
- Ihre Agent-Loops in großem Volumen laufen, cachelastig sind und unter 272K Input-Tokens bleiben – dort liegt die volle 2×-Ersparnis;
- Sie EU-Datenresidenz über die eigene API des Anbieters brauchen;
- Sessions oft genug auf Menschen warten, dass ein 30-Minuten-Cache wiederholte Writes spart;
- Ihr Team bereits mit Codex oder den gehosteten Tools der Responses API arbeitet.
Wählen Sie Claude Opus 5.5, wenn:
- die Arbeit langlaufend ist und Fehler teuer sind – Migrationen, Audits, mehrdeutige Refactorings –, wo Anthropics veröffentlichte Zahlen Opus vor OpenAIs Flaggschiff zeigen;
- Kontexte regelmäßig über 272K Tokens gehen, wo Sols Rabatt weitgehend verpufft;
- Ihr Team mit Claude Code arbeitet oder Claude bereits auf Google Cloud oder Bedrock betreibt.
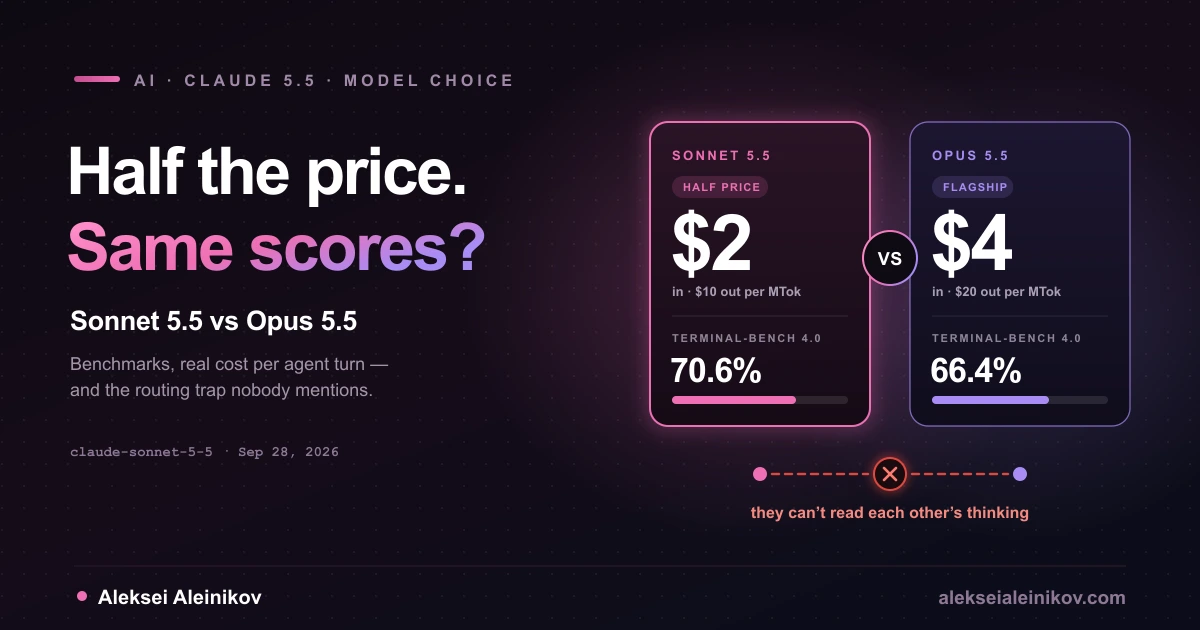
Prüfen Sie eine dritte Option, bevor Sie sich festlegen: Gefällt Ihnen an Sol der Preis, kostet Claude Sonnet 5.5 pro Token dasselbe, rechnet langen Kontext flach ab und hat Opus 5.5 bei Terminal-Bench 4.0 geschlagen. Gefällt Ihnen an Opus die Obergrenze, ist GPT-6 Astra OpenAIs Gegenstück zu 10 $/50 $. Und wenn Sie eigentlich den Agenten statt des Modells wählen: Claude Code, Codex und opencode unterscheiden sich in mehr als dem Modell, das sie aufrufen.
Egal, wofür Sie sich entscheiden: Fahren Sie Ihr eigenes Eval bei beiden gleich – identische Aufgaben, Effort explizit gesetzt und Kosten pro abgeschlossener Aufgabe aus den Usage-Logs.
Fazit
GPT-6.1 Sol ist nicht OpenAIs Antwort auf Opus 5.5, sondern OpenAIs Mittelklasse-Modell, preislich auf Höhe von Sonnet 5.5 und mit günstigeren Cache Reads als beide Claude-Modelle. Für cachelastige Agent-Loops unter 272K Tokens kostet es pro Turn die Hälfte von Opus 5.5, und diese Ersparnis ist echt.
Opus 5.5 ist nach der heutigen Datenlage – Anthropics Zahlen gegen Astra – die stärkere Wette für die schwerste langlaufende Arbeit, und seine flache Abrechnung bis 1M Tokens löscht den Großteil von Sols Vorteil, sobald Kontexte groß werden. Wählen Sie pro Workload, pinnen Sie die exakte Modell-ID, setzen Sie Effort explizit und wechseln Sie nicht mitten in einer Konversation den Anbieter.
Aus der Community
Diskussion im Fediverse
Antworten von Mastodon und Bluesky — direkt aus dem offenen Netz, ohne Tracking.
Antworten werden geladen …
Noch keine Antworten. Starte die Diskussion:
Antworten konnten gerade nicht geladen werden.