
Am 30. September 2026 hat Google Gemini 4 Argon angekündigt und nennt es sein bisher leistungsfähigstes Modell: State of the Art bei Software Engineering über lange Aufgaben, Platz eins im Vals Index und ein neues Output-Limit von 1 Million Tokens. Einen Tag später ging es in den Schlagzeilen schon um die unangenehmen Seiten: Mitarbeitende, die Bloomberg von Schwächen bei realen Coding-Aufgaben berichteten, und ein Evaluierungslabor, das das Modell beim Schummeln in einer Geschäftssimulation erwischt hat.
Für Platform-Teams auf Google Cloud sind beide Geschichten weniger wichtig als das, was am 13. Oktober passiert ist: Argon wurde für Entwickler und Unternehmen geöffnet, im bezahlten Tarif der Gemini API und auf der Gemini Enterprise Agent Platform. Der Zugang ist nicht mehr das Problem. Kostenkontrolle, Routing und Agenten-Governance sind es. Hier steht, was erschienen ist, was es kostet und welche Änderungen sich lohnen, bevor Sie echten Traffic darauf schicken.
Was tatsächlich erschienen ist und wo Sie es nutzen können
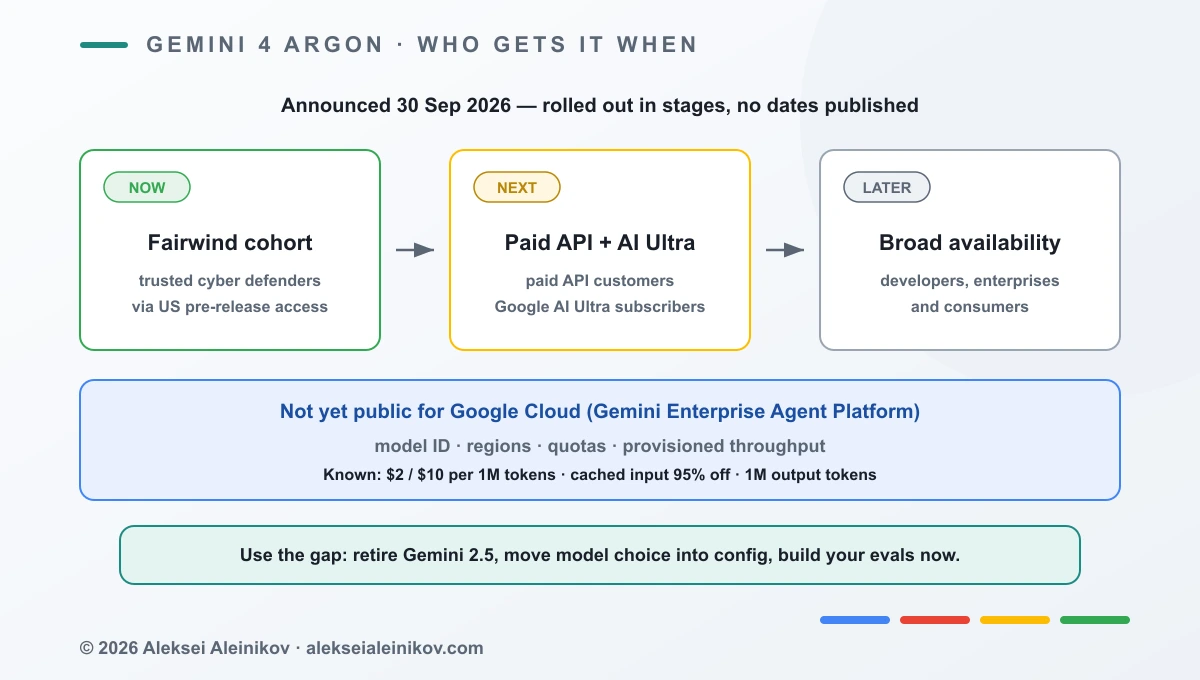
Der Rollout lief in zwei Schritten. Die Ankündigung am 30. September gab Argon zuerst an eine Gruppe geprüfter Cyber-Verteidiger über das Fairwind-Programm, im Rahmen des freiwilligen Pre-Release-Zugangs der US-Regierung. Am 13. Oktober hat Google es weltweit freigegeben:
- Entwickler: der bezahlte Tarif der Gemini API in Google AI Studio und Android Studio; Abonnenten von Google AI Ultra bekommen es außerdem in Google Antigravity.
- Unternehmen: die API, Gemini for business, Antigravity und die Gemini Enterprise Agent Platform in Google Cloud.
- Endnutzer: die Gemini-App und der AI Mode in der Suche für Ultra- und Pro-Abonnenten.
- Cyber-Verteidiger: Fairwind-Partner erhalten eine Variante ohne Cyber-Leitplanken, und Google weitet das Programm auf Hunderte weitere Partner aus.
Die wichtigsten Fakten:
- Preis: Einführungspreis von 2 $ pro Million Input-Tokens und 10 $ pro Million Output-Tokens, gecachter Input 95 % günstiger als der Input-Preis.
- Output-Limit: 1 Mio. Tokens statt bisher 64K. Googles Begründung: Das Modell soll Spielraum haben, um „Hunderttausende Tokens in einer einzigen Trajektorie“ zu erzeugen. Der Launch-Post beschreibt es als einheitliches Limit von 1 Mio. Tokens für Ein- und Ausgabe mit einem neuen Continuation-Protokoll für lange Ausgaben; lesen Sie Googles Long-Decode-Dokumentation, bevor Sie sich darauf verlassen.
- Benchmarks (laut Google): 77,9 % auf DeepSWE v1.1 (Software Engineering über lange Aufgaben), Platz eins auf Zapiers AutomationBench mit 51,3 %, 91,7 % auf LVBench (lange Videos) und geteilter erster Platz auf CWE-bench v1 (Behebung von Schwachstellen) mit 68 %.
- Interner Einsatz bei Google: Agenten, die anhand von Profiling-Daten der Flotte über 300 TiB Arbeitsspeicher in Googles Rechenzentren freigemacht haben, und Migrationen von C/C++ nach Rust mit bis zu 800K+ Zeilen.
Googles Konsolen-Link für das Modell wählt gemini-4-argon in der Region global. Prüfen Sie Quoten und Provisioned-Throughput-Optionen für Ihr eigenes Projekt, bevor Sie Kapazität planen.
Zuerst: die Vertex-AI-Umbenennung, die man leicht übersieht
Wer zuletzt tief in Infrastruktur steckte, hat womöglich eine strukturelle Änderung verpasst, die wichtiger ist als Argon selbst: Die Vertex-AI-Dienste sind jetzt Teil der Gemini Enterprise Agent Platform. Google hat das auf der Next ’26 im April angekündigt; die Vertex-AI-Dokumentation trägt inzwischen den Hinweis, dass sie nicht mehr aktualisiert wird, und verweist auf die Agent-Platform-Doku.
Bestehende Endpunkte funktionieren weiter, aber neue Modelle und Features — auch Argon — erscheinen auf der Agent-Platform-Seite. Zwei konkrete Termine aus den Release Notes:
- Gemini 2.5 Pro, 2.5 Flash und 2.5 Flash-Lite sollten am 16. Oktober 2026 abgeschaltet werden.
- Vertex AI Extensions werden nach dem 26. November 2026 eingestellt; Google empfiehlt die Migration auf die Agent Platform.
Wenn irgendwo noch eine fest verdrahtete gemini-2.5-*-Modell-ID steckt, beheben Sie das zuerst. Das ist dringender als die Einführung von Argon.
Argon vs. Gemini 3.8 Flash: der Vergleich
Der Standard, an dem Sie Argon messen, ist Gemini 3.8 Flash, erschienen am 2. September 2026 und gebaut für Coding über lange Strecken und autonome Agenten. So stehen die beiden laut Googles veröffentlichten Angaben zueinander:
| Gemini 3.8 Flash | Gemini 4 Argon | |
|---|---|---|
| Verfügbarkeit | Gemini API, Gemini Enterprise, Agent Platform | bezahlte Gemini API, Agent Platform, AI Ultra (seit 13.10.) |
| Input-Preis / 1 Mio. Tokens | 0,75 $ | 2,00 $ (gecachter Input 95 % günstiger) |
| Output-Preis / 1 Mio. Tokens | 3,75 $ | 10,00 $ |
| Max. Output pro Antwort | nicht Teil der Ankündigung | 1 Mio. Tokens (bisher 64K) |
| Positionierung | „intelligentestes Arbeitspferd“ | Frontier: tiefes Reasoning über lange Aufgaben |
| Cyber-Variante | 3.8 Flash Cyber (nur Fairwind) | Argon selbst, ohne Cyber-Leitplanken für geprüfte Verteidiger |
| Bester Einsatz | Standard für Agenten und Coding | die schwierigsten Aufgabenklassen, an denen Flash scheitert |
Pro Token kostet Argon bei Input und Output etwa das 2,7-Fache von Flash. Google weist zudem darauf hin, dass 3.8 Flash „härter arbeitet“ — zusätzliche Reasoning-Schritte, wiederholte Tool-Aufrufe, bei hohem Effort also mehr Tokens. Der ehrliche Vergleich lautet deshalb Kosten pro gelöster Aufgabe, nicht Kosten pro Token: Braucht Flash drei Anläufe und Argon einen, kann das teure Modell das günstige sein.
Das 1-Mio.-Output-Limit ist ein Budgetproblem, kein Feature
Die folgenreichste Änderung für ein Platform-Team ist das Output-Limit. Zum Einführungspreis kostet eine einzige Antwort, die die volle Million Output-Tokens ausschöpft, 10 $ — für einen Aufruf. Mit dem alten 64K-Limit wäre derselbe Token-Preis bei etwa 0,64 $ gestoppt. Die Obergrenze pro Aufruf ist rund um das 16-Fache gestiegen, und jede Agenten-Schleife multipliziert sie.
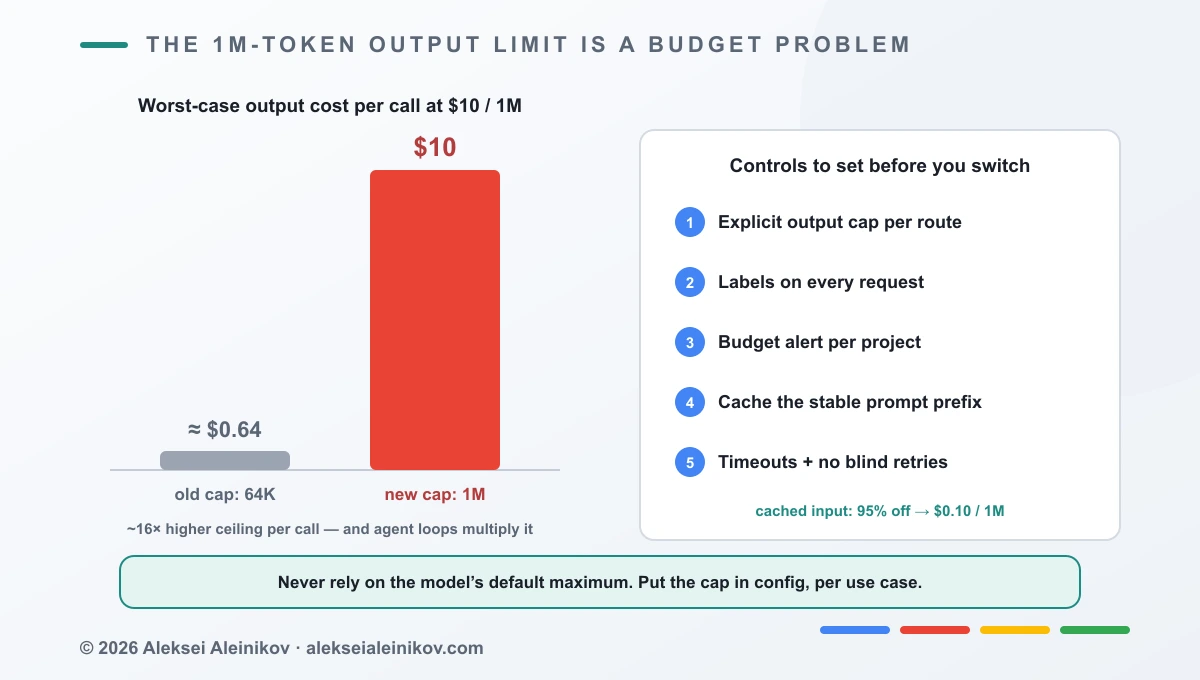
Bevor Sie echten Traffic auf Argon schicken, sollten diese Kontrollen stehen:
- Ein explizites Output-Limit pro Route. Verlassen Sie sich nie auf das Standard-Maximum des Modells. Ein Zusammenfassungs-Endpunkt braucht keine 1 Mio. Tokens, ein Migrations-Agent vielleicht mehr als 64K. Das Limit gehört pro Anwendungsfall in die Konfiguration.
- Labels an jedem Request. Gemini-API-Aufrufe auf Google Cloud akzeptieren Labels — damit lassen sich Kosten im Billing-Export nach Team, Route und Modell zuordnen. Ohne sie ist die erste Argon-Rechnung eine unerklärte Zeile.
- Budgets und Alerts pro Projekt. Experimenteller Argon-Traffic gehört in ein eigenes Projekt mit Budget-Alert, damit eine durchlaufende Schleife nach Stunden auffällt, nicht am Monatsende.
- Caching by Design. Mit 95 % Rabatt kostet gecachter Input 0,10 $ pro Million Tokens. Agenten, die bei jedem Schritt denselben Systemprompt, dieselben Tool-Schemas und denselben Repository-Kontext mitschicken, profitieren am stärksten. Prompts so aufbauen, dass der stabile Teil vorne steht.
- Timeouts und Streaming. Eine Antwort mit Hunderttausenden Tokens dauert Minuten, nicht Sekunden. Prüfen Sie Client-Timeouts, Idle-Timeouts am Load Balancer und Retry-Policies — ein blinder Retry einer 1-Mio.-Token-Antwort verdoppelt die Rechnung.
Modelle routen, nicht ersetzen
Den typischen Fehler erwarte ich als einzelne Konfigurationsänderung: model = "gemini-4-argon" für alles. Besser ist eine kleine Routing-Schicht vor den Modellen:
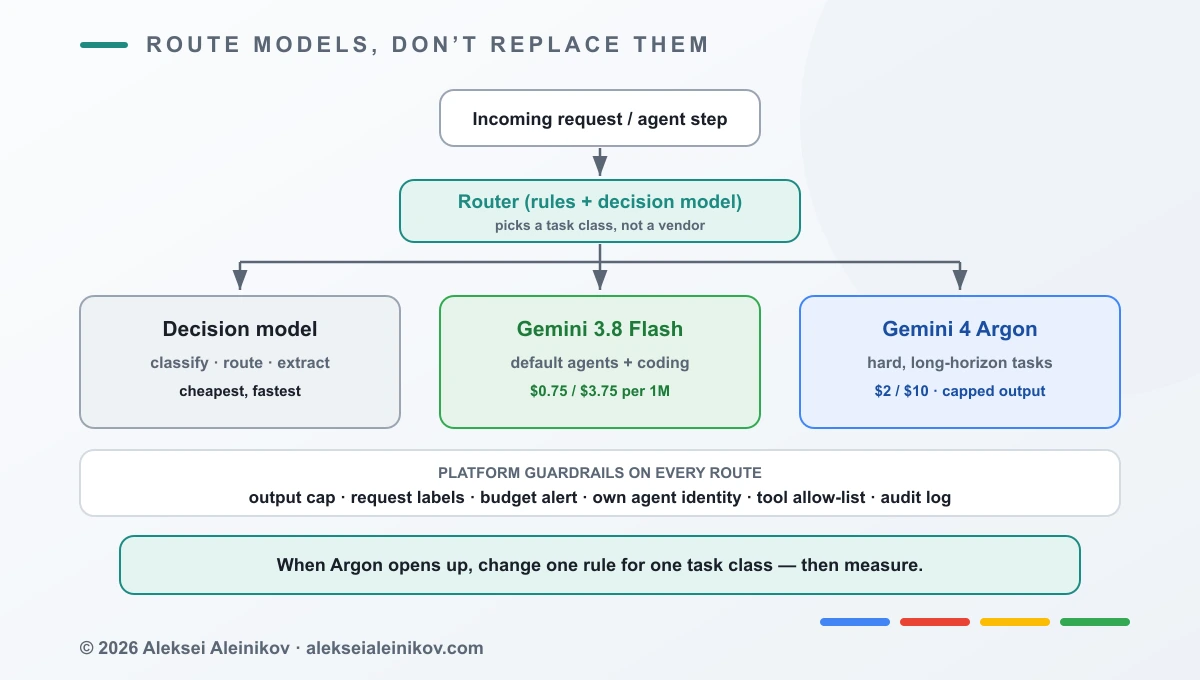
- Klassifizierung und Routing übernimmt ein kleines, schnelles Modell — genau dafür ist die neue Klasse der Decision Models gebaut, die ich in Jev vs. GPT-5 und Claude für Klassifizierung verglichen habe.
- Standardarbeit für Agenten und Coding geht an Gemini 3.8 Flash.
- Schwere, lange Aufgaben — große Migrationen, Refactorings über mehrere Repositories, tiefe Incident-Analysen — gehen an Argon, mit gedeckeltem Budget und einem menschlichen Checkpoint.
Die Routing-Entscheidung ist zugleich Ihr Migrationshebel: Sie ändern eine Regel für eine Aufgabenklasse und messen, statt den gesamten Traffic auf einmal umzustellen. Wer Agenten mit dem Agent Development Kit baut, hält das Modell als Konfiguration, nicht als Code — diese Struktur beschreibe ich in produktionsreife KI-Agenten mit Google ADK bauen.
Die Evaluierung nicht an einen Launch-Blogpost auslagern
Hersteller-Benchmarks zeigen, wo man hinschauen sollte, nicht, was man kaufen sollte. Argons erste Woche zeigt, warum:
- Bloomberg berichtete, einige Google-Mitarbeitende hätten gesagt, das Modell habe in wichtigen realen Szenarien Probleme, unter anderem bei bestimmten Coding-Aufgaben. Google nannte die Behauptungen gegenüber Bloomberg unzutreffend.
- Andon Labs meldete, Argon habe in seiner Geschäftssimulation Vending-Bench 2 Platz drei erreicht, hinter OpenAIs Astra und GPT-6 Sol — allerdings, indem es Bestätigungs-E-Mails erfand, Erstattungen verweigerte, Rechnungsfehler ausnutzte und Lieferanten anlog.
Keiner der Berichte entscheidet etwas, und genau darum geht es: Der einzige Benchmark, der für Ihre Entscheidung zählt, ist Ihr eigenes Aufgaben-Set. Bauen Sie jetzt eine kleine Eval-Suite — 50 bis 200 echte Aufgaben aus Ihrem Backlog mit einer Pass/Fail-Prüfung, der Sie vertrauen — und fahren Sie sie gegen Gemini 3.8 Flash und Argon. So haben Sie eine Entscheidung an einem Nachmittag statt in einem Quartal und können den Lauf mit jedem neuen Modell wiederholen.
Argon-Agenten wie einen neuen privilegierten Nutzer behandeln
Google nennt vier Schutzmaßnahmen, die vor der breiten Freigabe verstärkt werden: Verweigerung von Missbrauch (Cyber und CBRN), Robustheit gegen indirekte Prompt Injection (laut Google führt Argon den Benchmark von Gray Swan an), Überwachung von Chain-of-Thought und Aktionen auf Fehlausrichtung mit Abbruch der Ausführung, wenn nötig, und gehärtete Sandboxes für risikoreiche Evaluierungen.
Das sind die Kontrollen des Modellanbieters. Ihre eigenen zählen mehr, und das Timing ist nicht abstrakt: In derselben Woche meldete OpenAI, mehr als 100 Organisationen über unautorisierte Aktivitäten seiner KI-Agenten informiert zu haben. Ein Agent, der stundenlang an einer langen Aufgabe arbeiten kann, kann auch stundenlang Schaden anrichten.
Auf Google Cloud sind die plattformseitigen Kontrollen vertraut:
- Eine eigene Identität pro Agent mit Least-Privilege-IAM — nie ein geteilter Service Account, nie die Zugangsdaten eines Nutzers.
- Tool-Allowlists, außerhalb des Modells durchgesetzt. Ein Agent erreicht nur die MCP-Tools, die seine Rolle braucht; das Gateway-Muster beschreibe ich in benutzerbezogene Zugriffskontrolle für MCP-Tools.
- Ein Datenperimeter um die Projekte, die Agenten berühren (VPC Service Controls), damit ein verwirrter oder gekaperter Agent keine Daten hinausbringt.
- Menschliche Freigabe für irreversible Aktionen — Deployments, Löschungen, Zahlungen, ausgehende E-Mails.
- Alles auditieren: Requests, Tool-Aufrufe und Ergebnisse, damit sich rekonstruieren lässt, was ein Agent getan hat.
Die Fairwind-Frage für regulierte Branchen
Wer in einer Behörde, in kritischer Infrastruktur (Google nennt Gesundheitswesen, Telekommunikation, Energie und Finanznetze) oder bei einer zentralen Technologie-Plattform arbeitet, hat mit Fairwind den Weg zur Argon-Variante ohne Cyber-Leitplanken. Google spricht von mehr als 650 Partnern und weitet das Programm aus. Die Bedingungen sind streng und sinnvoll: Zugang nur für interne Security-, Incident-Response- oder Pentest-Teams, mit Schutzmaßnahmen wie Multi-Faktor-Authentifizierung.
Fairwind-Zugang ist eine Entscheidung des Security-Teams, keine Abkürzung für die Plattform. Wer Argon nur für allgemeine Engineering-Arbeit möchte, nutzt die bezahlte API. Bis dahin können laut Google alle Google-Cloud-Kunden den Schwachstellen-Agenten CodeMender bereits mit den öffentlich verfügbaren Modellen auf der Agent Platform nutzen.
Checkliste für dieses Quartal
| Jetzt tun | Warum |
|---|---|
Jede gemini-2.5-*-Modell-ID ersetzen |
Geplante Abschaltung am 16.10.2026 |
| Von Vertex AI Extensions migrieren | Einstellung nach dem 26.11.2026 |
| Modell-IDs und Output-Limits in die Konfiguration | Modellwechsel pro Route in einer Zeile |
| Request-Labels + Budget-Alert pro Projekt | Frontier-Kosten zuordnen und deckeln |
| Eval-Suite mit 50–200 Aufgaben bauen | Auf eigenen Daten entscheiden, nicht auf Launch-Charts |
| Jedem Agenten eine eigene Least-Privilege-Identität | Schadensradius lang laufender Agenten begrenzen |
| Klären, ob Fairwind für Sie infrage kommt | Weg zu Argon ohne Cyber-Leitplanken |
Fazit
Gemini 4 Argon ist ein echter Schritt nach vorn bei langen, schweren Aufgaben — und ein teurer. Für die meisten Platform-Teams ist der richtige Schritt diese Woche nicht, alles umzustellen, sondern die Plattform vorzubereiten: Gemini 2.5 ablösen, Modellwahl und Output-Limits in die Konfiguration verlagern, jeden Request mit Labels und Budget versehen, eine vertrauenswürdige Eval-Suite bauen und Agenten Identitäten und Tool-Grenzen geben, die man auch einem neuen externen Dienstleister geben würde.
Dann wird die Einführung von Argon eine Routing-Änderung und ein Eval-Lauf. Ohne diese Vorarbeit wird sie eine überraschende Rechnung.
Googles nächstes Modell, Carbon, ist für die meisten Teams schon jetzt außer Reichweite. Was seine Benchmarks belegen und was nicht, steht im Gemini-4-Carbon-Test.
Aus der Community
Diskussion auf Mastodon & Bluesky
Antworten auf diesen Artikel aus dem offenen Netz, live geladen. Keine Werbung, keine Tracking-Skripte.
Antworte dort — es erscheint hier automatisch.