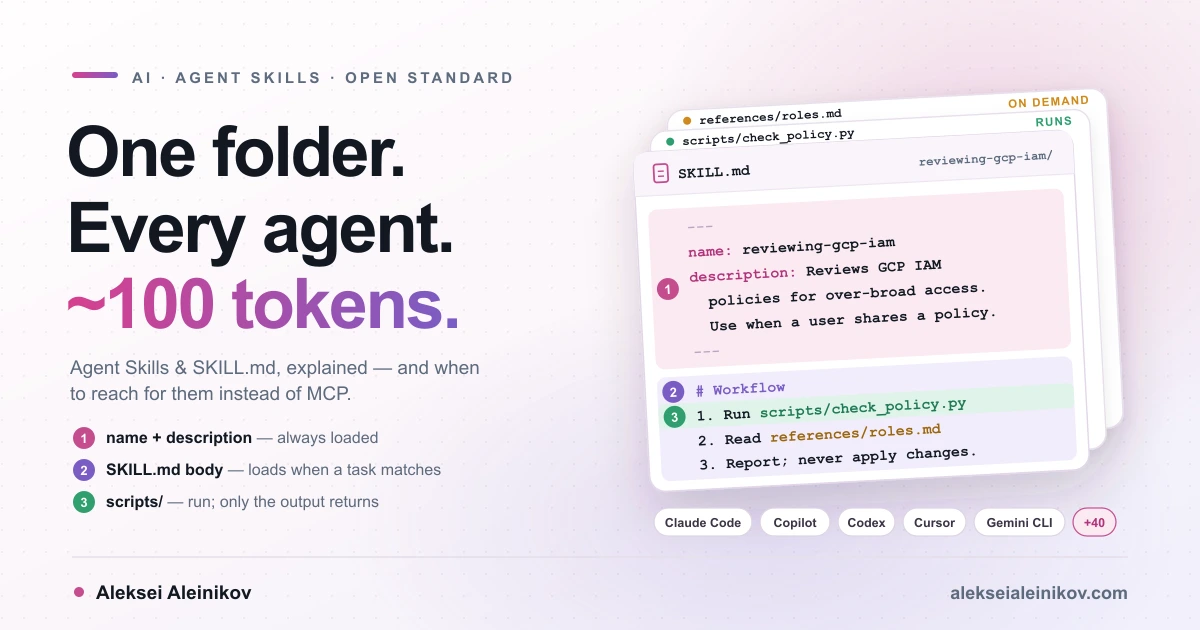
Wer 2026 die Wurzel eines aktiv gepflegten Repositorys öffnet, findet mit guter Wahrscheinlichkeit einen Ordner, den es vor einem Jahr noch nicht gab: .claude/skills/, .github/skills/ oder .agents/skills/. Darin kurze Markdown-Dateien namens SKILL.md. Dieser Ordner ist still und leise zum portabelsten Weg geworden, einem KI-Agenten eine Aufgabe beizubringen. Anthropic hat Agent Skills im Oktober 2025 vorgestellt und das Format am 18. Dezember 2025 als offenen Standard veröffentlicht. Die offizielle Client-Liste nennt inzwischen mehr als 40 Produkte — darunter Claude Code, GitHub Copilot, VS Code, OpenAI Codex und ChatGPT, Cursor, Gemini CLI, JetBrains Junie, OpenCode, Kiro, Goose und Pulumi Neo.
Der Hype lässt Skills wie einen Ersatz für alles Bisherige klingen: Prompts, MCP-Server, AGENTS.md, eigene Agenten. Das sind sie nicht. Skills lösen ein ganz bestimmtes Problem — Ablaufwissen, das ein Agent nur manchmal braucht — und das bemerkenswert gut. Gleichzeitig entsteht eine neue Software-Lieferkette, die mit den Rechten Ihres Agenten läuft. Dieser Leitfaden behandelt beide Hälften: wie Skills wirklich funktionieren, wo die großen Agenten nach ihnen suchen, worin sie sich von MCP und den anderen Anpassungsebenen unterscheiden und wie Sie Skills schreiben und installieren, ohne Ihren Laptop einem Fremden zu überlassen.
Was ein Agent Skill tatsächlich ist
Ein Agent Skill ist ein Ordner mit einer SKILL.md-Datei — YAML-Frontmatter mit Name und Beschreibung, gefolgt von Anweisungen in Markdown —, den ein KI-Agent beim Start entdeckt und erst lädt, wenn eine Aufgabe passt. Alles andere im Ordner ist optional:
reviewing-gcp-iam/├── SKILL.md # Pflicht: Metadaten + Anweisungen├── scripts/ # optional: Code, den der Agent ausführt├── references/ # optional: Doku, die der Agent bei Bedarf liest└── assets/ # optional: Vorlagen, Schemas, BilderDie Spezifikation ist kurz genug, um sie auswendig zu kennen. Das Frontmatter hat zwei Pflichtfelder und vier optionale:
| Feld | Pflicht | Regeln |
|---|---|---|
name |
Ja | 1–64 Zeichen, Kleinbuchstaben, Ziffern und Bindestriche; kein Bindestrich am Anfang, am Ende oder doppelt; muss dem Ordnernamen entsprechen |
description |
Ja | 1–1.024 Zeichen; sagt, was der Skill tut und wann er gilt |
license |
Nein | Lizenzname oder eine beigelegte Lizenzdatei |
compatibility |
Nein | Bis zu 500 Zeichen Umgebungsanforderungen (Produkt, Systempakete, Netzwerk) |
metadata |
Nein | Freie String-zu-String-Map, etwa Autor und Version |
allowed-tools |
Nein | Leerzeichengetrennte vorab freigegebene Tools, z. B. Bash(git:*) Read — experimentell, Unterstützung variiert |
Der Teil nach dem Frontmatter hat keine Pflichtstruktur. Die Spezifikation empfiehlt Schritt-für-Schritt-Anweisungen, Beispiele für Ein- und Ausgaben sowie Randfälle; die SKILL.md soll unter 500 Zeilen bleiben, Details wandern in referenzierte Dateien, höchstens eine Ebene tief. Der Referenz-Validator skills-ref validate ./my-skill prüft Frontmatter und Namensregeln.
Das ist das ganze Format. Spannend ist nicht, was ein Skill ist, sondern wie Agenten ihn laden.
Wie Skills geladen werden: Progressive Disclosure
Ein Skill ist um eine Einschränkung herum gebaut: Das Kontextfenster ist geteilt und teuer. Alles, was ein Agent während einer Aufgabe weiß — System-Prompt, Gesprächsverlauf, Tool-Definitionen, Dateiinhalte —, konkurriert um dieselben Token. Warum dieses Budget so wichtig ist, beschreibt Context Engineering 2026. Skills sind das bisher sauberste Werkzeug des Context Engineering, weil sie in drei Stufen laden:
- Discovery — rund 100 Token pro Skill. Beim Start liest der Agent nur
nameunddescriptionaller installierten Skills und legt sie in seinen System-Prompt. Das genügt, um zu wissen, dass ein Skill existiert und wann er relevant sein könnte. - Aktivierung — empfohlen unter 5.000 Token. Passt Ihre Anfrage zu einer Beschreibung, liest der Agent den vollständigen Inhalt der
SKILL.mdin den Kontext. Bei Claude ist das wörtlich ein Shell-Aufruf:cat reviewing-gcp-iam/SKILL.md. - Ausführung — nur, was die Aufgabe berührt. Verweisen die Anweisungen auf
references/finance.md, liest der Agent genau diese Datei und lässtreferences/sales.mdauf der Platte. Steht dort, er sollescripts/check_policy.pyausführen, tut er das — und nur die Ausgabe des Skripts gelangt in den Kontext, nie der Quellcode.
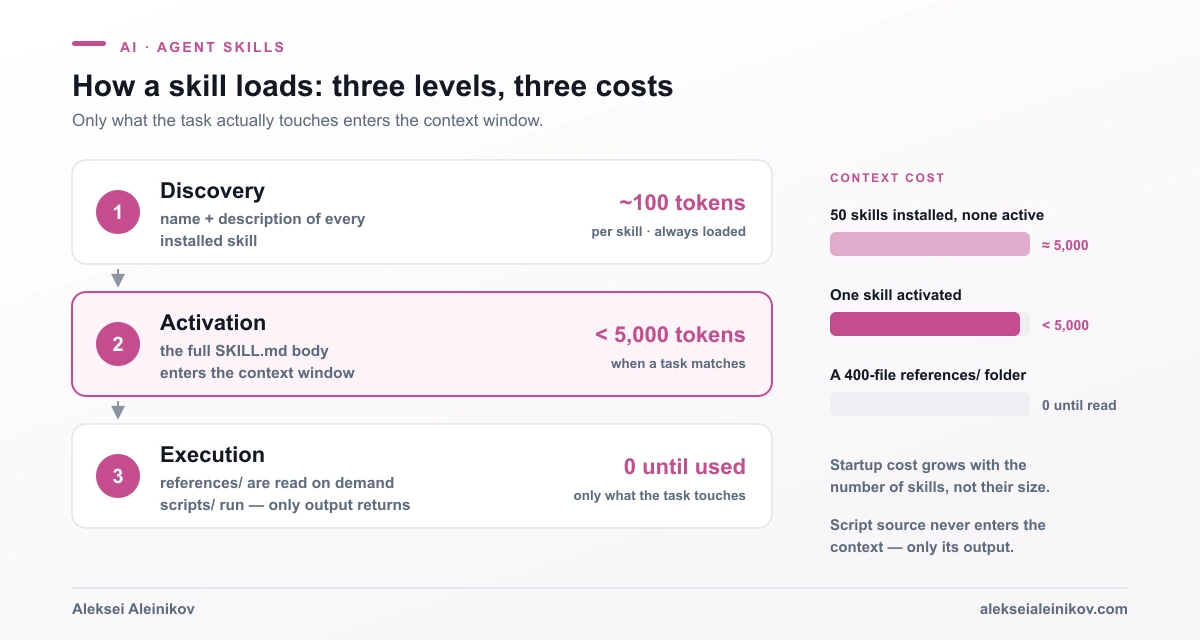
Die Folgen sind größer, als es klingt. Bei einem klassischen System-Prompt oder einer CLAUDE.md kostet jede Zeile in jeder Runde Token, ob relevant oder nicht. Mit Skills kostet ein 20-seitiges Runbook ungefähr so viel wie ein Satz — bis zu dem Moment, in dem es gebraucht wird. Anthropics technischer Beitrag geht noch weiter: Für einen Agenten mit Dateisystem und Codeausführung ist die Menge an Kontext, die man in einen Skill packen kann, praktisch unbegrenzt, weil Dateien erst beim Lesen etwas kosten.
Zwei Details, die das Marketing meist weglässt:
- Auch die Discovery-Liste hat ein Budget. Claude Code gibt der Skill-Liste etwa 1 % des Kontextfensters und begrenzt die Beschreibung pro Eintrag auf 1.536 Zeichen; läuft die Liste über, fallen zuerst die Beschreibungen der am seltensten genutzten Skills weg. Codex hält die anfängliche Liste unter 2 % des Kontextfensters (oder 8.000 Zeichen, wenn das Fenster unbekannt ist) und kürzt zuerst die Beschreibungen. Wer 200 Skills installiert, macht einige davon unsichtbar.
- Ein geladener Skill bleibt geladen. In Claude Code landet die gerenderte
SKILL.mdeinmal im Gespräch und bleibt dort über alle Runden. Nach einer automatischen Komprimierung hängt Claude Code nur die ersten 5.000 Token jedes aufgerufenen Skills wieder an, innerhalb eines gemeinsamen Budgets von 25.000 Token. Was überleben muss, gehört nach oben.
Skills vs. MCP vs. AGENTS.md vs. Subagenten
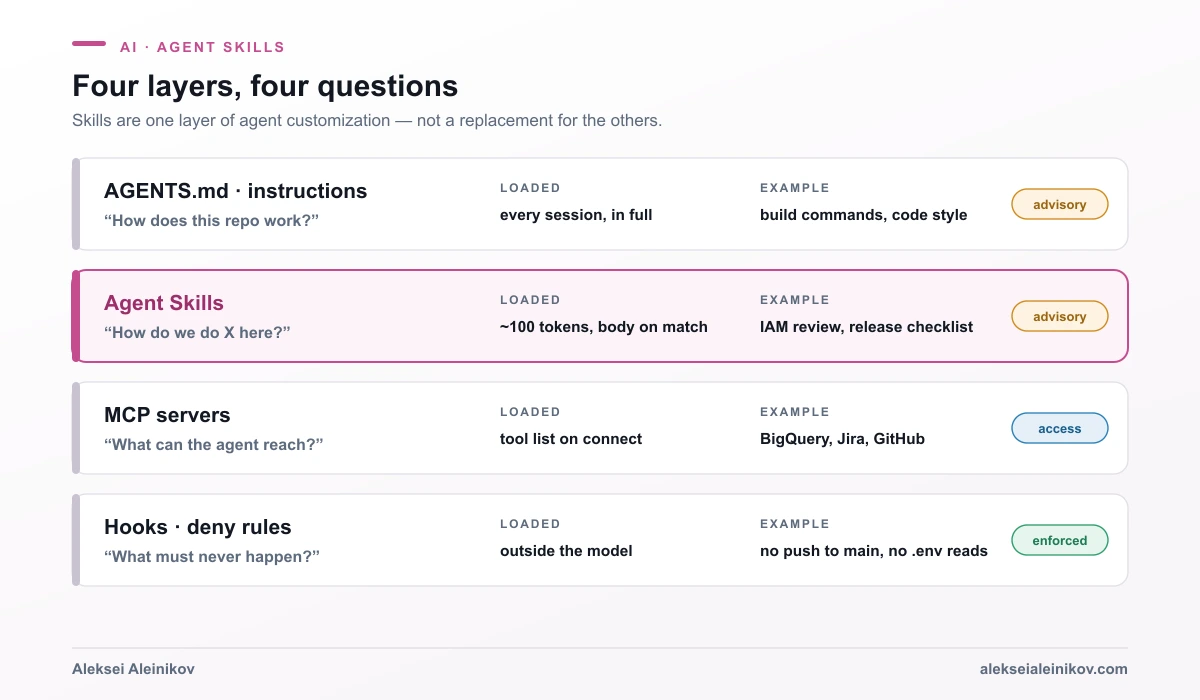
Hier entsteht die meiste Verwirrung, deshalb die Kurzfassung: MCP gibt einem Agenten Zugriff, ein Skill gibt ihm Know-how, AGENTS.md gibt ihm die Hausregeln, und Hooks geben Ihnen Garantien. Das sind Ebenen, keine Konkurrenten.
| Agent Skill | MCP-Server | AGENTS.md / Custom Instructions |
Subagent | Hook / Deny-Regel | |
|---|---|---|---|---|---|
| Was es ist | Ein Ordner: SKILL.md + optionale Skripte und Doku |
Ein Prozess, der Tools, Ressourcen und Prompts über ein Protokoll bereitstellt | Eine Markdown-Datei, die in jede Sitzung geladen wird | Ein eigener Agent mit eigenem Kontextfenster | Deterministischer Code oder Policy auf Agenten-Ereignisse |
| Gibt dem Agenten | Einen Ablauf: wie wir X machen | Reichweite: die Fähigkeit, Y anzufassen | Fakten: wie dieses Repo funktioniert | Isolation: Z woanders erledigen und berichten | Grenzen: das passiert nie |
| Wann es Kontext kostet | ~100 Token immer, Inhalt bei Treffer | Tool-Liste des verbundenen Servers; Claude Code lädt vollständige Schemas nur bei Bedarf (Tool Search), viele Clients laden sie vorab | Immer, vollständig | Nur das Endergebnis | Nie |
| Führt Code aus | Optionale gebündelte Skripte über die Shell des Agenten | Ja, im Server | Nein | Über eigene Tools | Ja, außerhalb des Modells |
| Portabel | Offener Standard, 40+ Clients | Offenes Protokoll | AGENTS.md ist ein offenes Format |
Produktspezifisch | Produktspezifisch |
| Kann das Modell es ignorieren | Ja | Es kann ein Tool nicht aufrufen | Ja | — | Nein |
Aus dieser Tabelle folgen drei praktische Regeln:
- Muss der Agent ein System erreichen, das er heute nicht erreicht — eine Datenbank, Jira, eine Cloud-API —, ist das ein MCP-Server, kein Skill. Wie man einen baut und absichert, zeigt MCP-Server erklärt.
- Fügen Sie immer wieder dieselbe Checkliste in den Chat ein, ist das ein Skill. Die Doku von Claude Code formuliert es fast genauso: Erstellen Sie einen Skill, wenn ein Abschnitt der
CLAUDE.mdzu einem Ablauf statt einem Fakt geworden ist. - Muss eine Regel jedes Mal gelten, reicht weder ein Skill noch
AGENTS.md— das Modell kann Anweisungen überspringen. Die Troubleshooting-Doku von Claude Code rät selbst, solche Regeln in einen Hook zu verschieben. Für Tool-Berechtigungen heißt das Deny- und Ask-Regeln, wie in Claude-Code-Modi im Vergleich beschrieben.
Beides lässt sich kombinieren. Ein Skill kann vorgeben, welche MCP-Tools der Agent in welcher Reihenfolge und mit welchen Zwischenprüfungen aufruft. Anthropics Best-Practice-Leitfaden verlangt sogar, MCP-Tools im Skill voll qualifiziert zu referenzieren (BigQuery:bigquery_schema), damit der Agent den richtigen Server wählt. Diese Paarung — MCP für die Hände, ein Skill für das Playbook — ist der Kern des eigentlichen Nutzens.
Wo die Agenten nach Skills suchen
Das Format ist portabel, die Ordner und Zusatzfunktionen sind es nicht. Stand Oktober 2026:
| Agent | Projekt-Skills | Persönliche Skills | Explizit aufrufen | Automatische Nutzung abschalten |
|---|---|---|---|---|
| Claude Code | .claude/skills/<name>/ (auch in Elternverzeichnissen bis zur Repo-Wurzel) |
~/.claude/skills/<name>/ |
/name |
disable-model-invocation: true |
| GitHub Copilot in VS Code | .github/skills/, .claude/skills/, .agents/skills/ |
~/.copilot/skills/, ~/.claude/skills/, ~/.agents/skills/ |
/name |
disable-model-invocation: true |
| OpenAI Codex | .agents/skills/ vom Arbeitsverzeichnis bis zur Repo-Wurzel |
~/.agents/skills/ (Admin: /etc/codex/skills) |
$name oder /skills |
allow_implicit_invocation: false in agents/openai.yaml |
Quellen: Claude-Code-Skills, VS Code Agent Skills, Codex-Skills.
Die Lehre für Teams: .agents/skills/ ist der neutralste Ort, und VS Code liest zusätzlich .claude/skills/ — ein einziger eingecheckter Ordner kann also mehrere Werkzeuge bedienen. Mischt Ihr Team Claude Code und Codex, halten Sie die maßgebliche Kopie an einer Stelle und verlinken die andere per Symlink; Claude Code und Codex folgen beide verlinkten Skill-Ordnern.
Die Portabilitätsfalle: zusätzliches Frontmatter
Jeder Hersteller erweitert das Format, und die Erweiterungen wandern nicht mit. Claude Code ergänzt disable-model-invocation, user-invocable, context: fork (Skill in einem isolierten Subagenten ausführen), argument-hint, paths, model, hooks und mehr. VS Code unterstützt mehrere derselben Namen. Codex legt seine Extras in eine separate Datei agents/openai.yaml.
Die Falle: Ein Upload auf claude.ai oder über die Claude Skills API scheitert hart, sobald ein Feld außerhalb der sechs Standardfelder enthalten ist — mit einer Meldung wie Unexpected key(s) in SKILL.md frontmatter: argument-hint. Soll ein Skill überall laufen, beschränken Sie das Frontmatter auf name, description, license, compatibility, metadata und allowed-tools und legen werkzeugspezifisches Verhalten in den Text oder in eine Herstellerdatei daneben.
Selbst bauen: ein Skill für Least-Privilege-IAM-Reviews
Hier ein Skill, den ein Plattform-Team so direkt einsetzen könnte. Er prüft eine IAM-Policy in Google Cloud, markiert zu breite Bindings mit einem deterministischen Skript und schlägt Least-Privilege-Ersatz vor. Er wendet einige der Regeln an, die der kostenlose GCP IAM Policy Checker im Browser prüft — verpackt, damit ein Agent sie direkt im Repository nutzen kann.
.agents/skills/reviewing-gcp-iam/├── SKILL.md├── scripts/│ └── check_policy.py└── references/ └── predefined-roles.mdDie SKILL.md mit ausschließlich portablen Feldern (die Anweisungen bleiben bewusst Englisch — so funktioniert der Skill in jedem Team):
---name: reviewing-gcp-iamdescription: Reviews Google Cloud IAM policies for over-broad access. Flags basic roles (owner, editor, viewer), public principals and service accounts with project-wide power, and proposes least-privilege predefined roles. Use when the user shares an IAM policy, asks who has access to a GCP project, or requests an IAM, permissions or least-privilege review.license: MITmetadata:  author: platform-team  version: "1.0"---
# Reviewing GCP IAM policies
## Workflow1. Get the policy as JSON. If the user has not provided one, ask for the project ID and run:   `gcloud projects get-iam-policy PROJECT_ID --format=json > policy.json`2. Run the checker and use only its output:   `python3 scripts/check_policy.py policy.json`3. For each finding, propose a predefined role. Look up candidates in   [references/predefined-roles.md](references/predefined-roles.md) and read only the section for the affected service.4. Report using the table below. Never apply changes yourself; output `gcloud` commands for a human to run.
## Report format| Severity | Member | Current role | Proposed role | Why ||---|---|---|---|---|
## Rules- `allUsers` or `allAuthenticatedUsers` on any role is HIGH.- A service account with a basic role is HIGH: any code running as it inherits project-wide power.- Never propose removing the last owner of a project.
Und das Skript, das den Teil übernimmt, den ein Sprachmodell nicht improvisieren sollte:
#!/usr/bin/env python3"""Flag risky bindings in a GCP IAM policy exported with --format=json."""import jsonimport sys
BASIC = {"roles/owner", "roles/editor", "roles/viewer"}PUBLIC = {"allUsers", "allAuthenticatedUsers"}

def check(policy: dict) -> list[tuple[str, str, str, str]]:    findings = []    for binding in policy.get("bindings", []):        role = binding.get("role", "")        for member in binding.get("members", []):            if member in PUBLIC:                findings.append(("HIGH", member, role, "public principal"))            elif role in BASIC and member.startswith("serviceAccount:"):                findings.append(("HIGH", member, role, "basic role on a service account"))            elif role in BASIC:                findings.append(("MEDIUM", member, role, "basic role; prefer a predefined role"))    return findings

if __name__ == "__main__":    if len(sys.argv) != 2:        sys.exit("usage: check_policy.py policy.json")    with open(sys.argv[1]) as f:        results = check(json.load(f))    for severity, member, role, why in results:        print(f"{severity}\t{member}\t{role}\t{why}")    print(f"{len(results)} finding(s)")
Warum er so gebaut ist:
- Die Beschreibung enthält die Auslöser, die Menschen tatsächlich verwenden — IAM policy, who has access, permissions, least-privilege — und sagt erst, was der Skill tut, dann wann.
- Das Skript ist die Quelle der Wahrheit für die Erkennung. Anthropics Leitfaden ist da deutlich: Für deterministische Operationen lieber ein vorgefertigtes Skript, weil generierter Code weniger zuverlässig ist und bei jedem Lauf Token kostet. Das Modell übernimmt, was es gut kann: Befunde erklären und Ersatzrollen auswählen.
- Die Referenzdatei wird selektiv geladen. Ein Katalog vordefinierter Rollen ist lang; die Anweisungen sagen dem Agenten, nur den benötigten Abschnitt zu lesen.
- Er hat keine Seiteneffekte. Er gibt
gcloud-Befehle aus, statt sie auszuführen. Ein Skill, der Dinge verändert, sollte nur von Hand ausgelöst werden — in Claude Code und VS Code mitdisable-model-invocation: true.
Testen wie Code
Ein Skill, der auslöst, ist noch kein Skill, der funktioniert. Anthropic empfiehlt, mindestens drei Evaluierungen anzulegen, bevor man umfangreiche Anweisungen schreibt, und die Ergebnisse dann in einer frischen Sitzung mit und ohne Skill zu vergleichen. In Claude Code automatisiert das skill-creator-Plugin diese Schleife: Es führt jeden Testfall in einem isolierten Subagenten aus, bewertet die Ausgabe, vergleicht Erfolgsquote, Token und Laufzeit mit und ohne Skill und erzeugt Prompts, bei denen der Skill auslösen bzw. nicht auslösen soll, um die Beschreibung zu schärfen. /skill-doctor zeigt, was jeder installierte Skill an Kontext kostet und welche Sie nie nutzen.
Beschreibungen, die wirklich auslösen
Feuert ein Skill nicht, liegt es fast immer an der Beschreibung. Der Agent vergleicht Ihre Anfrage mit einer Liste einzeiliger Beschreibungen — manchmal Dutzenden — und wählt eine aus. Diese Regeln funktionieren in Claude, Copilot und Codex:
- Erst sagen, was er tut, dann wann. „Generates commit messages by analysing staged diffs. Use when the user asks for a commit message or wants to review staged changes.“
- In der dritten Person schreiben. Die Beschreibung landet im System-Prompt; Anthropic warnt, dass „I can help you…“ oder „You can use this to…“ die Erkennung stört.
- Hauptanwendungsfall und Auslöser nach vorne. Claude Code und Codex kürzen Beschreibungen, wenn die Liste voll ist. Was am Ende steht, fällt als Erstes weg.
- Grenzen benennen. Der Codex-Leitfaden empfiehlt, klar zu sagen, wann der Skill nicht auslösen soll. Ein Skill, der bei allem feuert, ist genauso kaputt wie einer, der nie feuert.
- Nach der Tätigkeit benennen. Anthropic schlägt Gerundien vor —
processing-pdfs,reviewing-gcp-iam— und rät vonhelper,utilsodertoolsab.
Schlecht: description: Helps with IAM. Gut: die aus dem Beispiel oben.
Was auf keiner Folie steht: Skills sind eine Lieferkette
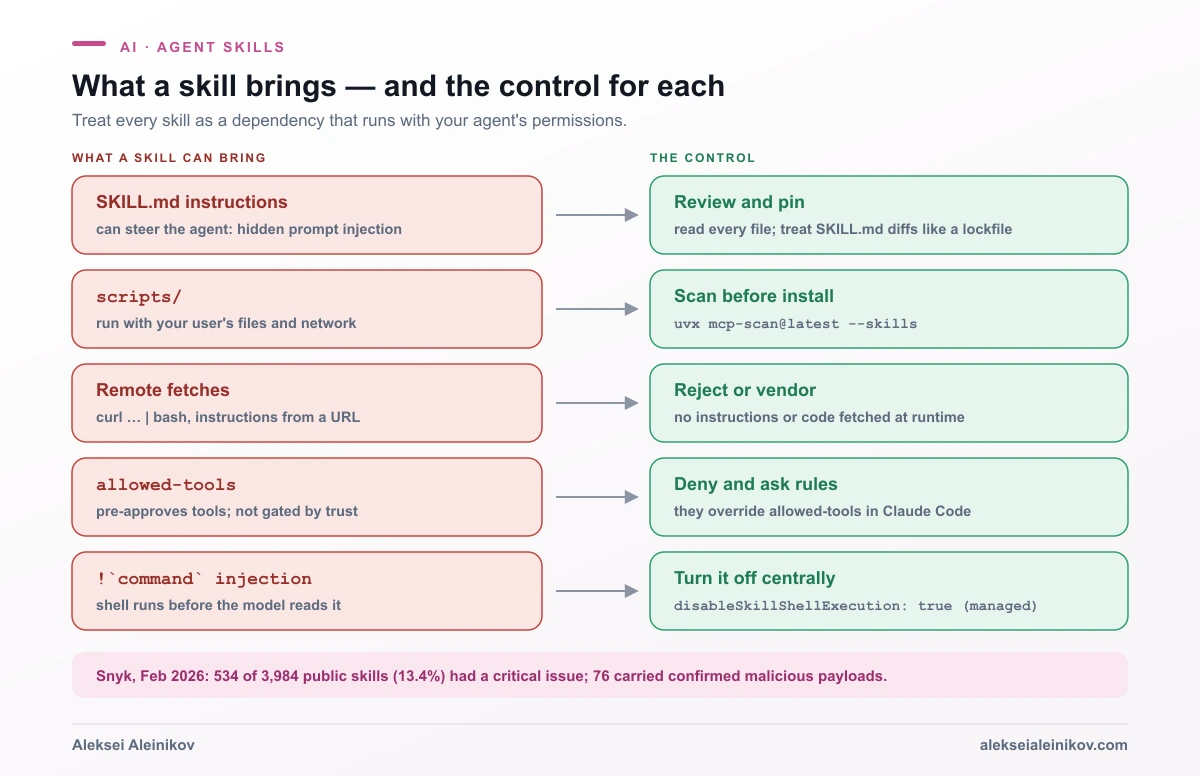
Ein Skill ist keine Dokumentation. Er besteht aus Anweisungen, denen ein Agent folgt, und Code, den er ausführen darf — mit Ihren Rechten, auf Ihrem Rechner. Anthropics eigene Übersicht sagt, Skills nur aus vertrauenswürdigen Quellen zu nutzen und die Installation wie die einer Software zu behandeln. In Claude Code haben die Skripte eines Skills — anders als im abgeschotteten Container der Claude API — denselben Netzwerkzugriff wie jedes andere Programm auf Ihrem Rechner.
Das Ökosystem wurde bereits auf die Probe gestellt. Am 5. Februar 2026 veröffentlichte Snyk die ToxicSkills-Studie, einen Scan von 3.984 öffentlichen Skills aus ClawHub und skills.sh:
- 534 Skills (13,4 %) hatten mindestens ein kritisches Problem — Malware-Verteilung, Prompt Injection oder offengelegte Secrets.
- 1.467 Skills (36,8 %) hatten mindestens eine Sicherheitslücke beliebigen Schweregrads.
- 76 bestätigte Schadcode-Payloads für Zugangsdatendiebstahl, Hintertüren und Datenabfluss.
- 91 % der bestätigten bösartigen Skills kombinierten Prompt Injection mit Schadcode: Die Anweisungen reden dem Agenten seine Vorsicht aus, dann richtet das Skript den Schaden an.
Die Muster kennt jeder, der die frühen npm-Jahre erlebt hat: ein „Voraussetzungen“-Schritt, der ein passwortgeschütztes ZIP lädt, ein base64-kodiertes curl … | bash, ein Skill, der seine eigentlichen Anweisungen zur Laufzeit von einer URL holt, sodass die geprüfte Version nicht die ist, die läuft.
Zwei Verhaltensweisen von Claude Code verdienen besondere Aufmerksamkeit, weil man sie leicht übersieht:
allowed-toolshängt nicht vom Workspace-Trust ab. Die Doku sagt es unmissverständlich: Dieallowed-toolseines Projekt-Skills gelten bei jedem Aufruf, auch in einem-p-Lauf in einem Ordner, dem Sie nie vertraut haben. Ein geklontes Repository kann einen Skill mitbringen, der für seine RundeBash(curl *)vorab freigibt. Lesen Sie das Frontmatter jedes Skills in einem Repository, bevor Sie einen Agenten darauf ansetzen.!`command`läuft, bevor das Modell irgendetwas sieht. Die dynamische Kontextinjektion von Claude Code führt Shell-Befehle beim Rendern des Skills aus und fügt deren Ausgabe ein. Diese Befehle werden zwar gegen Ihre Berechtigungsregeln geprüft — eine Deny-Regel bricht den Aufruf ab —, bleiben aber Shell-Befehle aus der Feder des Skill-Autors. Organisationen können das für Nutzer-, Projekt- und Plugin-Skills mit"disableSkillShellExecution": truein den Managed Settings abschalten.
Eine Checkliste, die sich in der Praxis bewährt:
- Nur aus Quellen installieren, die Sie benennen können. Eigene Repositorys, die Ihrer Organisation oder offizielle Sammlungen der Hersteller (anthropics/skills, openai/skills, github/awesome-copilot) — und trotzdem lesen.
- Skills in Git versionieren und Diffs prüfen. Ein Skill ist eine Abhängigkeit. Behandeln Sie eine geänderte
SKILL.mdwie ein geändertes Lockfile. - Scannen.
uvx mcp-scan@latest --skillsprüft installierte Skills auf Prompt Injection, verdächtige Downloads und Secrets. - Anweisungen aus dem Netz ablehnen. Ein Skill, der Anweisungen oder Skripte zur Laufzeit von einer URL holt, lässt sich nicht prüfen. Einchecken oder ablehnen.
- Secrets aus Skill-Ordnern heraushalten. Snyk fand fest eingebaute Secrets in 10,9 % der ClawHub-Skills.
- Skills mit harten Grenzen absichern. Deny-Regeln, Ask-Regeln für Seiteneffekte und eine Sandbox auf Betriebssystemebene stoppen einen Skill, der das Modell zu etwas überredet hat. Das ist wieder die Lethal Trifecta: Private Daten, nicht vertrauenswürdige Inhalte und ein Abflusskanal in einem Agenten sind die Bedingung, die man brechen muss.
Wann Sie keinen Skill brauchen
Eine praktische Faustregel: Haben Sie einem Agenten denselben Ablauf dreimal erklärt, wird daraus ein Skill; darf eine Regel nie gebrochen werden, wird daraus ein Hook; muss der Agent ein neues System erreichen, wird daraus ein MCP-Server. Halten Sie auch die Zahl der Skills klein: Jeder zusätzliche Skill ist eine weitere Beschreibung, die um die Aufmerksamkeit des Agenten konkurriert.
Skills sind seltener das richtige Werkzeug, als der Hype vermuten lässt:
- Einmalige Aufgaben. Schreiben Sie einfach den Prompt.
- Fakten, die der Agent in jeder Runde braucht — Build-Befehle, Code-Stil, Verzeichnisstruktur. Das gehört in
AGENTS.mdoder Ihre Custom-Instructions-Datei. - Zugriff auf Systeme. Authentifizierung, Live-Daten und entfernte Aktionen gehören in einen MCP-Server, idealerweise hinter einem Gateway mit Berechtigungen pro Nutzer, wie in benutzerbezogener Zugriffskontrolle für MCP.
- Garantien. „Nie auf main pushen“, „nie
.envlesen“ — dafür gibt es Deny-Regeln und Hooks. - Kontext, den der Skill zur Laufzeit aus dem Internet holen würde. Das ist kein Skill, sondern ein entfernter Prompt mit Zusatzschritten.
Fazit
Agent Skills haben sich durchgesetzt, weil sie im besten Sinne langweilig sind: ein Ordner, eine Markdown-Datei und zwei Pflichtfelder — für Menschen lesbar, in Git vergleichbar und über mehr als 40 Agenten hinweg portabel. Der clevere Teil ist Progressive Disclosure: rund 100 Token pro Skill bis zu dem Moment, in dem eine Aufgabe ihn braucht. Damit lässt sich einem Agenten endlich tiefes, spezifisches Know-how mitgeben, ohne jedes Gespräch darin zu ertränken.
Sie ersetzen weder MCP noch AGENTS.md noch Berechtigungsregeln; sie sind die fehlende Ebene dazwischen. Schreiben Sie Beschreibungen, die sagen was und wann, verlagern Sie deterministische Arbeit in Skripte, halten Sie das Frontmatter portabel — und prüfen Sie jeden Skill, den Sie installieren, mit demselben Misstrauen wie ein Paket, das mit Ihren Zugangsdaten läuft. Denn genau das ist er.
Aus der Community
Diskussion im Fediverse
Antworten von Mastodon und Bluesky — direkt aus dem offenen Netz, ohne Tracking.
Antworten werden geladen …
Noch keine Antworten. Starte die Diskussion:
Antworten konnten gerade nicht geladen werden.