Jev wirkt nur aus der Entfernung wie ein direkter Konkurrent zu GPT-5 und Claude. Alle drei können ein Ticket klassifizieren, einen Lead bewerten oder den nächsten Handler auswählen. Sie erreichen das Ergebnis jedoch über sehr unterschiedliche Verträge.
GPT-5 und Claude sind Sprachmodelle, deren Ausgabe man auf JSON oder einen Tool-Aufruf begrenzen kann. Jev verzichtet auf beliebige Textgenerierung und bietet stattdessen drei Entscheidungsprimitive. Genau diese engere Schnittstelle ist das Produkt.
Die nützliche Frage lautet deshalb nicht: „Welches Modell ist intelligenter?“ Sondern: Braucht dieser Schritt generierte Sprache oder eine begrenzte Entscheidung, die Code direkt verarbeiten kann?
Das Urteil in 30 Sekunden
| Wenn der Produktionsschritt Folgendes braucht … | Erste Wahl | Warum |
|---|---|---|
| Ein Label aus einer bekannten Taxonomie | Jev Choice oder klassischer Klassifikator | Antwortbereich und Wahrscheinlichkeiten sind nativ |
| Ein binäres Risikosignal | Jev Noul | Eine Wahrscheinlichkeit kann explizite Prüfschwellen steuern |
| Eine Bewertung anhand beschriebener Stufen | Jev Score | Liefert die gesamte Verteilung statt nur einer generierten Zahl |
| Ein Label plus schriftliche Erklärung | GPT oder Claude mit Structured Outputs | Jev kann die Erklärung nicht generieren |
| Bilder, Audio oder Video | GPT oder Claude | Jev 1.13 akzeptiert nur Text |
| Zählen, Rechnen oder Datumsvergleich | Deterministischer Code | TypeSafe dokumentiert diese Aufgaben ausdrücklich als Schwächen |
| Eine wechselnde oder unbekannte Taxonomie | GPT oder Claude zur Entdeckung; Klassifikator im Betrieb | Jev muss aus vor dem Request festgelegten Kandidaten wählen |
| Einen Entscheidungs-Funnel mit hohem Volumen | Regeln → Jev → spezialisiertes LLM → Mensch | Günstige Fälle enden früh, unsichere behalten einen Ausweg |
Die restliche Analyse erklärt diese Grenzen. Merken Sie sich vor allem eine Regel: Jev passt, wenn die Unsicherheit semantisch, der Aktionsraum aber endlich ist.
Was Jev tatsächlich ist
TypeSafe AI stellte Jev am 15. September 2026 vor, als erstes öffentliches „System One Model“ des Unternehmens und zunächst im Early Access. TypeSafe beschreibt eine neue Architektur, einen parallelen Sampler und eine Trainingsmethode namens Reinforcement Learning for Calibrated Decisions. Das Unternehmen hat bislang nicht genug technische Details veröffentlicht, damit Außenstehende diese Trainingsaussage reproduzieren könnten. RLCD sollte daher als Produktbeschreibung gelten, nicht als unabhängig etablierte Methode.
Konkreter ist die öffentliche API. Ein Request enthält einen gemeinsamen state und eine oder mehrere typisierte Fragen. Die Dokumentation definiert drei Primitive:
- Choice wählt eine Option aus einer geschlossenen Menge und liefert die vollständige Wahrscheinlichkeitsverteilung plus Konfidenz. Eine Choice-Frage unterstützt bis zu 255 Optionen.
- Score ordnet den Zustand auf zwei bis zehn geordneten, beschriebenen Stufen ein. Der numerische Score ist der wahrscheinlichkeitsgewichtete Mittelwert dieser Stufen.
- Noul bewertet eine Ja-Nein-Aussage und liefert die Wahrscheinlichkeit für „Ja“ zwischen 0 und 1. Ein separates Konfidenzfeld ist unnötig, weil eine Wahrscheinlichkeit beide binären Ergebnisse vollständig beschreibt.
Mehrere Fragen in einem Request werden unabhängig gegen denselben Zustand und laut TypeSafe parallel ausgewertet. Das ist nützlich, wenn ein Workflow mehrere getrennte Urteile über denselben Datensatz benötigt.
Der aktuelle Produktionsalias jev-latest zeigt auf jev-1.13.0. TypeSafes Modellseite nennt am 21. September 2026 diese Betriebsgrenzen:
| Eigenschaft von Jev 1.13 | Aktuell dokumentierter Wert |
|---|---|
| Kontextbudget | 64k Tokens für State und alle Fragen zusammen |
| Budget pro Frage | 32k Tokens für State plus längste Frage |
| Input-Modalitäten | Nur Text; Strings, JSON-Objekte oder Arrays aus Textwerten |
| Veröffentlichte Rate Limits | 250.000 Tokens/s und 1.200 Requests/min; laut TypeSafe im Early Access veränderlich |
| Modellanpassung | Kein Kunden-Fine-Tuning und kein LoRA; Verhalten über State, Instructions und Criteria |
| Am besten unterstützte Sprache | Englisch; andere Sprachen funktionieren, aber nicht gleich genau |
| Datenverarbeitung | Requests werden nicht zum Training genutzt; Zero Data Retention ist eine Enterprise-Option |
Nach dem Tuning von Schwellenwerten sollten Sie jev-1.13.0 statt jev-latest pinnen. Der Alias kann ohne Änderung Ihrer Anwendung auf ein neues Modell wechseln. Das Feld model in der Antwort zeigt, welche Version tatsächlich geantwortet hat.
{ "model": "jev-latest", "state": "Meine Laufschuhe kamen in der falschen Größe an.", "questions": { "department": { "type": "choice", "instructions": "Welches Team soll den Fall bearbeiten?", "criteria": { "returns": "Umtausch, falsche oder beschädigte Artikel", "shipping": "Lieferstatus, Verspätungen, verlorene Pakete", "billing": "Abbuchungen, Rechnungen, Zahlungsprobleme" } }, "needs_human": { "type": "noul", "instructions": "Benötigt diese Anfrage einen menschlichen Agenten?" } }}Das ist keine Chat Completion mit einem geschickten Prompt. Der mögliche Antwortbereich gehört zur Modellschnittstelle.
Der eigentliche Unterschied liegt im Output-Vertrag
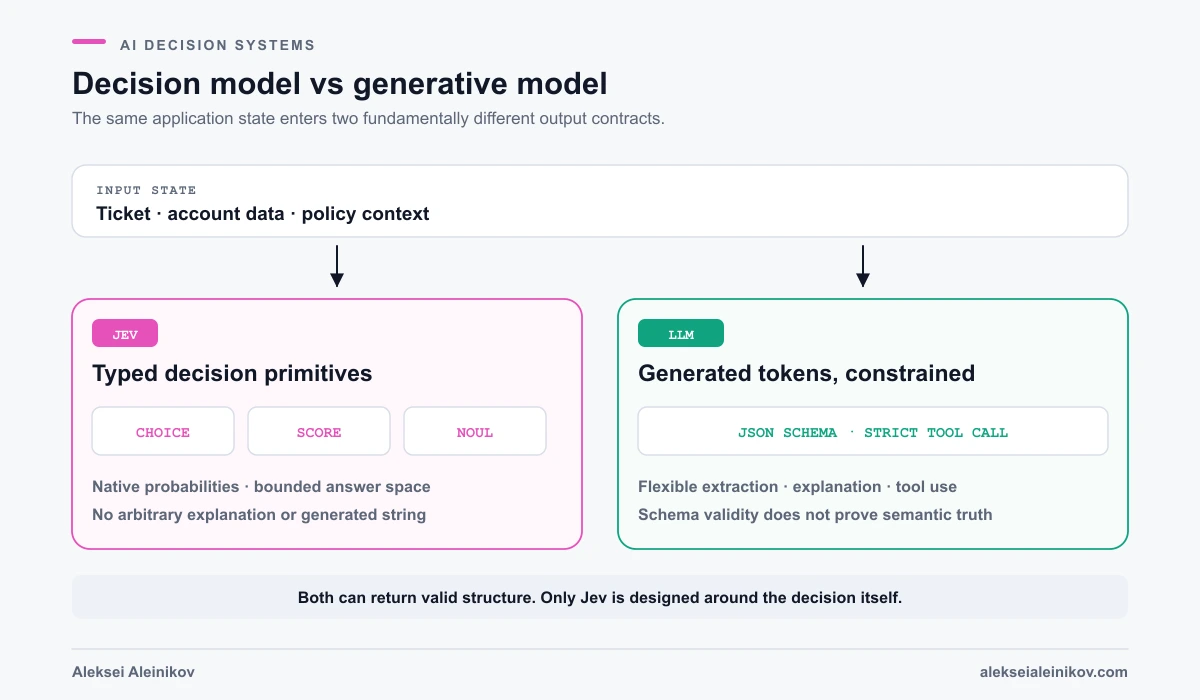
OpenAIs Structured Outputs und Anthropics Structured Outputs verwenden beide Constrained Decoding, um eine unterstützte Teilmenge von JSON Schema zu erzwingen. Sie lösen ein wichtiges Engineering-Problem: Pflichtfelder, Typen und Enum-Werte hängen nicht mehr davon ab, ob das Modell den Prompt befolgt.
Damit ist eine solche Ausgabe valide:
{ "route": "billing", "confidence": 0.91, "reason": "Der Kunde meldet eine doppelte Abbuchung."}Das Schema garantiert jedoch nur, dass route ein erlaubter String und confidence eine Zahl ist. Es beweist weder, dass billing richtig noch dass 0.91 kalibriert ist. OpenAI weist ausdrücklich darauf hin, dass Structured Outputs weiterhin inhaltliche Fehler enthalten und unpassende Eingaben in das vorgegebene Schema zwingen können. Anthropic dokumentiert Ausnahmen bei Ablehnungen, Token-Limits und sogar der Groß- und Kleinschreibung von Enum-Werten.
Jevs Vertrag ist enger. probabilities ist ein natives Ergebnis von Choice oder Score und keine Konfidenzzahl, die das Modell in ein JSON-Feld schreiben soll. Die confidence wird aus der Form dieser Verteilung berechnet. Eine flache Verteilung bedeutet mehrdeutige Optionen, eine scharfe Spitze einen klaren Favoriten.
Auch das beweist keine Korrektheit. TypeSafes Score-Dokumentation sagt es ausdrücklich: Die Konfidenz beschreibt die Antwort des Modells, nicht die Garantie, dass diese richtig ist. Die Kalibrierung muss gegen gelabelte Ergebnisse aus der eigenen Domäne geprüft werden.
Klassifizierung: Jev ist enger, und genau das ist der Vorteil
Für eine feste Taxonomie passt Jevs Choice-Primitiv ungewöhnlich gut:
Ticket + Kontozustand → returns: 0,61 → billing: 0,35 → shipping: 0,04Der Code kann die primäre Route an returns senden, billing wegen der Wahrscheinlichkeit oberhalb eines sekundären Schwellenwertes benachrichtigen und ein Ticket bei niedriger Konfidenz in die manuelle Triage geben. Die Policy bleibt normaler Code.
GPT-5 und Claude können mit einem strikten Schema dasselbe Geschäftsergebnis erzeugen. Gleichzeitig können sie eine Begründung schreiben, beliebige Felder extrahieren, Bilder lesen, Dateien durchsuchen, Tools aufrufen oder das Gespräch fortsetzen. Diese Flexibilität ist wichtig, wenn die Klassifizierung nur ein Schritt in einer größeren kognitiven Aufgabe ist.
Der architektonische Trade-off:
| Frage | Jev | GPT-5 / Claude |
|---|---|---|
| Klassifizierung in feste Klassen | Natives Choice-Primitiv | Enum in JSON Schema oder Tool-Aufruf |
| Binäres Urteil | Native Noul-Wahrscheinlichkeit | Generierter Boolean oder Zahlenwert |
| Geordnete Bewertung | Native Score-Verteilung | Generierter Score im strukturierten Output |
| Freie Erklärung | Nicht unterstützt | Native Stärke |
| Tool-Nutzung | Entscheidung kann eine Funktion wählen; Code führt sie aus | Native Tool Calls und Agent-Loops |
| Beliebige Extraktion | Auf vordefinierte Entscheidungen und Kandidaten begrenzt | Flexible strukturierte Extraktion |
| Unsicherheit | Native Wahrscheinlichkeiten; Kalibrierung bleibt zu prüfen | Meist eigenes Feld oder externe Evaluation |
| Output-Validität | Durch das Primitiv garantiert | Innerhalb des unterstützten Schemas garantiert, mit dokumentierten Randfällen |
Soll das Modell eine noch unbekannte Kategorie entdecken, ist Jev die falsche Abstraktion. Choice kann zwar other enthalten, aber keine fehlende Kategorie erfinden und erklären. Ein Sprachmodell kann zunächst die Taxonomie entdecken; ein begrenztes Modell oder ein klassischer Klassifikator betreibt sie anschließend.
Neun dokumentierte Fehlerbilder von Jev
Die wertvollste TypeSafe-Seite ist nicht die Homepage, sondern die Jaggedness-Liste für Jev 1.13, zuletzt geprüft am 17. September 2026. Das Unternehmen dokumentiert neun Wege, auf denen das eigene Modell scheitern kann:
| Fehlerbild | Was schiefgeht | Reaktion im Produktivsystem |
|---|---|---|
| Wörtliche Auslegung | Implizite Bedingungen, Negationen und unklarer Scope werden anders verstanden als beabsichtigt | Exakte Bedingung nennen und Grenzfälle in Criteria aufnehmen |
| Zählen | Zeichen, Vorkommen und lange Listen werden nicht zuverlässig gezählt | Kandidaten finden und in Code zählen |
| Numerisches Reasoning | Hex-Werte, rohe Zahlenrelationen und genaue Interpolation sind schwach | Zahlen in semantische Klassen umwandeln; Arithmetik in Code behalten |
| Datumsvergleich | Reihenfolge, Zeitfenster, relative Daten und gemischte Formate sind unzuverlässig | Begrenzte Datumsbestandteile extrahieren und echte Datumswerte in Code vergleichen |
| Indirektion | Mehrstufige Fragen und doppelte Verneinungen verlieren Genauigkeit | Direkt auf relevanten State zeigen und Urteil aufteilen |
| Irrelevanter Kontext | Mit nicht relevanten Inhalten sinkt die Genauigkeit | Vor dem Jev-Aufruf Retrieval oder Filterung einsetzen |
| Adversarial Content | Prompt-Injection-ähnlicher Text im State kann die Antwort lenken | State als nicht vertrauenswürdig behandeln, Criteria präzisieren und Angriffe testen |
| Strukturelle Annahmen | Äquivalente Noul- und Choice-Fragen müssen keine arithmetisch kompatiblen Wahrscheinlichkeiten liefern | Jedes Primitiv separat kalibrieren; Invarianten in Code erzwingen |
| Generierung | Choices zu freiem Text zu verketten ist langsam und schwach | Ein generatives Modell verwenden |
Zwei Details sind besonders wichtig. Erstens leidet Jev unter Context Rot: Ein Kontextlimit von 64k bedeutet nicht, dass 64k Tokens für jede Entscheidung nützlich sind. Zweitens sind die Wahrscheinlichkeiten keine algebraischen Bausteine. TypeSafe zeigt eine Frage und ihre Negation mit Wahrscheinlichkeiten, die sich zu 1.19 addieren, und warnt ausdrücklich davor, für getrennte Fragen $P(x)=1-P(\neg x)$ anzunehmen.
Darum wirkt die beste Jev-Architektur bewusst unspektakulär: exakte Fakten in Code vorverarbeiten, nur entscheidungsrelevanten State senden, pro Urteil eine atomare Frage stellen und das Ergebnis gegen Fachlabels validieren.
Routing: Entscheiden und Ausführen trennen
„Routing“ versteckt zwei verschiedene Aufgaben:
- Entscheiden, welche Route zum aktuellen Zustand passt.
- Ausführen, indem ein Service, Modell, eine Queue oder ein menschlicher Workflow aufgerufen wird.
Jev ist für die erste Aufgabe gebaut. GPT-5 und Claude können beide innerhalb eines Agent-Loops übernehmen. Das reduziert möglicherweise Orchestrierungscode, gibt dem Modell aber auch eine größere Aktionsfläche.
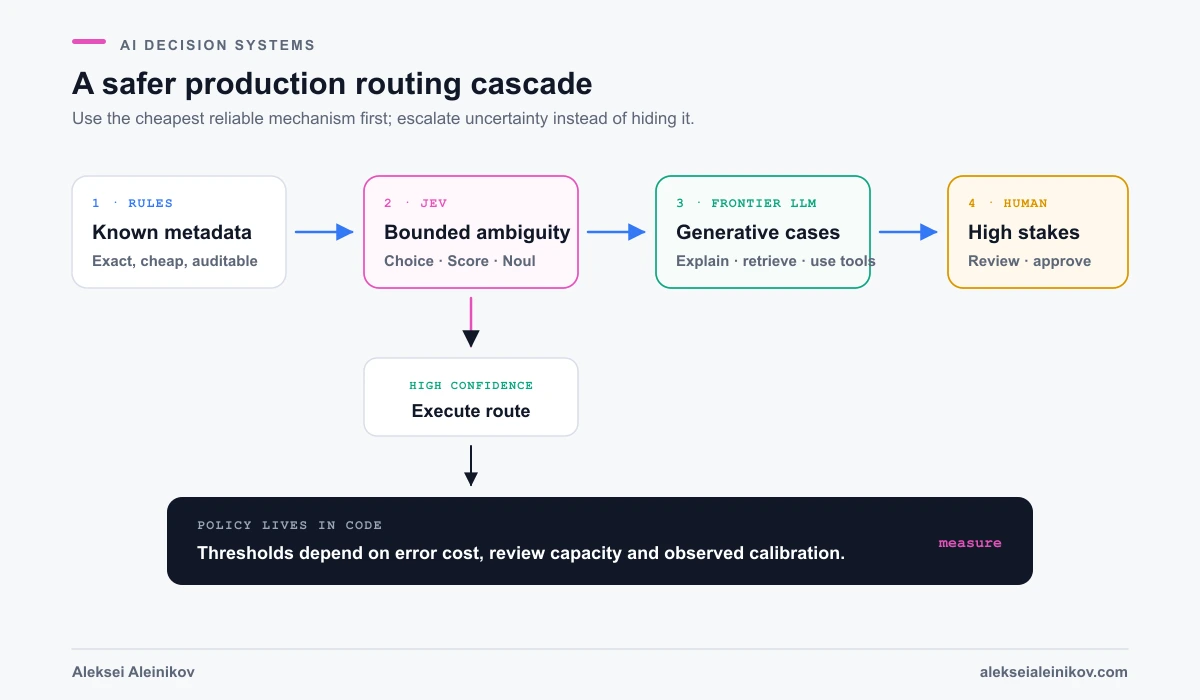
Eine praktische Produktionsroute kann so aussehen:
def route(request):    known = route_from_metadata(request)    if known:        return known
    decision = jev_classify(request)    if decision.confidence >= 0.85:        return decision.choice
    if request.is_high_risk:        return "human_review"
    return route_with_frontier_llm(request)
Die Schwellenwerte sind Beispiele, keine Empfehlungen. Leiten Sie sie aus den Kosten falscher Routen und einem Validierungsdatensatz ab. Ein Artikel zum Passwort-Reset verträgt einen niedrigeren Wert als die Freigabe einer Zahlung.
Dieser Ansatz, ein Modell als begrenzte Komponente zu behandeln, passt auch zum Wechsel von Prompts zu explizitem Laufzeitkontext, den Context Engineering beschreibt. Er unterscheidet sich deutlich davon, einem allgemeinen Agenten den gesamten Loop zu überlassen; GenAI vs. Agentic AI vs. KI-Agenten vs. LLM trennt diese Entwürfe.
Was Preis- und Latenzangaben wirklich aussagen
TypeSafe veröffentlicht auffällige Werte: 0,042 US-Dollar pro Million Input-Tokens, keine gemessene Gebühr für Output-Tokens und 70–500 ms End-to-End-Latenz. Die Startseite wirbt mit 193,6-mal schneller und 444,6-mal günstiger im eigenen Workflow-Vergleich.
Diese Zahlen brauchen drei Kennzeichnungen.
Erstens sind es Messungen und Preise von TypeSafe, keine unabhängigen Ergebnisse. Laut Unternehmen stammen die veröffentlichten Läufe von Laptops an der US-Westküste, wo auch der Dienst aktuell bereitgestellt wird.
Zweitens stammen die großen Verhältniszahlen aus vier firmeneigenen Workflow-Evaluationen. Referenzlabels sind die gemittelten Antworten von GPT-6 Astra und Claude Fable 5.1 bei hohem Thinking. TypeSafe erklärt, dass Mitglieder des eigenen Model-Capabilities-Teams die Workflows erstellt haben, und räumt mögliche Verzerrungen ein. Das Unternehmen bezeichnet die 193,6- und 444,6-fachen Verbesserungen selbst als wahrscheinlich oberes Ende realer Gewinne.
Drittens produzieren die Systeme nicht dasselbe Artefakt. Jev liefert begrenzte Entscheidungen. Ein Frontier-LLM im Vergleich liefert kompatible Entscheidungen über TypeSafes System-One-Adapter, einschließlich Wahrscheinlichkeiten. Dass ein autoregressives Modell mehr Output erzeugt und dadurch mehr Zeit und Geld benötigt, ist erwartbar. Das kann exakt den Kosten Ihrer Anwendung entsprechen, ist aber kein universeller Benchmark für Modellintelligenz.
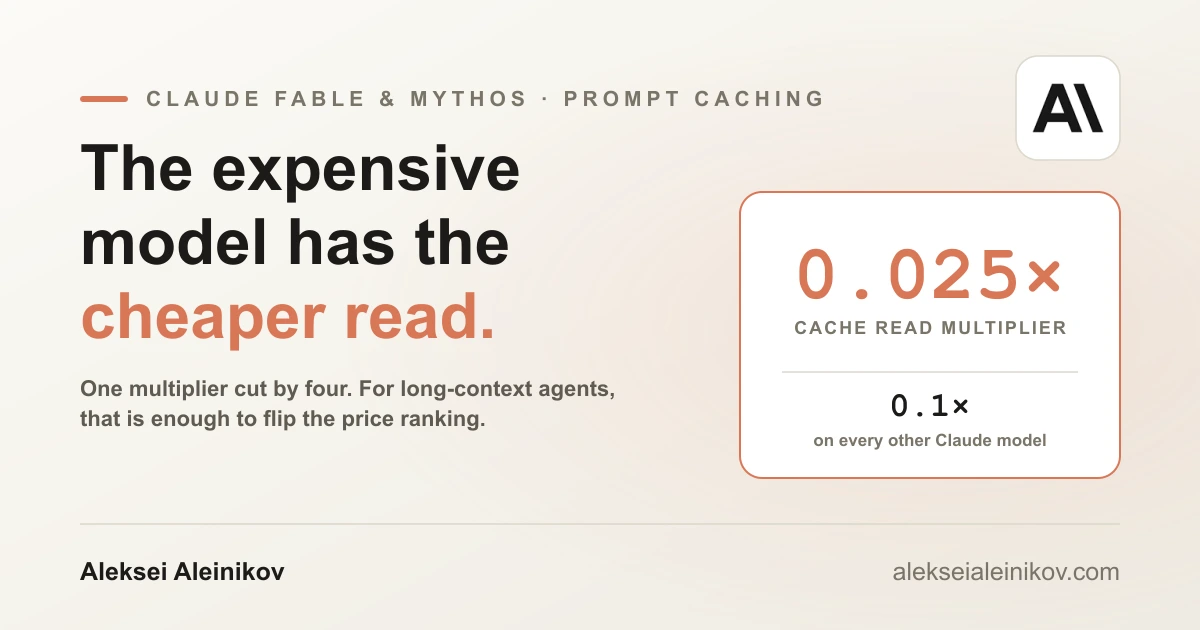
Als stabile Preisreferenz nennt die GPT-5-API-Seite aktuell 1,25 US-Dollar pro Million Input-Tokens und 10 US-Dollar pro Million Output-Tokens bei 400.000 Tokens Kontext. Sie bezeichnet GPT-5 außerdem als vorheriges Modell und empfiehlt GPT-6 Astra für neue Projekte. Anthropics aktuelles Claude Sonnet 5 listet 2 US-Dollar für Input und 10 US-Dollar für Output pro Million Tokens bei einer Million Tokens Kontext; Opus 5 liegt bei 5 und 25 US-Dollar. Das sind Token-Grundpreise, keine End-to-End-Workflow-Kosten.
Der faire Vergleich ist daher der eigene Preis pro akzeptierter Entscheidung:
$$ \text{Kosten pro akzeptierter Entscheidung} = \frac{\text{API-Kosten} + \text{Prüfkosten} + \text{Fehlerkosten}} {\text{automatisch akzeptierte Entscheidungen}} $$
Ein günstiges Modell, das die Hälfte der Fälle zur Prüfung schickt, kann teurer sein als ein hochpreisiges Modell, das sie korrekt löst. Ein selbstsicheres, aber schlecht kalibriertes Modell kann weit mehr kosten als beide.
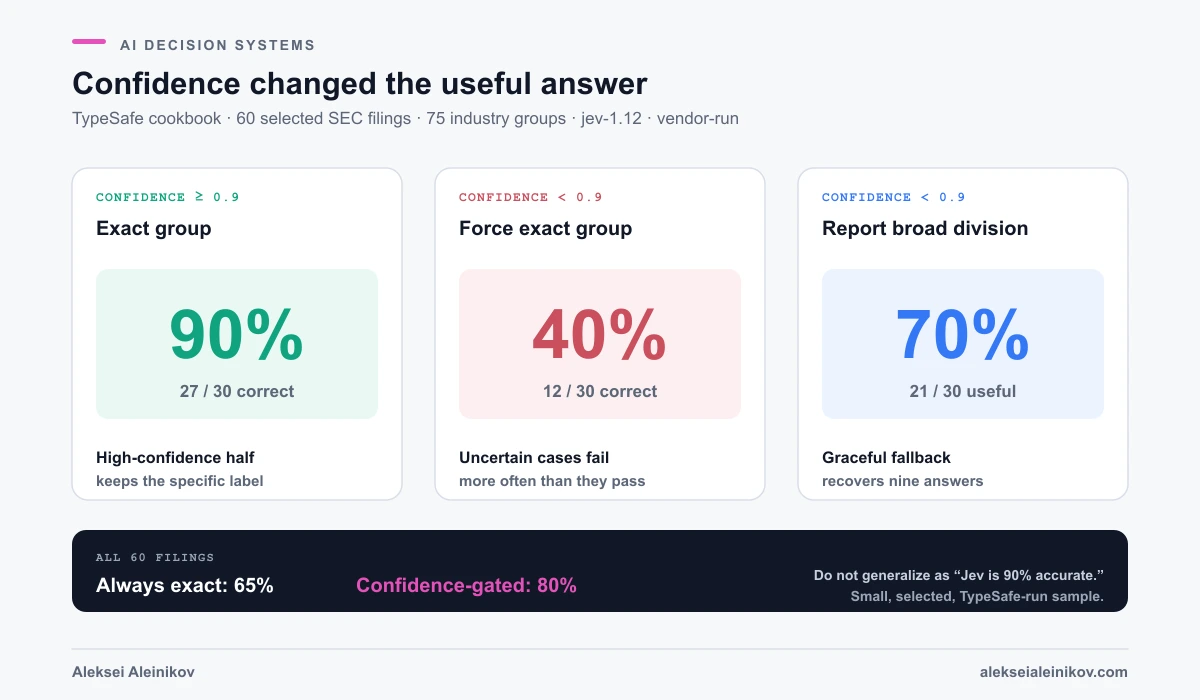
Das nützlichste öffentliche Jev-Ergebnis lautet 90% vs. 40%
TypeSafe hat ein kleineres Ergebnis veröffentlicht, das für die Praxis mehr aussagt als die 444,6-fache Headline. Im Cookbook zur Klassifizierung mit Konfidenz klassifizierte jev-1.12 insgesamt 60 ausgewählte SEC-Jahresberichte in 75 Industriegruppen. Die Dokumente waren 700 bis 2.200 Wörter lang, im Mittel 1.438 Wörter.
Bei einer Konfidenzschwelle von 0.9 teilte sich die Menge exakt in zwei Hälften:
| Policy und Teilmenge | Richtig | Accuracy |
|---|---|---|
| Immer eine von 75 Industriegruppen erzwingen | 39/60 | 65% |
| Konfidenz ≥ 0,9, exakte Gruppe ausgeben | 27/30 | 90% |
| Konfidenz < 0,9, trotzdem exakte Gruppe erzwingen | 12/30 | 40% |
| Konfidenz < 0,9, breitere Division ausgeben | 21/30 | 70% |
| Konfidenz-gesteuertes Ergebnis über alle 60 | 48/60 | 80% |
Das ist ein nützliches Beispiel für Selective Prediction: Konfidenz machte schwierige Beispiele nicht richtig, trennte aber eine deutlich stärkere Teilmenge ab und erlaubte der Anwendung, kontrolliert auf eine gröbere Antwort zurückzufallen.
Auch das ist kein unabhängiger Benchmark. TypeSafe wählte Berichte aus, deren Text den vom Unternehmen selbst gemeldeten SIC-Code stützte, setzte den Schwellenwert 0.9, nutzte nur 60 Dokumente und testete das eigene Modell. Die richtige Schlussfolgerung lautet nicht „Jev hat 90 Prozent Accuracy“, sondern: „Messen Sie Accuracy als Funktion der Coverage und geben Sie unsicheren Fällen eine gröbere oder menschliche Route.“
„Null Halluzinationen“ ist zu breit
TypeSafes enge technische Aussage ist nachvollziehbar: Weil Jev keine beliebigen Strings generieren kann, kann es keine Option außerhalb einer Choice und kein ungültiges JSON zurückgeben. Typfehler sind konstruktiv ausgeschlossen.
Das ohne Einschränkung „null Halluzinationen“ zu nennen, führt in die Irre. Ein Modell kann den vollkommen validen Wert billing liefern, obwohl fraud richtig wäre. Das ist ein semantischer Fehler, auch wenn es kein Typfehler ist.
Eine saubere Begrifflichkeit:
- Schema-Validität: Entspricht der Output dem deklarierten Typ?
- Entscheidungsgenauigkeit: Wurde das erwartete Ergebnis gewählt?
- Kalibrierung: Waren von Antworten mit Wahrscheinlichkeit 0,8 ungefähr 80 Prozent richtig?
- Coverage: Welcher Anteil der Fälle überschritt den Automatisierungsschwellenwert?
- Konsistenz: Erhält derselbe oder ein äquivalenter Zustand eine stabile Antwort?
Jev macht die erste Eigenschaft viel einfacher und liefert nützliche Signale für die nächsten drei. Es beseitigt nicht die Notwendigkeit, sie zu evaluieren.
So führen Sie eine faire Evaluation durch
Beginnen Sie nicht mit einem einzigen polierten Support-Ticket. Erstellen Sie eine eingefrorene Menge echter, anonymisierter Fälle mit Labels, auf die sich die Fachverantwortlichen geeinigt haben.
Messen Sie jeden Kandidaten unter dem Vertrag, den Sie produktiv einsetzen würden:
- Geben Sie jedem System denselben Zustand und dieselben Klassendefinitionen.
- Verwenden Sie für GPT-5 und Claude strikte Structured Outputs statt Regex-Parsing.
- Pinnen Sie Modellversionen, wenn der Anbieter Snapshots unterstützt.
- Erfassen Sie Accuracy, Macro-F1 für unausgeglichene Klassen, p50- und p95-Latenz, Token-Kosten, Ablehnungen und unvollständige Antworten.
- Tragen Sie Accuracy gegen Automation-Coverage bei mehreren Konfidenzschwellen auf.
- Bepreisen Sie menschliche Prüfung und falsche Routen, nicht nur API-Tokens.
- Wiederholen Sie den Test nach Änderungen an Taxonomie oder Prompt. Schemas verhindern ungültige Antworten, nicht Behavioural Drift.
Beantworten Sie vor dem Launch außerdem diese Betriebsfragen:
- Was geschieht bei
429, Timeout, Refusal oder Provider-Ausfall? - Wird bei jeder Entscheidung die exakte Modell-ID geloggt?
- Kann vor Änderungen an Modell, Taxonomie oder Schwellenwerten ein eingefrorener Evaluationssatz wiederholt werden?
- Werden adversariale Strings in nutzergesteuertem State wie Prompt Injections getestet?
- Gibt es für unvollständige Taxonomien eine
other-, Abstain-, Oberklassen- oder Human-Route? - Zeigen Dashboards Accuracy und Automation Coverage nach Klasse, Sprache und Input-Länge?
- Sieht ein Reviewer ursprünglichen State, gewählte Option, Wahrscheinlichkeitsverteilung, Modellversion und Policy-Version?
Für Wahrscheinlichkeiten sollten Sie einen Brier Score oder eine Kalibrierungskurve ergänzen. Für ein binäres Ergebnis gilt:
$$ \text{Brier} = \frac{1}{N}\sum_{i=1}^{N}(p_i-y_i)^2 $$
Niedriger ist besser. Ein System, das 0.9 nur dann ausgibt, wenn es ungefähr neun von zehn Mal richtig liegt, ist für schwellenwertbasierte Automatisierung nützlicher als eines, das jede Antwort mit 0.99 versieht.
Welches Modell sollten Sie wählen?
Wählen Sie Jev, wenn all das zutrifft:
- der Output lässt sich als Choice, Score oder Noul ausdrücken;
- Taxonomie oder Rubrik stehen vor dem Request fest;
- viele enge Urteile bei niedriger Latenz sind nötig;
- Wahrscheinlichkeiten und Konfidenz-Gates gehören zur Produktlogik;
- Early-Access-Risiko und ein junges Ökosystem sind akzeptabel.
Wählen Sie GPT-5 oder ein aktuelles GPT-Modell, wenn die Entscheidung zusätzlich breite Tool-Nutzung, Codeausführung, Retrieval, Bildverständnis, ausführliche Erklärungen oder freie Generierung braucht. OpenAI führt GPT-5 inzwischen als vorheriges Modell. Neue Evaluationen sollten daher den empfohlenen Nachfolger einbeziehen, statt die Architektur am bekannten Namen festzumachen.
Wählen Sie Claude, wenn der umgebende Workflow von langem Kontext, Dokumentverständnis, nuancierter Sprache, Erklärungen oder einem Agent-Loop mit strikten Tool-Eingaben profitiert. Wählen Sie eine konkrete Claude-Stufe; „Claude“ ist eine Familie und kein einzelner Preis- oder Latenzpunkt. Die neuere Preisaufteilung behandelt Claude Fable und Mythos.
Wählen Sie einen klassischen Klassifikator, wenn ausreichend stabile gelabelte Daten vorhanden sind, lokale Inference oder vollständige Modellkontrolle nötig ist und die Taxonomie sich langsam ändert. Jev macht Supervised Learning nicht überflüssig.
Fazit
Jev ist interessant, weil es die Annahme zurückweist, dass jede intelligente Operation Sprache erzeugen muss. Für Klassifizierung und Routing kann ein Modell, das nur begrenzte Entscheidungen und Wahrscheinlichkeiten liefert, eine sauberere Komponente sein als ein allgemeines LLM, das durch ein JSON-Schema gezwungen wird.
Ein sauberer Vertrag ist jedoch kein nachweislich besseres Modell. TypeSafes Output-Garantien sind real. Latenz, Preis und Benchmark-Ergebnisse sind vielversprechende Herstellerdaten. Semantische Genauigkeit und Kalibrierung für den eigenen Workload bleiben nachzuweisen.
Der wahrscheinliche Gewinner ist nicht Jev oder GPT oder Claude. Es ist eine Architektur, die jede Art von Intelligenz dort einsetzt, wo sie passt: Regeln für Gewissheit, ein Entscheidungsmodell für begrenzte Mehrdeutigkeit, ein Sprachmodell für generative Komplexität und einen Menschen für Konsequenzen, die keine Evaluation wegpreisen kann.
Aus der Community
Diskussion im Fediverse
Antworten von Mastodon und Bluesky — direkt aus dem offenen Netz, ohne Tracking.
Antworten werden geladen …
Noch keine Antworten. Starte die Diskussion:
Antworten konnten gerade nicht geladen werden.