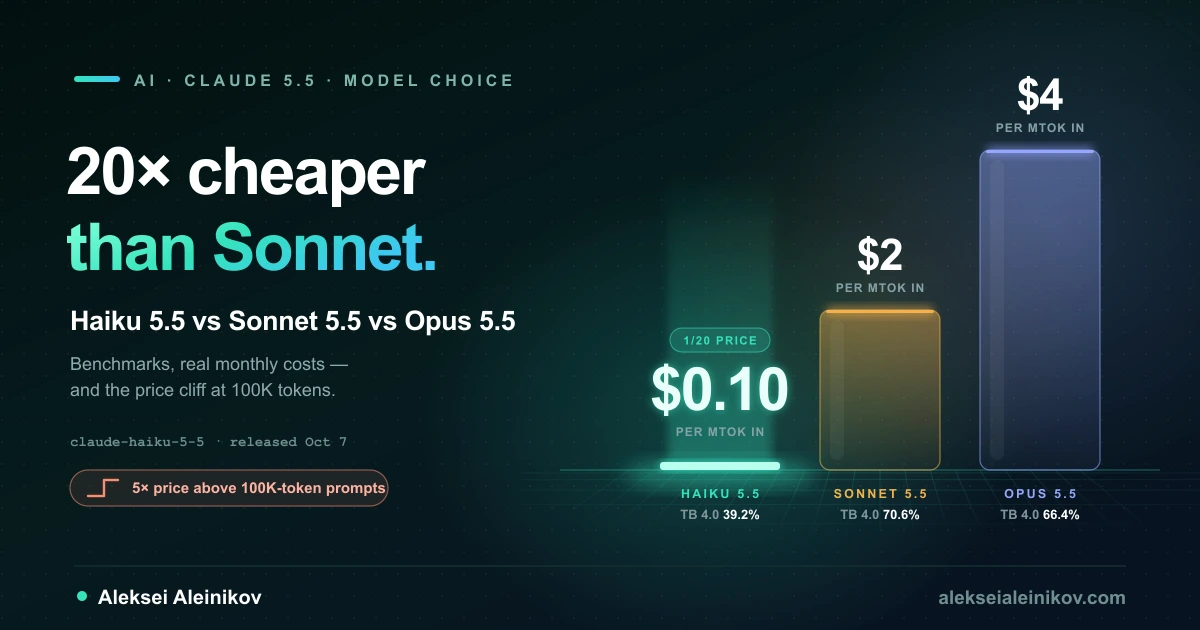
Anthropic hat Claude Haiku 5.5 am 7. Oktober veröffentlicht, und zwei Zahlen aus dem Launch-Beitrag werden die meiste Aufmerksamkeit bekommen: ein Preis und ein Sprung. Der Preis: 0,10 $ pro Million Input-Tokens und 0,50 $ pro Million Output-Tokens, ein Zwanzigstel von Sonnet 5.5. Der Sprung: Bei Terminal-Bench 4.0, einem Benchmark für agentisches Coding, kam Haiku 4.5 auf 0,0 %, Haiku 5.5 auf 39,2 %.
Die naheliegende Lesart lautet „ein billiges Sonnet“. Das ist es nicht, und wer es so behandelt, zahlt zu viel oder liefert schlechtere Ergebnisse. Dieser Leitfaden vergleicht Haiku 5.5 mit Sonnet 5.5 und Opus 5.5 anhand von Anthropics veröffentlichten Zahlen, rechnet aus, was drei reale Workloads pro Monat auf jedem Modell kosten, und erklärt die eine Preisregel, die nur Haiku hat: Ab 100.000 Tokens kostet dieselbe Anfrage das Fünffache.
Haiku 5.5 vs. Sonnet 5.5 vs. Opus 5.5 auf einen Blick
Die Angaben stammen von der Modellseite zu Haiku 5.5, der Modellübersicht und der Preisseite.
| Claude Haiku 5.5 | Claude Sonnet 5.5 | Claude Opus 5.5 | |
|---|---|---|---|
| API-Modell-ID | claude-haiku-5-5 |
claude-sonnet-5-5 |
claude-opus-5-5 |
| Input / Output pro Million Tokens | 0,10 $ / 0,50 $ (Prompts ≤ 100K) | 2 $ / 10 $ | 4 $ / 20 $ |
| Prompts über 100K Tokens | 0,50 $ / 2,50 $ | unverändert | unverändert |
| Cache Read pro Million Tokens | 0,01 $ (0,05 $ über 100K) | 0,10 $ | 0,20 $ |
| Batch API Input / Output | 0,05 $ / 0,25 $ | 1 $ / 5 $ | 2 $ / 10 $ |
| Kontextfenster / max. Output | 1M / 128K | 1M / 128K | 1M / 128K |
| Thinking | Adaptiv; abschaltbar | Adaptiv; Minimum between_tools |
Adaptiv, immer aktiv |
| Standard-Effort auf der Claude API | medium |
high |
medium |
| Relative Latenz | Am schnellsten | Schnell | Mittel |
| Wissensstand | Juni 2026 | Juni 2026 | Juni 2026 |
| Anthropics eigene Beschreibung | „Für hochvolumige, latenzkritische Aufgaben wie Klassifizierung, Extraktion und Routing“ | „Die beste Kombination aus Geschwindigkeit und Intelligenz“ | „Für langlaufendes agentisches Coding und Wissensarbeit“ |
Drei Zeilen verdienen einen zweiten Blick:
- Cache Reads kosten bei Haiku 10 % des Inputs, bei Sonnet und Opus 5 %. Am Launch-Tag von Haiku 5.5 hat Anthropic außerdem den Cache-Read-Preis von Sonnet 5.5 auf 0,10 $ halbiert, was Sonnet 5.5 laut Anthropic bei den meisten agentischen Aufgaben rund 20 % günstiger macht. Haikus Cache Read ist trotzdem zehnmal billiger als der von Sonnet. Warum Cache Reads Agent-Rechnungen dominieren, steht in der Cache-Read-Regel bei den Preisen von Fable und Mythos.
- Nur Haiku 5.5 wird nach Prompt-Länge abgerechnet. Die anderen beiden verlangen von 9K bis 900K Tokens denselben Preis pro Token. Dazu unten mehr, denn das verändert, wie Sie Pipelines für lange Dokumente bauen sollten.
- Der Standard-Effort unterscheidet sich wieder. Haiku und Opus starten mit
medium, Sonnet mithigh. Setzen Sieoutput_config.effortin jedem A/B-Test explizit.
Haiku 5.5 gibt es auf der Claude API, Amazon Bedrock (anthropic.claude-haiku-5-5), Google Cloud, Microsoft Foundry und Claude Platform on AWS. Zusätzlich führt Anthropic monatliche API-Guthaben für Max- und Team-Abos ein – 100 $ bei Max 5x, 200 $ bei Max 20x und bis zu 500 $ gepoolt bei Team, nutzbar für jedes Modell. Das reicht, um jedes Muster aus diesem Artikel als Prototyp zu testen, bevor echter Traffic darauf läuft.
Die Benchmarks: ein riesiger Sprung und eine klare Decke
Das sind die Zahlen aus Anthropics Launch-Beitrag. Die Tabelle dort vergleicht Haiku 5.5 mit Haiku 4.5, OpenAIs GPT-6 Luna und Sonnet 5.5. OSWorld bezieht sich hier auf das Offline-Subset und ist daher nicht direkt mit den 80,1 % vergleichbar, die Sonnet 5.5 im eigenen Launch-Beitrag auf dem vollständigen Benchmark erreichte.
| Benchmark | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| Terminal-Bench 4.0 (agentisches Coding im Terminal) | 39,2 % | 0,0 % | 16,4 % | 70,6 % |
| FrontierCode 1.1 Main (mergebare Änderungen) | 46,4 % | – | 42,4 % | 52,1 % auf xhigh |
| OSWorld 2.1, Offline-Subset (Computer Use) | 72,4 % | 15,7 % | 48,9 % | 83,9 % |
| GDPval-AA v2.1 (Wissensarbeit, Elo) | 1620 | 735 | 1437 | 1840 |
| AA-Briefcase v1.1 (Wissensarbeit, Elo) | 1578 | 614 | 1336 | 1824 |
| Humanity’s Last Exam, ohne / mit Tools | 45,9 % / 57,4 % | 10,2 % / 18,7 % | – | 56,9 % / 64,5 % |
| Chartography, ohne Tools (visuelles Reasoning) | 46,4 % | 6,4 % | 29,1 % | 61,6 % |
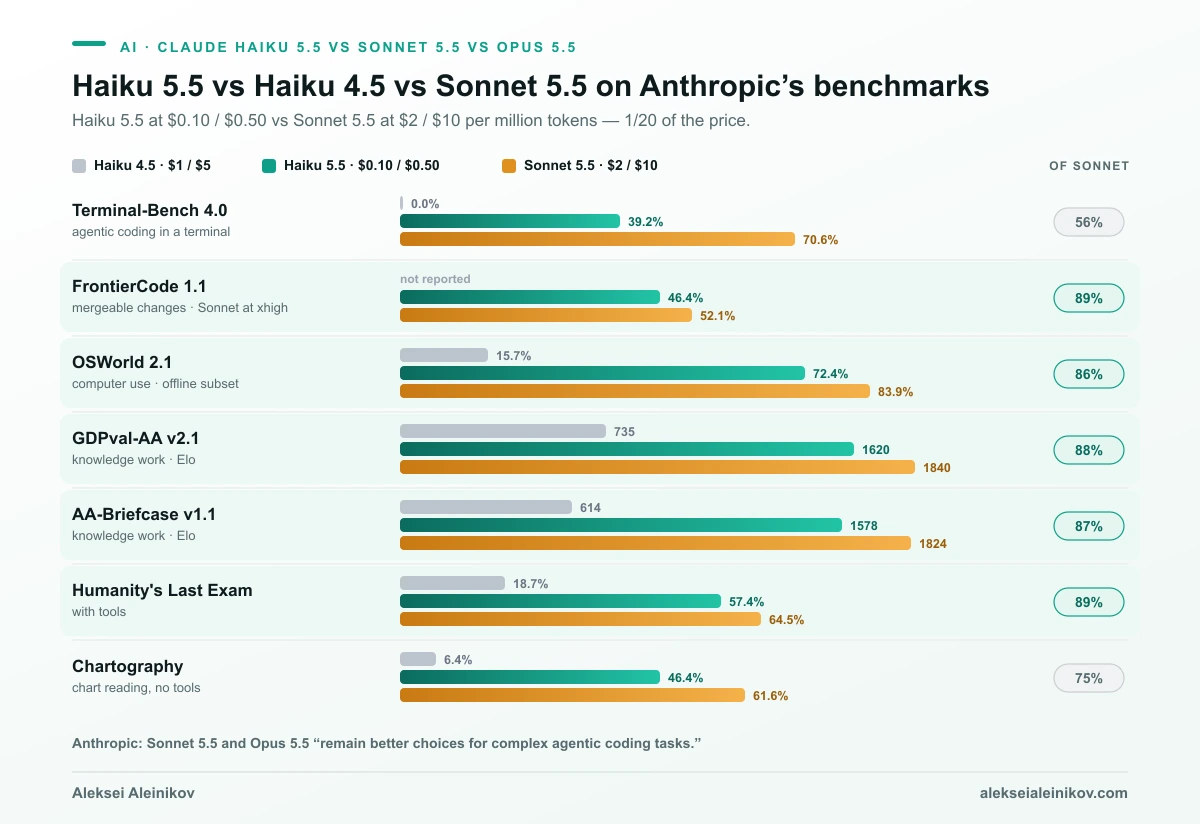
Drei Dinge lassen sich aus der Tabelle ablesen:
- Computer Use ist die Überraschung. 72,4 % bei OSWorld sind 86 % von Sonnets Wert zu 5 % seines Preises, und Haiku 5.5 ist bei Standardgeschwindigkeit Anthropics schnellstes Modell. Deshalb positioniert Anthropic es für Live-Kundensupport und Browser Use, und deshalb unterstützt das neue Browser-Use-Tool Haiku 5.5 (Haiku 4.5 nicht). Das Toolset fügt jeder Anfrage rund 6.600 Input-Tokens hinzu – 0,00066 $ bei Haiku, 0,0132 $ bei Sonnet.
- Bei langem agentischem Coding zeigt sich die Decke. 39,2 % gegenüber 70,6 % bei Terminal-Bench sind etwa die Hälfte von Sonnets Wert. Anthropic sagt das offen: Sonnet 5.5 und Opus 5.5 bleiben für komplexes agentisches Coding die bessere Wahl, Haiku 5.5 eignet sich für eng umrissene Aufgaben wie Compaction, Zusammenfassungen oder Subagent-Arbeit. FrontierCode, das abgegrenzte, mergebare Änderungen belohnt, liegt deutlich näher: 46,4 % gegenüber 52,1 %.
- Die eigentliche Geschichte ist der Sprung gegenüber Haiku 4.5. GDPval-AA hat sich mehr als verdoppelt, OSWorld stieg von 15,7 % auf 72,4 %. Das Kontextfenster wächst von 200K auf 1M Tokens, der maximale Output von 64K auf 128K, und es ist das erste Haiku mit einstellbarem Effort. Wer heute Haiku 4.5 einsetzt, bekommt ein Upgrade – offen ist nur, wie viel Sonnet-Traffic mit nach unten wandern kann.
Hinter dem Tempo-Versprechen steht eine erste Kundenzahl: Asana hat Haiku 5.5 mit seinem Agenten AI Teammates getestet und gegenüber dem aktuell eingesetzten Modell mehr als 30 % geringere Latenz bis zum Abschluss einer Aufgabe und bis zu 2,5-mal schnellere Inferenz pro Agent-Turn gemessen.
Wie immer gilt: Das sind Herstellerangaben. Nutzen Sie sie als Karte dafür, wo Sie eigene Evals fahren, nicht als Ersatz dafür.
Die 100K-Stufe: Haikus Preis hängt von der Prompt-Länge ab
Die Preisseite sagt es deutlich: Claude 4.6 und neuere Modelle berechnen über das gesamte 1M-Kontextfenster denselben Preis – außer Claude Haiku 5.5, das nach Prompt-Länge abgerechnet wird: Ein Prompt mit mehr als 100.000 Tokens zahlt höhere Preise.
| Haiku-5.5-Preis pro Million Tokens | Prompt ≤ 100K Tokens | Prompt > 100K Tokens |
|---|---|---|
| Input | 0,10 $ | 0,50 $ |
| Output | 0,50 $ | 2,50 $ |
| 5-Minuten-Cache-Write | 0,125 $ | 0,625 $ |
| 1-Stunden-Cache-Write | 0,20 $ | 1,00 $ |
| Cache Read | 0,01 $ | 0,05 $ |
| Batch Input / Output | 0,05 $ / 0,25 $ | 0,25 $ / 1,25 $ |
Jeder Preis steigt um das Fünffache – auch der Output. Ein Prompt mit 99K Tokens kostet rund 0,0099 $ Input, einer mit 101K Tokens rund 0,0505 $. Laut Anthropic lagen etwa 90 % der Haiku-4.5-Anfragen unter 100K. Deshalb nennt Anthropic im Schnitt „rund 75 % weniger“ statt der 90 %, die der Listenpreis für kurze Prompts nahelegt. Der andere Teil der Differenz ist der Tokenizer: Haiku 5.5 nutzt den neueren Tokenizer, der mit Claude Opus 4.7 eingeführt wurde, und derselbe Text ergibt rund 30 % mehr Tokens als bei Haiku 4.5. Nach der Faustregel der Doku von etwa 555.000 englischen Wörtern pro Million Tokens entsprechen 100K Tokens rund 55.000 Wörtern Englisch; deutscher Text braucht pro Wort meist mehr Tokens.
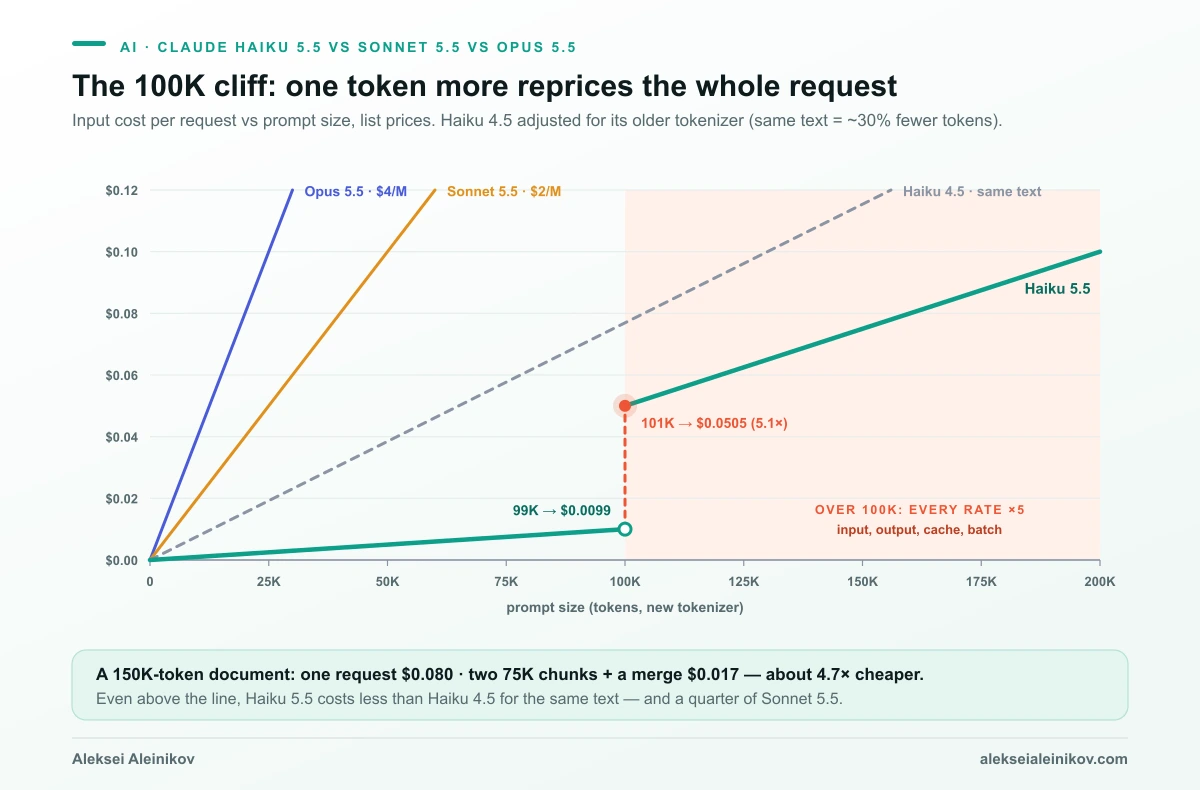
Was das in der Praxis bedeutet:
- Pipelines für lange Dokumente sollten unter 100K chunken. Zählen Sie den gesamten Prompt – System-Prompt, Anweisungen, Tool-Definitionen und Dokument –, nicht nur das Dokument. Allein das Browser-Toolset bringt rund 6.600 Tokens mit.
- Zählen Sie Tokens mit dem neuen Modell. Ein Prompt, den Sie bei Haiku 4.5 mit 85K gemessen haben, liegt bei Haiku 5.5 bei rund 110K. Nutzen Sie den Token-Counting-Endpunkt mit
model: "claude-haiku-5-5". - Langer Kontext bleibt günstig – nur nicht 20× günstig. Oberhalb der Grenze kostet Haiku 5.5 0,50 $ / 2,50 $, immer noch ein Viertel von Sonnet 5.5.
Was drei reale Workloads pro Monat kosten
Listenpreise zählen erst über einen Workload. Hier sind drei typische, gerechnet zu Listenpreisen auf der Claude API. Die Token-Zahlen sind illustrativ und auf den neueren Tokenizer bezogen; für Haiku 4.5 habe ich sie durch 1,3 geteilt, um seinen älteren Tokenizer zu berücksichtigen. Ihr Mix wird anders aussehen, die Verhältnisse bleiben.
1. Eine Million Support-Tickets klassifizieren. Ein gecachter System-Prompt mit 2.000 Tokens und den Kategoriedefinitionen, ein Ticket mit 400 Tokens und eine Antwort mit 30 Tokens über einen erzwungenen Tool-Aufruf – der bei Haiku 5.5 keinen Thinking-Block liefert.
| Modell | Cache Reads | Input | Output | Pro Monat |
|---|---|---|---|---|
| Haiku 5.5 | 20 $ | 40 $ | 15 $ | 75 $ |
| Haiku 5.5, Batch API | 10 $ | 20 $ | 7,50 $ | 37,50 $ |
| Haiku 4.5 (Prompt zu kurz zum Cachen) | – | 1.846 $ | 115 $ | 1.962 $ |
| Sonnet 5.5 | 200 $ | 800 $ | 300 $ | 1.300 $ |
| Opus 5.5 | 400 $ | 1.600 $ | 600 $ | 2.600 $ |
In dieser Tabelle stecken zwei Details. Erstens kann Haiku 4.5 diesen Prompt gar nicht cachen: Sein minimaler cachebarer Präfix liegt bei 4.096 Tokens, Haiku 5.5, Sonnet 5.5 und Opus 5.5 cachen ab 512. Den Haiku-4.5-Prompt über das Minimum aufzufüllen, brächte ihn auf rund 833 $ – immer noch das 11-Fache der Haiku-5.5-Rechnung. Zweitens schönt die Tabelle Sonnet und Opus: Sonnet 5.5 lehnt ein erzwungenes tool_choice ab, und Opus 5.5 denkt immer, beide würden also zusätzliche Thinking-Tokens als Output abrechnen. Trotzdem ist Haiku 5.5 hier 17-mal günstiger als Sonnet. In der Batch API sind Cache-Treffer nicht garantiert, betrachten Sie diese Zeile also als Untergrenze. Ob ein Frontier-Modell für Klassifizierung überhaupt das richtige Werkzeug ist, habe ich in Jev vs. GPT-5 und Claude für Klassifizierung und Routing untersucht.
2. 10.000 lange Dokumente zusammenfassen. Jedes Dokument hat 150K Tokens, die Zusammenfassung 2K Tokens.
| Ansatz | Pro Dokument | Pro Monat |
|---|---|---|
| Haiku 5.5, eine Anfrage (über 100K) | 0,0800 $ | 800 $ |
| Haiku 5.5, zwei Chunks à 75K + Merge-Anfrage | 0,0172 $ | 172 $ |
| Haiku 4.5, eine Anfrage | 0,1231 $ | 1.231 $ |
| Sonnet 5.5, eine Anfrage | 0,32 $ | 3.200 $ |
| Opus 5.5, eine Anfrage | 0,64 $ | 6.400 $ |
Chunking unterhalb der Stufe macht denselben Job etwa 4,7-mal günstiger. Der Preis dafür: Kein einzelner Aufruf sieht das ganze Dokument – für Zusammenfassungen und Extraktion in Ordnung, für Fragen, die Reasoning über das ganze Dokument brauchen, falsch.
3. Tausend Agent-Aufgaben mit Subagents. Pro Aufgabe liest ein Orchestrator 40K Tokens und schreibt 4K, um zu planen und zusammenzuführen; danach lesen 20 Subagents je 30K Tokens Code und schreiben je 1,5K, Thinking inklusive. Der Orchestrator ist in jeder Zeile Opus 5.5, nur die Subagents wechseln.
| Subagent-Modell | Subagents pro Aufgabe | Aufgabe gesamt | Pro Monat |
|---|---|---|---|
| Opus 5.5 | 3,00 $ | 3,24 $ | 3.240 $ |
| Sonnet 5.5 | 1,50 $ | 1,74 $ | 1.740 $ |
| Haiku 5.5 | 0,075 $ | 0,315 $ | 315 $ |
Zehnmal günstiger als reines Opus – sofern die Teilaufgaben eng genug geschnitten sind für ein Modell, das bei Terminal-Bench 39,2 % erreicht. Diese Bedingung ist das eigentliche Designproblem, und darum geht es im nächsten Abschnitt.
Opus plant, Haiku führt aus – ohne das Reasoning zu verlieren
Das Muster, das Anthropic mit diesem Release verkauft, ist ein größeres Modell, das plant und Teilaufgaben an viele parallele Haiku-5.5-Subagents verteilt. Seit Claude Fable 5.1 schränkt Anthropic ein, welche Modelle das Preserved Thinking anderer Modelle lesen dürfen – vor allem als Schutz gegen Distillation. Wie Sie Modelle verdrahten, ist deshalb wichtig:
- Thinking fließt von Haiku 5.5 nach oben. Auf der Claude API und Google Cloud lesen Sonnet 5.5 und Opus 5.5 die Thinking-Blöcke von Haiku 5.5. Eine Konversation, die günstig auf Haiku startet und zu Sonnet oder Opus eskaliert, behält ihr Reasoning. Auf anderen Plattformen sieht das größere Modell nur Haikus Text und Tool-Aufrufe.
- Der Weg zurück nach unten verwirft das Reasoning. Laut Doku liest nur Opus 5.5 das Thinking von Sonnet 5.5, und das Thinking von Opus 5.5 lesen nur Fable 5.1 und Mythos 5.1. Ein Turn, der zurück zu Haiku geroutet wird, läuft ohne das Reasoning des größeren Modells – still, mit HTTP 200, genau wie bei der Routing-Falle zwischen Sonnet und Opus.
- Thinking ist an das Konto gebunden. Die Thinking-Blöcke von Haiku 5.5 funktionieren nur in dem Konto, das sie erzeugt hat, oder in einem damit verknüpften. Ein gemeinsamer Konversationsspeicher, der Sessions über den Schlüssel eines anderen Kunden abspielt, verliert sie.
- Der Verlauf muss append-only bleiben. Bei Konten, die am oder nach dem 31. August 2026 angelegt wurden, liefert jede Änderung an
system,toolsoder früheren Nachrichten vor einem Haiku-5.5-Thinking-Block einen 400-Fehler.
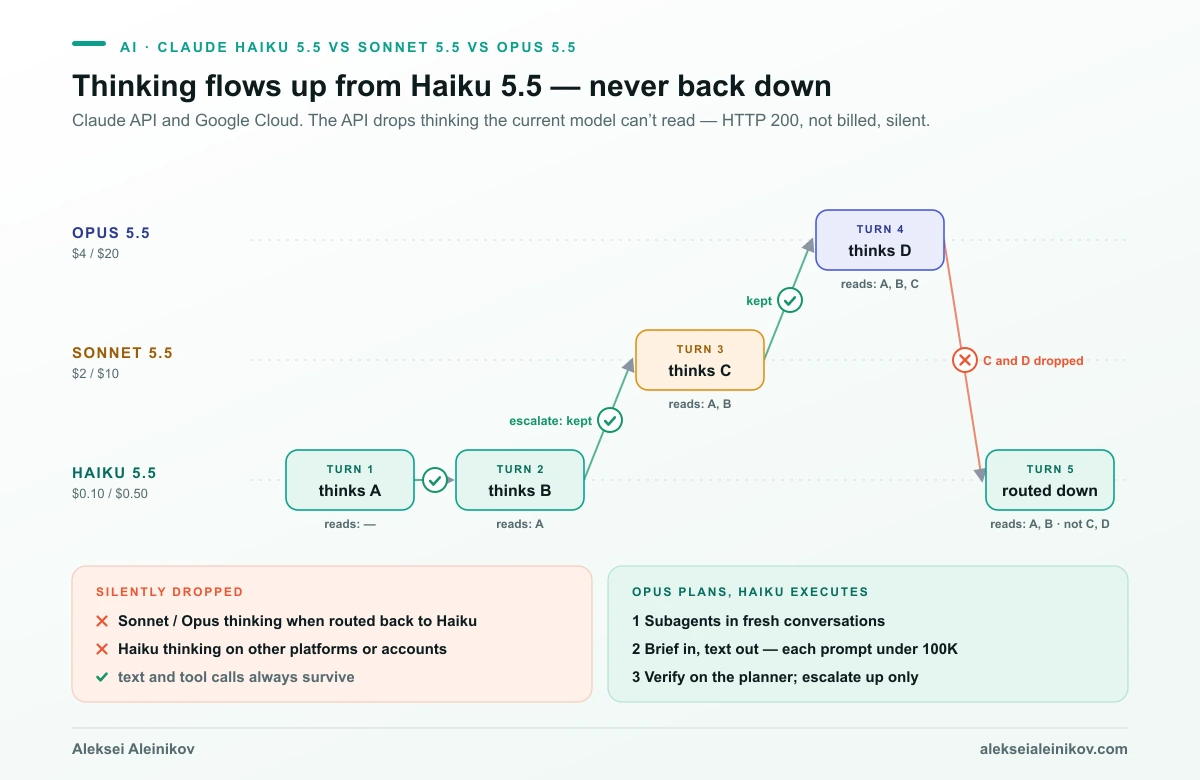
Das Subagent-Muster umgeht all das, weil jeder Subagent eine frische Konversation ist: Der Orchestrator schreibt ein Task-Briefing, der Subagent arbeitet es ab, das Ergebnis kommt als Text zurück. Nichts wird modellübergreifend erneut abgespielt, also geht nichts verloren. Was tatsächlich darüber entscheidet, ob es funktioniert:
- Briefen Sie wie einen Junior-Engineer. Eingaben, exaktes Ausgabeformat, Abnahmekriterien und was nicht angefasst werden darf. Bei FrontierCode – abgegrenzte, mergebare Änderungen – kommt Haiku 5.5 Sonnet am nächsten.
- Halten Sie den Prompt jedes Subagents unter 100K. Zwanzig Subagents über der Grenze kosten jeweils das Fünffache.
- Prüfen Sie im Orchestrator, nicht im Subagent. Lassen Sie den Planer Ergebnisse kontrollieren und neu vergeben, statt dass sich ein Subagent selbst abnimmt.
Wenn Sie ohnehin mit einem Coding-Agent arbeiten, ist das dieselbe Idee wie dessen eigene Subagents; wie Claude Code, Codex und opencode diese Arbeit strukturieren, steht in KI-Coding-Agents: Claude Code vs. Codex vs. opencode.
Migration von Haiku 4.5: Was bricht
Die Launch-Kommunikation nennt Haiku 5.5 für die meisten Integrationen einen Drop-in-Ersatz. Der Migrationsleitfaden ist präziser – diese Dinge liefern Fehler:
| Was Sie heute an Haiku 4.5 senden | Bei Haiku 5.5 | Lösung |
|---|---|---|
claude-haiku-4-5 / claude-haiku-4-5-20251001 |
falsches Modell | claude-haiku-5-5 (ohne Datumssuffix, kein separater Alias) |
thinking: {"type": "enabled", "budget_tokens": N} |
400-Fehler | {"type": "adaptive"} plus output_config.effort |
temperature, top_p oder top_k abweichend vom Standard |
400-Fehler | Weglassen; über den Prompt steuern |
| Ein abschließender Assistant-Turn als Prefill | 400-Fehler | Mit einem User-Turn enden; Format über Structured Outputs oder Tools |
computer_20250124 auf der Claude API oder Google Cloud |
400-Fehler | computer_toolset_20260801 |
| Frühere Turns bearbeiten und Thinking zurücksenden | 400 bei Konten ab dem 31. August 2026 | Verlauf append-only halten |
Und Änderungen, die keine Anfrage scheitern lassen, aber Ergebnisse oder Rechnung verändern:
- Antworten können mit Thinking-Blöcken beginnen. Adaptives Thinking ist standardmäßig aktiv. Code, der
content[0].textliest, bricht; wählen Sie Blöcke nachtype. - Thinking zählt zu
max_tokens. Ein kleines Limit, das für Haiku 4.5 abgestimmt war, kann nach dem Thinking-Block ganz ohne Text enden. - Der Thinking-Text ist standardmäßig leer. Haiku 4.5 lieferte zusammengefasstes Thinking; Haiku 5.5 liefert nur eine Signatur, außer Sie setzen
display: "summarized". - Derselbe Text ergibt rund 30 % mehr Tokens. Prompts neu zählen, Budgets neu rechnen – und die 100K-Grenze erneut prüfen.
- Kein Priority Tier. Wer bei Haiku 4.5 eine Priority-Tier-Zusage hat, muss die Kapazität separat planen.
Eine minimale Klassifizierungsanfrage, die auf Haiku 5.5 so funktioniert:
response = client.messages.create(    model="claude-haiku-5-5",    max_tokens=1024,    output_config={"effort": "low"},          # für nicht erzwungene Aufrufe; ein erzwungener Tool-Aufruf überspringt Thinking    system=[{        "type": "text",        "text": CATEGORY_RULES,               # zusammen mit dem Ticket unter 100K halten        "cache_control": {"type": "ephemeral"},  # Breakpoint auf dem statischen Teil, nicht dem Ticket    }],    tools=[classify_tool],                    # input_schema mit Enum der Kategorien    tool_choice={"type": "tool", "name": "classify"},  # erzwungen: kein Thinking-Block    messages=[{"role": "user", "content": ticket_text}],  # kein Assistant-Prefill)
if response.stop_reason == "refusal":         # kein serverseitiger Fallback bei Haiku 5.5    route_to_human(ticket_text)else:    label = next(b.input for b in response.content if b.type == "tool_use")
Ein Caching-Detail, das still Geld kostet: Nutzen Sie hier kein automatisches Caching auf oberster Ebene. Es setzt den Breakpoint auf den letzten Block – das Ticket, das sich bei jeder Anfrage ändert –, und der Cache trifft nie. Markieren Sie stattdessen den statischen System-Block und halten Sie tools, tool_choice und effort über alle Anfragen gleich, denn Änderungen daran invalidieren den Cache.
Am schnellsten durch eine echte Codebasis kommen Sie mit dem mitgelieferten Claude-API-Skill in Claude Code:
/claude-api migrate this project to claude-haiku-5-5Refusals ohne Fallback
Haiku 5.5 bringt Schutzmechanismen für Cyber und Biologie mit. Anthropic beschreibt die Cyber-Schutzmechanismen als strenger als bei Haiku 4.5, aber lockerer als bei anderen aktuellen Modellen: Sie erlauben mehr defensive Aufgaben als bei Sonnet 5.5 und blockieren weiterhin Penetrationstests und andere Techniken, die eher von Angreifern genutzt werden. Die Biologie-Schutzmechanismen entsprechen Sonnet 5, Sonnet 5.5 und Opus 5.
Für Engineering-Teams zählt die Verdrahtung: Eine abgelehnte Anfrage liefert stop_reason: "refusal", und es gibt keinen serverseitigen Fallback – die Arbeit läuft nicht auf einem anderen Modell weiter. Eine Pipeline, die eine Million Einträge verarbeitet, braucht dafür einen expliziten Zweig. Teams mit autorisierter offensiver Sicherheitsarbeit können sich für das Cyber Verification Program bewerben, um weniger Blockierungen zu bekommen.
Welches Modell wofür?
- Haiku 5.5 auf
low– Klassifizierung, Routing, Extraktion, Tagging, Moderations-Vorfilter, Compaction und erste Durchsicht von Dokumenten. Erzwingen Sie den Tool-Aufruf, wenn die Ausgabe ein Label ist. Nutzen Sie die Batch API, wann immer das Ergebnis nicht in Echtzeit gebraucht wird. - Haiku 5.5 auf
medium– Live-Kundensupport, In-App-Assistenten und Browser Use, wo Geschwindigkeit am meisten zählt und die Aufgabe klar definiert ist. - Haiku 5.5 als Subagent – abgegrenzte Coding- und Recherche-Teilaufgaben unter einem Planer auf Opus 5.5 oder Sonnet 5.5, jeweils in einer frischen Konversation unter 100K Tokens.
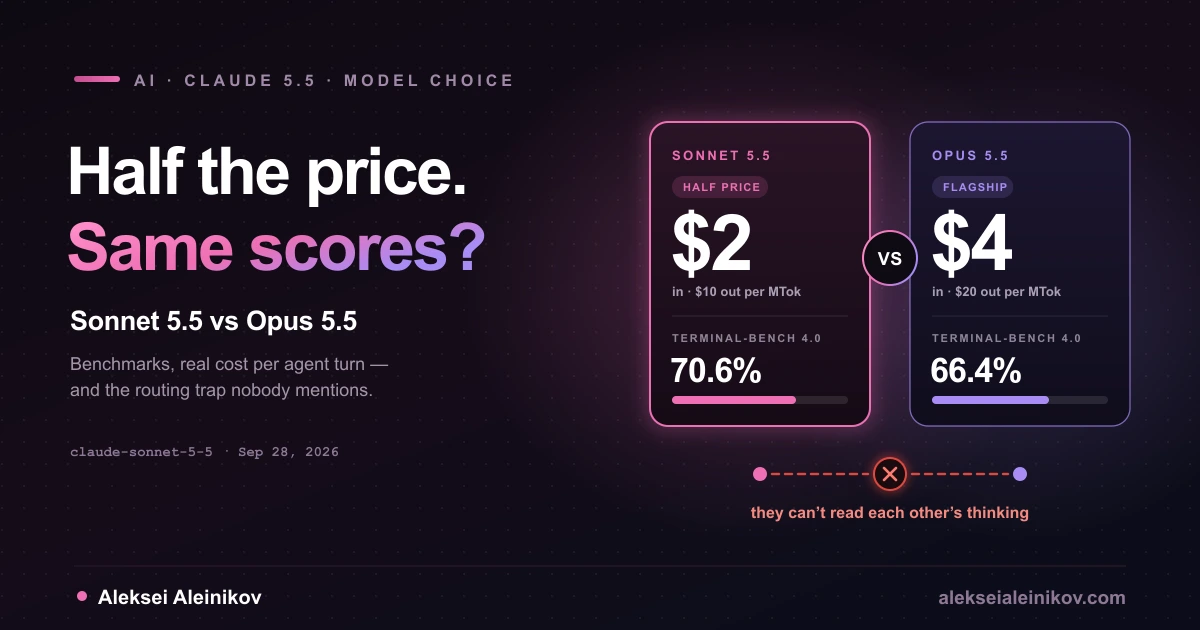
- Sonnet 5.5 – Ihr Standard für agentisches Coding und allgemeine Arbeit. Durch den halbierten Cache-Read-Preis ist es bei agentischer Arbeit jetzt rund 20 % günstiger; die Abwägung gegenüber Opus steht in Sonnet 5.5 vs. Opus 5.5.
- Opus 5.5 – mehrdeutige Langzeitaufgaben und der Planer-Platz in einem Multi-Agent-System. Wer zusätzlich OpenAIs Mittelklasse-Modell abwägt, findet den Vergleich in GPT-6.1 Sol vs. Claude Opus 5.5.
Fazit
Haiku 5.5 ist das erste kleine Claude-Modell, das Architekturentscheidungen verändert, nicht nur Rechnungen. Zu einem Zwanzigstel von Sonnets Preis bewältigt es Computer Use, Extraktion in der Wissensarbeit und abgegrenztes Coding gut genug, dass viel Traffic, der heute auf Sonnet läuft, nach unten wandern kann – und fast alles, was noch auf Haiku 4.5 läuft, sollte wechseln.
Aber es ist ein Spezialist, und es hat eine Preisregel, die kein anderes aktuelles Claude-Modell hat. Halten Sie Prompts unter 100.000 Tokens, erzwingen Sie Tool-Aufrufe für Labels, geben Sie Subagents frische Konversationen mit knappen Briefings, und lassen Sie Thinking nach oben zu Sonnet oder Opus fließen – zurück nach unten fließt es nie.
Aus der Community
Diskussion auf Mastodon & Bluesky
Antworten auf diesen Artikel aus dem offenen Netz, live geladen. Keine Werbung, keine Tracking-Skripte.
Antworte dort — es erscheint hier automatisch.