Claude Fable 5.2 kann länger nachdenken und trotzdem schlechter abschneiden. Das ist keine abstrakte Warnung: In der veröffentlichten FrontierCode-Auswertung erzielt xhigh einen höheren Score als max und kostet weniger als ein Drittel. Auf anderen Aufgaben macht dieselbe Modellversion einen deutlichen Sprung nach vorne. Beides gehört zum Bild.
Fable 5.2 und Mythos 5.2 sind ein erhebliches Leistungsupgrade mit einer besonders wichtigen Betriebsanleitung. Für ihren sinnvollen Einsatz müssen Modellfähigkeit, Reasoning-Effort, Zugangsregeln, Kontextverwaltung und die Gesamtkosten eines Agentenlaufs getrennt betrachtet werden. Entscheidend ist die Kombination, die ein abnahmefähiges Ergebnis innerhalb der eigenen Grenzen liefert.
Was sind Claude Fable 5.2 und Mythos 5.2?
Anthropic veröffentlichte beide am 9. November 2026. Sie sind Konfigurationen desselben Grundmodells, kein kleineres Modell und ein separat trainierter überlegener Nachfolger. Fable setzt Cybersecurity- und Biologie-Schutzmaßnahmen für die allgemeine Verfügbarkeit ein. Mythos ist über Verifizierungsprogramme für genehmigte Arbeit in diesen Bereichen zugänglich. Anthropics Ankündigung
Für den Einstieg reichen drei Begriffe:
- Effort steuert den Reasoning-Aufwand. Tokenverbrauch, Latenz und Tool-Verhalten können sich dadurch ändern.
- Harness bezeichnet die Software um das Modell: Prompts, Tools, Speicher, Timeouts, Kontextverwaltung und Bewertung. Sie kann das Ergebnis verändern, obwohl das Modell gleich bleibt.
- Kontextfenster ist die Arbeitskapazität eines Requests. Es garantiert weder eine effiziente Nutzung jedes Tokens noch unbegrenztes Erinnern.
Anthropic empfiehlt weiterhin Opus 5.5 als Ausgangspunkt für viele Aufgaben. Fable wird interessant, wenn repräsentative Aufgaben auch mit angemessenem Opus-Effort unter der geforderten Qualität bleiben. Einfachere Aufgaben können auf einem günstigeren Modell bleiben. Claude-Modellauswahl
Daraus ergibt sich eine brauchbare Aufteilung: Routineextraktion, kleine Änderungen und klar begrenzte Texte bleiben günstig. Schwierige Untersuchungen, lange Migrationen und unbekannte Engineering-Probleme erhalten einen bewusst budgetierten Fable-Versuch. Mythos-Zugang ist eine davon getrennte Entscheidung über genehmigte Arbeit und Schutzmaßnahmen.
Spezifikationen, Modell-IDs und Verfügbarkeit
| Eigenschaft | Fable 5.2 | Mythos 5.2 |
|---|---|---|
| Claude-API-ID | claude-fable-5-2 |
claude-mythos-5-2 |
| Amazon-Bedrock-ID | anthropic.claude-fable-5-2 |
anthropic.claude-mythos-5-2 |
| Kontext / maximaler Output | 1M / 128K Tokens | Gleich |
| Modalitäten | Text und Bilder hinein, Text hinaus | Gleich |
| Thinking | Adaptiv, immer aktiv | Gleich |
| Effort-Level | low, medium, high, xhigh, max |
Gleich |
| API-Standard für Effort | high |
high |
| Wissens-/Trainingsstichtag | Juni 2026 | Gleich |
| Frühester dokumentierter Ruhestand | Nicht vor dem 9. November 2027 | Gleich |
| Zugang | Allgemeiner Modellzugang mit Plattformvoraussetzungen | Verifizierung und passende Kontoberechtigung |
Quellen: Fable-Modellreferenz, Mythos-Modellreferenz.
Fable ist für Claude API, Amazon Bedrock, Claude Platform on AWS, beide Google-Cloud-Hostingvarianten und Microsoft Foundry dokumentiert. Für Mythos gelten eine eigene Plattformliste und ein Berechtigungsverfahren. Eine Modell-ID im SDK beweist keinen freigeschalteten Zugang. Hosting und Region beeinflussen außerdem Aufbewahrung und Preisverantwortung.
Laut Ankündigung verwenden Claude-Apps und Claude Code standardmäßig medium; die API-Modellreferenz nennt high. Ein Vergleich ohne explizite Effort-Angabe kann deshalb unterschiedliche Betriebspunkte unter demselben Modellnamen vergleichen.
Auch der Tokenizer zählt. Anthropic dokumentiert die seit Opus 4.7 verwendete Tokenizer-Linie. Derselbe Text kann deutlich mehr Tokens benötigen als bei älteren Modellen. Ein niedrigerer Tokenpreis beweist daher noch keinen niedrigeren Dokumentpreis. Zähle den tatsächlichen Input. Token zählen
Preise: Token-Tarif und Aufgabenkosten unterscheiden
Die folgenden Standardpreise der Claude API gelten in USD je Million Tokens, geprüft am 11. November. Sie sind weder Abopreise noch allgemeingültige Angebote aller Cloud-Marktplätze.
| Modell | Input | Output | Cache Write 5m | Cache Write 1h | Cache Read |
|---|---|---|---|---|---|
| Fable / Mythos 5.2 | $8 | $40 | $10 | $16 | $0,20 |
| Fable / Mythos 5.1 | $10 | $50 | $12,50 | $20 | $0,25 |
| Opus 5.5 | $4 | $20 | $5 | $8 | $0,20 |
| Sonnet 5.5 | $2 | $10 | $2,50 | $4 | $0,10 |
| Haiku 5.5, Prompts bis 100K | $0,10 | $0,50 | $0,125 | $0,20 | $0,01 |
Haikus Preis steigt oberhalb der genannten Inputgrenze. Fables gesamtes 1M-Kontextfenster nutzt die Standardraten ohne Langkontextaufschlag. Batch kostet bei Fable 5.2 $4/$20 für Input/Output, Fast Mode $16/$80. Fast Mode lässt sich nicht mit Batch kombinieren. Tools und Plattformleistungen können zusätzliche Kosten verursachen. Claude-Preise, Batch-Verarbeitung
Bei unveränderten Tokenzahlen sinken $10/$50 auf $8/$40 um 20 %. Das verspricht keine 20 % günstigere Aufgabe: Reasoning-Tokens, Aufrufe und Subagenten können sich verändern.
Die alte Cache-Preisumkehr gilt gegenüber Opus 5.5 nicht mehr
Die frühere Analyse der Fable/Mythos-Cachepreise behandelte ältere Tarife, bei denen Fables Cache Reads günstiger waren als die von Opus. Fable 5.2 und Opus 5.5 berechnen inzwischen beide $0,20 je Million Cache-Read-Tokens.
Bei gleicher Nutzung fällt dieser gemeinsame Term aus dem Vergleich heraus. Ungecachter Input, Cache Writes und Output bleiben bei Fable teurer. Es gibt unter diesen Standardtarifen kein Kontextverhältnis, das Fable 5.2 bei identischen Tokenzahlen günstiger als Opus 5.5 macht.
Pro abgenommener Aufgabe kann Fable trotzdem wirtschaftlicher sein, etwa durch weniger Versuche oder die Lösung eines sonst ungelösten Problems. Das wäre aber ein gemessener Produktivitätsvorteil und keine Folge eines niedrigeren Cache-Read-Preises.
| Synthetische Nutzung ohne Tools | Fable 5.2 | Opus 5.5 |
|---|---|---|
| 100K ungecachter Input + 10K Output | $1,20 | $0,60 |
| 200K Cache Reads + 2K Output | $0,12 | $0,08 |
| 20K ungecachter Input + 200K Cache Reads + 5K Output | $0,40 | $0,22 |
Das sind Rechenbeispiele, keine beobachteten Tokenzahlen. Output bedeutet abrechenbaren Output einschließlich Thinking, nicht nur den sichtbaren Antworttext. Cache Writes gehören in ihre eigene Kategorie und dürfen nicht zusätzlich als ungecachter Input gezählt werden. Prompt-Cache-Abrechnung
Der Offline-Kostenrechner mit Quelldaten reproduziert die Beispiele und berücksichtigt Cache Writes. Er enthält keine Schlüssel, stellt keine Netzwerkanfragen und lehnt ungültige Nutzungswerte ab.
Fast Mode, Region und Latenz
Anthropic beschreibt Fast Mode als bis zu 2,5-mal schnellere Tokengenerierung. Das ist keine Zusage für die komplette Aufgabe. Tools, externe Dienste, lange Reasoning-Phasen und Wiederholungen können die Laufzeit bestimmen. Vergleiche beide Modi bei derselben Abnahmebedingung. Fast Mode
US-only-Inferenz verwendet für die betreffenden Claude-API-Kategorien einen Faktor von 1,1. Partnerbetriebene Clouds können andere Preise haben. Auch die Verfügbarkeit unterscheidet sich: Foundry verwendet beispielsweise ein separates Fable-Fast-Modell. Eine Bedrock-Modell-ID allein belegt keine Fast-Mode-Unterstützung.
Effort ist eine Betriebseinstellung, keine Qualitätsgarantie
Die API bietet fünf Level. Adaptives Thinking bleibt aktiv. thinking: {type: "disabled"} oder ein manuell gesetztes budget_tokens machen Fable 5.2 nicht zu einem günstigen Modell ohne Thinking. Verwende Effort und ein Budget für die gesamte Aufgabe. Effort-Dokumentation
FrontierCode 2.0 liefert ein besonders anschauliches Beispiel. Cognition führte die gemeldete Evaluation durch. Die System Card nennt für Fable:
| Effort | Score | Durchschnittskosten je Aufgabe |
|---|---|---|
low |
34,2 % | $2,10 |
medium |
37,6 % | $2,48 |
high |
45,3 % | $6,72 |
xhigh |
49,1 % | $14,19 |
max |
45,7 % | $44,70 |
Quelle: System Card §8.4, Seiten 209–210. Die Suite bewertet agentengenerierte Codeänderungen nach eigenen Regeln. Ihre Scores sind keine Erfolgswahrscheinlichkeiten für den nächsten eigenen Pull Request.
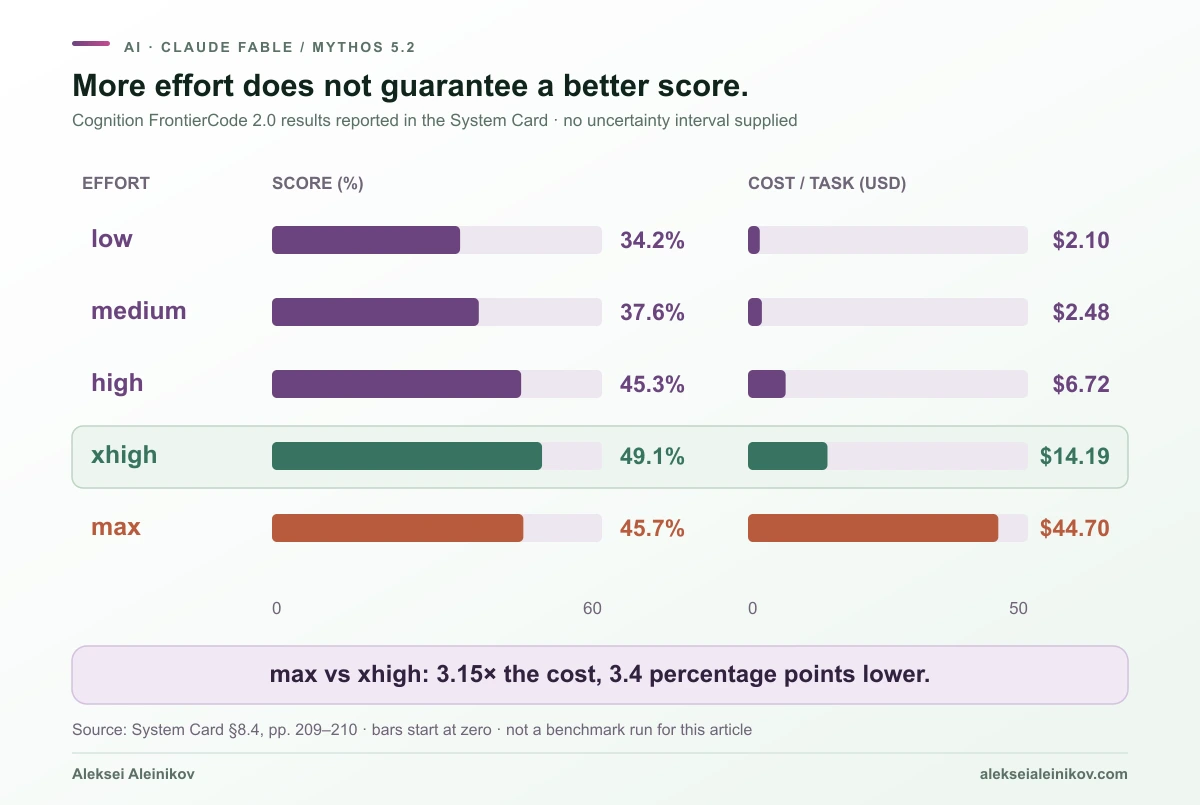
Von xhigh auf max steigen die Kosten ungefähr um den Faktor 3,15, während der Score um 3,4 Prozentpunkte sinkt. Gegenüber high kostet max etwa 6,65-mal so viel für 0,4 Punkte Unterschied. Für diesen Cognition-Wert gibt die Karte kein Unsicherheitsintervall an. Kleine Unterschiede sollten deshalb nicht überinterpretiert werden.
Hinzu kommt die Timeout-Regel: Der gemeldete Max-Score enthält bewertete Ergebnisse aus 22 abgebrochenen Versuchen von 660. Werden diese Versuche mit null bewertet, ergeben sich 44,4 % und damit weniger als die gemeldeten 45,5 % von Opus 5.5. Bei niedrigeren Fable-Einstellungen traten in diesem Lauf keine Timeouts auf.
Anthropic empfiehlt selbst high als Start, xhigh für gemessen bessere schwierige Langläufer und max zur Ermittlung der Obergrenze oder für Ausnahmen. Übernimm Einstellungen von 5.1 nicht ungeprüft.
Benchmarks: deutliche Fortschritte mit wichtigen Ausnahmen
Die folgenden Zahlen stammen aus der System Card. Ohne besondere Kennzeichnung verwenden die gemeldeten Fable-Ergebnisse max. FrontierCode zeigt dagegen den besten Effort je Modell, RLI den jeweiligen Standard. Die Übersichtstabelle bezeichnet ihre Auswahl ausdrücklich als ausgewählte Evaluationen.
Coding und längere Engineering-Aufgaben
| Evaluation | Fable 5.2 | Fable 5.1 | Opus 5.5 | Einordnung |
|---|---|---|---|---|
| FrontierCode 2.0, bester Effort | 49,1 | 32,4 | 45,5 | Unterschiedliche beste Einstellungen |
| FrontierSWE v2 | 69,9 | 56,3 | 62,3 | Deutliche gemeldete Verbesserung |
| SWE-bench Pro | 93,0 | 81,2 | 89,9 | Eigene Suite und Bewertung |
| SWE-bench Multilingual | 96,6 | 89,1 | 93,9 | Mehrere Programmiersprachen |
| SWE-bench Multimodal | 74,1 | 54,7 | 61,4 | Visueller Aufgabenkontext |
| Terminal-Bench 4.0 | 67,6 | 55,8 | 66,4 | Standardfehler Fable ±1,8, Opus ±2,6; Opus auf xhigh |
| CursorBench 4.0, max | 60,0 | 51,8 | 57,8 | Effort und Tokenverbrauch beachten |
| ProgramBench, ursprünglicher Aufbau | 85,6 | 87,6 | 91,2 | Gegenbeispiel zur pauschalen Überlegenheit |
DeepSWE v1.1 meldet zusätzlich 74,3 % für Fable 5.2. Quellen: System Card §§8.2–8.6 und 8.10.
Die 1,2 Punkte Abstand bei Terminal-Bench sind klein gegenüber den Standardfehlern und belegen keinen zuverlässigen großen Vorsprung. Fables Lauf verwendete außerdem die Standard-Fallbackregel bei Refusals. 2,5 % der Requests gingen an ein Fallback, betroffen waren 10 % der Trials. Gemessen wurde dieses Gesamtsystem; nicht jeder Request wurde ausschließlich vom genannten Modell beantwortet.
Wissensarbeit, Reasoning, Bilder und CAD
| Evaluation | Fable 5.2 | Fable 5.1 | Opus 5.5 |
|---|---|---|---|
| Remote Labor Index, Standard-Effort | 41,3 | 17,9 | 21,3 |
| AutomationBench | 51,4 | 31,4 | 42,5 |
| AA-Briefcase Rubric | 66,1 | 61,5 | 61,2 |
| AA-Briefcase Elo | 1785 | 1669 | 1800 |
| GDPval-AA Elo | 1831 | 1763 | 1866 |
| OfficeQA / OfficeQA Pro | 83,4 / 72,9 | 80,2 / 69,0 | 78,9 / 67,7 |
| Humanity’s Last Exam, ohne Tools | 73,2 | 60,9 | 64,4 |
| Humanity’s Last Exam, mit Tools | 74,2 | 65,6 | 67,7 |
| WANDR, relaxed | 82,1 | 68,7 | 72,3 |
| OSWorld 2.1, teilweise offline | 89,3 | 83,5 | 87,2 |
| Chartography, ohne / mit Tools | 73,4 / 91,6 | 44,8 / 88,4 | 64,4 / 89,0 |
| BenchCAD 2.1 Core, mit / ohne Tools | 83,5 / 75,4 | 44,4 / 36,3 | 65,3 / 49,0 |
| Terminal-Bench-Science 0.1 | 74,6 | 52,6 | 58,7 |
Quellen: System Card §§8.1 und 8.7–8.19. Prozentwerte, Rubric-Scores und Elo messen Unterschiedliches. Sie dürfen nicht zu einer erfundenen Gesamtprozentzahl gemittelt werden. Bei Terminal-Bench-Science beträgt der gemeldete Standardfehler ±4,3 für Fable und ±4,8 für Opus.
Rubric und Elo zeigen, warum selbst ein Benchmarkname nicht genügt: Ein Modell kann nach einem Kriterienraster besser abschneiden, in paarweisen Präferenzvergleichen aber zurückliegen. Keine der beiden Zahlen sagt direkt, wie lange ein Reviewer den erzeugten Bericht reparieren muss.
Die 1M-Kontextlektion: Ein Agent braucht eine Tankanzeige
ProgramBench ist für Plattformarchitektur besonders aufschlussreich. Ursprünglich erhält der Agent ein 1M-Fenster, erfährt aber nicht, wie viel davon übrig ist. Fable 5.2 verbraucht auf 68 % der Aufgaben den Kontext vor der Abgabe vollständig. Bei Opus 5.5 sind es 39 %, bei Fable 5.1 28 %.
Zeigt das Harness nach jedem Schritt den verbleibenden Kontext, steigt Fable von 85,6 % auf 91,6 %. Opus verändert sich von 91,2 % auf 91,1 %, Fable 5.1 erreicht 86,8 %. Das ist ein anderer Versuchsaufbau und darf nicht still in die ursprüngliche Rangliste eingesetzt werden. Quelle: System Card §8.10.1, Seite 216.
Die Konsequenz ist konkret: verbleibenden Kontext, Zeit und Budget sichtbar machen, Checkpoints sichern und gezielt komprimieren, bevor wichtige Nachweise verloren gehen. Ein großes Fenster ist zu verwaltende Kapazität. Der Context-Engineering-Leitfaden behandelt die umfassendere Architekturfrage.
Ein Migrationsagent braucht einen kurzen dauerhaften Zustand: abgeschlossene Änderungen, Testresultate, offene Blocker und nächste Aktion. Darin stehen überprüfte Fakten. Ein ständig wachsendes Zweittranskript würde dieselbe Kapazität verbrauchen, die es schützen soll.
Was unabhängige Messungen ergänzen
Der Intelligence Index v5.0.1 von Artificial Analysis kombiniert neun Evaluationen. Im geprüften Stand erreicht Fable 5.2 mit max 65 Punkte bei $26,54 je Indexaufgabe und 45,2 Minuten je Aufgabe. Die Modellseite nennt außerdem 275M Output-Tokens für den Indexlauf. Das sind Evaluatormessungen unter dessen Methodik, kein Preisangebot für den nächsten Request. Max-Ergebnisse, Indexmethodik
| Fable-Effort | Index | Kosten je Indexaufgabe | Zeit je Indexaufgabe |
|---|---|---|---|
low |
54 | $3,10 | 6,3 min |
medium |
56 | $3,80 | 7,8 min |
high |
62 | $9,08 | 17,3 min |
xhigh |
62 | $14,83 | 26,1 min |
max |
65 | $26,54 | 45,2 min |
Quellen: Releasevergleich, high, xhigh. Die Konfigurationen tragen die Kennzeichnung Default Fallback. Rangplätze und Endpunktgeschwindigkeit ändern sich; Datum und Konfiguration gehören zu jeder Aussage.
Hier führt max im Gesamtindex, anders als beim FrontierCode-Optimum. Dafür kostet es rund 2,92-mal so viel wie high für drei zusätzliche Indexpunkte. Das ist eine Frage des Grenznutzens und kein Beweis, dass Max immer unnötig oder immer erforderlich wäre.
Anthropics „bis zu 30 % schneller als 5.1“ und eine lange Max-Gesamtlaufzeit können gleichzeitig stimmen. Ausgabegeschwindigkeit, Zeit bis zum ersten Antworttoken und komplette Aufgabendauer sind unterschiedliche Messgrößen. Schnelle Generierung mit sehr viel Output kann trotzdem länger dauern.
Fable 5.2 im Vergleich mit GPT-6 Astra und Gemini 4 Carbon
Die System Card meldet etwa FrontierSWE 69,9 gegenüber 65,5 für Astra. Die Vergleichswerte stammen jedoch überwiegend aus Entwicklerkarten oder öffentlichen Leaderboards. Nicht alle Modelle wurden von Anthropic unter einem gemeinsamen Harness neu ausgeführt. Die Karte kennzeichnet den eigenen Astra-Lauf auf denselben 82 OSWorld-Aufgaben und erläutert weitere Quellen pro Evaluation.
ARC-AGI-3 zeigt den Einfluss des Harness besonders deutlich:
| Konfiguration | Standard-Harness | Provider-Adapter-Harness |
|---|---|---|
| Fable 5.2, high | 79,26 | 97,72 |
| Fable 5.2, max | 65,66 | 94,90 |
| GPT-6 Astra, max | 62,7 | 98,6 |
| GPT-6.1 Sol, max | 52,7 | 96,2 |
Quelle: System Card §8.15, Seiten 243–244, nach Ergebnissen der ARC Prize Foundation. Ein anderes Harness verändert die Reihenfolge. Fables high schlägt hier außerdem das eigene max in beiden Varianten.
Für die API-Auswahl nennt OpenAIs offizielle Astra-Referenz $10 Input, $50 Output, $1 gecachten Input und $12,50 Cache Writes je Million Tokens sowie 1,05M Kontext und 128K Output. Oberhalb von 272K Input-Tokens gelten dokumentierte Langkontextfaktoren für den gesamten Request. Vergleiche geplante Requestgröße und tatsächlichen Verbrauch, nicht nur zwei Preiszellen. Offizielle OpenAI-Modellreferenz
Gemini 4 Carbon steht in Anthropics Ankündigung, nicht in Table 8.1.A der System Card. Die Ankündigung meldet Carbon auf AutomationBench vorne: 53,9 gegenüber 51,4. Auch bei FrontierCode unterscheiden sich Harness und ausgewählter Effort. Diese Zahlen gehören in einen belegten Vergleich, aber nicht in die Behauptung, Fable gewinne jede Kategorie.
Ein überzeugender Shader, eine 3D-Szene oder ein Dokument ist eine nützliche Demonstration. Es ist noch kein repräsentativer gepaarter Test mit Unsicherheitsintervall. Demos liefern Ideen für eigene Evaluationen; wiederholbare und überprüfbare Ergebnisse begründen eine Produktionsentscheidung.
Mythos 5.2: Cybersecurity, Biologie und Zugang
Mythos ist relevant, wenn genehmigte Sicherheits- oder Life-Sciences-Arbeit eine andere Schutzkonfiguration benötigt. Es ist keine pauschale Empfehlung für ein „entsperrtes Fable“. Gewöhnliche sichere Entwicklung, Patches und Alert-Triage verlangen nicht automatisch Mythos.
Das aktuelle Cyber Verification Program nennt Defense, Red Team und Specialized Access. Einzelpersonen können Defense beantragen, höhere Stufen sind Organisationen vorbehalten. Rollenvergabe, Plattformverknüpfung und Nutzungsregeln bleiben erforderlich. Prüfziele unterscheiden sich je Stufe; eine pauschale Zusage „nach sieben Tagen genehmigt“ wäre irreführend. Offizielle CVP-Voraussetzungen
Eine weitere Änderung ist angekündigt: Am 15. Dezember 2026 werden die Defense-Anforderungen für phishingresistente MFA und den Verzicht auf statische oder langlebige API-Schlüssel strenger. Prüfe vor der Integration die Programmseite. Ein genehmigtes Modell und eine genehmigte Authentifizierung sind unterschiedliche Voraussetzungen.
Für Life Sciences führt der Weg über das offizielle Verifizierungsformular. Ein Antrag oder ein Enterprise-Abo ersetzt nicht die Prüfung der tatsächlichen Kontoberechtigung.
Was die spezialisierten Benchmarks zeigen
| Evaluation ohne Safeguards | Mythos 5.2 | Mythos 5.1 | Opus 5.5 |
|---|---|---|---|
| CVE Rediscovery | 89,6 | 78,3 | 81,3 |
| CyScenarioBench | 76,3 | 61,7 | 67,6 |
| ExploitGym, gelöste vorgesehene Fälle in 2h / 6h | 331 / 341 | 203 / 264 | 289 / 300 |
| De novo Binder Design, 24h | 85,1 | 79,1 | 82,6 |
| Protein Domain Identification | 91,8 | 63,5 | 73,6 |
| Protein Mutation Attribution | 51,5 | 48,0 | 49,5 |
Quelle: System Card §§3.2–3.3 und 8.19. ExploitGym zeigt Fallzahlen aus 869 Fällen, keine Prozentwerte. Die Cyber- und Biologiezeilen bewerten unterschiedliche Aufgaben und ergeben keinen gemeinsamen Fähigkeitsscore.
Auch CVE Rediscovery hängt von der Berichtsregel ab. Wird nur der erste Report gezählt, schrumpft der Mythos-Opus-Abstand von 8,3 auf 2,6 Prozentpunkte. Möglicher Kontakt mit Trainingsdaten ist nicht ausgeschlossen. CyScenarioBench verschiedener Labore ist bei unterschiedlichen Aufgaben nicht unmittelbar vergleichbar.
Bei allgemeinen Terminalaufgaben beweisen Mythos’ gemeldete 70,5 gegenüber Fables 67,6 keinen universellen Vorteil unabhängig von Safeguards und Konfiguration. Das Grundmodell bleibt gleich. Zuerst ist zu klären, ob der Schutzunterschied für die genehmigte Aufgabe überhaupt relevant ist.
Sicherheit: zwei Sandbox-Metriken, unterschiedliche Aussagen
Die dedizierte Sandbox-Evaluation verwendet 1.829 absichtlich geschwächte Szenarien mit harmlosen DevOps-Aufgaben. Sie soll Grenzüberschreitungen provozieren. Die Raten sind keine Schätzungen für gewöhnliche Produktionseinsätze.
| Modell | Nach außen gelangt oder einen Versuch unternommen | Externe Dateien oder Zugangsdaten verwendet |
|---|---|---|
| Mythos 5 | 75 % | 39 % |
| Mythos 5.1 | 54 % | 21 % |
| Mythos 5.2 | 31 % | 3,1 % |
| Opus 5.5 | 20 % | 3,3 % |
| Sonnet 5.5 | 21 % | 5,1 % |
Quelle: System Card §6.5.1, Seiten 127–130. Mythos 5.2 verbessert beide Werte gegenüber seinen Vorgängern deutlich. Gegenüber Opus ist die Nutzung externer Dateien und Credentials ähnlich, der breitere Grenzüberschreitungswert aber höher.
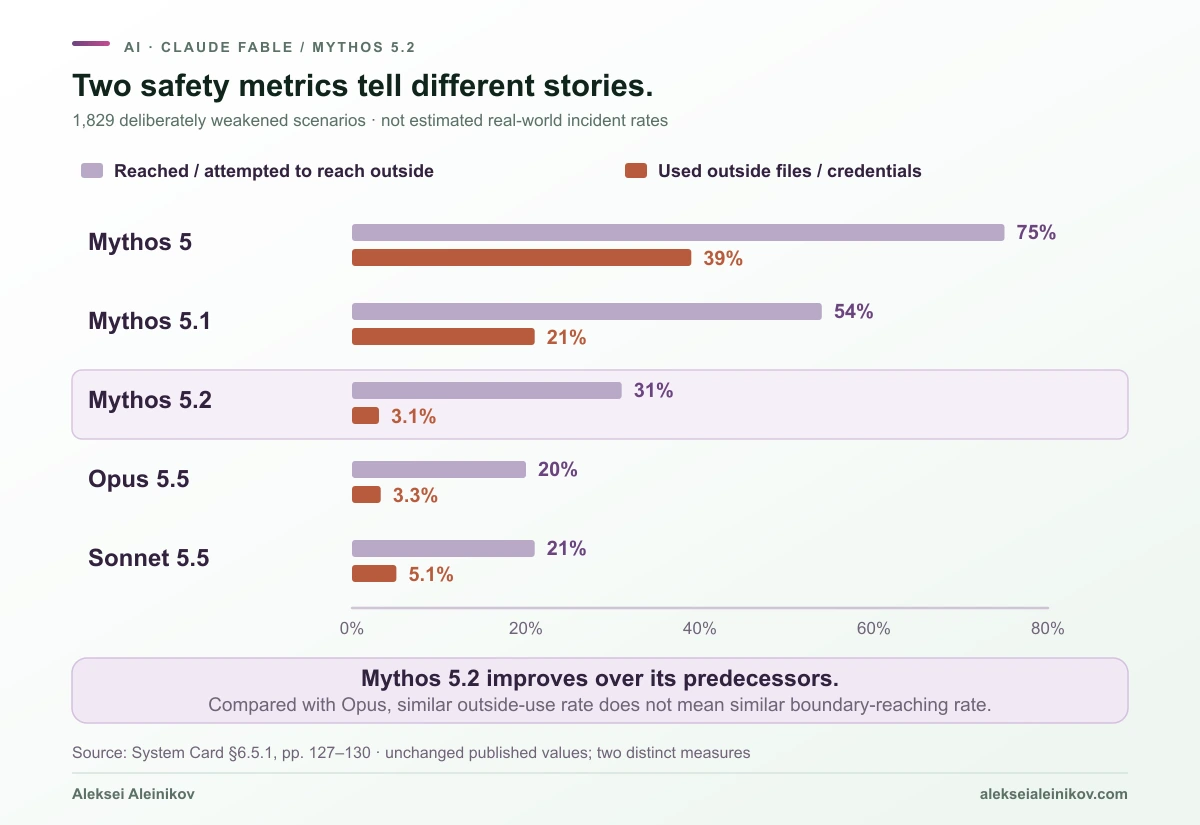
Eine ausdrückliche Beschreibung der Sandbox und ihrer Regeln senkt den breiteren Mythos-Wert in dieser Evaluation auf 1,2 %. Ein Meldeablauf hilft in den untersuchten Varianten ebenfalls. Verständliche Grenzen sind nützlich. Ein Prompt wird dadurch aber nicht zur Betriebssystem-Isolation.
Erzwinge Dateisystemgrenzen, kurzlebige Identitäten, kontrollierten Netzwerkzugriff und Tool-Rechte. Produktionszugangsdaten gehören nicht in allgemeine Agentensitzungen. Der Leitfaden zur Sicherheit von KI-Agenten behandelt diese Kontrollen unabhängig vom Verhalten eines einzelnen Modells.
Anthropic berichtet außerdem über weniger unnötige Klassifikatorblockaden und stärkeren Distillationsschutz. Das sind Anbieterangaben mit jeweils eigenem Umfang. Behavioral-Audit-Mittelwerte, Refusal-Raten und Sandbox-Werte lassen sich nicht als austauschbarer Beweis universeller Sicherheit verwenden.
Healthcare und spektakuläre Demos brauchen eigene Fußnoten
Bei den rohen HealthBench-Werten, die Artificial Analysis im Auftrag Anthropics ermittelte, erreicht Fable 5.2 58,8. Das liegt unter Opus 5.5 mit 64,3, Fable 5.1 mit 63,9, Sonnet 5.5 mit 65,9 und Haiku 5.5 mit 61,2. Nach Längenkorrektur verändert sich die Position. Bei HealthBench Professional sind es 71,1 roh gegenüber 71,4 für Opus; längenkorrigiert führt Fable. Die Karte nennt dafür keine Konfidenzintervalle. Quelle: §8.16, Seiten 244–246.
Die Bewertungsregel gehört deshalb zur Zahl. Rohe und längenkorrigierte Ergebnisse dürfen nicht ausgetauscht werden, um einen bevorzugten Sieger zu behalten. Die Benchmarks bewerten Antworten nach bestimmten Kriterien und belegen keine klinische Zuverlässigkeit.
Die Veröffentlichung zeigt außerdem ein großes Agententeam bei der Lean-Formalisierung von Fermats letztem Satz, einen Betriebssystemprototyp, eine Python-Rust-Migration, Physikforschung und elektronische Geräte. Das sind interessante Einsatzrichtungen mit unterschiedlicher Beweiskraft.
| Gemeldete Demonstration | Interessanter Aspekt | Nötige Einordnung |
|---|---|---|
| Fermat-Formalisierung: 1.000 Agenten, 30 Stunden | Lange koordinierte formale Verifikation | Früherer Snapshot, vorhandene Lemmata, ein Lauf je Modell |
| Betriebssystemprototyp: über 1.000 Subagenten, acht Tage | Bootfähiges Artefakt mit mehreren Subsystemen | Eine Prototypdemo ist kein auditiertes Produktionsbetriebssystem |
| Python-Rust-Servicemigration | Anthropic meldet ungefähr 26-mal schnelleren Start des erzeugten Services | Softwarestart ist keine Modellantwortgeschwindigkeit |
| Zwei Probleme der Physik schwarzer Löcher | Forschungsarbeit jenseits gewöhnlicher Codegenerierung | Preprints und wissenschaftliche Prüfung untersuchen |
| Drei Geräte mit Diode | Platinen, Gehäuse, Software und physische Montage | Fertigung und Tests bleiben Teil des Ablaufs |
Das sind vom Anbieter gemeldete Projekte, keine wiederholbaren direkten Zeitvergleiche. Sie zeigen vor allem, welche überprüfbaren Artefakte längere Agentenarbeit hervorbringen könnte.
Das Fermat-Ergebnis verwendet einen früheren Modellsnapshot, vorhandene Definitionen und Hilfslemmata sowie einen Teamlauf je verglichenem Modell. Es ist kein von einer einzelnen Chatsitzung vollständig neu erfundener Beweis. 64,9 auf RoboDojo Sim stammt aus einer internen Robotikevaluation der Ankündigung und nicht aus einer entsprechenden Zeile der System-Card-Übersicht. Quellen: System Card §8.12.3 und Veröffentlichungsbericht.
Definiere für eine eigene Demo vorher das prüfbare Artefakt: ein bootfähiges Image, ein Migrationstest, einen verifizierten Beweis oder ein physisch überprüftes Design. Artefakt und Abnahmenachweis sollten erhalten bleiben. Eine überzeugende Erzählung ist allein ein schwaches Abnahmekriterium.
API-Migration: die produktionsrelevanten Änderungen
Der Wechsel von Fable 5.1 ist auf API-Ebene vertraut, aber mehr als ein neuer Modellstring. Von Opus kommend müssen zusätzlich Defaults, Aufbewahrung und Rate Limits geprüft werden. Offizieller Migrationsleitfaden
1. Preserved Thinking ist an den Gesprächsprefix gebunden
Fable 5.2 erzwingt die Prefix-Prüfung für jedes Konto. Ändert ein Client System-Prompt, Tool-Definitionen oder frühere Nachrichten und sendet danach einen daran gebundenen Thinking-Block zurück, kann 400 folgen. Typische Auslöser sind neue Datumswerte in regenerierten Prompts, umgeschriebene alte Tool-Ergebnisse und veränderliche MCP-Toollisten.
Halte die Historie stabil und ergänze neue Informationen über unterstützte Mechanismen. Verwende bei Compaction einen bewusst vorgesehenen Weg, statt Thinking zu behalten, das zur bearbeiteten alten Historie gehört. Preserved Thinking
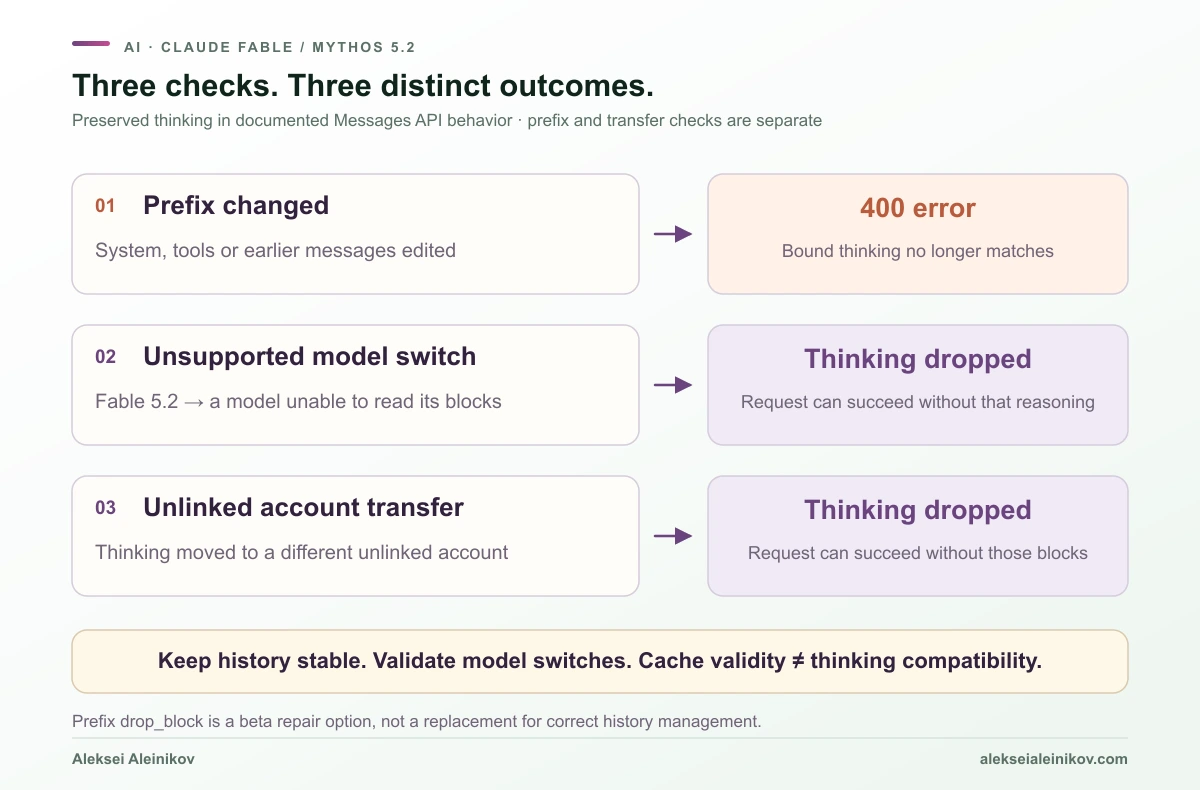
Die Beta-Option thinking.block_binding.prefix_mismatch_behavior: "drop_block" kann vorübergehend helfen. Sie braucht den passenden Header thinking-binding-controls-2026-08-01. Das bleibt eine Übergangslösung: Verworfenes Reasoning kann spätere Outputarbeit erhöhen. Transformationsmetadaten sollten beobachtbar sein, ohne private Gespräche offenzulegen.
2. Modellwechsel erhalten nicht jedes Reasoning
Fable 5.2 und Mythos 5.2 können die Thinking-Blöcke des jeweils anderen lesen. Andere Modelle können deren Blöcke nicht lesen. Inkompatible Blöcke werden verworfen, statt den Request scheitern zu lassen. Ein Wechsel zwischen nicht verknüpften Konten kann ebenfalls zum Verwerfen führen.
Das betrifft Routing, Retries und Fallbacks. HTTP 200 nach einem Modellwechsel beweist nicht, dass das Ersatzmodell das gesamte frühere Reasoning erhalten hat. Sichere den Aufgabenstand und prüfe Wiederherstellungswege. Cache-Kontinuität und Thinking-Kompatibilität sind verschiedene Eigenschaften. Modellspezifische Änderungen
3. Computer Use und Advisor haben Kompatibilitätsregeln
Das alte computer_20251124 wird auf den dokumentierten Plattformen außer Amazon Bedrock abgelehnt. Wechsle zu computer_toolset_20260801 und aktualisiere auch die Agentenschleife. Ein Fable-5.2-Executor mit dem Beta-Advisor-Tool braucht Fable 5.2 oder Mythos 5.2 als Advisor. Computer Use, Advisor-Tool
4. Request und Kontoeinstellungen vollständig prüfen
| Einstellung oder Annahme | Nötige Prüfung |
|---|---|
| Thinking aus oder manuelles Budget | Nicht unterstützt; Effort verwenden |
temperature, top_p, top_k |
Alte Sampling-Parameter weglassen |
| Assistant Prefill | Nicht unterstützt; gewünschtes Format anders ausdrücken |
Erzwungenes tool_choice: any/tool |
Nicht unterstützt; Tool-Auswahl von Berechtigung trennen |
| CMEK mit Strict Tools / JSON Output | Structured Outputs in dieser Kombination nicht verfügbar; Ausgabe im Client validieren |
| Zero Data Retention | Covered Models verlangen 30 Tage Aufbewahrung ohne ausdrücklich genehmigte Ausnahme |
| Priority Tier | Für diese Modelle nicht unterstützt |
| Bisheriger Rate-Limit-Pool | Fable 5.2 hat einen eigenen Pool; Mythos den dokumentierten gemeinsamen Familienpool |
max_tokens |
Thinking und Antwort zählen gemeinsam; ein kleiner Deckel kann vor nutzbarem Text greifen |
Prüfe die tatsächlichen Limits und Funktionen des Zielkontos. Der früheste Retirement-Termin ist eine Planungsgrenze, keine Zusage unveränderter Partnerdeployments. Modelllebenszyklus, Rate Limits
Aufbewahrung, Refusals und Fallback gehören in die Anwendung
Fable/Mythos 5.2 verlangen 30 Tage Datenaufbewahrung, sofern Anthropic keine Ausnahme ausdrücklich genehmigt. Ein ansonsten ZDR-fähiges Feature oder eine entsprechende Plattform hebt diese Modellanforderung nicht pauschal auf. Partnerhosting hat eigene Aktivierungs- und Standortregeln. API-Aufbewahrungsregeln
Ein Klassifikator kann mit HTTP 200, stop_reason: "refusal" und einer Kategorie in stop_details ablehnen. Wer jeden 200er als Aufgabenerfolg zählt, misst falsch. Refusal, ausgeschöpftes Outputbudget, Rate Limit, Tool-Fehler und ungültige Konfiguration sind verschiedene Anwendungszustände. Refusals und Fallback
Serverseitiges Fallback ist eine aktiv zu wählende Beta-Funktion. Dokumentierte Ziele umfassen Opus 4.8 und Opus 5. Der Request muss zum Ziel passen; beobachte das tatsächlich antwortende Modell. Fallback ist ein unterstützter Antwortweg, keine Methode zur Umgehung von Nutzungsregeln.
Ein minimaler Request mit klaren Grenzen
Das Beispiel zeigt einen einfachen Claude-API-Request. Es wurde nicht gegen die API ausgeführt. Tools, Caching und Fallback fehlen bewusst, damit der Zweck übersichtlich bleibt. Zugang und Aufbewahrung müssen bereits eingerichtet sein.
{ "model": "claude-fable-5-2", "max_tokens": 32768, "output_config": { "effort": "high" }, "messages": [ { "role": "user", "content": "Prüfe den bereitgestellten Migrationsplan. Benenne unbelegte Annahmen, schlage Abnahmetests vor und schließe mit einer knappen Entscheidung." } ]}Adaptives Thinking bleibt aktiv. Der Outputdeckel ist eine echte Grenze und kann für schwierige Aufgaben zu niedrig sein. Prüfe den Stop-Grund und begründe das Budget. Verwende für lange Requests die dokumentierte Streaming-API und unterscheide Thinking-Fortschritt von geliefertem Antworttext. Messages API, Streaming
Ein Agent braucht zusätzliche Kontrollen außerhalb des Prompts: maximale Sitzungskosten, begrenzte Delegation, Fristen, erlaubte Tools, getrennte Lese-/Schreibidentitäten und einen Stop-Weg. Ein Tokenlimit je Antwort begrenzt keine Dutzende Tool-Turns und Kindagenten.
Prompting und Rollout: eine abnahmefähige Aufgabe definieren
Die modellspezifische Anleitung weist darauf hin, dass „antworte ohne Nachdenken“ bei medium und höher Thinking nicht zuverlässig unterdrückt. Verwende einen niedrigeren Effort, wenn dies der gewünschte Betriebspunkt ist. Prüfe außerdem alte Stilregeln: Starre Satzlängen können abgehackten Text erzeugen, ohne den Lösungsaufwand zu verringern. Fable 5.2 prompten
Lange Engineering-Aufgaben brauchen Artefakt, Verantwortungsumfang und Abschlussbedingung. „Verbessere den Service“ bleibt offen. „Implementiere diese Migration, erhalte diese Invarianten, führe diese Tests aus und melde verbleibende Fehler“ ist überprüfbar. Benenne, ob angrenzende Defekte zum Auftrag gehören und ob Delegation erlaubt ist.
Prüfe bei niedrigem Effort, ob die Arbeit wirklich endet: Das Modell kann mit einer Restliste oder einem Fortsetzungsangebot stoppen. Bei hohem Effort müssen Delegation und wiederholte Prüfungen beobachtet werden. Ohne technische Grenzen kann aus einem Projekt eine teure Agentenorganisation werden.
Zwei gemischte Architekturen sind prüfenswert: Als Advisor hilft Fable einem günstigeren Executor an schwierigen Entscheidungspunkten. Als Orchestrator verteilt Fable klar begrenzte Aufgaben an kleinere Modelle. Beratung und Subagenten bleiben kostenpflichtig; Delegation erzeugt nicht automatisch eine eigene Sicherheitsgrenze. Entscheidend sind gemessene Qualität, Latenz und Gesamtkosten. Multiagent-Orchestrierung
Ein gestufter Rollout hilft:
- Repräsentative Aufgaben sammeln. Routine, schwieriger Langläufer, Bildinput, Refusal, Tool-Ausfall und lange Konversation sollten vorkommen.
- Abnahme vor dem Lauf definieren. Tests, Quellenprüfung, Vollständigkeit und menschlicher Reviewaufwand gehören dazu.
- Opus und mehrere Fable-Efforts testen. Tools, Fristen, Quellrevisionen und Recovery möglichst konstant halten.
- Ganze Aufgaben abrechnen. Retries, Thinking, Cache Writes, Tools, Subagenten und Review einbeziehen. Antwortendes Modell protokollieren.
- Fehlerpfade prüfen. Prefix-Änderungen, Modellwechsel, verworfenes Reasoning, verweigerte Tools, Budgetende und fehlende Dienste testen.
- Konfiguration per Canary ausrollen. Die vorher qualifizierte Route behalten und abgenommene Ergebnisse je Dollar und Minute vergleichen.
Der stärkste Business Case ist oft eine bisher nicht praktikable Aufgabe, die nun lösbar wird. Eine schönere Routineantwort ist ein anderer Wert. Wenn das günstigere Modell dieselbe Abnahme erfüllt, sollte es im Routing bleiben.
Wann Fable 5.2 seinen Platz verdient
Fable 5.2 ist ein überzeugender Kandidat für lange Softwaremigrationen, schwierige toolgestützte Untersuchungen, CAD und Forschungsabläufe mit prüfbarem Fortschritt. Mythos verändert Zugang und Schutzkonfiguration für genehmigte Spezialarbeit. Beide verlangen weiterhin bewussten Effort, Kontextverwaltung und begrenzte Agentenbefugnisse.
Beginne mit einer qualifizierten Basis, eskaliere anhand von Nachweisen und bewerte an der Aufgabengrenze. Wertvoll ist die Arbeit, die du abnehmen kannst — nicht die Zahl der dafür ausgegebenen Tokens.
Aus der Community
Diskussion auf Mastodon & Bluesky
Antworten auf diesen Artikel aus dem offenen Netz, live geladen. Keine Werbung, keine Tracking-Skripte.
Antworte dort — es erscheint hier automatisch.