Am 15. Oktober hat Meta die Gewichte von Muse Spark Open veröffentlicht, einem Modell mit 816 Milliarden Parametern, das Meta „das leistungsfähigste US-amerikanische Open-Weight-Modell bis heute“ nennt. Innerhalb eines Tages war es das meistdiskutierte KI-Release der Woche, und die naheliegende Frage folgte sofort: Ist es besser als die chinesischen Open-Weight-Modelle, die dieses Jahr das Tempo vorgeben, GLM 5.3 von Z.ai und Kimi K3 von Moonshot AI?
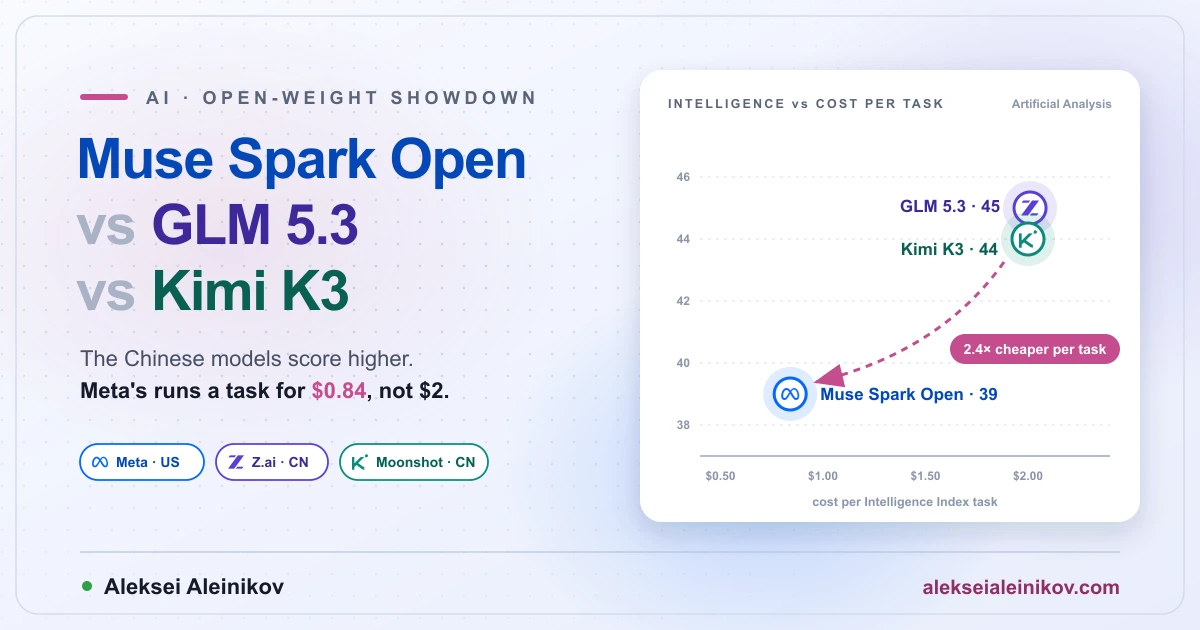
Die kurze Antwort lautet nein, und der Grund steckt im Zusatz „US-amerikanisch“ in Metas Überschrift. Auf dem unabhängigen Index von Artificial Analysis erreicht Muse Spark Open 39 Punkte, GLM 5.3 45 und Kimi K3 44. Die lange Antwort ist nützlicher: Muse Spark Open kostet pro Aufgabe weniger als die Hälfte, antwortet schneller, versteht Audio und Video und führt bei der Tool-Nutzung. Dieser Vergleich stellt alle Zahlen nebeneinander, die die drei Anbieter und Artificial Analysis veröffentlicht haben: unabhängige Werte, Metas Benchmark-Tabelle, Kosten pro Aufgabe, GPU-Speicherbedarf und die Lizenzklauseln, die entscheiden, ob Sie damit ein Produkt bauen dürfen.
Muse Spark Open vs GLM 5.3 vs Kimi K3 im Überblick
Die technischen Angaben stammen aus den Model Cards von Muse Spark Open, GLM 5.3 und Kimi K3; Werte, Geschwindigkeit und Preise von Artificial Analysis.
| Muse Spark Open | GLM 5.3 | Kimi K3 | |
|---|---|---|---|
| Anbieter | Meta (USA) | Z.ai (China) | Moonshot AI (China) |
| Gewichte veröffentlicht | 15. Oktober | August | Juli |
| Parameter gesamt | 816 Mrd. | 753 Mrd. | 2,8 Bio. |
| Aktiv pro Token | 42 Mrd. | 40 Mrd. | 104 Mrd. |
| Experten pro Token | 8 von 256 | k. A. | 16 von 896 |
| Eingabe | Text, Bilder, Audio, Video | Text | Text und Bilder |
| Kontextfenster | 1 Mio. | 1 Mio. | 1 Mio. |
| Intelligence Index (Artificial Analysis) | 39 | 45 | 44 |
| Output-Geschwindigkeit (Tokens/s) | 102 | 67 | 43 |
| Kosten pro Aufgabe (Artificial Analysis) | 0,84 $ | 2,01 $ | 2,00 $ |
| API-Preis pro Mio. Tokens (Input / Output) | 1,25 $ / 4,25 $ | 1,40 $ / 4,40 $ | 3,00 $ / 15,00 $ |
| Veröffentlichte Präzision | BF16 und NVFP4 | FP8 | MXFP4 |
| Reasoning | Immer an: low / medium / high / xhigh | low / high / max | Immer an: low / high / max |
| Lizenz | Muse Model License | GLM 5.3 License (MIT-artig) | Kimi K3 License |
Drei Zeilen erklären fast alles, was folgt. Der Intelligence Index sagt: Die chinesischen Modelle sind klüger. Die Kosten pro Aufgabe sagen: Metas Modell ist günstiger im Betrieb. Die Eingabe sagt: Nur Muse Spark Open kann eine Sprachnachricht anhören oder eine Bildschirmaufnahme ansehen.
Muse Spark Open gewinnt diesen Vergleich nicht bei der Intelligenz. Es gewinnt beim Preis der Intelligenz: 39 Punkte für 84 Cent pro Aufgabe gegenüber 44 oder 45 Punkten für rund zwei Dollar.
Was Meta tatsächlich veröffentlicht hat
Muse Spark Open ist die herunterladbare Version von Muse Spark, der Modellfamilie von Meta Superintelligence Labs, die Meta bisher nur über die eigene API angeboten hat. Es ist ein Mixture-of-Experts-Modell: 256 Experten pro Schicht, ein Router wählt pro Token 8 davon aus, sodass von 816 Milliarden Parametern etwa 42 Milliarden pro Token rechnen. Es liest Text, Bilder, Audio und Video, schreibt Text und hat ein Kontextfenster von 1 Million Tokens. Laut Model Card stammen die Trainingsdaten aus mehr als 100 Sprachen.
Meta hat es für Coding und Agenten gebaut. Im Launch-Beitrag läuft Muse Code, Metas Coding-Agent, mit Muse Spark Open komplett auf zwei Mac Studios: Er liefert Bugfixes und Features für Ice Cubes, einen Open-Source-Mastodon-Client für iOS, und steuert DaVinci Resolve von Anfang bis Ende, inklusive Sichtung des Materials Bild für Bild. Die Ankündigung auf Hugging Face zeigt zusätzlich einen Browser-Agenten, der nur Screenshots sieht, ohne DOM oder HTML.
Zwei Details sind in der Praxis wichtig:
- Reasoning lässt sich nicht abschalten. Sie wählen
low,medium,highoderxhigh, Standard istxhigh. Für einfache Aufgaben setzen Sielowexplizit, sonst bezahlen Sie für Denken, das Sie nicht brauchen. - Es ist der große Bruder von Muse Glimmer. Glimmer, im August erschienen, ist ein kleines dichtes Modell mit 30 Milliarden Parametern unter Apache 2.0, gedacht für den lokalen Betrieb. Beide teilen sich den Tokenizer, und Spark Open ist das größte Muse-Modell zum Herunterladen. Die gehosteten Muse-Spark-Versionen und Metas Flaggschiff Muse Wonder bleiben hinter Metas API.
Unabhängige Benchmarks: Was Artificial Analysis gemessen hat
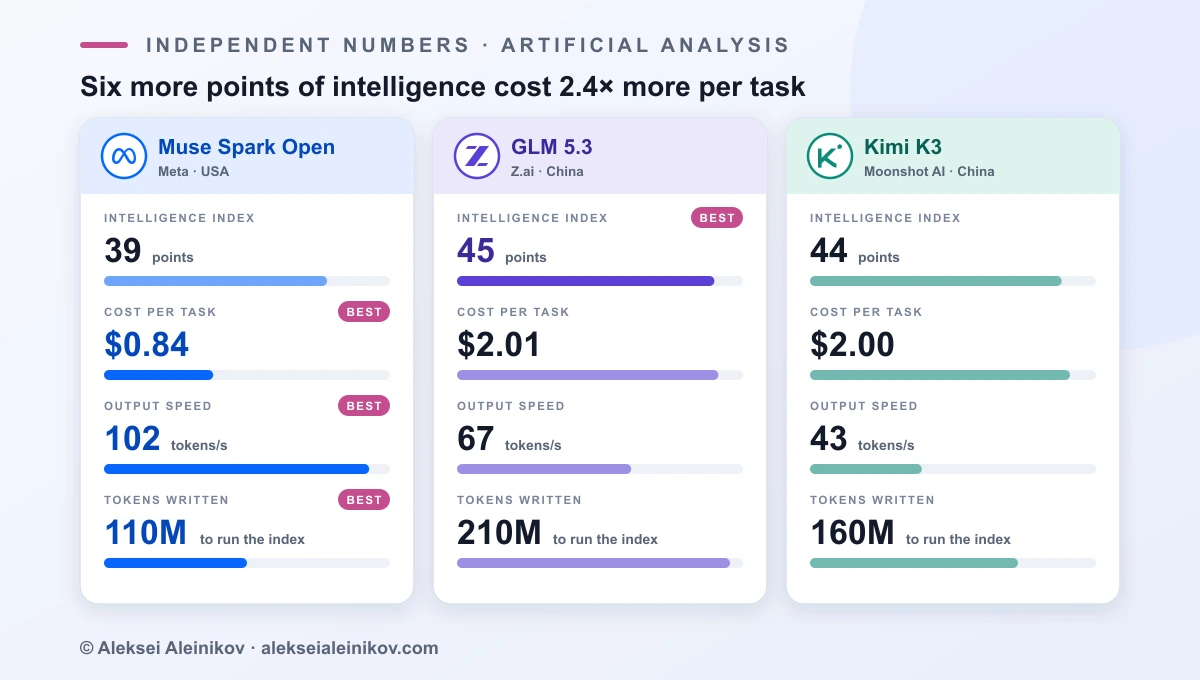
Herstellertabellen vergleichen Modelle auf Benchmarks, die der Hersteller ausgesucht hat. Artificial Analysis misst jedes Modell mit denselben zehn Tests, darunter Terminal-Bench 4.0, Humanity’s Last Exam, GDPval-AA und AA-LCR, und fasst sie zu einem Intelligence Index zusammen. Die Ergebnisse bei der jeweiligen Standard-Reasoning-Stufe:
| Artificial Analysis | Muse Spark Open (xhigh) | GLM 5.3 (max) | Kimi K3 (max) |
|---|---|---|---|
| Intelligence Index | 39 | 45 | 44 |
| Rang unter 119 vergleichbaren Modellen | 10 | 2 | 4 |
| Output-Tokens für den Index | 110 Mio. | 210 Mio. | 160 Mio. |
| Output-Geschwindigkeit | 102 Tokens/s | 67 Tokens/s | 43 Tokens/s |
| Kosten pro Index-Aufgabe | 0,84 $ | 2,01 $ | 2,00 $ |
Platz 10 klingt schlechter, als er ist. Artificial Analysis fasst 119 Modelle als vergleichbar zusammen; der Median dieser Gruppe liegt bei 19 Punkten, alle drei liegen also weit darüber. GLM 5.3 steht auf Platz 2, Kimi K3 auf Platz 4.
In dieser Gruppe liegt nur Xiaomis MiMo-V2.6-Pro mit 46 Punkten vor allen dreien. Die präzise Version von Metas Behauptung ist also die aus der Überschrift: Muse Spark Open ist das stärkste Open-Weight-Modell eines US-Labors. Metas eigene Tabelle stützt das, mit Nvidias Nemotron 3 Ultra bei 23 und Inkling bei 26 Punkten.
Wo Muse Spark Open gewinnt und wo es verliert
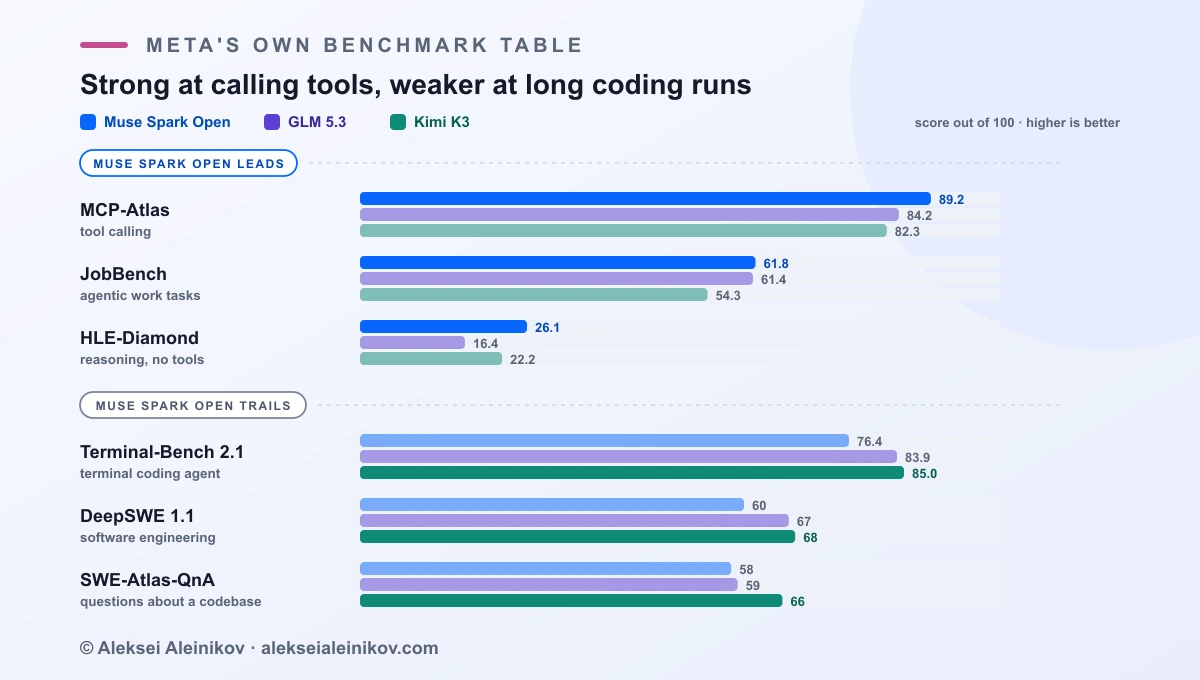
Metas Model Card vergleicht Muse Spark Open mit sieben Open-Weight-Modellen, darunter Mistral Large 4, Beam und Qwen3.8. Das sind die Zeilen für GLM 5.3 und Kimi K3:
| Metas Benchmark-Tabelle | Muse Spark Open | GLM 5.3 | Kimi K3 |
|---|---|---|---|
| MCP-Atlas (Tool Calling) | 89,2 | 84,2 | 82,3 |
| JobBench (agentische Arbeitsaufgaben) | 61,8 | 61,4 | 54,3 |
| HLE-Diamond, ohne Tools (Reasoning) | 26,1 | 16,4 | 22,2 |
| AA-Omniscience (Wissen minus Halluzination) | 25 | 14 | 20 |
| Toolathlon Verified | 72,8 | 73,0 | 76,5 |
| SciCode | 58,5 | 59,0 | 59,5 |
| HLE mit Tools | 61,0 | 62,5 | 56,0 |
| GPQA Diamond | 89,0 | 91,7 | 93,5 |
| Terminal-Bench 2.1 | 76,4 | 83,9 | 85,0 |
| DeepSWE 1.1 | 60 | 67 | 68 |
| SWE-Atlas-QnA | 58 | 59 | 66 |
| GDPval-AA v2 (Elo) | 1.401 | 1.653 | 1.537 |
Das Muster ist eindeutig. Muse Spark Open ist am stärksten, wo ein Agent Tools aufruft und ohne Tools nachdenkt: Bei MCP-Atlas führt es mit fünf Punkten, bei HLE-Diamond ohne Tools schlägt es GLM 5.3 um fast zehn. Der Vorsprung bei AA-Omniscience bedeutet: Es halluziniert weniger im Verhältnis zu dem, was es weiß. Am schwächsten ist es, wo ein Agent lange Code schreibt und ausführt: Bei Terminal-Bench 2.1 liegt es fast neun Punkte hinter Kimi K3, bei DeepSWE acht. Bei professioneller Wissensarbeit (GDPval-AA) liegt GLM 5.3 weit vorn.
Bei Bildern ist nur Kimi K3 ein fairer Gegner, weil GLM 5.3 keine Bilder liest. Metas Tabelle teilt dieses Duell auf: Muse Spark Open führt bei ZeroBench (50,0 vs. 41,0), SimpleVQA (73,6 vs. 71,9) und IntPhys2 (68,3 vs. 60,3), Kimi K3 bei BabyVision (85,7 vs. 80,2), VideoMME v2 (65,4 vs. 61,5) und bei der Computersteuerung in OSWorld Verified (84,8 vs. 80,4).
Das Harness-Problem: gleicher Benchmark, andere Zahlen
Schauen Sie genau auf Terminal-Bench 2.1. Meta hat alle Modelle im selben Agenten gemessen, Terminus 2, und berichtet 83,9 für GLM 5.3 und 85,0 für Kimi K3. Die Model Cards der Anbieter nennen 88,2 für GLM 5.3 und 88,3 für Kimi K3, beide gemessen in Claude Code. Die Modelle haben sich nicht verändert, nur der Agent drumherum.
Das ist kein Skandal, so funktionieren agentische Benchmarks: Das Harness ist Teil des Ergebnisses. Z.ais eigene Model Card führt Kimi K3 in Claude Code ebenfalls mit 88,3, passend zu Moonshot. Und es gilt in beide Richtungen: Die 76,4 von Muse Spark Open sind ebenfalls ein Terminus-2-Wert, einen Claude-Code-Wert hat Meta nicht veröffentlicht. Daraus folgen zwei Regeln:
- Vergleichen Sie Zahlen aus einer Tabelle, nie über Tabellen hinweg. Metas Tabelle ist in sich konsistent; die Mischung mit Hersteller-Cards ist es nicht.
- Testen Sie in Ihrem eigenen Agenten. Wenn Ihr Team Claude Code, opencode oder Codex nutzt, zählt die Rangfolge in genau diesem Werkzeug. Warum das Harness so viel ausmacht, zeigt mein Vergleich von opencode, Codex und Claude Code.
Der echte Preis: geschriebene Tokens, nicht der Preis pro Token
Auf der Preisliste sehen Muse Spark Open und GLM 5.3 fast gleich aus: 1,25 $ gegenüber 1,40 $ pro Million Input-Tokens, 4,25 $ gegenüber 4,40 $ pro Million Output-Tokens. Kimi K3 ist mit 3,00 $ und 15,00 $ klar teurer. Trotzdem hat Artificial Analysis für dieselbe Arbeit 0,84 $ bei Muse Spark Open und 2,01 $ bei GLM 5.3 gemessen.
Der Unterschied liegt darin, wie viel jedes Modell schreibt. Für den gesamten Intelligence Index hat GLM 5.3 210 Millionen Output-Tokens erzeugt, Kimi K3 160 Millionen und Muse Spark Open 110 Millionen. Bei dauerhaft aktivem Reasoning sind die Denk-Tokens der größte Teil davon, und Sie bezahlen jeden einzelnen. Der Cache-Rabatt trägt etwas bei: 88 % bei Muse Spark Open gegenüber 81 % bei GLM 5.3.
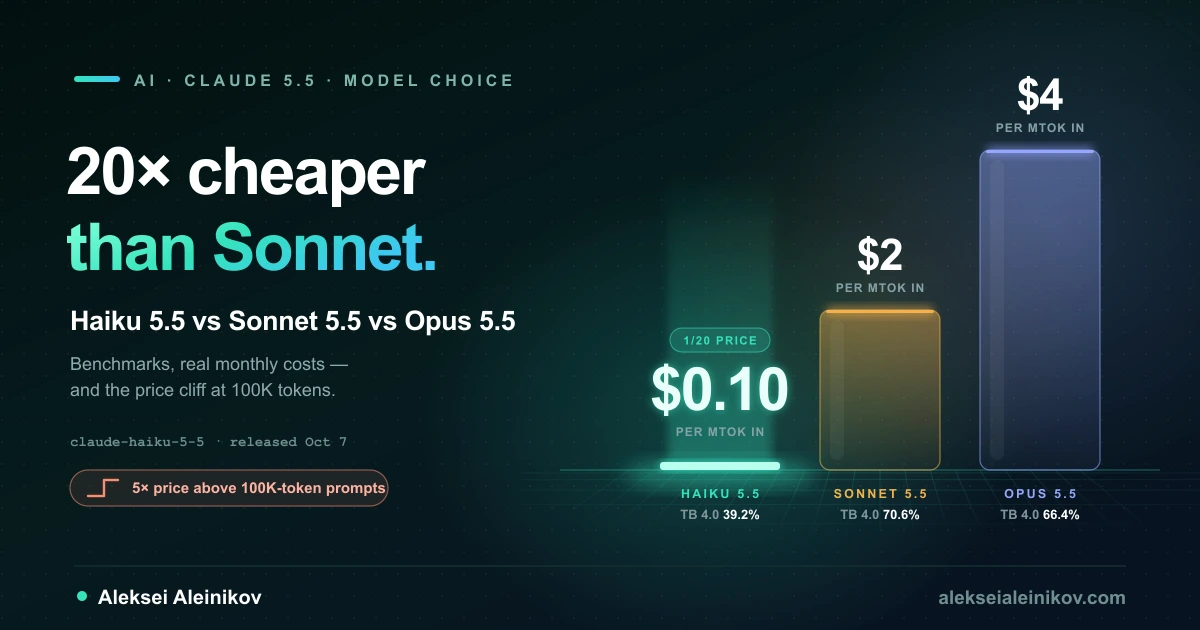
Das ändert, wie man Modellpreise liest. Ein niedrigerer Preis pro Token bedeutet wenig, wenn das Modell doppelt so lange nachdenkt; Ihre Rechnung sagt die Zahl voraus, die eine erledigte Aufgabe auf Ihrem eigenen Workload kostet. Dieselbe Logik entscheidet, ob Claude Haiku 5.5, Sonnet 5.5 oder Opus 5.5 günstiger ist.
Drei Einschränkungen, bevor Sie mit 0,84 $ planen:
-
Billig ist keines der drei. Artificial Analysis nennt als Medianpreis vergleichbarer Modelle 0,43 $ pro Million Input-Tokens und 1,59 $ pro Million Output-Tokens. Muse Spark Open ist das günstigste dieser drei, nicht des Marktes.
-
Preise hängen vom Anbieter ab. Die Zahlen oben sind die von Together AI für Muse Spark Open und die der Hersteller-APIs für GLM 5.3 und Kimi K3. Fireworks, Groq, Baseten, Modal, Nebius und OpenRouter hosten Muse Spark Open mit eigenen Preisen und Limits; Groq begrenzt den Kontext zum Beispiel auf 131.072 statt 1 Million Tokens.
-
Geschwindigkeit ist Anbieter-Geschwindigkeit. 102 Tokens pro Sekunde hat Artificial Analysis über die API gemessen. Auf eigener Hardware hängt der Durchsatz von GPUs und Serving-Stack ab.
Was es braucht, um jedes Modell selbst zu hosten
Alle drei sind Open-Weight, aber „offen“ deckt sehr unterschiedliche Hardware-Budgets ab. Mixture-of-Experts-Modelle müssen alle Experten im Speicher halten, auch wenn jedes Token nur wenige nutzt. Die Gesamtzahl der Parameter bestimmt also den Speicher, die aktiven Parameter die Geschwindigkeit.
| Selbst hosten | Muse Spark Open | GLM 5.3 | Kimi K3 |
|---|---|---|---|
| Veröffentlichte Gewichte | NVFP4 und BF16 | FP8 | MXFP4 (quantisierungsbewusst trainiert) |
| Speicher für die Gewichte | ≥700 GB (NVFP4), 2 TB (BF16), laut Meta | ~753 GB in FP8 (meine Rechnung) | ~1,56-TB-Checkpoint |
| Kleinstes Rechenzentrums-Setup | 1 Knoten mit 8× B200 (NVFP4), 8× H200 für 1 Mio. Kontext | 1 Knoten mit 8× H200 (meine Schätzung) | Mehr als 8× B200; 8× B300 oder zwei Knoten (meine Schätzung) |
| Auf dem Mac | 2× Mac Studio M5 Ultra mit je 512 GB (Meta); 3-Bit auf einem M3 Ultra mit 512 GB bei ~21 Tokens/s | Nur Community-Quantisierungen | Nicht realistisch |
| Serving-Engines | SGLang, vLLM, TensorRT-LLM, Transformers, MLX, llama.cpp, Unsloth | SGLang, vLLM, TokenSpeed, Transformers, KTransformers, Unsloth, Ascend-NPUs | vLLM, SGLang, TokenSpeed |
Wo „meine Rechnung“ oder „meine Schätzung“ steht, sind das Gewichte in der veröffentlichten Präzision geteilt durch den GPU-Speicher: 8× H200 ergeben 1.128 GB, 8× B200 1.440 GB. KV-Cache und Aktivierungen kommen hinzu. Für Muse Spark Open rechnet Hugging Face mit etwa 250 KB KV-Cache pro Token in BF16, also 266 GB für einen vollen Kontext von 1 Million Tokens. Deshalb empfiehlt Hugging Face für das volle Fenster den Endpoint mit 8× H200.
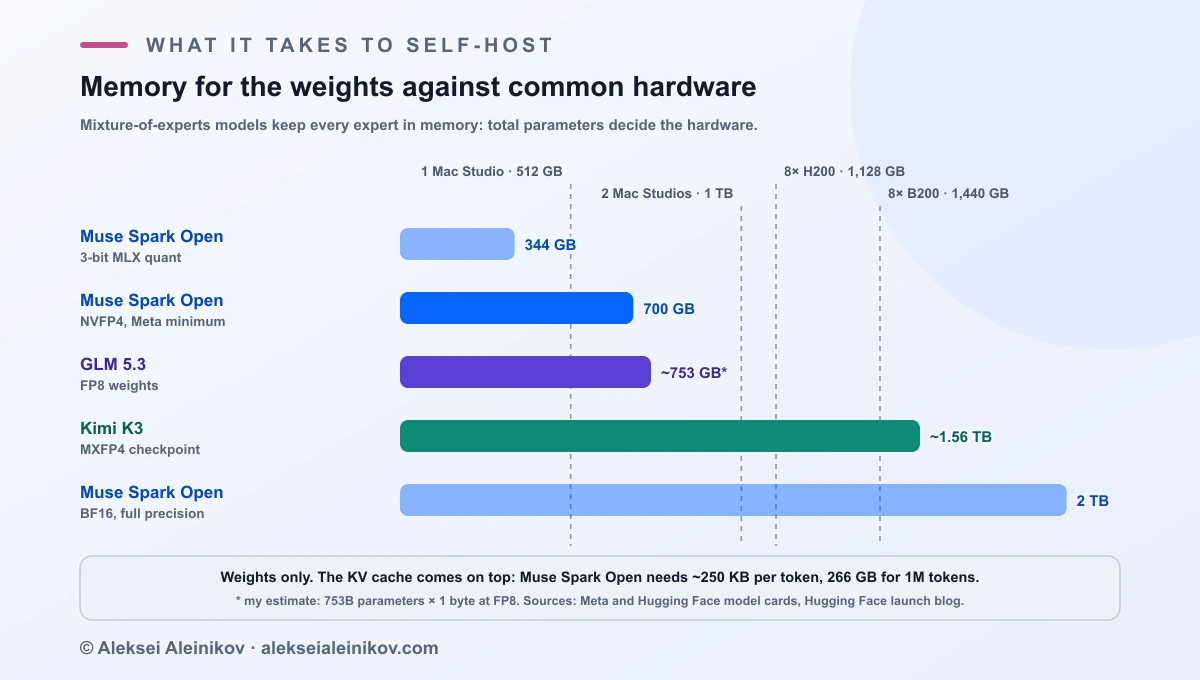
Die Mac-Studio-Geschichte stimmt, ist aber schmal. Zwei Mac Studios mit M5 Ultra und je 512 GB halten das ganze Modell im Unified Memory, und Hugging Face hat für eine 3-Bit-Version auf einem einzelnen M3 Ultra 21 Tokens pro Sekunde gemessen. Das reicht für eine Entwicklerin oder einen Entwickler, nicht für ein Team. Apples M5 Ultra mit 512 GB ist außerdem noch nicht im Handel; praktisch bleibt vorerst ein gemieteter GPU-Knoten oder eine API. Was Quantisierung mit der Qualität macht und wann 3 Bit noch reichen, erklärt mein Leitfaden zur Quantisierung; für die Wahl des Serving-Stacks vLLM vs Ollama.
Lizenzen: Das Kleingedruckte entscheidet über die kommerzielle Nutzung
Alle drei Lizenzen beginnen wie MIT: kostenlos nutzen, kopieren, verändern, feintunen und weitergeben. Danach fügt jede eigene Bedingungen hinzu, und die unterscheiden sich stärker als die Benchmarks.
| Lizenzklausel | Muse Spark Open | GLM 5.3 | Kimi K3 |
|---|---|---|---|
| Kostenlose kommerzielle Nutzung | Ja, mit Bedingungen | Ja | Ja, mit Bedingungen |
| Namensnennung im Produkt | Immer: „Built with Muse Spark Open“ in UI, Doku, Website oder Einstellungen | Nur Copyright-Hinweis in Kopien | „Kimi K3“ in der UI ab 100 Mio. monatlichen Nutzern oder 20 Mio. $ Monatsumsatz |
| Schwelle für Model-as-a-Service | Ab 20 Mio. $ Jahresumsatz: separater Vertrag mit Meta | Ab 10 Mrd. $ Jahresumsatz: Sicherheitsprüfung durch Z.ai | Ab 20 Mio. $ Jahresumsatz: separater Vertrag mit Moonshot |
| Download-Sperre auf Hugging Face | Voller Name, Geburtsdatum, Firmenangaben | Keine | Keine |
So lesen Sie das in der Praxis:
- GLM 5.3 ist am freizügigsten. Die einzige echte Bedingung trifft Unternehmen, die Modellzugriff verkaufen und mehr als 10 Milliarden Dollar Umsatz machen. Für alle anderen verhält es sich wie MIT.
- Muse Spark Open verlangt überall sichtbare Nennung. Jedes Produkt damit muss irgendwo „Built with Muse Spark Open“ zeigen, und die Lizenz behandelt jedes Modell, das mit seinen Ausgaben trainiert, feingetunt oder destilliert wurde, als Derivat unter denselben Bedingungen. Eine Usage Policy ist Teil der Lizenz; sie schließt militärische und ITAR-bezogene Nutzung, den Betrieb kritischer Infrastruktur und die Nutzung durch Minderjährige unter 18 aus. Lizenzgeber für Europa ist Meta Platforms Ireland Limited.
- Kimi K3 liegt dazwischen. Interne Nutzung ist ausgenommen, ebenso die Nutzung über Moonshots offizielle Produkte oder zertifizierte Inferenz-Partner.
Die Model-as-a-Service-Klauseln betreffen Sie, wenn Sie Inferenz weiterverkaufen: eine KI-Plattform, ein API-Reseller, ein SaaS mit direktem Modellzugriff. Wenn das Modell nur Funktionen Ihres eigenen Produkts antreibt, nehmen alle drei Lizenzen Sie davon aus.
Sicherheit: weniger Jailbreaks, mehr Ablehnungen
Meta hat die offene Version zusätzlich auf Sicherheit nachtrainiert und misst den Unterschied in der Model Card gegen dieselben Konkurrenten:
| Metas Sicherheitstests (niedriger ist besser) | Muse Spark Open | GLM 5.3 | Kimi K3 |
|---|---|---|---|
| StrongREJECT v2, adaptive Jailbreaks | 0,5 | 62,9 | 66,6 |
| FORTRESS, adversarialer Risiko-Score | 5,8 | 28,2 | 26,7 |
| FORTRESS, Über-Ablehnungs-Score | 17,4 | 3,2 | 2,7 |
Die ersten zwei Zeilen sagen: Muse Spark Open ist viel schwerer zu jailbreaken. Die dritte Zeile ist der Preis dafür: Es lehnt harmlose Anfragen fünf- bis sechsmal so oft ab wie die chinesischen Modelle. Meta berichtet außerdem, dass Muse Spark Open in seinem internen Benchmark 99,2 % der Jailbreaks für Cyber-Missbrauch abgelehnt hat, Kimi K3 75,5 %.
GLM 5.3 steht am anderen Ende. Z.ai schreibt, dass sich mit dem Ausbau des Post-Trainings die Cyber-Fähigkeiten „schneller entwickelt haben als erwartet“, und meldet einen Bestwert bei der Schwachstellensuche in CyberGym (84,5). Für ein Red Team ist das ein Vorteil; für einen Kundenassistenten heißt es, dass Ihre eigenen Leitplanken mehr Last tragen. Metas Rat gilt für alle drei: Setzen Sie das Modell in einem System mit Guardrails ein und lassen Sie unumkehrbare Aktionen von einem Menschen bestätigen.
Welches Modell sollten Sie nehmen?
| Wenn Ihre Priorität … ist | Wählen Sie | Warum |
|---|---|---|
| Agenten, die vor allem Tools und APIs aufrufen | Muse Spark Open | Höchste Werte bei MCP-Atlas und JobBench, am schnellsten, am günstigsten pro Aufgabe |
| Audio, Video oder Bildschirmaufnahmen als Eingabe | Muse Spark Open | Als einziges der drei versteht es Audio und Video |
| Strenges Jailbreak-Profil für eine öffentliche App | Muse Spark Open | Niedrigste Jailbreak-Werte in Metas Tests, auf Kosten von mehr Ablehnungen |
| Lange autonome Coding-Sitzungen | Kimi K3 | Beste Werte bei Terminal-Bench, DeepSWE und SWE-Atlas |
| Das klügste offene Modell mit der einfachsten Lizenz | GLM 5.3 | Höchster Intelligence Index, MIT-artige Lizenz, passt auf einen 8×-H200-Knoten |
| Sicherheitsforschung und Schwachstellenanalyse | GLM 5.3 | Stärkste veröffentlichte Cyber-Ergebnisse der drei |
| Ein Modell, das eine Person zu Hause betreiben kann | Muse Spark Open | Offiziell auf Mac Studio mit MLX unterstützt; GLM 5.3 nur über Community-Quantisierungen, Kimi K3 passt nicht |
Wenn nichts davon den Ausschlag gibt, schicken Sie Ihre 20 wichtigsten Aufgaben über eine gehostete API durch alle drei, bevor Sie Hardware kaufen. Bei diesen Preisen kostet das weniger als eine Stunde Entwicklerzeit, und es ist der einzige Benchmark mit Ihrem Harness, Ihren Prompts und Ihrer Definition von „erledigt“.
Fazit
Muse Spark Open ist das stärkste Open-Weight-Modell eines US-Labors, und Metas Überschrift ist da präzise. Das stärkste Open-Weight-Modell ist es nicht: GLM 5.3 und Kimi K3 liegen auf dem unabhängigen Index vorn und bei langen Coding-Aufgaben deutlich vorn. Meta hat stattdessen das effizienteste der drei gebaut. Es antwortet mit etwa halb so vielen Tokens, ist schneller, kostet pro Aufgabe etwa 2,4-mal weniger, versteht Audio und Video und ist am schwersten zu jailbreaken.
Damit lässt sich die Wahl einfach formulieren. Geht es ums Programmieren, machen Kimi K3 oder GLM 5.3 die Arbeit besser. Geht es um Agenten, die im großen Stil Tools aufrufen, oder um multimodale Eingaben, macht Muse Spark Open sie gut genug für deutlich weniger Geld. Prüfen Sie vor dem Launch die Lizenz: Der Hinweis „Built with Muse Spark Open“ ist keine Option.
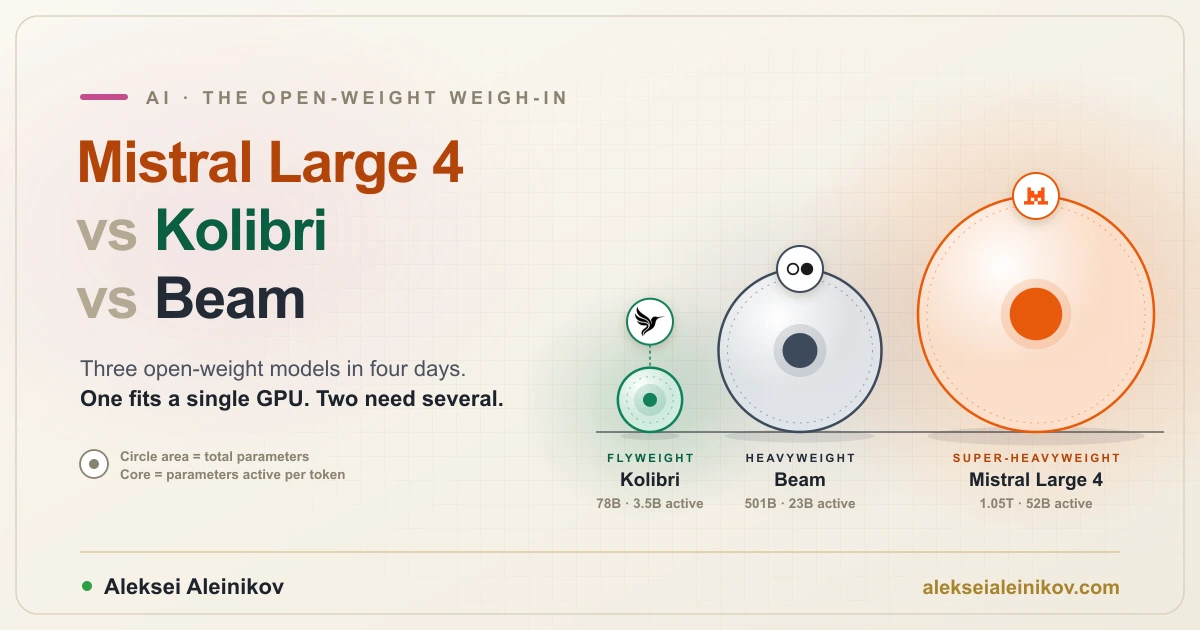
Wie sich die europäischen Open-Weight-Modelle schlagen, zeigt mein Vergleich von Mistral Large 4, Kolibri und Beam, inklusive der Hardware, die jedes Modell braucht.
Aus der Community
Diskussion auf Mastodon & Bluesky
Antworten auf diesen Artikel aus dem offenen Netz, live geladen. Keine Werbung, keine Tracking-Skripte.
Antworte dort — es erscheint hier automatisch.