Innerhalb von vier Tagen wurden drei Open-Weight-Sprachmodelle angekündigt. Am 3. Oktober 2026, dem Tag der Deutschen Einheit, veröffentlichte Aleph Alpha Kolibri, ein deutsch-englisches Modell. Am 5. Oktober stellte Reflection AI Beam vor, ein Modell mit 501 Milliarden Parametern. Am 6. Oktober startete Mistral AI Mistral Large 4, ein Modell mit einer Billion Parametern, das Mistral selbst „le Chonk“ nennt. Die Suchanfragen nach Open-Source-KI und selbst gehosteten Modellen stiegen schon vor dieser Woche — jetzt lautet die Frage: Welches davon läuft auf meinen eigenen GPUs?
Die ehrliche Antwort beginnt mit zwei Korrekturen. Das sind keine drei Konkurrenten, sondern drei Gewichtsklassen: Das kleinste Modell aktiviert pro Token fünfzehnmal weniger Parameter als das größte. Und am 12. Oktober lässt sich nur eines der drei tatsächlich herunterladen. Dieser Vergleich geht durch, was die Anbieter veröffentlicht haben: Release-Status, Lizenzen, Architektur, jeden Benchmark, den mindestens zwei von ihnen berichten, den Speicherbedarf und was „souverän“ bei jedem Modell bedeutet.
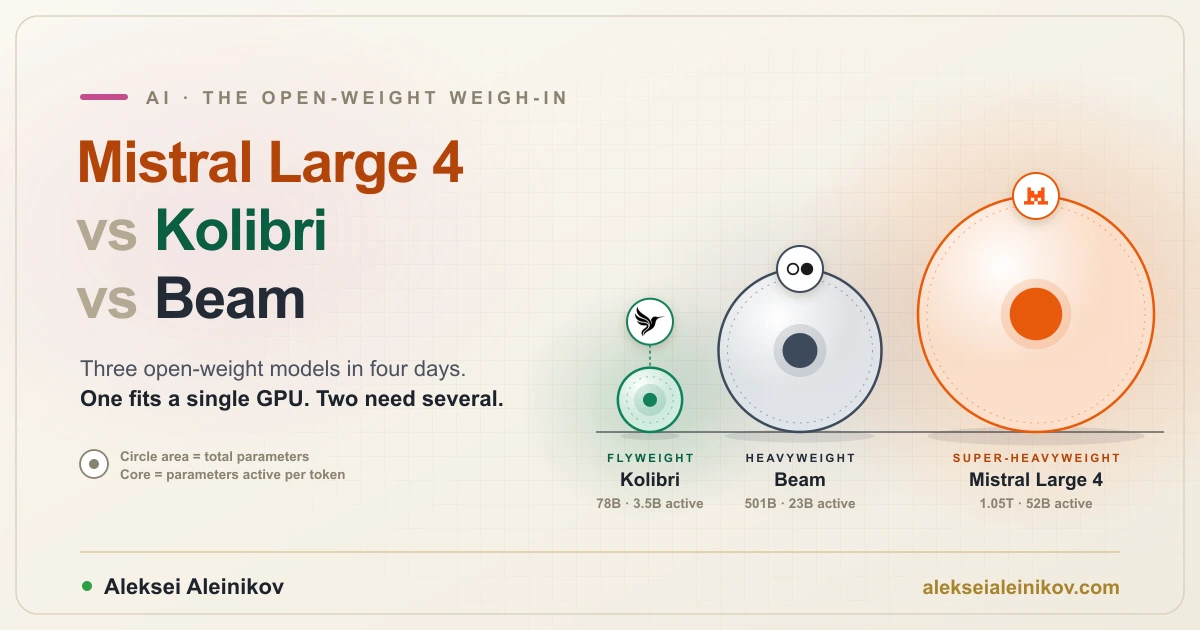
Mistral Large 4 vs Kolibri vs Beam im Überblick
Die Angaben stammen aus Mistrals Ankündigung und Modellseite, Aleph Alphas Ankündigung und Kolibris Model Card sowie Reflections Beam-Ankündigung.
| Mistral Large 4 | Kolibri | Beam | |
|---|---|---|---|
| Anbieter | Mistral AI (Frankreich) | Aleph Alpha (Deutschland) | Reflection AI (USA) |
| Angekündigt | 6. Oktober 2026 | 3. Oktober 2026 | 5. Oktober 2026 |
| Gewichte | „Bis Ende des Monats“ | Jetzt auf Hugging Face | „Später in diesem Monat“ |
| Lizenz | Noch nicht veröffentlicht | Apache 2.0 | Apache 2.0 (angekündigt) |
| Heute nutzbar als | API Public Preview | Self-Hosting | Warteliste (Early Access) |
| Architektur | Mixture-of-Experts | Mixture-of-Experts, 384 Experten | Sparse Mixture-of-Experts |
| Parameter gesamt | ~1,05 Bio. (plus 1,6 Mrd. Vision-Encoder) | 78,1 Mrd. | 501 Mrd. |
| Aktive Parameter pro Token | 52 Mrd. | 3,46 Mrd. | 23 Mrd. |
| Eingabe | Text und Bilder | Text | Text |
| Kontextfenster | 1 Mio. (API) | 262.144 nativ, 1.048.576 validiert | 1 Mio. „effektiv“ |
| Sprachen | 160+, alle EU-Amtssprachen | Deutsch und Englisch | Nicht angegeben |
| Reasoning-Steuerung | Hybrid aus Instruct und Reasoning | Stufen none / low / medium / high |
Parameter für Reasoning-Effort |
| Pre-Training-Tokens | Nicht veröffentlicht | 20 Bio. (+3,44 Bio. Mid-Training) | 23,8 Bio. |
| Trainiert auf | 3.800 NVIDIA Grace Blackwell GPUs, Mistrals eigene Rechenzentren in Europa | 768 B200 GPUs in Deutschland und Finnland | 6.144 GB300 GPUs (Pre-Training), 10.500 GB300 (RL) |
| API-Preis pro Mio. Tokens | 1,36 $ Input · 4,18 $ Output | Kein öffentlicher API-Preis | Nicht veröffentlicht |
| Gebaut für | Coding, Agenten, Multimodal, Cybersecurity | Deutsch und Englisch in Unternehmen und Verwaltung | Coding und agentische Workloads |
Drei Zeilen entscheiden die meisten Fälle, bevor irgendein Benchmark ins Spiel kommt:
- Gewichte. Wenn Sie diesen Monat ein selbst gehostetes Modell in Produktion brauchen, ist der Vergleich vorbei: Nur Kolibri lässt sich herunterladen.
- Aktive Parameter. Sie bestimmen die Kosten pro Token — 3,46, 23 und 52 Milliarden sind drei verschiedene GPU-Budgets.
- Eingabe. Nur Mistral Large 4 liest Bilder. Gescannte PDFs, Diagramme oder technische Zeichnungen schließen die anderen beiden aus.
Das sind keine drei Rivalen. Kolibri ist ein deutsches Arbeitspferd für eine einzelne GPU, Beam ein Coding-Modell für einen Multi-GPU-Knoten, Mistral Large 4 ein Frontier-Modell für einen kompletten Blackwell-Server mit acht GPUs — und nur Kolibris Gewichte gibt es heute.
Nur eines der drei lässt sich heute herunterladen
„Open-Weight“ bedeutet in diesem Monat drei verschiedene Zustände:
- Kolibri — veröffentlicht. Die Gewichte liegen auf Hugging Face unter Apache 2.0. Die Lizenz gilt für Gewichte und Konfigurationsdateien in diesem Repository; Trainingscode, Architektur und Methoden behält Aleph Alpha ausdrücklich für sich.
- Beam — angekündigt. Laut Reflection läuft gerade das abschließende Red-Teaming. Gewichte, technischer Bericht, Model Card und Entwickler-Artefakte sollen „später in diesem Monat“ unter Apache 2.0 erscheinen. Bis dahin gibt es eine Warteliste.
- Mistral Large 4 — als gehostete Preview nutzbar. Die API funktioniert heute. Die Gewichte will Mistral bis Ende Oktober veröffentlichen und testet das Modell vorher mit Cybersecurity-Unternehmen, ausgewählten Partnern und staatlichen Stellen. Die Modellseite verlinkt ein Hugging-Face-Repository
mistralai/Mistral-Large-4-1T-A52Bmit dem Hinweis „Coming soon“ und nennt keine Lizenz.
Planen Sie keinen Produktionsstart auf Basis einer Lizenz, die noch niemand gelesen hat. Mistral hat für verschiedene offene Modelle schon unterschiedliche Lizenzbedingungen verwendet — warten Sie auf die tatsächliche Lizenzdatei, bevor Sie für Mistral Large 4 von Apache 2.0 ausgehen.
Mistral Large 4: Europas Billionen-Parameter-Modell
Mistral Large 4 ist das größte Modell, das Mistral je gebaut hat: ein Mixture-of-Experts mit rund 1,05 Billionen Parametern, davon 52 Milliarden pro Token aktiv, plus ein Vision-Encoder mit 1,6 Milliarden Parametern. Mistral nennt es ein Hybridmodell aus Instruct und Reasoning — ein Modell für schnelle Antworten und längeres Nachdenken. Trainiert wurde es von Grund auf auf 3.800 NVIDIA Grace Blackwell GPUs in Mistrals eigenen europäischen Rechenzentren; die Preview läuft auf derselben Infrastruktur.
Was Mistral hervorhebt:
- Coding und Agenten. 61,7 % auf DeepSWE v1.1, 59,4 % auf SWE-Atlas-QnA und 28,3 % auf Terminal-Bench 4, zusammen ein Coding Agent Index von 49,8 % — nach Mistrals Zahlen vor DeepSeek V4 Pro und Qwen3.8 Max. Auf AutomationBench, 657 Geschäftsabläufe in Apps wie Gmail, Sheets und Salesforce, erreicht es 59,9 %. In einer verblindeten Bewertung der Code-Qualität mit Surge AI landete es auf Platz zwei von fünf Modellen (3,74 von 5), hinter Claude Opus 5 (4,22) und vor Kimi K3 und GLM-5.3.
- Cybersecurity. Laut Mistral gehört das Modell beim Artificial Analysis Cyber Index zu den fünf besten weltweit, löst 93 % der 40 Cybench-Aufgaben und erreicht 82 % in einem Test, bei dem eine echte Schwachstelle reproduziert und gepatcht werden muss. Claude Opus 5.5 und GPT-6 Astra liegen dort laut Mistral nahe null, weil sie die Aufgabe verweigern. Für Security-Teams ist ein Modell, das Schwachstellenarbeit nach den eigenen Richtlinien erledigt, das eigentliche Argument für Self-Hosting — zugleich meldet Mistral bei bösartigen Cyber-Prompts eine höhere Ablehnungsquote als bei anderen offenen Modellen.
- Bilder. Mistral Large 4 liest Dokumente, Diagramme und Fotos. Beim Visual-Grounding-Test Dense 200 meldet Mistral 42 % gegenüber 41 % für GPT-6 Astra.
- Sprachen. Die Trainingsdaten umfassen über 160 Sprachen, darunter alle Amtssprachen der Europäischen Union.
- Robustheit gegen Prompt Injection. Auf Lakeras öffentlichem B3-Benchmark wehrt es 93,3 % der Angriffe ab — der höchste Wert, den Mistral unter offenen Modellen gesehen hat.
Preise. Die Preview-API kostet 1,36 $ pro Million Input-Tokens und 4,18 $ pro Million Output-Tokens, gecachter Input 0,14 $. Als ich am 12. Oktober nachgesehen habe, zeigte die Modellseite einen Einführungsrabatt von 50 %. Mistral betreibt außerdem ein europäisches Deployment „end-to-end, unabhängig von anderen digitalen Dienstleistern und nach europäischem Recht“ — nützlich, wenn Sie das Modell schon vor den Gewichten nutzen wollen, ohne Daten an einen US-Hyperscaler zu schicken.
Was fehlt. Keine Architekturdetails außer den Parameterzahlen, keine Zahl der Pre-Training-Tokens, keine deutschen Einzelwerte und keine Lizenz. Architektur, weitere Benchmarks und die Post-Training-Methode sollen mit den Gewichten kommen.
Kolibri: ein deutsches Modell für eine einzelne GPU
Kolibri ist Aleph Alphas Antwort auf eine engere Frage: Was ist das beste Modell für deutsch- und englischsprachige Unternehmensarbeit, das eine Firma auf einem einzigen Server betreiben kann? Es hat 78,1 Milliarden Parameter, aktiviert pro Token aber nur 3,46 Milliarden, verteilt auf 384 kleine Experten (sechs geroutete und ein geteilter pro Token). Vierzig der fünfzig Schichten sehen nur ein Sliding Window von 512 Tokens, jede fünfte Schicht den vollen Kontext. Das begrenzt den Speicher pro Token und macht lange Kontexte günstig.
Die Größenentscheidung begründet Aleph Alpha mit einer Betriebszahl: In ihren Tests schaffte eine 123B-Variante auf zwei H100 nur 3 gleichzeitige Anfragen mit 256K Tokens, das 78B-Modell dagegen 18 — und dekodierte 28 % schneller.
Was Kolibri auszeichnet:
- Deutsch von Grund auf. 21,3 % der Pre-Training-Tokens sind deutsch — rund 4,3 Billionen Tokens, überwiegend originärer oder umformulierter deutscher Webtext plus Parlamentsprotokolle und Rechtstexte. Maschinelle Übersetzung kam nur sparsam zum Einsatz. Der zweisprachige Tokenizer komprimiert deutschen Webtext mit 4,90 Bytes pro Token — stärker als jeder andere Tokenizer in Aleph Alphas Vergleich; was das spart, zeigt der Abschnitt unten.
- Es sagt „Ich weiß es nicht“. Aleph Alpha hat Kolibri mit Abstentionsdaten und dem eigenen Merlin-Arthur-Protokoll trainiert. Auf dem öffentlichen AA-Omniscience-Set enthält es sich bei 44 % der Aufgaben, statt falsch zu antworten (Vorgänger: 15 %). Für RAG über regulierte Dokumente ist eine Enthaltung besser als eine selbstbewusste Vermutung.
- Branchen-Evaluierungen. Aleph Alpha hat interne Testsuiten für die öffentliche Verwaltung in Deutschland, Automobilzulieferer, Halbleiter, Luft- und Raumfahrt sowie Antriebstechnik gebaut. Auf der Suite für die öffentliche Verwaltung erreicht Kolibri 75,0.
- Stark in seiner Gewichtsklasse. In Aleph Alphas eigenem Vergleich führt Kolibri unter den Mixture-of-Experts-Modellen ähnlicher Größe in beiden Sprachen:
| Modell (Harness von Aleph Alpha) | Aktive Parameter | Gesamt (EN) | Gesamt (DE) |
|---|---|---|---|
| Kolibri | 3,5 Mrd. | 75,5 | 70,8 |
| Qwen3.5 35B-A3B | 3 Mrd. | 74,7 | 69,8 |
| GPT-OSS 120B | 5,1 Mrd. | 72,3 | 70,2 |
| Nemotron 3 Super 120B-A12B | 12 Mrd. | 73,0 | 67,9 |
| Mistral Small 4 119B-A6B | 6 Mrd. | 63,1 | 61,4 |
| Qwen3.8 27B (dense) | 27 Mrd. | 80,2 | 79,9 |
Das dichte Qwen3.8 27B liegt noch vorn — mit fast achtmal so vielen aktiven Parametern pro Token.
Was deutscher Text in Tokens kostet
Der Unterschied der Tokenizer wird leicht unterschätzt. Auf demselben deutschen Webtext packt Kolibris Tokenizer 4,90 Bytes in jedes Token. Jeder andere Tokenizer in Aleph Alphas Vergleich braucht für dasselbe Dokument mehr Tokens: 13 % mehr bei GPT-5, 22 % mehr bei Tekken — dem Tokenizer früherer Mistral-Modelle —, 32 % mehr bei DeepSeek V4 und 49 % mehr bei Kimi K3.
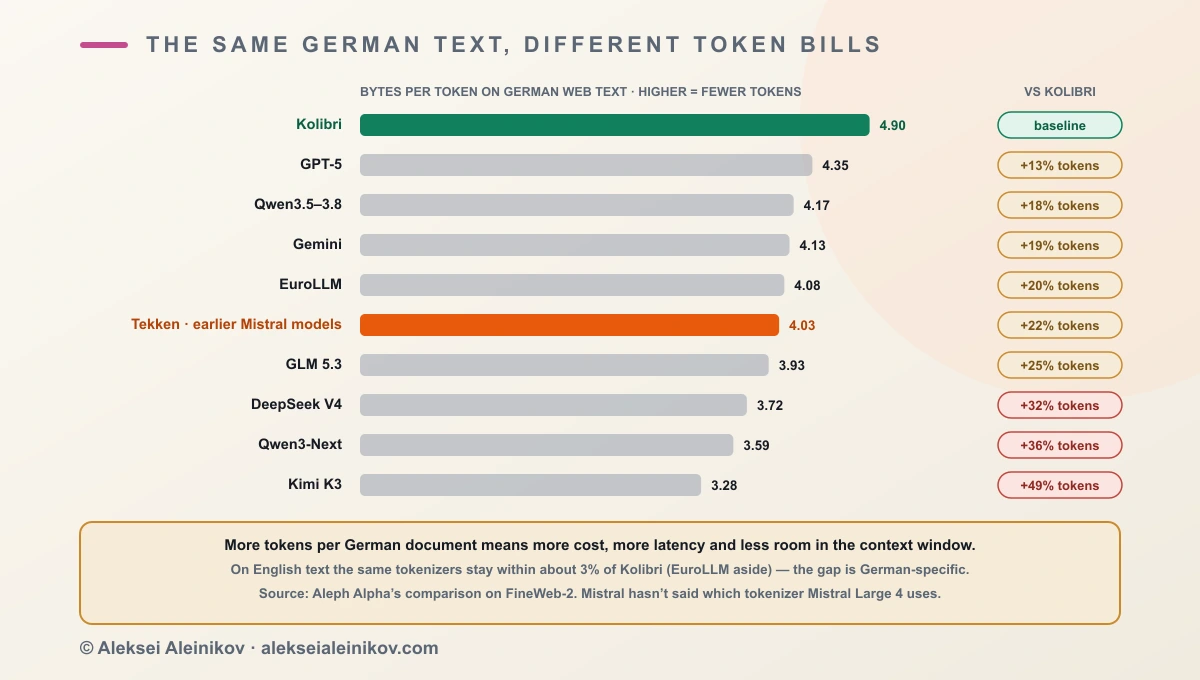
Tokens bezahlen Sie bei einer API, und Tokens füllen beim Self-Hosting GPU-Speicher und Kontextfenster — ein Workload mit viel Deutsch spürt den Unterschied also bei jeder Anfrage. Bei englischem Text verschwindet die Lücke: Dieselben Tokenizer liegen bis auf EuroLLM innerhalb von etwa 3 % um Kolibri. Ob Mistral Large 4 noch Tekken verwendet, hat Mistral nicht gesagt — lesen Sie diese Zeile also als Referenz für frühere Mistral-Modelle, nicht als Messung des neuen.
Für den Betrieb braucht Kolibri Aleph Alphas vLLM-Plugin, das Kolibris Parser für Reasoning und Tool Calls mitbringt:
pip install "aleph-alpha-inference>=1"
vllm serve Aleph-Alpha/Kolibri-1 --kv-cache-dtype fp8 \  --reasoning-parser kolibri1 \  --tool-call-parser kolibri1 \  --enable-auto-tool-choice
Der Endpunkt ist OpenAI-kompatibel, bestehende Clients funktionieren also; den Reasoning-Effort setzen Sie über chat_template_kwargs. Falls Sie noch keinen Inference-Server gewählt haben: Mein Vergleich vLLM vs. Ollama erklärt, warum ein solches Modell auf vLLM gehört und nicht in eine Desktop-Runtime.
Die Grenzen. Kolibri verarbeitet nur Text und ist bewusst zweisprachig — kein Französisch, Polnisch oder Spanisch. Bei schwierigem agentischem Coding liegt es hinter größeren Modellen: 27,7 % auf Terminal-Bench 2.1 gegenüber 80,1 % bei Beam, laut den jeweiligen Anbietertabellen. Und Aleph Alphas Model Card stellt klar, dass Kolibri in Systeme gehört, in denen ein Mensch die Ausgabe prüft — nicht in solche, in denen das Modell entscheidet.
Beam: Reflections Coding-Modell
Beam ist Reflection AIs erstes öffentliches Modell und für eine Aufgabe gebaut: Coding und agentische Arbeit. Es ist ein Sparse Mixture-of-Experts mit 501 Milliarden Parametern, 23 Milliarden davon pro Token aktiv, 52 Schichten und abwechselnd lokaler und globaler Attention. Vortrainiert wurde es auf 23,8 Billionen Tokens auf 6.144 NVIDIA GB300 GPUs in weniger als vier Wochen, danach weitere vier Wochen Reinforcement Learning auf 10.500 GB300 GPUs — über 100 Millionen Rollouts in fast einer Million Coding-, Agenten- und MINT-Umgebungen.
Reflection positioniert Beam ungewöhnlich offen: „konkurrenzfähig mit größeren offenen Modellen wie GLM 5.2 und nahe an Qwen 3.8-Max bei Coding und agentischen Aufgaben“, während „Frontier-Modelle wie Kimi K3 bei der reinen Leistung vorn bleiben“. Das Argument ist Effizienz: Reasoning-Werte auf dem Niveau von GLM-5.2 mit drei- bis viermal weniger Inferenz-Rechenaufwand.
Beams gemeldete Werte mit den Vergleichsmodellen aus Reflections eigener Tabelle:
| Benchmark | Beam | GLM 5.3 | Kimi K3 | Qwen 3.8 Max | DeepSeek V4.1 Flash |
|---|---|---|---|---|---|
| DeepSWE v1.1 | 44,4 | 61,0 | 68,0 | 51,0 | 74,2 |
| Terminal-Bench 2.1 | 80,1 | 88,2 | 88,3 | 86,6 | 90,6 |
| SWE-bench Verified | 80,9 | — | — | — | — |
| GPQA Diamond | 90,5 | 91,7 | 93,5 | 92,6 | 90,9 |
| Humanity’s Last Exam (ohne Tools) | 36,2 | 42,3 | 46,9 | 43,6 | 39,1 |
| MCP Atlas | 78,7 | 84,2 | 82,3 | 84,5 | — |
Reflection hat diese Zahlen am 8. Oktober aktualisiert, drei Tage nach dem Start.
Die Grenzen. Beam verarbeitet nur Text, die Ankündigung sagt nichts über Sprachen außer Code, und außerhalb der Early-Access-Gruppe hat es noch niemand betrieben. Sinnvoll ist: Beam für Coding-Agenten auf die Shortlist setzen und in der Woche testen, in der die Gewichte erscheinen.
Benchmarks: Was sich vergleichen lässt und was nicht
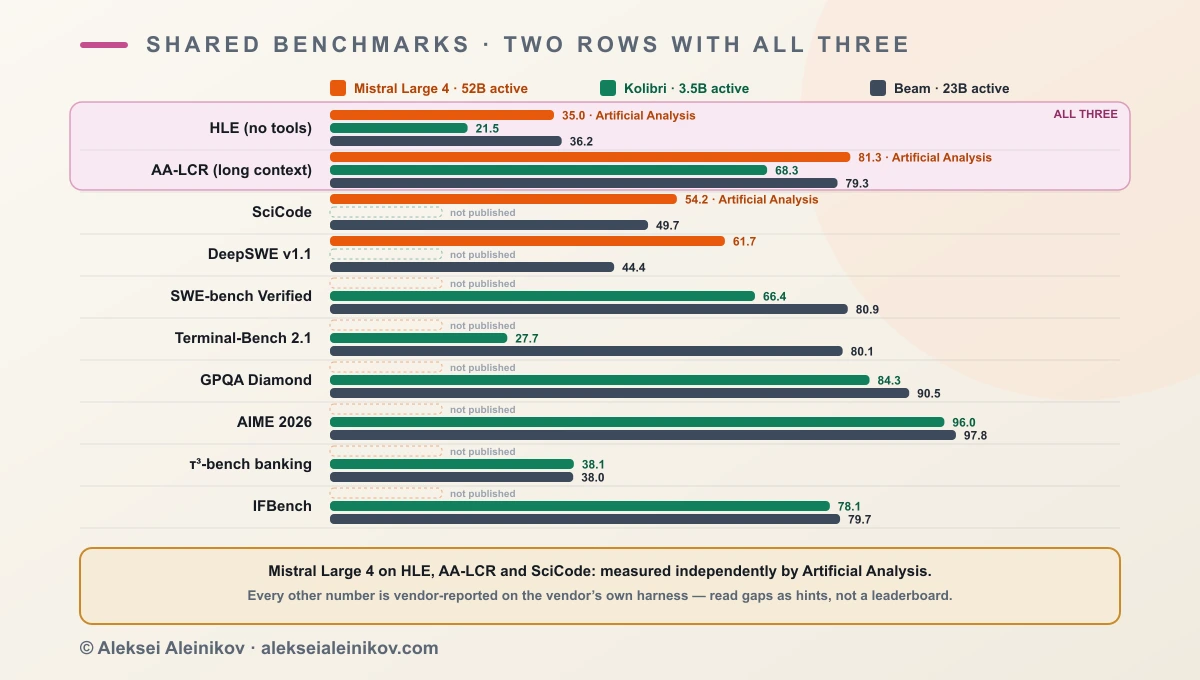
Kein Anbieter hat eine Tabelle mit allen drei Modellen veröffentlicht. Jeder hat eigene Evaluierungen gefahren, eigene Vergleichsmodelle gewählt und teils andere Benchmark-Versionen genutzt. Mistral hat GPQA, HLE, SWE-bench oder Long-Context-Werte gar nicht veröffentlicht — das unabhängige Labor Artificial Analysis hat die Preview von Mistral Large 4 aber bereits auf Humanity’s Last Exam, AA-LCR und SciCode gemessen — Benchmarks, die auch Reflection und bei den ersten beiden auch Aleph Alpha berichten. Damit ergänzt, hier jede Zeile, die mindestens zwei der drei abdecken:
| Benchmark | Mistral Large 4 | Kolibri | Beam |
|---|---|---|---|
| Humanity’s Last Exam, ohne Tools | 35,0¹ | 21,5 | 36,2 |
| AA-LCR (langer Kontext) | 81,3¹ | 68,3 | 79,3 |
| SciCode | 54,2¹ | — | 49,7 |
| DeepSWE v1.1 | 61,7 | — | 44,4 |
| SWE-bench Verified | — | 66,4 | 80,9 |
| Terminal-Bench 2.1 | — | 27,7 | 80,1 |
| GPQA Diamond | — | 84,3 | 90,5 |
| AIME 2026 | — | 96,0 | 97,8 |
| τ³-bench banking | — | 38,1 | 38,0 |
| IFBench | — | 78,1 | 79,7 |
| Aktive Parameter pro Token | 52 Mrd. | 3,5 Mrd. | 23 Mrd. |
¹ Gemessen von Artificial Analysis auf der API-Preview. Alle anderen Zahlen stammen von den Anbietern selbst, jeweils mit eigenem Harness. Die leeren Zellen habe ich in Mistrals Ankündigung, auf der Modellseite und im 189-seitigen technischen Bericht von Aleph Alpha gesucht — sie sind bisher nirgends veröffentlicht.
So lesen Sie die Tabelle:
- Zwei Zeilen enthalten jetzt alle drei. Bei Humanity’s Last Exam liegen Mistral Large 4 (35,0) und Beam (36,2) nah beieinander, Kolibri folgt mit 21,5. Beim Long-Context-Reasoning (AA-LCR) führt Mistral Large 4 mit 81,3, Beam folgt knapp mit 79,3, Kolibri erreicht 68,3 — mit einem Fünfzehntel der aktiven Parameter von Mistral.
- Beam schlägt Kolibri in sieben der acht gemeinsamen Zeilen — erwartbar bei fast siebenmal so vielen aktiven Parametern. Am größten ist der Abstand bei langen agentischen Schleifen (Terminal-Bench, SWE-bench), am kleinsten bei AIME und IFBench.
- τ³-bench banking ist das interessante Unentschieden. Es ist ein agentischer Kundenservice-Benchmark in einer regulierten Branche, und Kolibri hält mit Beam mit — bei etwa einem Siebtel des aktiven Rechenaufwands. Sieht Ihr Workload so aus, reicht vielleicht das kleine Modell.
- Mistral Large 4 gegen Beam: vier Zeilen, Mistral vorn in dreien. DeepSWE (61,7 vs. 44,4), SciCode (54,2 vs. 49,7) und AA-LCR (81,3 vs. 79,3); bei HLE liegt Beam 1,2 Punkte vorn. Reflections eigene Tabelle führt GLM 5.3 bei DeepSWE mit 61,0 — Mistral Large 4 liegt bei dieser Aufgabe also etwa auf dem Niveau von GLM 5.3.
- Mistral Large 4 gegen Kolibri: zwei Zeilen, beide für Mistral unabhängig gemessen. Mistral Large 4 führt in beiden deutlich — erwartbar bei fünfzehnmal so vielen aktiven Parametern.
Alle drei auf einer Skala
Über einzelne Benchmarks hinaus bewertet Artificial Analysis bewertet die Preview von Mistral Large 4 mit 38 auf seinem Intelligence Index — über dem Median von 26 für vergleichbare Modelle, bei durchschnittlich 1,13 $ pro Evaluierungsaufgabe. Kolibri und Beam stehen dort noch nicht. Beide Anbieter haben ihre Modelle aber mit Modellen verglichen, die Artificial Analysis gemessen hat — und das grenzt sie ein:
- Beam schlägt in Reflections eigener Tabelle Inkling (Index 25) in 13 von 15 Zeilen, GLM-5.2 (34) in 8 von 13 und verliert gegen DeepSeek V4.1 Flash (39) in 7 von 9. Damit liegt es etwa auf dem Niveau von GLM-5.2 — passend zu Reflections eigener Beschreibung.
- Kolibri liegt im Durchschnitt von Aleph Alphas Tabelle über Qwen3.6 35B-A3B (18) und unter dem dichten Qwen3.8 27B (34).
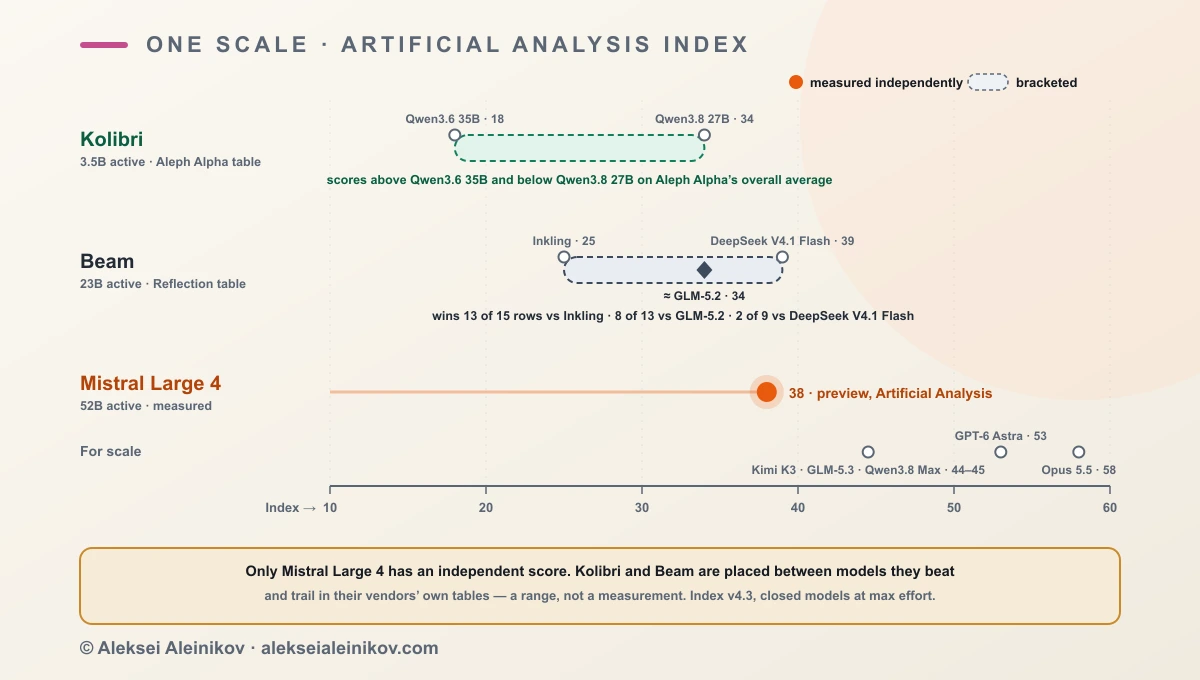
Eine Eingrenzung ist keine Messung: Sie setzt voraus, dass die Vergleiche der Anbieter auch auf einem unabhängigen Harness halten. Aber es ist die erste gemeinsame Skala für alle drei. Mistral Large 4 landet neben DeepSeek V4.1 Flash und wenige Punkte unter den stärksten offenen Modellen — Kimi K3, GLM-5.3 und Qwen3.8 Max mit 44–45. Beam landet vermutlich etwas unter Mistral Large 4. Kolibri erreicht mit 3,5 Mrd. aktiven Parametern höchstens das Niveau eines dichten 27B-Modells. Noch ein Detail von derselben Seite: Artificial Analysis führt das Kontextfenster der Preview mit 524K Tokens — halb so viel wie die 1 Mio. auf Mistrals Modellseite.
Die praktische Lesart ist dieselbe wie bei geschlossenen Modellen: Anbietertabellen zeigen, wo Sie hinschauen sollten, nicht, was Sie kaufen sollten. Beim Vergleich von GPT-6.1 Sol und Claude Opus 5.5 kamen die entscheidenden Zahlen aus der Preisliste, nicht aus dem Leaderboard. Bei selbst gehosteten Modellen kommen sie aus Ihrem GPU-Budget.
Hardware: Was jedes Modell zum Laufen braucht
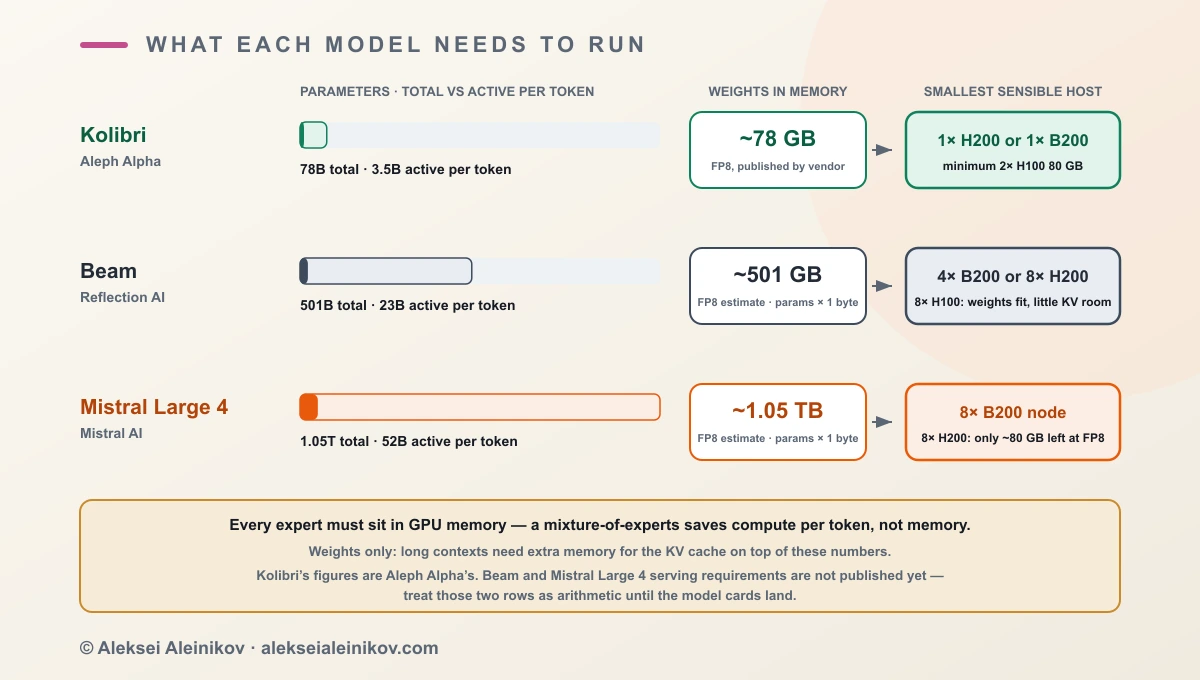
Ein Mixture-of-Experts-Modell spart Rechenaufwand pro Token, aber keinen Speicher. Jeder Experte muss im GPU-Speicher liegen, weil der Router für das nächste Token jeden von ihnen wählen kann. Der Speicherbedarf folgt also den gesamten Parametern, Geschwindigkeit und Kosten pro Token folgen den aktiven.
Für die Gewichte allein gilt die Faustregel Parameter × Bytes pro Parameter: 2 Bytes in BF16, 1 Byte in FP8, etwa ein halbes Byte in 4-Bit.
| Kolibri | Beam | Mistral Large 4 | |
|---|---|---|---|
| Gewichte in FP8 | ~78 GB (veröffentlicht) | ~501 GB (Schätzung) | ~1,05 TB (Schätzung) |
| Gewichte in 4-Bit | ~39 GB | ~250 GB | ~525 GB |
| Kleinster sinnvoller Host | 1× H200 oder 1× B200 | 4× B200 oder 8× H200 | 8× B200 |
| Auf Google Cloud | A3 High mit 2× H100 | A3 Ultra oder A4, voller Knoten | A4, voller Knoten |
| Quelle | Model Card von Aleph Alpha | Meine Rechnung | Meine Rechnung |
Drei Dinge, die die Tabelle verbirgt:
- Der KV-Cache kommt dazu. Lange Kontexte brauchen Speicher pro Anfrage. Acht H100 (640 GB) fassen Beams FP8-Gewichte mit etwa 140 GB Rest für den Cache — genug für den Start, zu wenig für viele lange parallele Agenten; vier B200 (etwa 720 GB) lassen etwas mehr Raum. Acht H200 (1.128 GB) fassen die FP8-Gewichte von Mistral Large 4 mit fast nichts übrig; deshalb steht in der Tabelle B200.
- Kolibris Architektur ist genau dafür gebaut. Weil 40 von 50 Schichten nur ein 512-Token-Fenster sehen, wächst der Cache mit der Kontextlänge langsam — deshalb schafft ein Server 18 gleichzeitige Anfragen mit 256K Tokens.
- Quantisierung ist der Ausweg. 4-Bit-Gewichte halbieren den Speicher und kosten meist etwas Qualität. Community-Quantisierungen von Kolibri liegen bereits auf Hugging Face. Wie dieser Tausch funktioniert, steht in Quantisierung erklärt — für Beam und Mistral Large 4 sollten Sie auf offizielle Formate warten, bevor Sie Hardware planen.
Die Zahlen für Beam und Mistral Large 4 sind meine Schätzungen aus den Parameterzahlen. Keiner der beiden Anbieter hat Betriebsanforderungen veröffentlicht; aktualisieren Sie den Plan, sobald die Model Cards erscheinen.
Souveränität: Rechtsraum, Eigentümer und EU AI Act
Alle drei Anbieter verkaufen Souveränität, und jeder meint etwas leicht anderes damit.
- Mistral AI hat das Modell in eigenen europäischen Rechenzentren trainiert und bietet ein europäisches Deployment, das es „end-to-end, unabhängig von anderen digitalen Dienstleistern und nach europäischem Recht“ betreibt. Gerade hat Mistral eine Series D über 3 Milliarden Euro abgeschlossen, um diese Kapazität auszubauen.
- Aleph Alpha sagt, Kolibri sei in Deutschland gebaut und auf Infrastruktur in Deutschland und Finnland trainiert worden, „nach europäischem und deutschem Recht, ohne ausländische Kontrolle“. Am 16. September 2026 haben Aleph Alpha und das kanadische Unternehmen Cohere aber einen Vertrag über einen Zusammenschluss unterzeichnet: Das gemeinsame Unternehmen soll als Cohere auftreten, mit geplanten Hauptsitzen in Berlin und Toronto. Die Behörden müssen noch zustimmen.
- Reflection AI ist ein US-Unternehmen. Am 10. Oktober berichtete die Financial Times, dass Nvidia über eine Übernahme von Reflection AI oder eine größere Beteiligung verhandelt.
Was das praktisch heißt: Sobald Apache-2.0-Gewichte auf Ihrer eigenen Hardware laufen, sieht kein Anbieter Ihre Prompts, und ein Eigentümerwechsel kann die Lizenz bereits heruntergeladener Gewichte nicht widerrufen. Ein neuer Eigentümer kann aber alles rund um die Gewichte ändern — Supportverträge, die gehostete API und ob es eine nächste Version gibt. Wenn Sie eine souveräne Plattform bauen, behandeln Sie das Modell wie jede andere Abhängigkeit: Version festschreiben, Gewichte in die eigene Registry spiegeln, nicht darauf bauen, dass der Anbieter erreichbar bleibt.
Der EU AI Act. Die Pflichten für KI-Modelle mit allgemeinem Verwendungszweck gelten für die Anbieter — Mistral, Aleph Alpha und Reflection —, und alle drei stehen auf der Liste der Unterzeichner des General-Purpose AI Code of Practice der EU-Kommission. Bei Modellen mit mehr als 10^25 FLOPs Trainingsrechenaufwand wird ein systemisches Risiko vermutet, mit zusätzlichen Pflichten. Aleph Alpha veröffentlicht Kolibris Pre-Training-Aufwand: 6,4 × 10^23 FLOPs, weit unter dieser Grenze. Mistral und Reflection haben ihre Werte nicht veröffentlicht.
Nichts davon geht automatisch auf Sie über. Ihre Pflichten als Betreiber folgen Ihrem Anwendungsfall: Eine Hochrisiko-Anwendung im Sinne des AI Act bringt Pflichten mit sich, egal welches der drei Modelle darunter läuft, ein internes Assistenzsystem mit geringem Risiko nur wenige. Die Wahl eines europäischen Anbieters ersetzt diese Bewertung nicht.
Welches Modell sollten Sie selbst hosten?
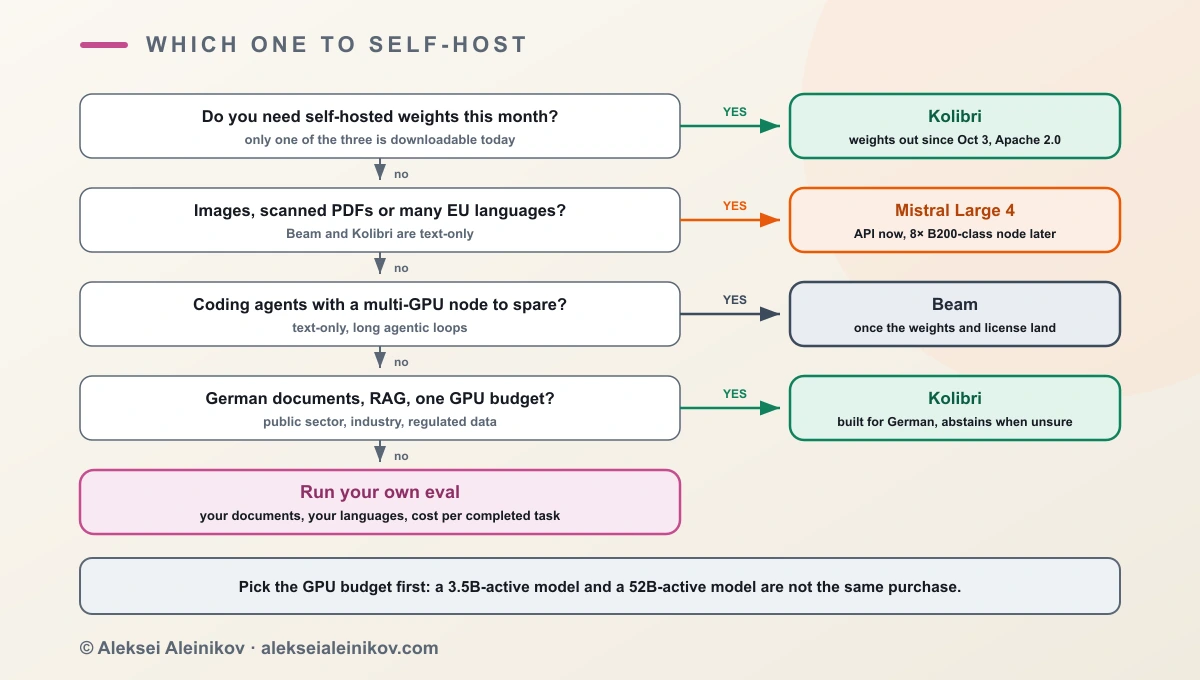
- Sie brauchen diesen Monat ein selbst gehostetes Modell in Produktion: Kolibri — das einzige mit veröffentlichten Gewichten und Lizenz.
- Deutsche Dokumente, RAG, öffentliche Verwaltung oder regulierte Branche, ein bis zwei GPUs: Kolibri. Der deutsche Tokenizer, das Abstentionstraining und die Branchen-Evaluierungen zielen genau darauf — kombiniert mit einem selbst gehosteten Embedding-Modell bleibt die ganze Pipeline im Haus.
- Gescannte Dokumente, Diagramme, viele EU-Sprachen: Mistral Large 4 — jetzt über das europäische Deployment der API, und für die Zeit nach den Gewichten einen Knoten der B200-Klasse einplanen.
- Security Operations — Schwachstellen-Triage, Malware-Analyse, Detection Rules: Mistral Large 4, das einzige der drei mit veröffentlichten Cybersecurity-Ergebnissen.
- Eine interne Plattform für Coding-Agenten mit freiem Multi-GPU-Knoten: Beam und Mistral Large 4 auf die Shortlist setzen und beide in der Woche, in der die Gewichte erscheinen, an Ihren eigenen Repositories testen. Beam ist pro Token günstiger; Mistral Large 4 lag in beiden Coding-Benchmarks mit Werten für beide Modelle vorn (DeepSWE und SciCode).
Egal, welches Modell Sie wählen: Führen Sie eine eigene Evaluierung durch — mit Ihren Dokumenten, Ihren Sprachen, Ihren Tools und den Kosten pro erledigter Aufgabe, nicht mit Tokens pro Sekunde von einer Anbieterfolie.
Fazit
Die Open-Weight-Welle im Oktober gibt europäischen Unternehmen echte Optionen, aber keine austauschbaren. Kolibri ist ein kleines, effizientes deutsch-englisches Modell, das Sie heute auf einer GPU betreiben können. Beam ist ein mittelgroßes amerikanisches Coding-Modell, das mehrere GPUs braucht und bisher nur über eine Warteliste existiert. Mistral Large 4 ist auf dem Papier das leistungsfähigste der drei, das einzige multimodale und das größte im Betrieb — heute über eine API nutzbar, selbst hostbar, sobald Gewichte und Lizenz da sind.
Entscheiden Sie in dieser Reihenfolge: was Sie herunterladen können, was Ihre GPUs fassen, dann was die Benchmarks sagen. Und schauen Sie Ende Oktober noch einmal auf den Vergleich, wenn es für zwei der drei Modelle endlich Model Cards geben sollte.
Aus der Community
Diskussion auf Mastodon & Bluesky
Antworten auf diesen Artikel aus dem offenen Netz, live geladen. Keine Werbung, keine Tracking-Skripte.
Antworte dort — es erscheint hier automatisch.