Bei jedem großen Modell-Release taucht sofort dieselbe Frage auf: „Ist das endlich der Opus-Killer?“
Mit dem Start von GPT-6.2 Astra und GPT-6.2 Sol am 17. November 2026 — mitten in einer Welle neuer Releases wie Claude Fable 5.2, Gemini 4 Hydrogen & Carbon, Qwen4-Max und Hy4 Flash — war das Rennen um das beste Coding-Modell noch nie so eng. OpenAI senkt Astras API-Preis um 20 %, gibt 60 % Rabatt auf Cache Reads und führt den Ultrafast Mode (bis zu 4,5× Tempo) ein.
Nach Auswertung der verifizierten Benchmarks, der Kosten pro Million Tokens und echter Entwickler-Erfahrungen fällt mein Urteil klar aus: GPT-6.2 ist ein starkes Effizienz-Update, vor allem Sol — aber in meiner täglichen Engineering-Praxis bleibt Claude Opus 5.5 besser.
Die Kurzantwort.
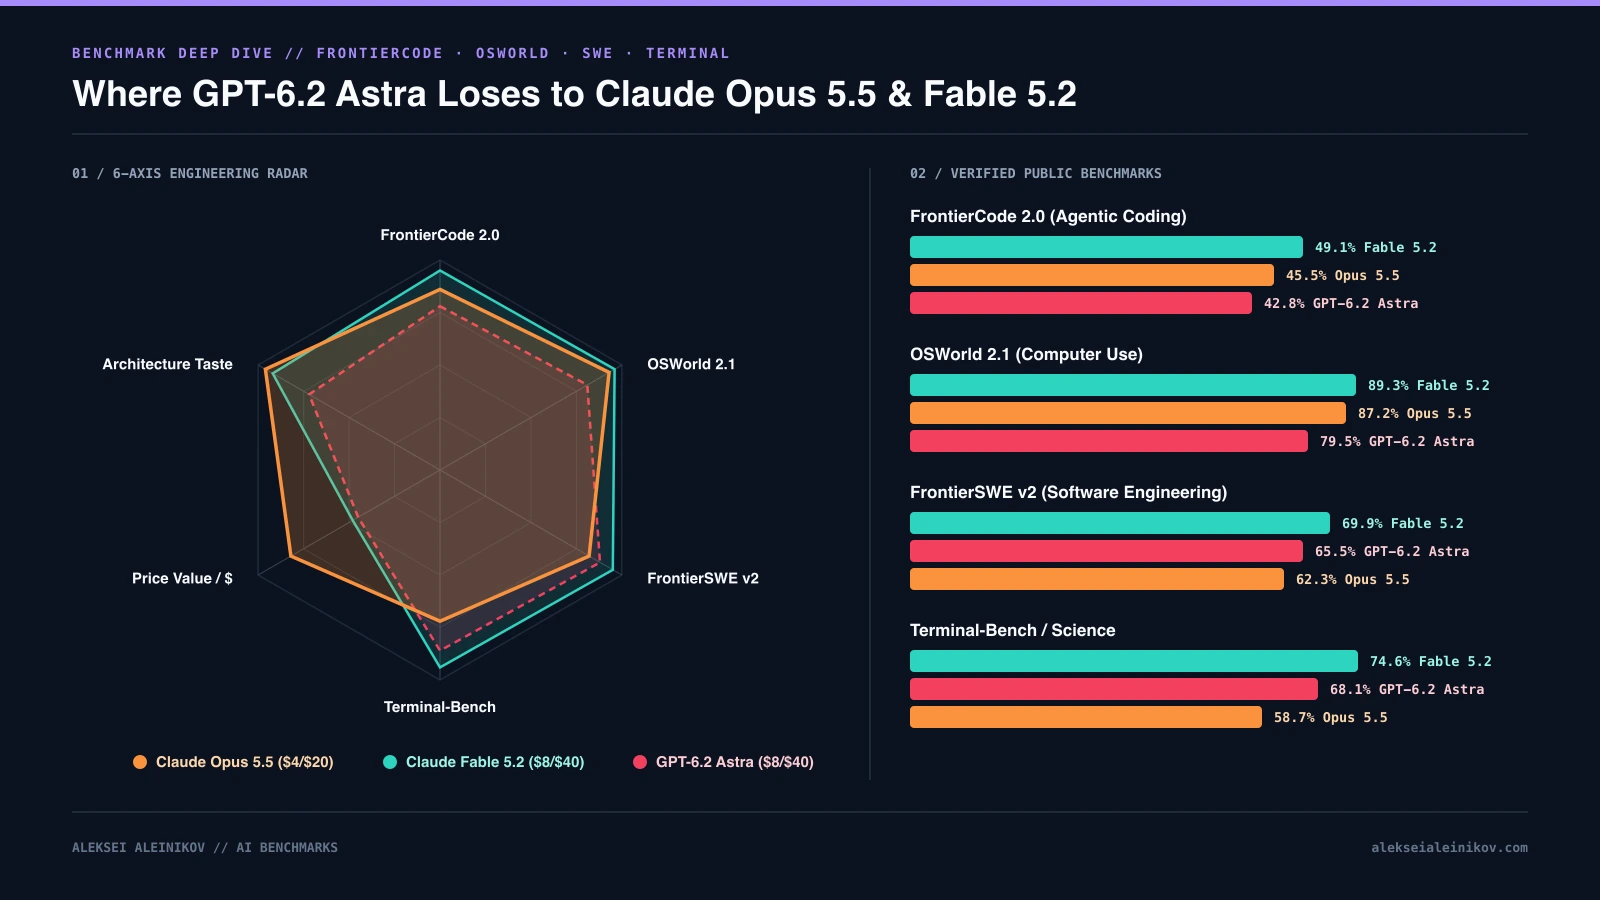
GPT-6.2 Astra($8 / $40) ist pro Token weiterhin 2× teurer alsClaude Opus 5.5($4 / $20) und verliert gegen Opus beiFrontierCode 2.0undOSWorld 2.1.GPT-6.2 Sol($2 / $10) ist ein starkes Arbeitstier für Alltagscode und PR-Reviews — doch bei sauberer Architektur ohne Sackgassen hält Opus 5.5 weiter die Krone.
1. Benchmarks & Kosten pro Million Tokens: Astra vs. Sol vs. Opus 5.5
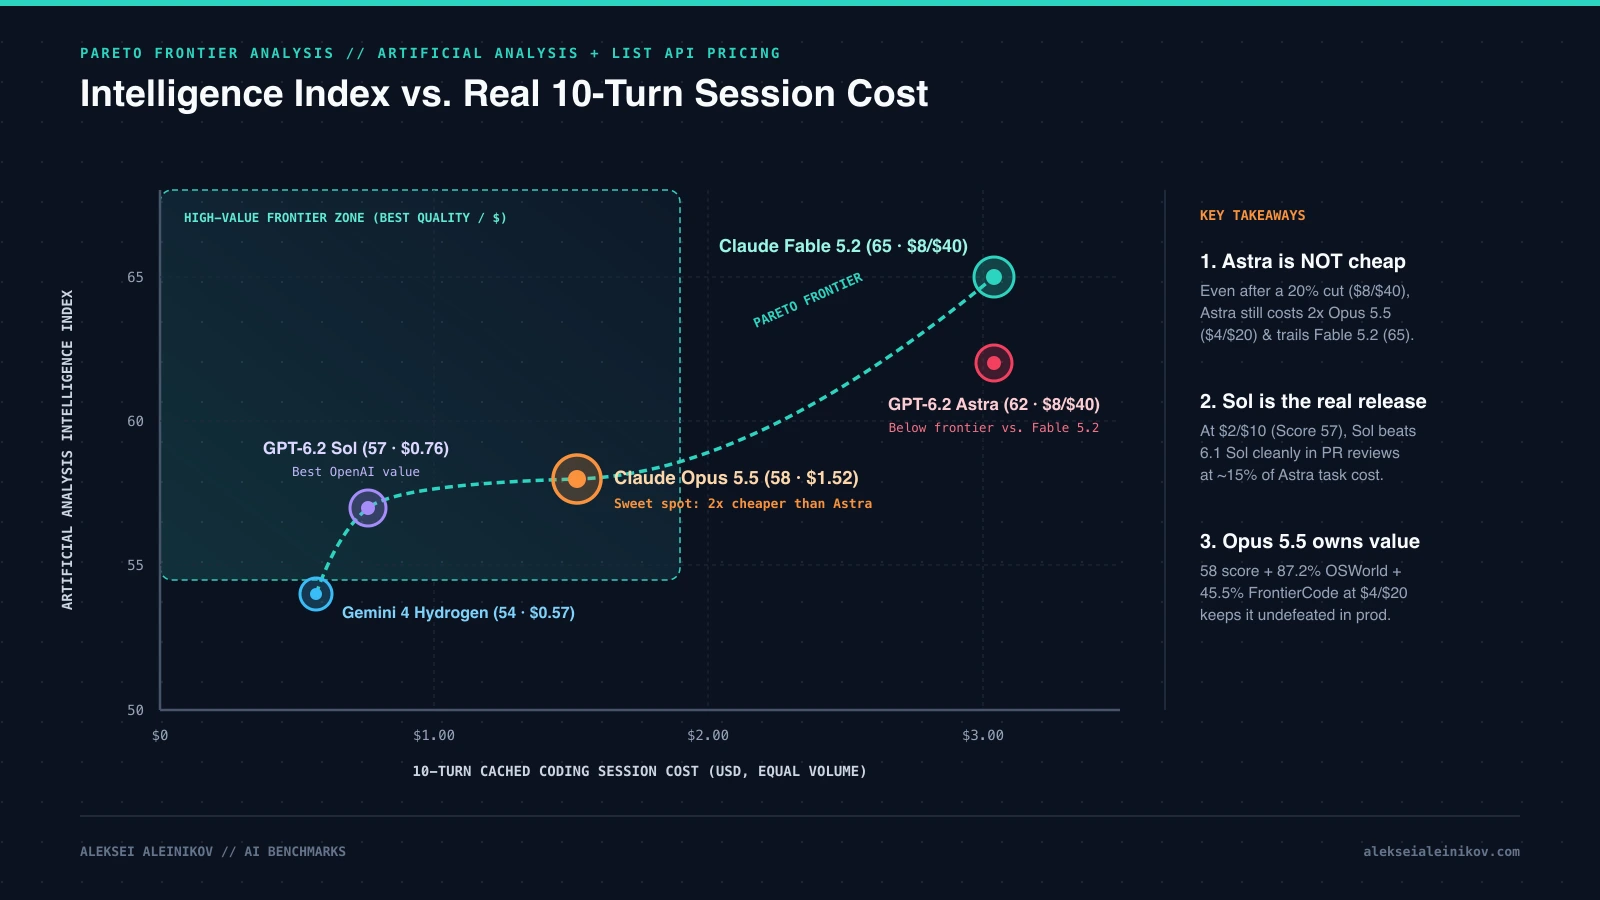
Auf dem Papier hat OpenAI konsequent auf Kosten pro Aufgabe und lange Agenten-Ketten optimiert. GPT-6.2 Astra erreicht 62 Punkte im Artificial Analysis Intelligence Index (+5,2 Punkte gegenüber der ersten GPT-6 Astra auf Agents’ Last Exam) und ist OpenAIs erstes öffentliches Modell mit der Bewertung „High“ für AI Self-Improvement im Preparedness Framework. GPT-6.2 Sol kommt auf 57 Punkte — bei rund 15 % der Task-Kosten von Astra.
Stellt man OpenAIs neues Duo jedoch direkt neben Claude Opus 5.5 ($4 / $20) und Anthropics großes Flaggschiff Claude Fable 5.2 ($8 / $40), zerfällt das „Opus-Killer“-Narrativ schnell:
| Benchmark / Metrik | GPT-6.2 Sol | Claude Opus 5.5 | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|---|---|
| API-Preis (In / Out / Cache) | $2 / $10 / $0.10 |
$4 / $20 / $0.20 |
$8 / $40 / $0.40 |
$8 / $40 / — |
| 10-Turn-Kosten (gleiche Tokens) | $0.76 |
$1.52 |
$3.04 (~$2.30 bei -30 % Out) |
$3.04+ |
| Artificial Analysis Index | 57 |
58 |
62 |
65 |
| FrontierCode 2.0 (Coding) | — | 45.5% |
42.8% |
49.1% |
| OSWorld 2.1 (Computer Use) | — | 87.2% |
79.5% |
89.3% |
| FrontierSWE v2 (SWE) | — | 62.3% |
65.5% |
69.9% |
| Terminal-Bench / Science | — | 58.7% |
68.1% |
74.6% |
Zwei harte Fakten springen sofort ins Auge:
- Astra (
$8 / $40) ist pro Token doppelt so teuer wie Opus 5.5 ($4 / $20) — und verliert gegen Opus 5.5 dennoch beiFrontierCode 2.0(42,8 %vs.45,5 %) undOSWorld 2.1(79,5 %vs.87,2 %). Selbst beim Cache Read ($0.40vs.$0.20pro 1M Tokens) ist Opus 5.5 in langen 80K-Sessions nur halb so teuer. - Auf exakt demselben
$8 / $40-Preisniveau schlägtClaude Fable 5.2GPT-6.2 Astra in jedem großen Benchmark (65vs.62Intelligence Index,49,1 %vs.42,8 %FrontierCode,69,9 %vs.65,5 %FrontierSWE,89,3 %vs.79,5 %OSWorld,74,6 %vs.68,1 %Terminal-Bench) — bei 1M Kontext und 128K Output-Buffer.
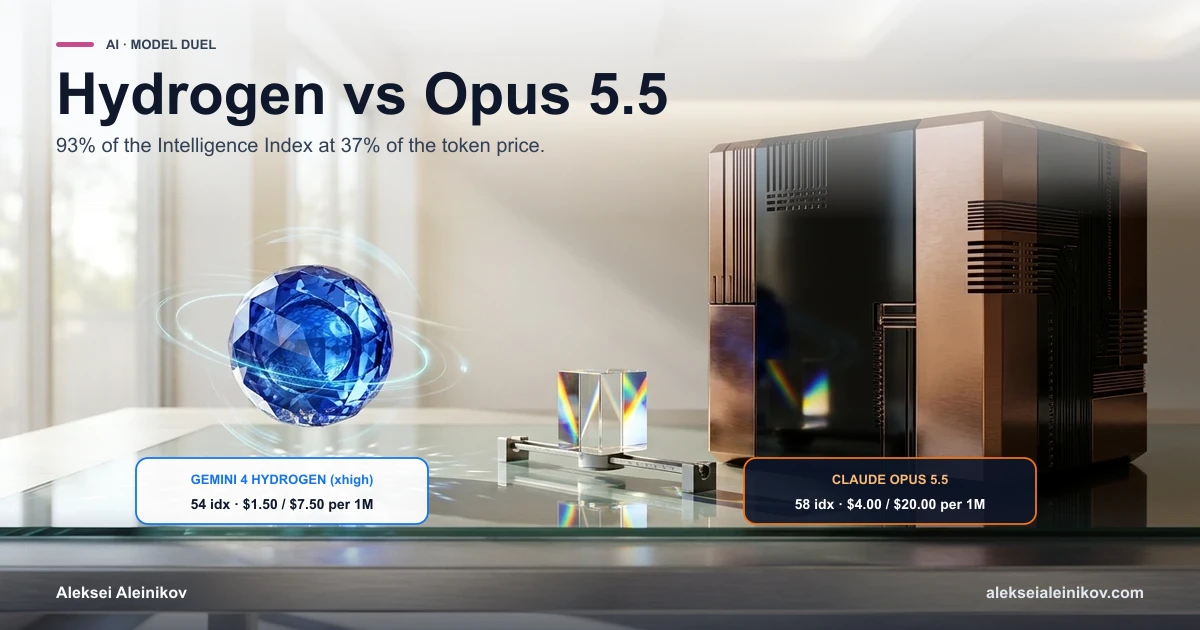
Auch im Budget-Bereich bleibt der Wettbewerb gnadenlos: Gemini 4 Hydrogen ($1.50 / $7.50) unterbietet GPT-6.2 Sol bei gleicher Token-Menge ($0.57 vs. $0.76), während neue Releases wie Qwen4-Max und Hy4 Flash (mit LatentMoE + Engram und ~12B aktiven Parametern) die Kostenuntergrenze weiter drücken. Mehr Details dazu in unseren Analysen zu Gemini 4 Hydrogen vs. Claude Opus 5.5 und Claude Fable 5.2 & Mythos 5.2.
2. Was Entwickler in der Praxis wirklich beobachten
Hinter den Release-Folien zeichnen Praxistests von Engineering-Teams ein sehr klares Bild:
Wo GPT-6.2 spürbar besser wurde
- Sparsamerer Token-Verbrauch: API-Teams bestätigen, dass Astra und Sol mehrstufige Daten- und Refactoring-Schleifen mit weniger Tool-Calls und weniger überflüssigem Text abschließen.
GPT-6.2 Solüberzeugt bei Code-Reviews: Im direkten Vergleich zu6.1 SolfindetSol 6.2deutlich mehr echte Randfall-Bugs in Pull Requests (auch wenn es teils sehr pedantisch bei Stilfragen reagiert).- Strengere Prompt-Treue: Bei klaren, engen Spezifikationen dichtet Astra seltener ungefragt eigene Muster dazu.
Wo die Reibung bleibt
- Architektur-Sackgassen: Kritiker ziehen weiterhin das typische Codex-Fazit — stark auf klaren Teilaufgaben, aber bei unübersichtlichen Multi-Service-Architekturen neigt es eher zum Verrennen als Claude.
- Latenz & fehlende Transparenz: Im Max-Modus läuft Astra mit ~60 tok/s rund 11,5 Minuten (
~$4.00) an einer vollen Index-Aufgabe. Ohne Ultrafast Mode oder sichtbare Gedankenschritte ist das Debugging hängender Agenten mühsam. - Abo-Limits trotz günstigerer API: Viele Abonnenten merken an, dass man in intensiven Coding-Wochen in den Chat-Workspaces weiterhin schnell an Nutzungsgrenzen stößt.
3. Meine ehrliche Meinung: Warum Claude Opus 5.5 vorn bleibt
Benchmarks messen isolierte Rätsel unter sauberen Prompts. Echte Software-Architektur ist fast nie sauber.
Bei meinen eigenen Aufgaben rund um Code und Architektur bevorzuge ich aktuell weiterhin Claude Opus 5.5 gegenüber GPT-6.2 Astra & Sol — vor allem aus drei Gründen:
- Besseres Maß und Architektur-Gespür: Opus 5.5 baut seltener drei unnötige Abstraktionsschichten, wo eine saubere 20-Zeilen-Änderung reicht.
- Weniger Korrektur-Runden: Eine
$0.76-Session ist nicht günstig, wenn man danach drei Extra-Prompts braucht, um ein Modell aus einer falschen Annahme zu befreien. - Überlegenes Preis-Leistungs-Verhältnis: Mit
$4 / $20kostet Opus 5.5 nur die Hälfte von Astra ($8 / $40) und liefert beiFrontierCode 2.0,OSWorld 2.1und hartem Debugging das ruhigere Urteil.
4. Das sauberste Multi-Modell-Setup aktuell
Man muss sich nicht an einen einzigen Anbieter binden. Die stärkste Kombination aus Kosten, Tempo und Architektur-Qualität:
Claude Opus 5.5($4 / $20) als Lead-Architekt für unklare Systemdesigns, Security-Grenzen und kritisches Debugging.GPT-6.2 Sol($2 / $10) für automatische PR-Reviews und schnelle Alltagsaufgaben.Gemini 4 Hydrogen($1.50 / $7.50) für günstige 1M-Kontext-Repo-Scans, Log-Analysen und Subagenten mit hohem Volumen.
Solange OpenAI weder die architektonische Ruhe von Opus erreicht noch Astra preislich Richtung $4 / $20 senkt, gilt: Opus 5.5 ist nicht geschlagen — es hat mit Sol nur einen schnellen, günstigen Sparringspartner bekommen.