Google hat gemini-4-hydrogen am 12. November 2026 als Nachfolger von Gemini 3.8 Flash in der Gemini-Modellfamilie veröffentlicht. Auf dem Papier wirkt der Vergleich eines schnellen Arbeitstiers mit Anthropics Flaggschiff Claude Opus 5.5 ungleich. In der Praxis kommen Entwickler beim direkten Testen in IDEs und Agent-Harnesses jedoch immer wieder zum gleichen Ergebnis: Hydrogen ist so schnell und treffsicher, dass es den Arbeitsalltag spürbar verändert.
Dieser Vergleich stellt offizielle Spezifikationen, unabhängige Artificial-Analysis-Benchmarks, eine konkrete 10-Turn-Kostenrechnung und verdichtetes Entwickler-Feedback aus dem Praxisalltag nebeneinander. Jede Benchmark-Zahl und jeder Preis ist sauber seiner Quelle zugeordnet — inklusive der Punkte, an denen xhigh mehr Kontingent frisst als erwartet.
Das Kurzfazit. Gemini 4 Hydrogen (
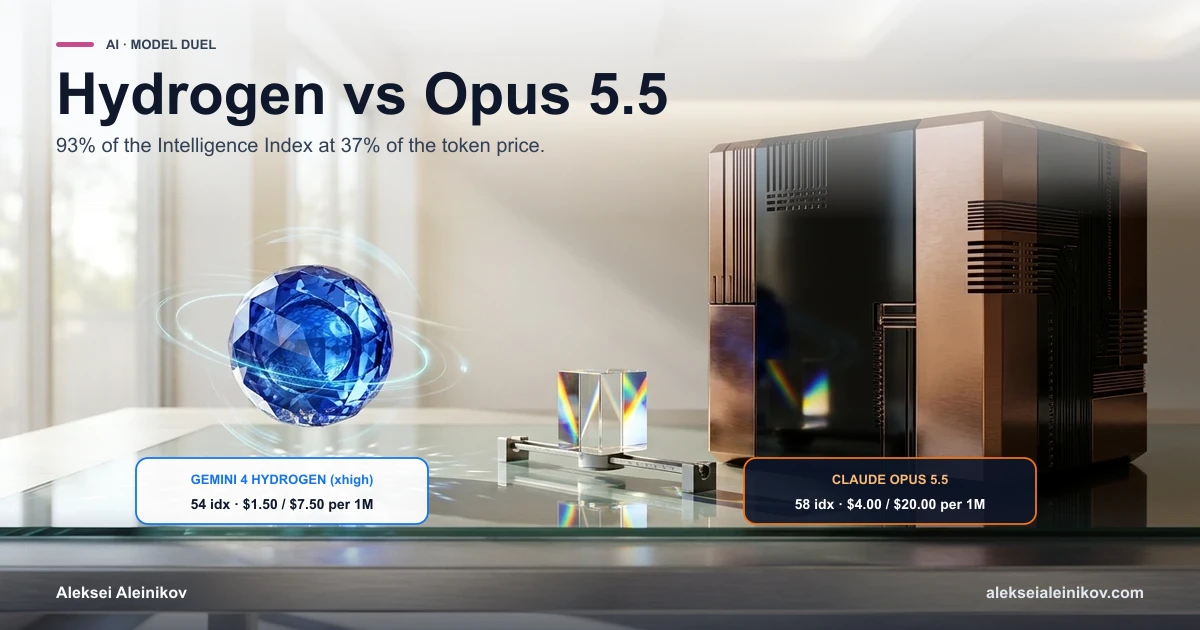
high/xhigh) schließt über 90 % der Benchmark-Lücke zu Claude Opus 5.5 bei 37 % des Listenpreises ($1,50/$7,50 vs. $4/$20) und spürbar geringerer Latenz. Nutze Hydrogen als Standard-Modell im Alltag und reserviere Opus 5.5 für mehrdeutige Architektur-Entscheidungen.
Spezifikationen und Preise im Überblick
Die folgende Tabelle basiert auf der Google AI Studio Modelldokumentation, den Gemini-API-Preisen, der Anthropic-Modellübersicht sowie OpenRouter:
| Merkmal | Gemini 4 Hydrogen | Claude Opus 5.5 |
|---|---|---|
| API-Modell-ID | gemini-4-hydrogen |
claude-opus-5-5 |
| Input / Output pro 1M Tokens | $1,50 / $7,50 | $4,00 / $20,00 |
| Cache-Read pro 1M Tokens | $0,075 | $0,20 |
| Kontextfenster | 1M Tokens (Einheitspreis) | 1M Tokens |
| Max. Output | Bis zu 1M (per Continuation) | 128K Tokens |
| Thinking-Steuerung | 4 Stufen: low, medium, high, xhigh |
Adaptiv, immer aktiv (medium Standard) |
| Native Modalitäten | Text, Bild, Audio, Video, PDF/Dateien | Text, Bild |
| Rolle im Portfolio | Schnelles Arbeitstier | Schweres Flaggschiff |
Drei Details erklären den praktischen Vorsprung im IDE- und Agent-Alltag:
- Pauschales 1M-Fenster für $1,50 / $7,50. Ganze Repositories, CI-Logs oder Design-Docs kosten weniger als die Hälfte von Opus 5.5 — ohne Aufpreis ab 200K Tokens.
- Cache-Reads für $0,075 statt $0,20. Agent-Loops lesen System-Prompt, Tool-Schemas und Repo-Kontext in jedem Turn erneut — der 2,67× günstigere Cache-Preis dominiert die reale Rechnung.
- Native Multimodalität + 1M Continuation. Audio, Video-Transkripte und große PDFs verarbeitet Hydrogen direkt ohne Vorverarbeitung.
Reale Kostenrechnung: 10-Turn-Coding-Agent-Session
Listenpreise pro Million Tokens zeigen nur die halbe Wahrheit. Rechnen wir eine typische 10-Turn-Session durch (z. B. Modul-Refactoring plus Test-Fixes):
- Gecachter Prefix pro Turn:
80.000Tokens (Repo-Map, Tool-Definitionen, System-Prompt) →800.000Cache-Read-Tokens gesamt - Frischer Input pro Turn:
4.000Tokens (Diffs, Test-Fehler, Code-Snippets) →40.000frische Input-Tokens gesamt - Output + Thinking pro Turn:
6.000Tokens →60.000Output-Tokens gesamt
| Kostenposition | Gemini 4 Hydrogen | Claude Opus 5.5 |
|---|---|---|
Cache-Reads (0,80M Tokens) |
$0,060 ($0,075/1M) |
$0,160 ($0,20/1M) |
Frischer Input (0,04M Tokens) |
$0,060 ($1,50/1M) |
$0,160 ($4,00/1M) |
Output + Thinking (0,06M Tokens) |
$0,450 ($7,50/1M) |
$1,200 ($20,00/1M) |
| Gesamt für 10 Turns | $0,570 |
$1,520 |
Bei gleicher Token-Menge ist Hydrogen 2,67× günstiger ($0,57 vs. $1,52). Schaltet man jedoch auf xhigh, erzeugt das Modell oft 40–60 % mehr Thinking-Tokens pro Turn — was exakt zu den Messungen von Artificial Analysis passt, wo Hydrogen von $1,87/Task (high) auf $3,16/Task (xhigh, +69 %) springt.
Benchmarks und Messquellen
Eine saubere Trennung zwischen unabhängigen Leaderboards und Hersteller-Angaben verhindert verzerrte Schlüsse:
| Benchmark | Quelle | Hydrogen (high) |
Hydrogen (xhigh) |
Claude Opus 5.5 | Sonnet 5.5 | Gemini 4 Carbon |
|---|---|---|---|---|---|---|
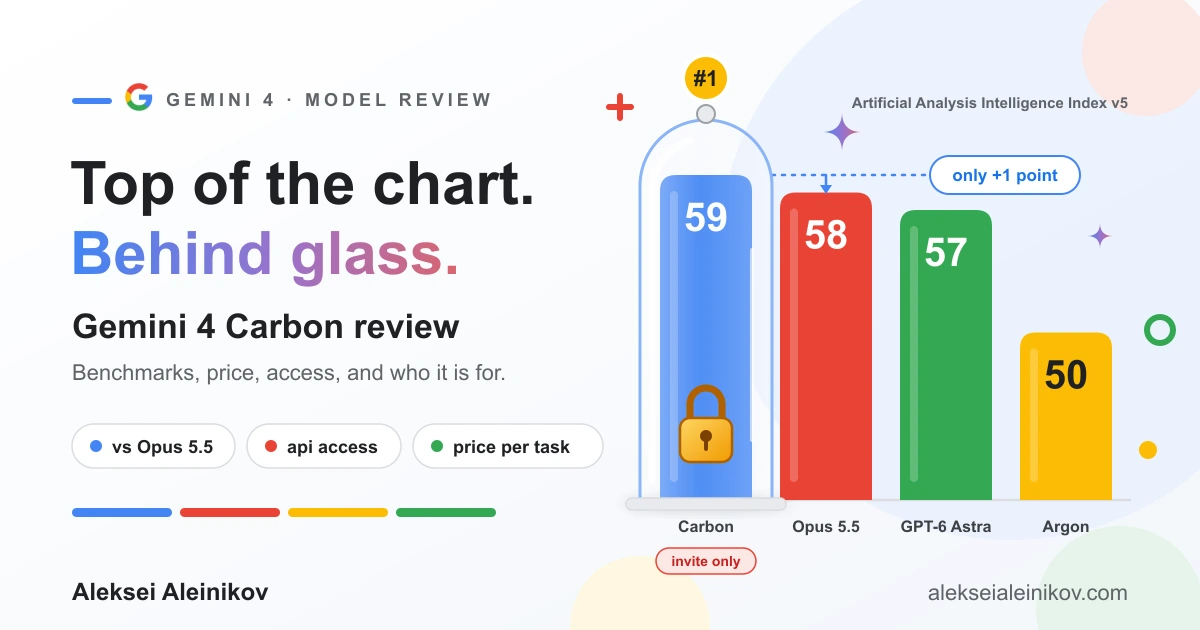
| AA Intelligence Index v5 | Artificial Analysis | 51 | 54 | 58 | ~55 | 59 |
| Ø Kosten pro AA-Task | Artificial Analysis | $1,87 | $3,16 | — (Premium-Tier) | — | $7,76 (Std.) |
| Terminal-Bench 4.1 | Google / AA | 57,0 % | — | 66,4 % (TB 4.0) | 63,9 % | — |
| OSWorld-2.1 (offline) | Vendor Cards | 77,6 % | — | 87,2 % | — | 81,5 % |
| AutomationBench-AA | Artificial Analysis | 76,1 % | — | — | — | — |
| HLE-Diamond | Vendor / Evals | 58,8 % | — | 67,7 % (HLE m. Tools) | 64,5 % | — |
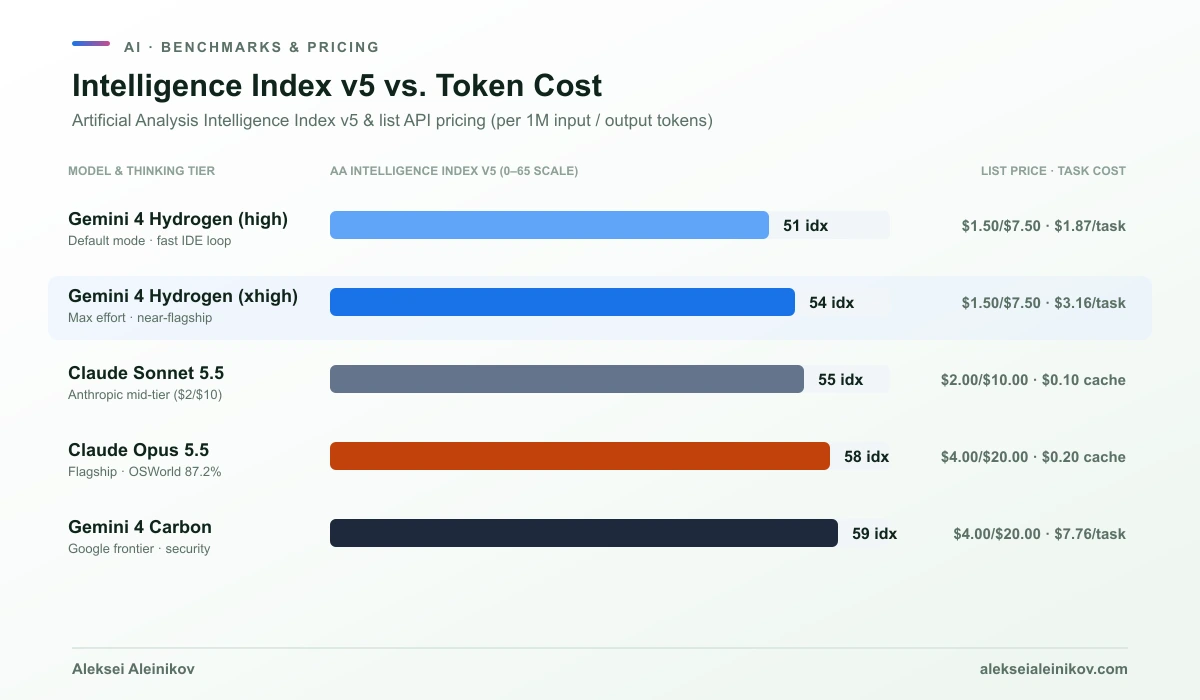
Drei klare Erkenntnisse aus den Zahlen:
- Innerhalb der Google-Familie erreicht Hydrogen auf Standard-
high(51) bereits das Niveau von Gemini 4 Argon (50zum Launch) bei viel niedrigerem Preis. Gemini 4 Carbon (59) bleibt das Spezialmodell für Security und tiefes Reasoning. - Gegen Opus 5.5 ist ein Abstand von 4 Punkten (
54vs.58) im Alltag klein genug, dass Tempo und schnelle Iterationszyklen oft mehr bringen als maximale Einzelprompt-Tiefe. - Wo Opus 5.5 klar vorn bleibt: komplexe Computer-Use-Flows (
87,2 %vs.77,6 %auf OSWorld offline) und offene Architekturentscheidungen mit vielen impliziten Anforderungen.
Was Entwickler im Alltag berichten
Aus den ersten produktiven Einsätzen und direkten Vergleichstests ergibt sich ein erstaunlich einheitliches Bild:
- Tempo verändert den Edit-Test-Loop. Entwickler heben immer wieder hervor, wie unmittelbar
gemini-4-hydrogenim Vergleich zu schweren Reasoning-Modellen reagiert. Statt auf eine große Antwort zu warten, schafft man zwei bis drei präzise Iterationen im selben Zeitfenster. - Starkes Bug-Fixing und Vision-to-Code. In der Praxis punktet Hydrogen bei chirurgischen Bugfixes im Repository, deutlich weniger Halluzinationen bei unvollständigen Prompts (ein klarer Sprung gegenüber Gemini 3.8 Flash) sowie sauberem UI-Code direkt aus groben Wireframes oder Screenshots.
- Wo es noch hakt. Im
xhigh-Modus neigt das Modell teils zu ausführlichen Antworten und verbraucht in Retry-Schleifen feste Monats-Quotas spürbar schneller. Zudem kritisieren manche Teams, dass Google Orchestrator-Pairing und höhere Limits an teure 100-$-Subscriptions bindet. - Wie sich Opus 5.5 im Alltag schlägt. Opus 5.5 wird weiterhin für strukturierte Greenfield-Architektur und saubere SOLID-Entwürfe gelobt — allerdings warnen Praxistests auch davor, dass das Modell mit hoher Überzeugung subtile Edge-Case-Fehler oder Retry-Loops einbauen kann, wenn Prompts nicht eng genug eingegrenzt sind.
API-Konfiguration und die Thinking-Falle
Beide APIs bieten steuerbare Thinking-Tiefe, allerdings mit unterschiedlichen Standardwerten und Fallstricken:
// Gemini API — gemini-4-hydrogen (Standard thinkingLevel: "high"){  "model": "gemini-4-hydrogen",  "generationConfig": {    "thinkingConfig": { "thinkingLevel": "high" }  }}
// Claude API — claude-opus-5-5 (Standard effort: "medium"){  "model": "claude-opus-5-5",  "output_config": { "effort": "medium" }}
Praxistests zeigen dabei immer wieder dieselben drei Konfigurationsfallen:
highist der Sweet Spot. 51 Punkte im Intelligence Index (~$1,87/Task) bei sehr geringer Antwortzeit für flüssige Edit-Test-Zyklen.lowundmediumkosten spürbar Qualität. Bei Multi-File-Logik sinkt die Trefferquote deutlich — gut für Boilerplate, riskant beim Debugging.xhighfrisst Zeit und Kontingent. Aufxhighklettert Hydrogen auf 54, treibt die Task-Kosten aber um ~69 % nach oben ($1,87 → $3,16). Der häufigste Kritikpunkt in der Community: feste Pro-Quotas leeren sich aufxhighüberraschend schnell, wenn Agenten in Retry-Schleifen laufen.
Die beste Praxis: Zweistufiges Routing
Statt sich starr für ein Modell zu entscheiden, kombiniert das sauberste Produktiv-Setup beide — genau nach dem Orchestrator-Muster in Antigravity oder Multi-Model-Workflows in Cursor:
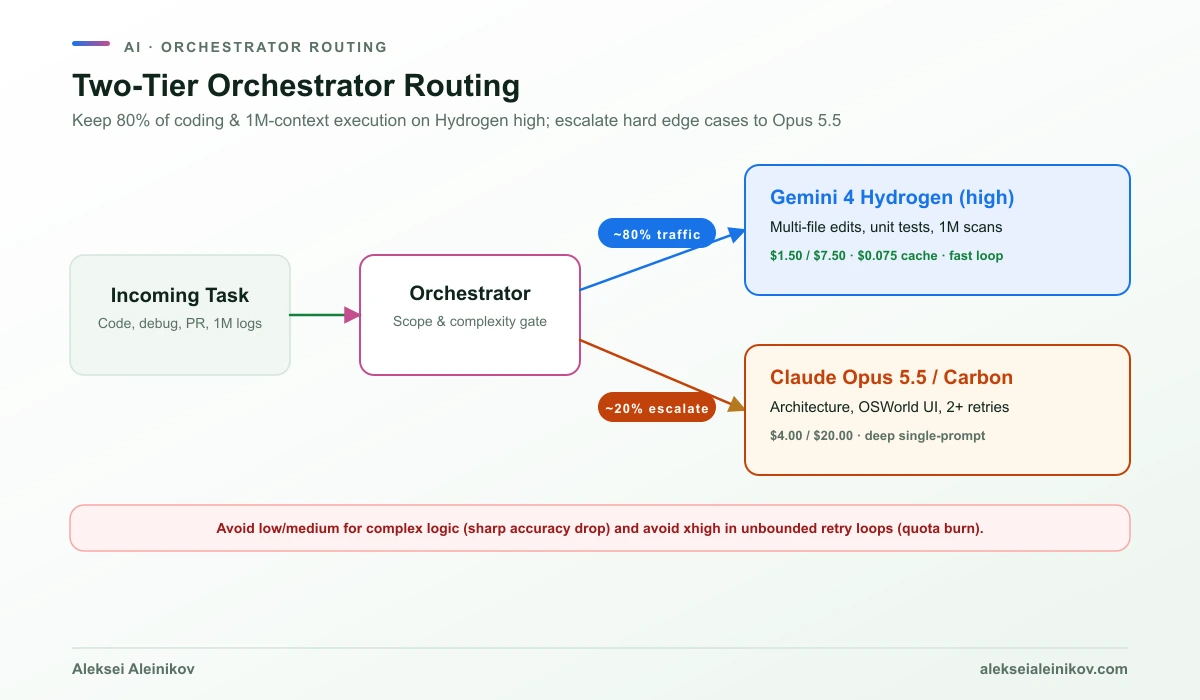
- An Gemini 4 Hydrogen (
high): Multi-File-Code, Unit-/Integrationstests, Log- und Trace-Analysen im 1M-Kontext, PR-Reviews und parallele Subagents. - Eskalation an Claude Opus 5.5 (oder Gemini 4 Carbon): initiale Systemarchitektur, unscharfe Anforderungen, hartnäckiges Cross-Service-Debugging nach zwei Fehlversuchen und anspruchsvolle Computer-Use-Automatisierung.
(Wer innerhalb der Anthropic-Familie routet, sollte zudem die Einbahnstraßen-Regel für Thinking-Blöcke zwischen Sonnet 5.5 und Opus 5.5 beachten.)
Fazit
Google hat Claude Opus 5.5 nicht beim schweren Frontier-Reasoning entthront — Opus 5.5 bleibt bei komplexen Urteilen und Computer-Use vorn. Entscheidend geschlagen hat Google Anthropic jedoch bei Qualität pro Dollar und Sekunde: Gemini 4 Hydrogen liefert über 90 % der Flaggschiff-Coding-Leistung für $1,50 / $7,50 mit pauschalem 1M-Kontextfenster. Als Standard-Modell im Alltag — mit Opus 5.5 als Eskalationsstufe — ist diese Kombination aktuell kaum zu schlagen.