
PostgreSQL in Docker ist in zehn Sekunden gestartet — und in zehn Minuten verliert man damit in Produktion Daten, wenn man einfach ein Standard-Snippet aus einem Tutorial übernimmt.
Die meisten Ausfälle bei containerisiertem Postgres liegen nicht an Docker selbst. Sie entstehen, weil Dockers Standardwerte (64 MB /dev/shm, 10 Sekunden Timeout bis SIGKILL, ungepinnte :latest-Tags und veraltete PGDATA-Pfade) direkt mit dem Speicher-, Checkpoint- und Dateisystem-Modell von PostgreSQL kollidieren.
Die Kurz-Checkliste. Mounte PG-18+-Volumes unter
/var/lib/postgresql(nicht/data), setzeshm_size: 1gb+, setzestop_grace_period: 60s, aktiviere--data-checksums, schalte PgBouncer vor Lastspitzen und binde Port5432niemals an0.0.0.0.
Der Breaking Change ab PostgreSQL 18+: PGDATA-Mount-Pfad
Wer ein bestehendes Docker-Compose-Setup auf PostgreSQL 18 oder neuer hebt, stößt sofort auf die wichtigste strukturelle Änderung im offiziellen Image.
Laut der offiziellen Docker-Hub-Dokumentation für postgres gilt:
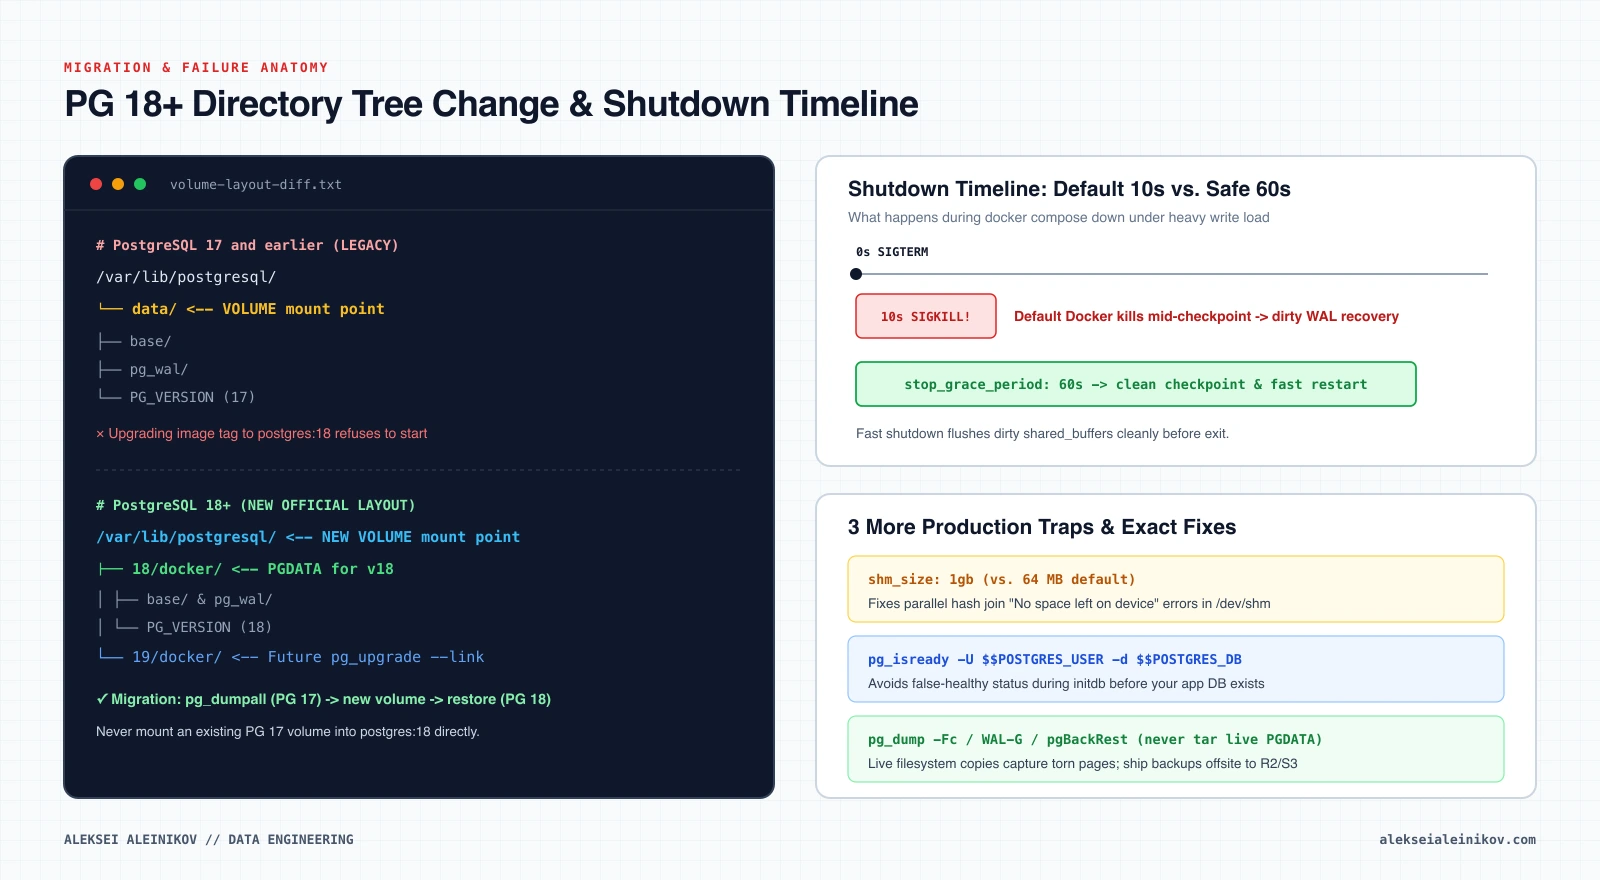
- PostgreSQL 17 und älter:
PGDATAlag direkt in/var/lib/postgresql/data, Volumes wurden auf/var/lib/postgresql/datagemountet. - PostgreSQL 18 und neuer:
PGDATAliegt jetzt in versionsspezifischen Unterordnern (/var/lib/postgresql/18/dockerbzw./19/dockerfür v19), und das definierte Docker-VOLUMEist/var/lib/postgresql.
Der Grund: Das Container-Layout entspricht damit Debians pg_ctlcluster-Konvention, sodass pg_upgrade --link künftige Major-Upgrades innerhalb desselben Überordners direkt vornehmen kann.
Sicheres Upgrade von PG ≤17 auf PG 18+ in 4 Befehlen
Lass das alte Volume als sofortiges Rollback unberührt, bis der neue Container verifiziert ist:
# 1. Alle Datenbanken und Rollen aus dem laufenden PG-17-Container sicherndocker exec -t pg-prod pg_dumpall -U app_admin > pg17_full.sql
# 2. Stack stoppen (KEIN -v übergeben, damit das alte PG-17-Volume erhalten bleibt)docker compose down
# 3. compose.yaml auf postgres:18.1-bookworm + NEUES Volume unter /var/lib/postgresql umstellen und startendocker compose up -d postgres
# 4. Dump in den frischen PG-18-Container einspielendocker exec -i pg-prod psql -U app_admin -d postgres < pg17_full.sql
5 stille Produktionsfallen im Docker-Standard
1. Der 64-MB-/dev/shm-Absturz (shm_size)
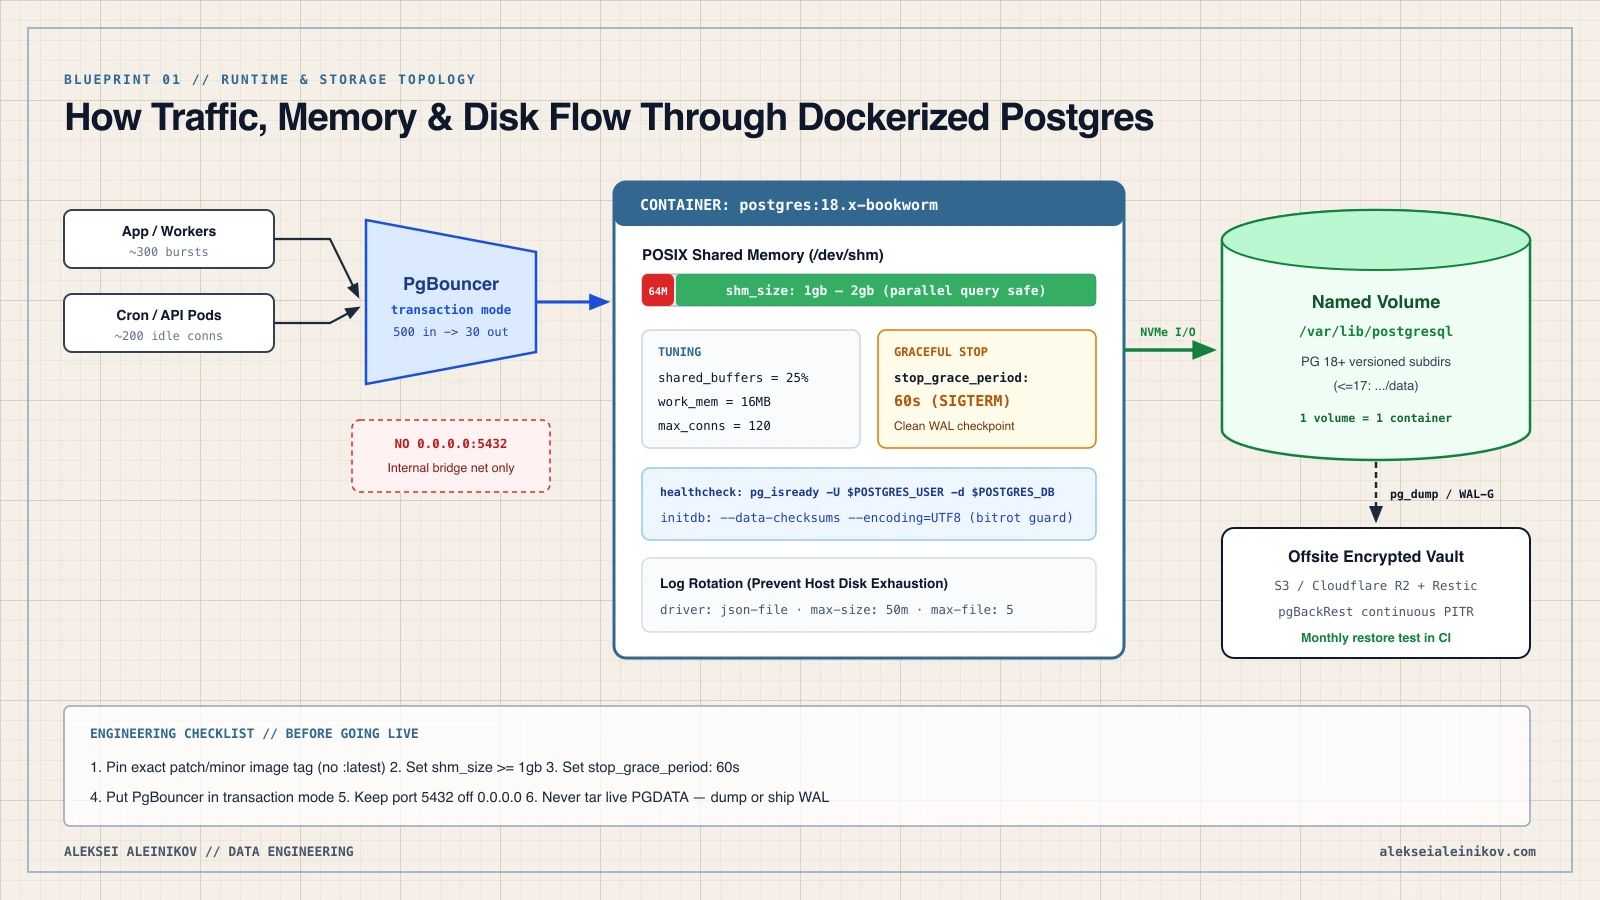
Docker begrenzt /dev/shm standardmäßig auf 64 MB. PostgreSQL nutzt POSIX Shared Memory für Dynamic Shared Memory (DSM), Parallel Workers und parallele Hash-Joins. Unter Last brechen Queries plötzlich ab mit:
ERROR: could not resize shared memory segment "/PostgreSQL.12345" to 67108864 bytes: No space left on deviceLösung: Setze shm_size: 1gb (oder 2gb–4gb bei größeren Instanzen) explizit im Compose-Service.
2. Das 10-Sekunden-SIGKILL-Limit beim Stoppen
Bei docker compose down oder docker stop sendet Docker SIGTERM und wartet nur 10 Sekunden, bevor SIGKILL den Prozess hart beendet. Muss PostgreSQL gerade gigabyteweise Dirty Buffers in einen Checkpoint schreiben, reicht das nicht — beim nächsten Start läuft ein langsames Crash-Recovery über das WAL.
Lösung: Setze stop_grace_period: 60s (bei hoher Schreiblast 120s), damit PostgreSQL per SIGTERM (fast shutdown) seinen Checkpoint ordentlich abschließen kann.
3. Trügerische Healthchecks ohne -U und -d
Ein simples pg_isready ohne Parameter prüft den Standard-User (root) und kann während initdb-Neustarts bereits „healthy“ melden, bevor Zieldatenbank und App-User existieren.
Lösung: Immer User und Zieldatenbank übergeben:
healthcheck: test: ["CMD-SHELL", "pg_isready -U $${POSTGRES_USER} -d $${POSTGRES_DB}"] interval: 10s timeout: 5s retries: 5 start_period: 20s4. Verbindungs-Engpässe ohne Connection Pooler
PostgreSQL forkt für jede Client-Verbindung einen eigenen OS-Backend-Prozess (~5–10 MB RAM plus work_mem). Ein plötzlicher Ansturm von 300 Serverless- oder Worker-Verbindungen führt im speicherbegrenzten Container schnell zum Linux-OOM-Kill.
Lösung: Schalte PgBouncer im transaction-Pooling-Modus vor Postgres: max_connections bleibt schlank (z. B. 100–150), während PgBouncer 500+ Client-Verbindungen abfedert. Seit PgBouncer 1.21+ funktionieren Prepared Statements über MAX_PREPARED_STATEMENTS direkt im Transaction-Modus — ORMs wie Prisma, SQLAlchemy oder pgx brauchen keine Workarounds mehr.
5. Named Volumes vs. Bind Mounts & Rechte
- Linux-Server: Sowohl ein Docker Named Volume auf lokalem NVMe-Storage als auch ein sauberes Host-Verzeichnis mit UID/GID
999:999funktionieren sauber (niemals SMB/NFS ohne strikte Locking-Garantien). - Heimserver (Proxmox / TrueNAS / Mini-PC): Wenn du noch entscheidest, ob Docker direkt auf Linux, in einer Proxmox-KVM-VM oder auf TrueNAS läuft, schau in unseren Hardware-Guide Proxmox VE vs. Docker vs. TrueNAS Scale.
Produktionsreifes compose.yaml zum Kopieren (PostgreSQL 18+ + PgBouncer)
Ein sauberes Baseline-Setup mit Docker-Compose-Service-Optionen und PostgreSQL-Ressourcenparametern (dimensioniert für einen 8-GB-RAM-Host):
services:  postgres:    image: postgres:18.1-bookworm # Exakte Version pinnen, niemals :latest    container_name: pg-prod    restart: unless-stopped    stop_grace_period: 60s    shm_size: 1gb    environment:      POSTGRES_USER: app_admin      POSTGRES_PASSWORD: ${POSTGRES_PASSWORD:?set in .env}      POSTGRES_DB: app_prod      POSTGRES_INITDB_ARGS: "--data-checksums --encoding=UTF8 --locale=C.UTF-8"    command:      - "postgres"      - "-c"      - "shared_buffers=2GB"      - "-c"      - "effective_cache_size=6GB"      - "-c"      - "work_mem=16MB"      - "-c"      - "maintenance_work_mem=512MB"      - "-c"      - "max_connections=120"      - "-c"      - "wal_level=replica"      - "-c"      - "random_page_cost=1.1"      - "-c"      - "effective_io_concurrency=200"    volumes:      # PG 18+ mountet auf /var/lib/postgresql (fuer PG <=17 /var/lib/postgresql/data)      - pg_data:/var/lib/postgresql    networks:      - db_internal    healthcheck:      test: ["CMD-SHELL", "pg_isready -U $${POSTGRES_USER} -d $${POSTGRES_DB}"]      interval: 10s      timeout: 5s      retries: 5      start_period: 20s    logging:      driver: json-file      options:        max-size: "50m"        max-file: "5"
  pgbouncer:    image: edoburu/pgbouncer:v1.24.1-p1    container_name: pg-pooler    restart: unless-stopped    depends_on:      postgres:        condition: service_healthy    environment:      DB_HOST: postgres      DB_PORT: 5432      DB_USER: app_admin      DB_PASSWORD: ${POSTGRES_PASSWORD:?set in .env}      DB_NAME: app_prod      POOL_MODE: transaction      MAX_CLIENT_CONN: 500      DEFAULT_POOL_SIZE: 30      MAX_PREPARED_STATEMENTS: 200      AUTH_TYPE: scram-sha-256    ports:      # Nur an localhost oder privates Tailscale/WireGuard-Interface binden — nie 0.0.0.0      - "127.0.0.1:6432:5432"    networks:      - db_internal
volumes:  pg_data:
networks:  db_internal:    driver: bridge
Zwei Details, die im Ernstfall den Unterschied machen:
--data-checksumsbeiminitdberkennt stille Speicherfehler sofort, bevor sie unbemerkt in Backups wandern.- Port
5432wird gar nicht veröffentlicht, und PgBouncer lauscht ausschließlich auf127.0.0.1:6432(bzw. im internen Docker-Netzwerk).
Spickzettel für RAM-Sizing (2 GB bis 32 GB Server)
Das compose.yaml oben ist auf einen 8-GB-Host ausgelegt. Für kleinere oder größere Server skalierst du diese fünf Parameter proportional — PostgreSQL nutzt intensiv den Linux-OS-Page-Cache, daher bleiben bewusst ~50–75 % des RAMs außerhalb von shared_buffers:
| Host-RAM | shm_size |
shared_buffers |
effective_cache_size |
work_mem |
max_connections |
|---|---|---|---|---|---|
| 2 GB | 512mb |
512MB |
1536MB |
4MB |
60 |
| 4 GB | 1gb |
1GB |
3GB |
8MB |
80 |
| 8 GB | 1gb |
2GB |
6GB |
16MB |
120 |
| 16 GB | 2gb |
4GB |
12GB |
32MB |
150 |
| 32 GB | 4gb |
8GB |
24GB |
64MB |
200 |
Backups & Recovery: Niemals ein laufendes Volume mit tar kopieren
Selbst wenn dein Host auf RAID oder ZFS läuft, gilt: RAID-Snapshots sind kein Disaster Recovery. Ein tar oder rsync auf ein laufendes PGDATA-Verzeichnis erzeugt inkonsistente Seiten und unbrauchbare Backups.
Zwei saubere Wege:
- Logische komprimierte Dumps (DBs unter ~30–50 GB):
Regelmäßig
pg_dump -Fcausführen und verschlüsselt perresticoderrclonein S3-kompatiblen Storage ohne Egress-Kosten wie Cloudflare R2 sichern:Terminal window docker exec pg-prod pg_dump -U app_admin -Fc app_prod > /backups/app_prod_$(date +%F).dump - Kontinuierliche WAL-Archivierung + PITR (größere DBs / enges RPO): Mit pgBackRest oder WAL-G im eigenen Image oder Sidecar für Point-in-Time-Recovery auf die Sekunde genau.
Teste einmal im Monat einen Restore in einen Wegwerf-Container — ein ungetestetes Backup ist nur Hoffnung:
# Test-Container starten, aktuellen Dump einspielen und wieder aufräumendocker run -d --name pg-restore-test -e POSTGRES_PASSWORD=test -e POSTGRES_USER=app_admin -e POSTGRES_DB=app_prod postgres:18.1-bookwormsleep 5docker exec -i pg-restore-test pg_restore -U app_admin -d app_prod --no-owner < /backups/app_prod_$(date +%F).dumpdocker rm -f pg-restore-testFür die passende Index-Strategie in Postgres siehe außerdem unseren PostgreSQL-Index-Benchmark (B-Tree, GIN, BRIN).
Schnelle Diagnose: 3 Fehler direkt aus docker logs
Skipping initializationoder sofortiger Exit nach dem Update aufpostgres:18: Ein PG-≤17-Volume wurde in ein PG-18+-Image gemountet. Image aufpostgres:17zurückdrehen, perpg_dumpallsichern und in ein neues Volume unter/var/lib/postgresqleinspielen.could not resize shared memory segment ... No space left on device:/dev/shmhat Dockers 64-MB-Limit erreicht.shm_sizeauf1gb+ erhöhen und Container neu anlegen (docker compose up -d --force-recreate postgres).chown: changing permissions ... Operation not permitted: Typisch bei Host-Bind-Mounts unter macOS/Windows oder Rootless-Docker. Auf ein Docker Named Volume (pg_data:/var/lib/postgresql) wechseln oder unter Linuxchown -R 999:999setzen.
Quellen
- Docker Hub Official Image —
postgresDokumentation & PG-18+-PGDATA-Layout - PostgreSQL Offizielle Dokumentation — Resource Consumption (
shared_buffers,work_mem, DSM) - PgBouncer Offizielle Dokumentation — Konfiguration & Pooling-Modi
- Docker Compose Spezifikation — Services (
shm_size,stop_grace_period,healthcheck)
Aus der Community
Diskussion auf Mastodon & Bluesky
Antworten auf diesen Artikel aus dem offenen Netz, live geladen. Keine Werbung, keine Tracking-Skripte.
Antworte dort — es erscheint hier automatisch.