Die meisten Tests von Datenbank-Clients sind eine Rundreise durch die Feature-Liste. Ich wollte etwas Engeres wissen: Wenn du Navicat 18 öffnest und vor eine echte Tabelle setzt, welche der neuen Funktionen findest du wirklich, und welche halten stand?
Also habe ich es mit PostgreSQL und einer Tabelle mit 10 Millionen Zeilen verbunden und die wichtigsten Funktionen nacheinander durchgespielt. Das hier ist die Liste dessen, was ich gesehen habe: was auf Anhieb klappte, was versteckt war und eine KI-Antwort, die einen zweiten Blick brauchte.
Was ist Navicat, und für wen ist es?
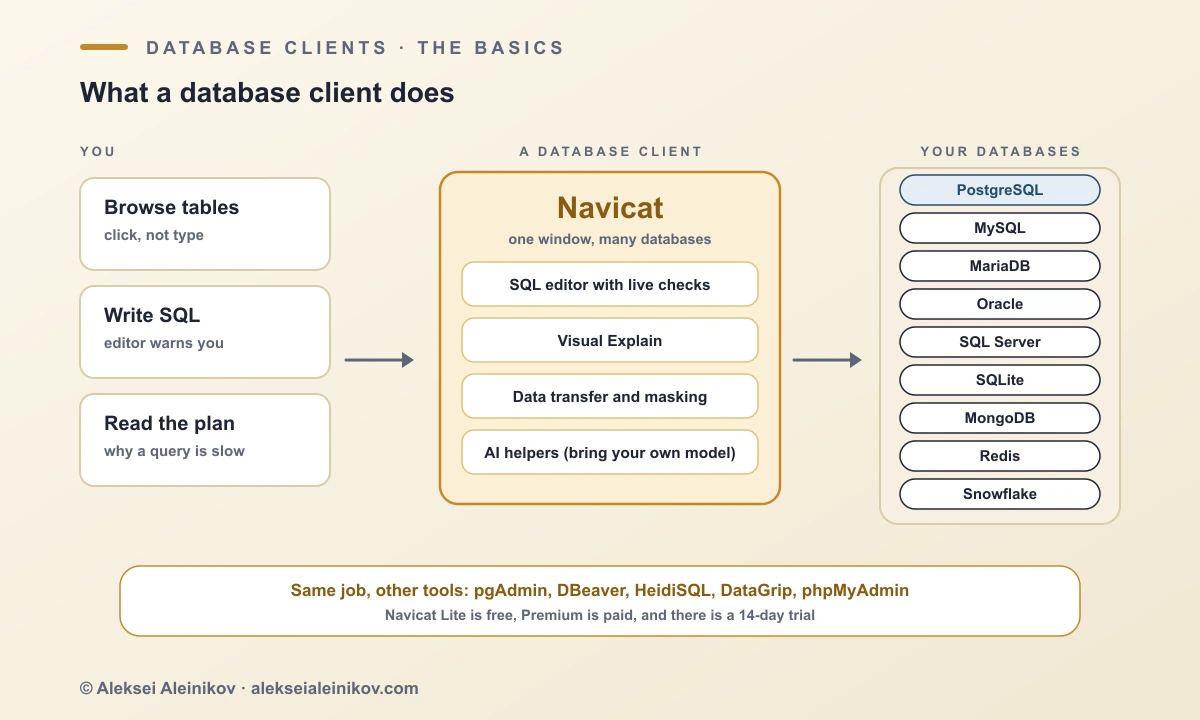
Eine Datenbank hält deine Daten, und um mit ihr zu arbeiten, tippst du normalerweise SQL in ein Terminal (bei PostgreSQL ist das psql). Ein Datenbank-Client legt ein Fenster darum: Du siehst die Tabellen als Baum, schreibst Abfragen in einem Editor, der dich vor Fehlern warnt, siehst dir an, wie eine Abfrage laufen wird, und verschiebst Daten zwischen Datenbanken ohne eigene Skripte.
Navicat ist einer der ältesten dieser Clients. PremiumSoft, eine Firma aus Hongkong, hat 2002 die erste Version veröffentlicht. Navicat Premium verbindet viele Datenbanktypen in einem Fenster: PostgreSQL, MySQL, MariaDB, Oracle, SQL Server, SQLite, MongoDB, Redis und Snowflake. Es läuft auf Windows, macOS und Linux. Es ist kommerzielle Software, mit einer kostenlosen Lite-Edition und einer 14-Tage-Testversion der vollen Version.
Das Urteil in 30 Sekunden
- Funktioniert: die Live-Fehlerprüfung, die Vorschau von Fix with AI, Explain mit dem echten Plan, Rename Symbol und die Vorschau von Data Masking.
- Versteckt: Explain steckt im Menü Query, die Code-Vervollständigung schweigt, bis ein Schema gewählt ist, und Rename Symbol ist ausgegraut, solange Text markiert ist.
- Mit Vorsicht: KI-Antworten hängen vom angebundenen Modell ab. Die erste Ask-AI-Antwort nutzte Spaltennamen, die nicht in meinem Schema stehen, also lies das SQL, bevor du es ausführst. In meinem ersten Data-Masking-Lauf kamen E-Mail, Telefon und IBAN als kurze Zahlen zurück, wähle die Technik also pro Spalte und lies die Vorschau.
- Nicht getestet: AI Fill und das Verschieben von Daten zwischen verschiedenen Datenbanktypen.
- Kostenloses Lite: behält Vervollständigung und Live-Fehlerprüfung. Refactoring, Visual Explain, Data Masking und KI-Fehlerkorrektur sind in den kostenpflichtigen Editionen.
So habe ich getestet
Die Datenbank ist ein lokaler PostgreSQL-17.6-Server. Darin liegt die Tabelle events mit 10 Millionen Zeilen aus meinem Index-Benchmark, dazu zwei kleine Tabellen für diesen Test: customers (50.000 Zeilen mit erfundenen Namen, E-Mail-Adressen, Telefonnummern, IBANs und Kartennummern) und orders (200.000 Zeilen). Nichts davon ist echt.
Die große Tabelle öffnete sich im Grid mit den ersten Zeilen, und das Info-Panel listete Spalten und Typen auf.
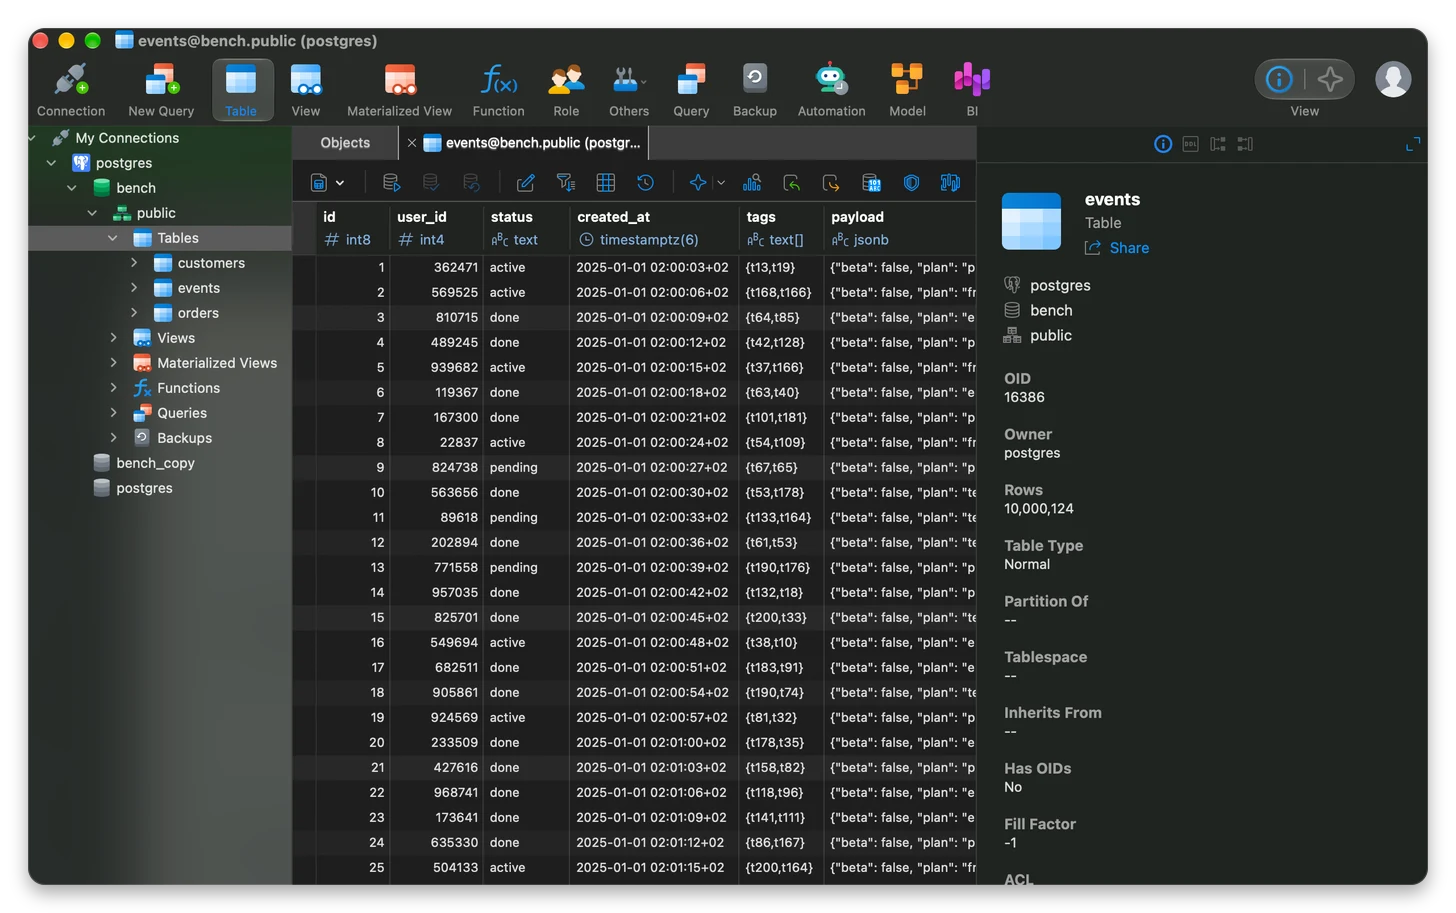
Ein Detail ist wissenswert. Das Info-Panel zeigt Rows 10,000,124. Die Tabelle hat genau 10.000.000 Zeilen. Das Panel liest die Planner-Statistik von PostgreSQL (pg_class.reltuples, hier 10,000,124) und nicht count(*), und nichts kennzeichnet die Zahl als Schätzung. Eine Kleinigkeit, aber eine ehrliche Notiz.
Fehler fangen, bevor die Abfrage läuft
Ich habe SELECT user_idd FROM events WHERE status = 'failed' getippt, mit einem Tippfehler im Spaltennamen. Bevor ich irgendetwas ausgeführt habe, war user_idd rot unterstrichen. Beim Darüberfahren erschien die Meldung Identifier reference user_idd unfound in database [ln:1 col:8 len:8] mit zwei Schaltflächen, Copy und Fix with AI.
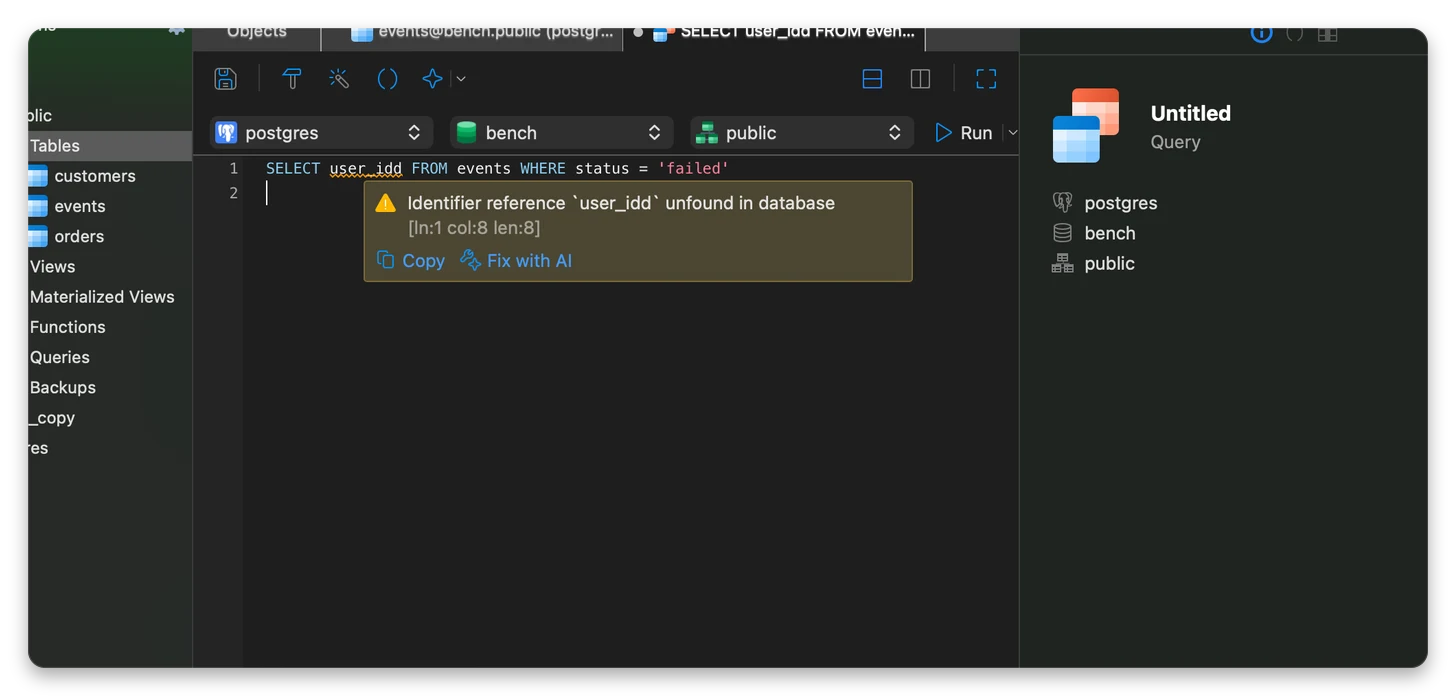
Das ist die Live-Fehlerprüfung aus der Ankündigung von Version 18, und sie funktioniert. Geprüft wird gegen das echte Schema, nicht nur gegen die SQL-Syntax. Die Formulierung ist etwas steif („unfound in database“), und von allein schlägt es kein user_id vor, aber es zeigt auf die genaue Stelle.
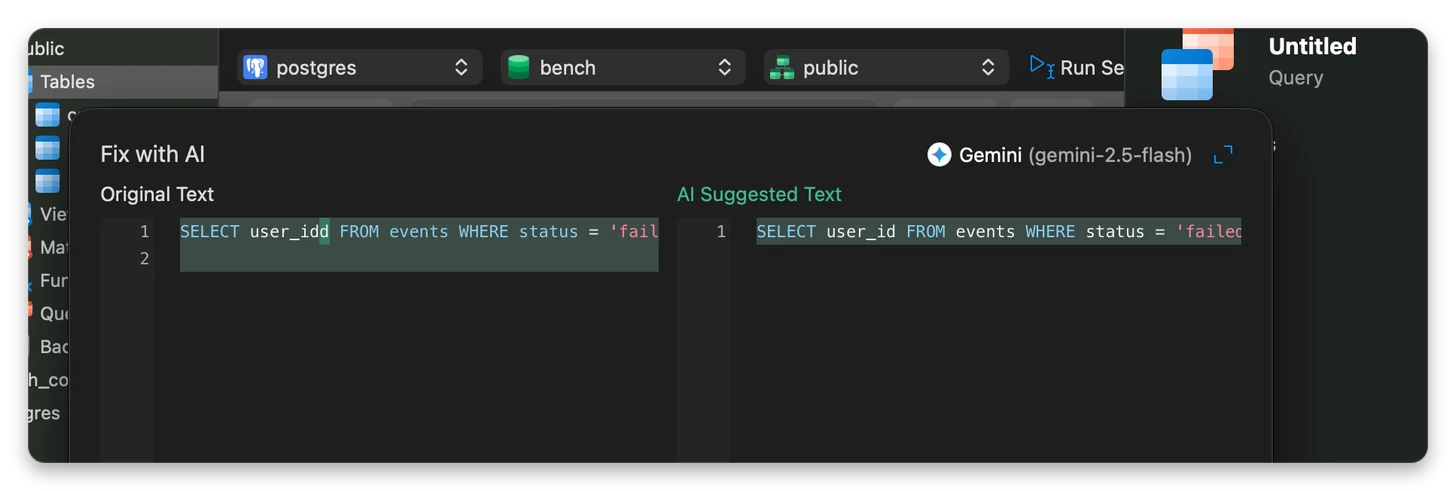
Den Vorschlag liefert die zweite Schaltfläche. Fix with AI öffnet einen Dialog mit dem Originaltext links und dem Text der KI rechts, und nichts wird ersetzt, bevor du zustimmst. Gemini 2.5 Flash hat den Tippfehler zu user_id korrigiert. Dieses Vorschau-vor-dem-Schreiben-Verhalten entspricht dem, was Navicat verspricht.
Die KI braucht zuerst einen Assistenten
Es gibt kein eingebautes Modell. Unter Settings, AI ist die Assistentenliste anfangs leer, und du fügst mit dem Plus-Knopf einen hinzu. Die Anbieter, die ich gesehen habe: OpenAI ChatGPT, Google Gemini, Anthropic Claude, DeepSeek, xAI Grok, Alibaba Qwen, ByteDance Doubao, Moonshot Kimi, dazu OpenAI Compatible, Ollama und LM Studio. Es gibt außerdem eine Option, die Antworten mehrerer Assistenten zu vergleichen.
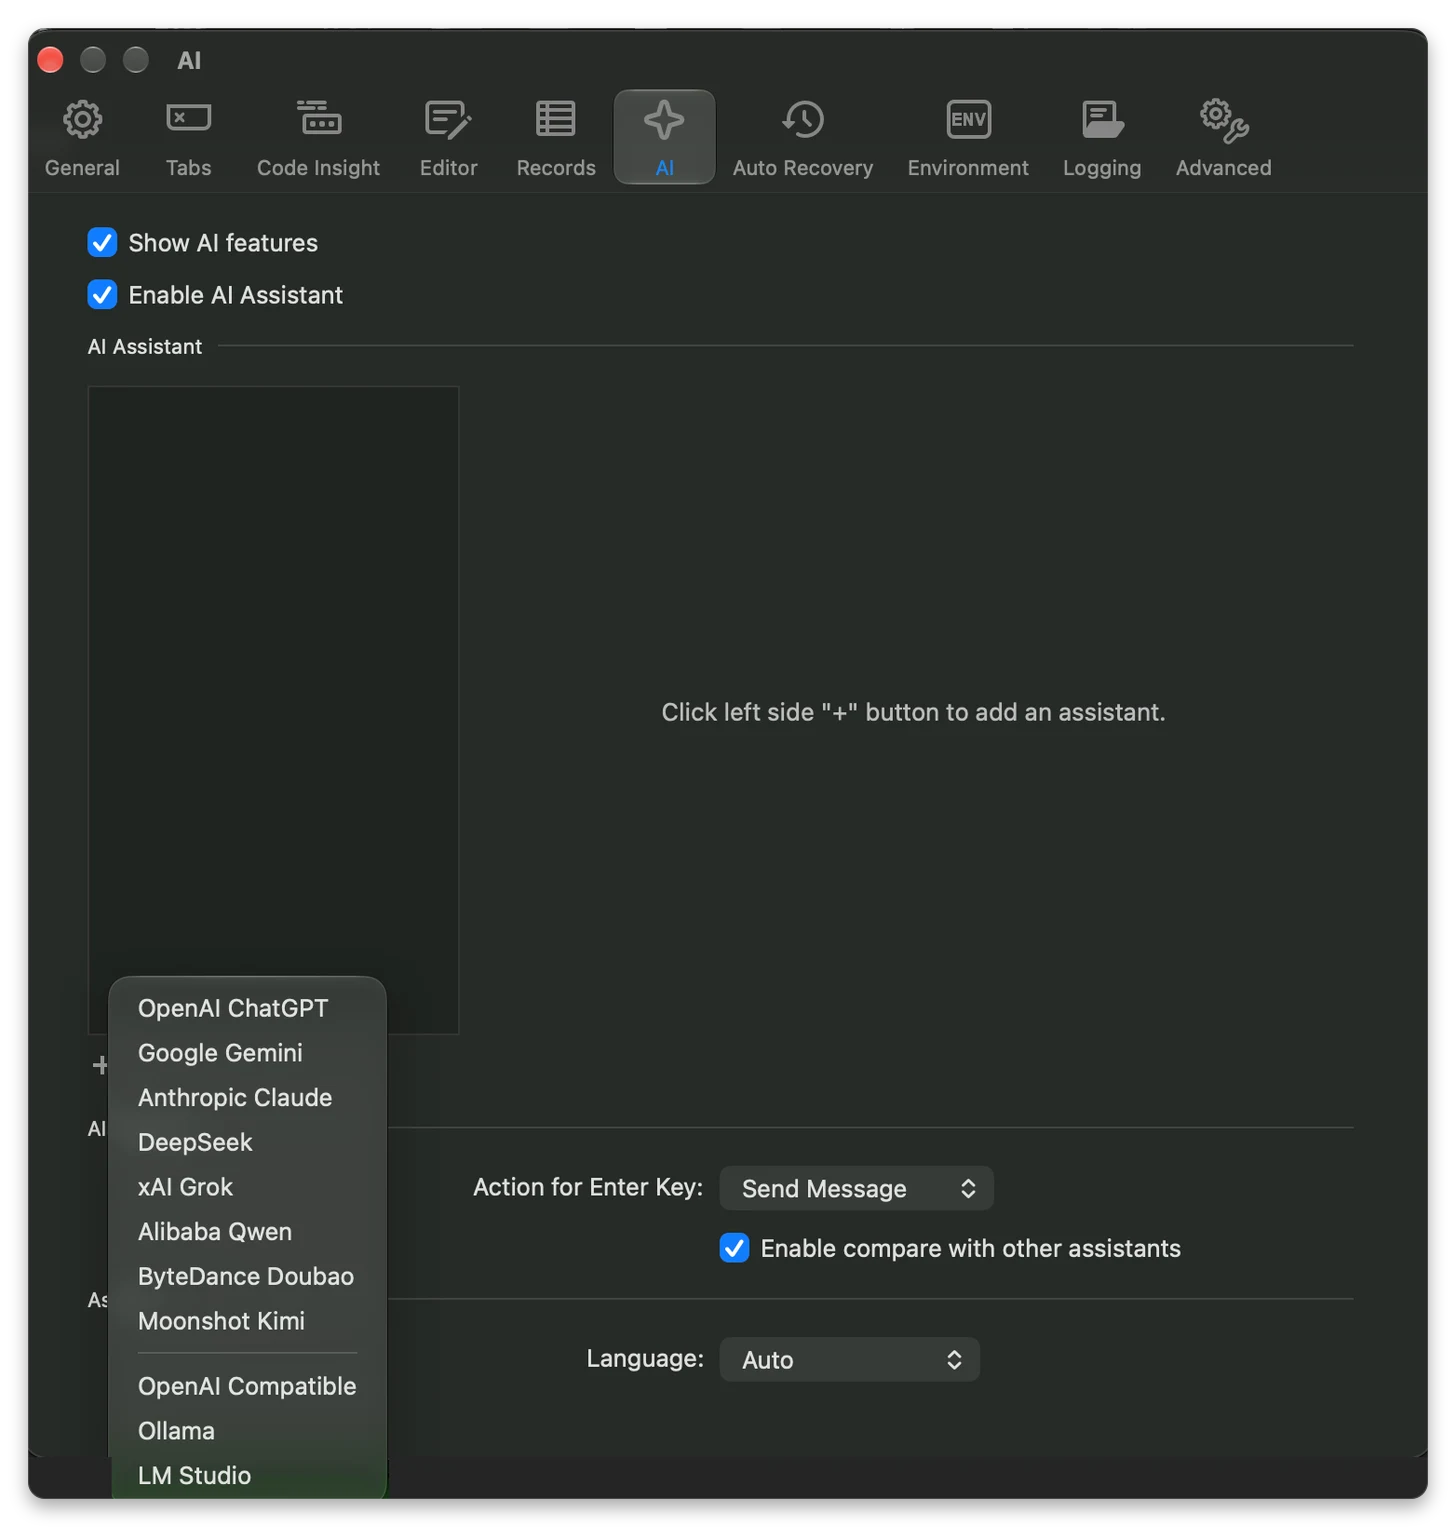
Zwei praktische Folgen. Erstens bringst du deinen eigenen Assistenten mit, die KI-Funktionen laufen also mit dem Schlüssel und den Bedingungen deines Anbieters. Zweitens war das Häkchen Attach Schema im Dialog von Fix with AI gesetzt, das heißt, Tabellen- und Spaltennamen gehen an den gewählten Assistenten. Das ist ein Grund, Ollama oder LM Studio auszuprobieren, wenn dein Schema sensibel ist.
Ask AI: lies das SQL, bevor du es ausführst
Ich habe auf Englisch gefragt: top 10 customers by total order amount. Der Vorschlag kam mit Vorschau, wie zuvor. Er sah vernünftig aus:
SELECT c.customer_id, c.customer_name, SUM(o.total_amount) AS total_order_amountFROM customers AS cJOIN orders AS o ON c.customer_id = o.customer_idGROUP BY c.customer_id, c.customer_nameORDER BY total_order_amount DESCLIMIT 10;Er läuft so nicht. In meinem Schema heißen die Spalten customers.id, customers.full_name und orders.total_cents. Die drei Namen, die das Modell gewählt hat, stehen nicht in meinem Schema, und PostgreSQL antwortete column c.customer_id does not exist.
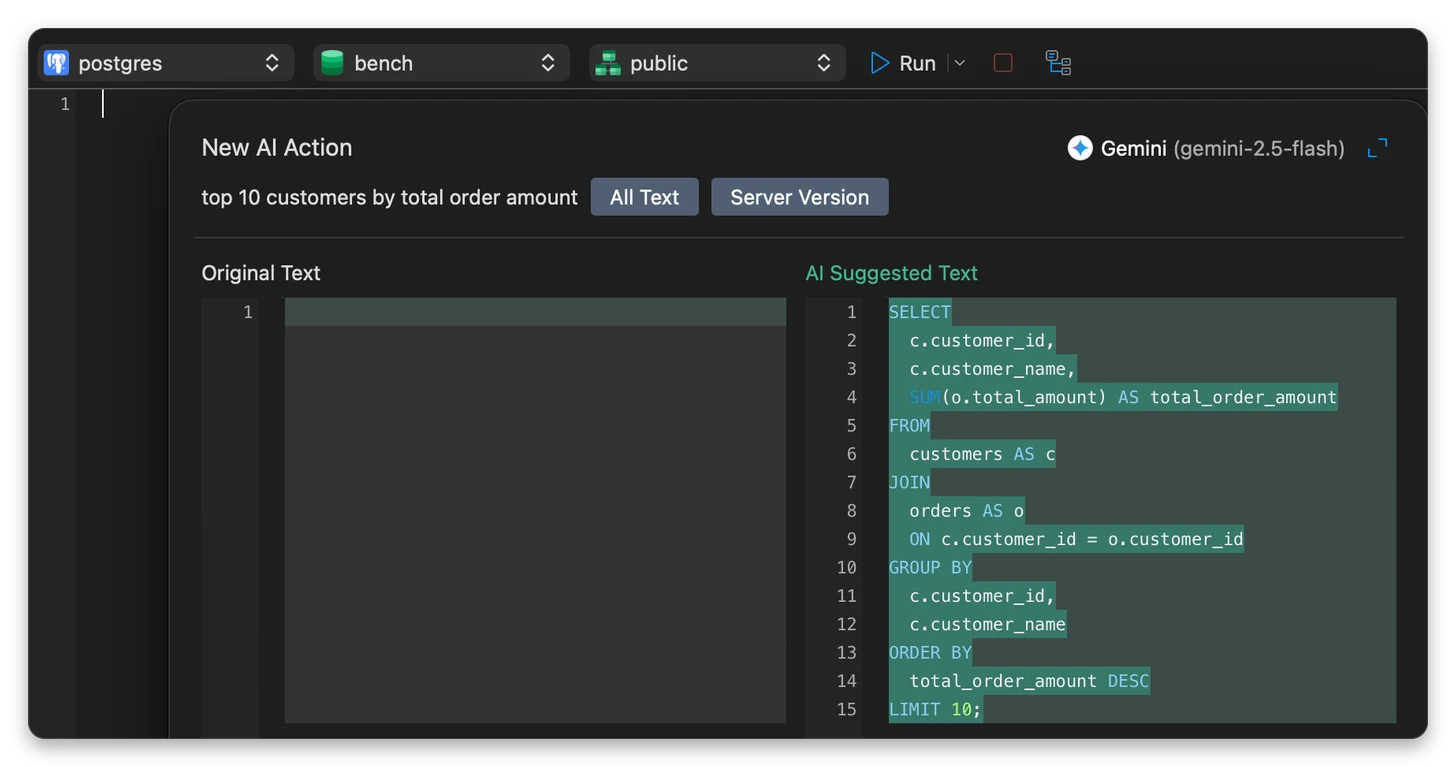
Ich behaupte nicht, dass dir das auch passiert. Es ist eine Antwort von einem Modell, und KI-Antworten hängen vom angebundenen Modell ab und davon, wie viel von deinem Schema es sieht. Der Dialog, den ich gesehen habe, hatte Schaltflächen namens All Text und Server Version, und ich habe dort keine Möglichkeit gefunden, das Schema anzuhängen, das Modell hat also womöglich geraten. Die Lehre gilt in jedem Fall: Die Vorschau zeigt das SQL, nicht ob es stimmt. Lies es, oder führe es an einer Kopie aus, bevor du ihm vertraust.
Explain gibt es, aber es ist versteckt
Ich habe die Abfrage korrigiert und den Plan gesucht. Der Run-Knopf hat ein Dropdown, und darin stehen Run, Run Current Statement und Continue on Error. Kein Explain. Es liegt in der macOS-Menüleiste unter Query.
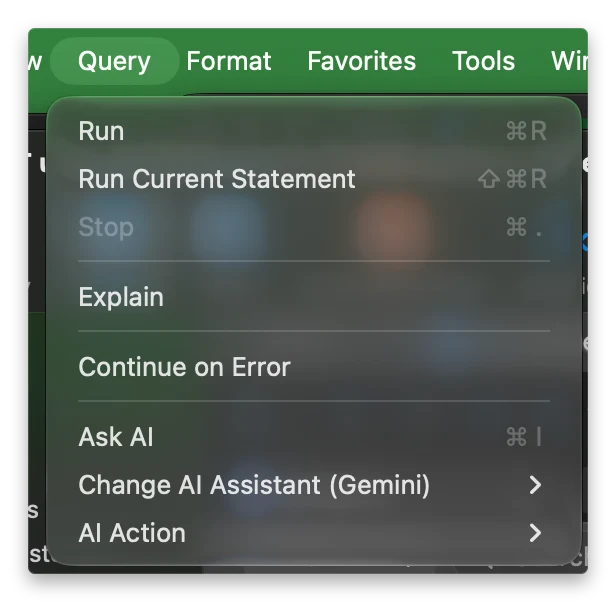
Der Plan öffnet sich in einem Panel mit den Ansichten Visual, JSON, Text und Statistics und einem Schieberegler für den Kostenschwellwert. Der visuelle Plan für SELECT user_id FROM events WHERE status = 'failed' hat zwei Knoten: Gather (269593.38) und den Scan auf events (260459.98), rot hervorgehoben als der teure Teil.
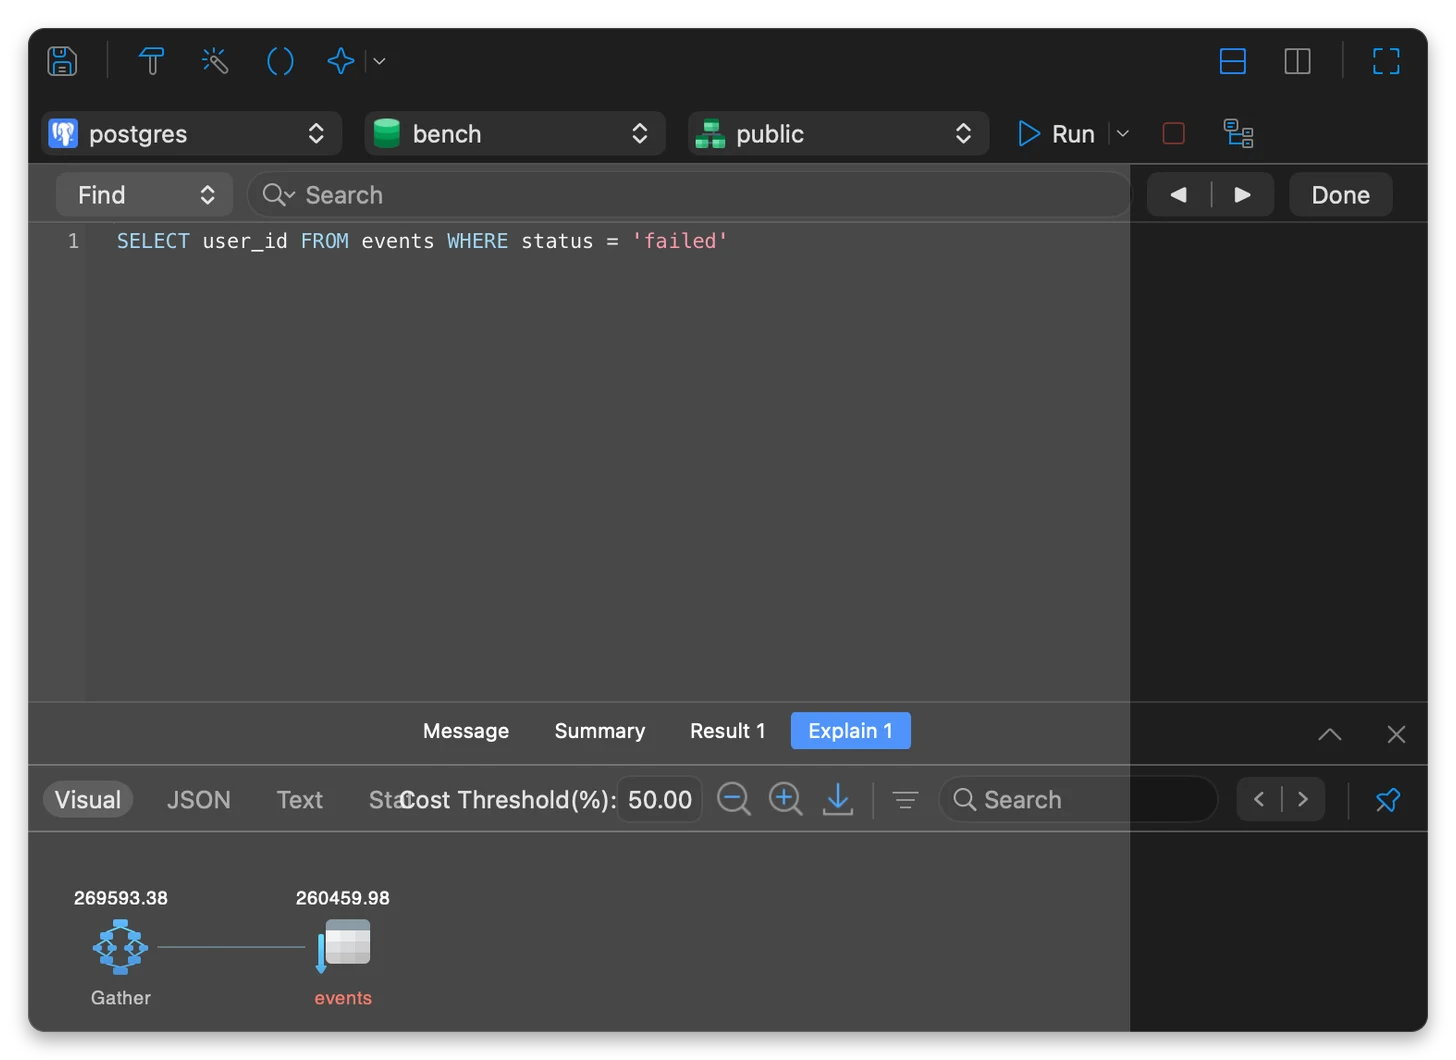
Zur Kontrolle habe ich EXPLAIN in psql für dieselbe Abfrage ausgeführt, und die Zahlen stimmen überein:
Gather (cost=1000.00..269593.38 rows=81334 width=4) Workers Planned: 2 -> Parallel Seq Scan on events (cost=0.00..260459.98 rows=33889 width=4) Filter: (status = 'failed'::text)Navicat zeigt also den echten Plan des Servers, keine Näherung. Die Kosten sind Planner-Einheiten, keine Millisekunden. Mit EXPLAIN ANALYZE dauerte dieselbe Abfrage etwa 205 ms und lieferte 84.979 Zeilen, wo der Planner 81.334 erwartet hatte. Ein Sequential Scan ist hier zu erwarten: Auf status gibt es keinen Index. Im Index-Benchmark (auf PostgreSQL 18 gemessen) beantwortete ein partieller Index auf den seltenen failed-Zeilen eine solche Abfrage in etwa 0,125 ms.
Die Code-Vervollständigung läuft, sobald ein Schema gewählt ist
In den Code-Insight-Einstellungen von Navicat war die Vervollständigung eingeschaltet. Eine Weile schlug sie trotzdem nichts vor. Der Grund lag in der Symbolleiste: Nach dem erneuten Verbinden war die Schema-Auswahl neben der Datenbank leer. Bis ich public gewählt hatte, wurden keine Tabellennamen vorgeschlagen, und jeder Bezeichner wurde als „unfound“ markiert.
Mit gewähltem public stand beim Tippen von FROM cust die Tabelle customers an erster Stelle der Liste, mit ihrem Schema, danach Snippets, Schlüsselwörter und PostgreSQL-Funktionen.
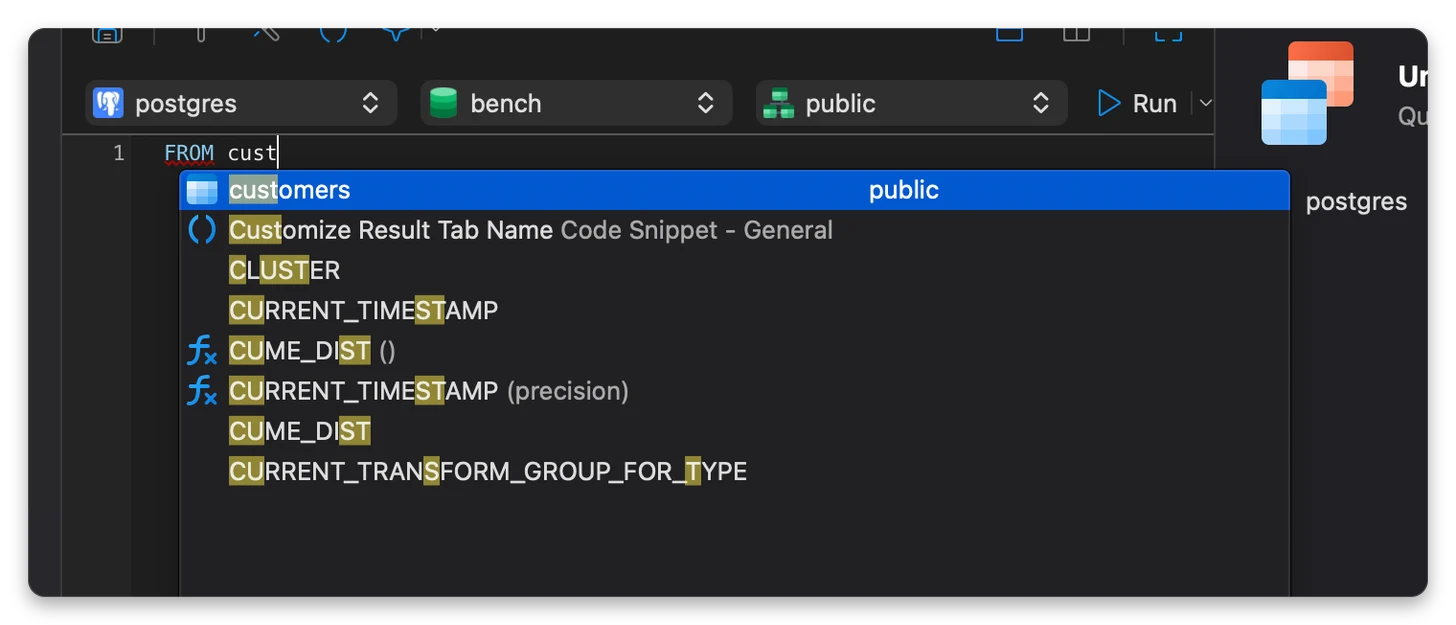
Läuft sie, ist sie gut. Bis du weißt, dass du die Schema-Auswahl prüfen musst, ist es ein stiller Ausfall, und ein kleiner Hinweis dort würde Neulingen ein paar Minuten sparen.
Rename Symbol
Ich habe SELECT c.full_name, o.total_cents FROM customers c JOIN orders o ON o.customer_id = c.id geschrieben und versucht, den Alias c umzubenennen. Der Menüeintrag (Rechtsklick, Refactor, Rename Symbol, Kürzel Cmd+F2) war ausgegraut, solange Text markiert war. Mit dem Cursor im Alias war er aktiv.
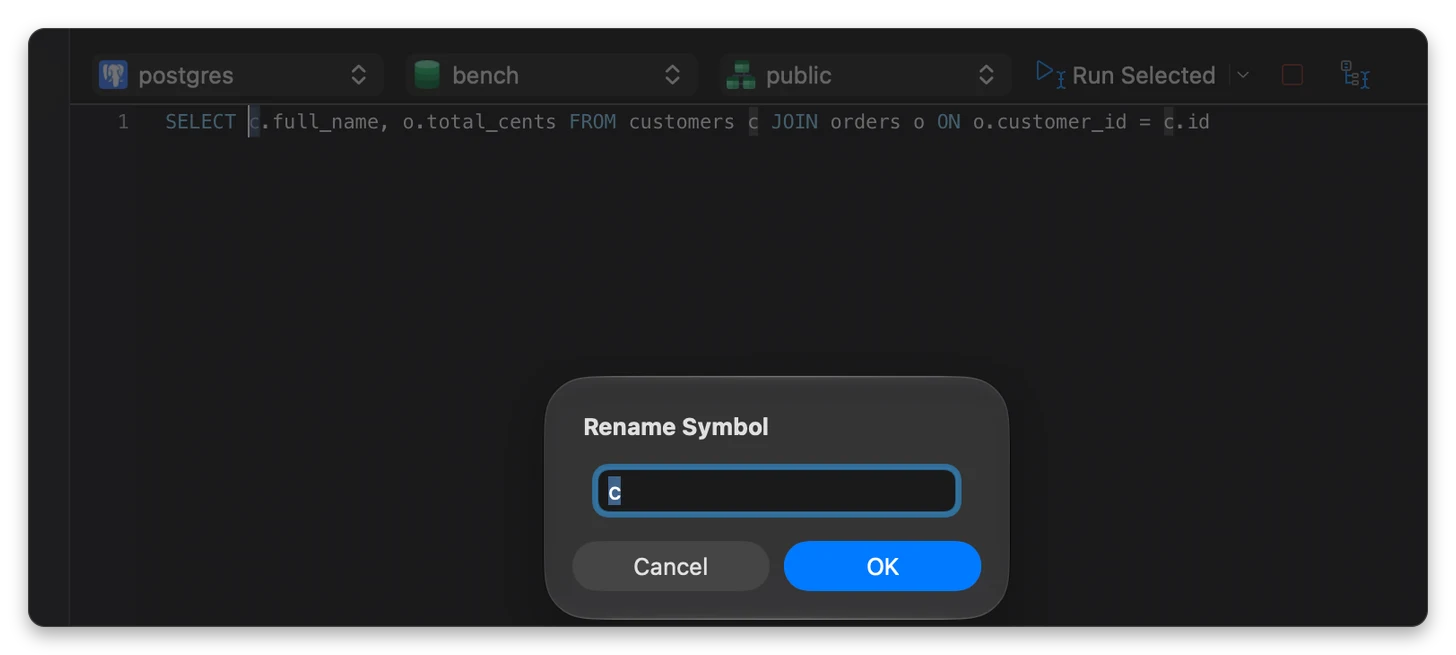
Ich habe cust getippt. Alle drei Verwendungen des Alias wurden geändert, der andere Alias o blieb unangetastet, und die Abfrage lief weiter.
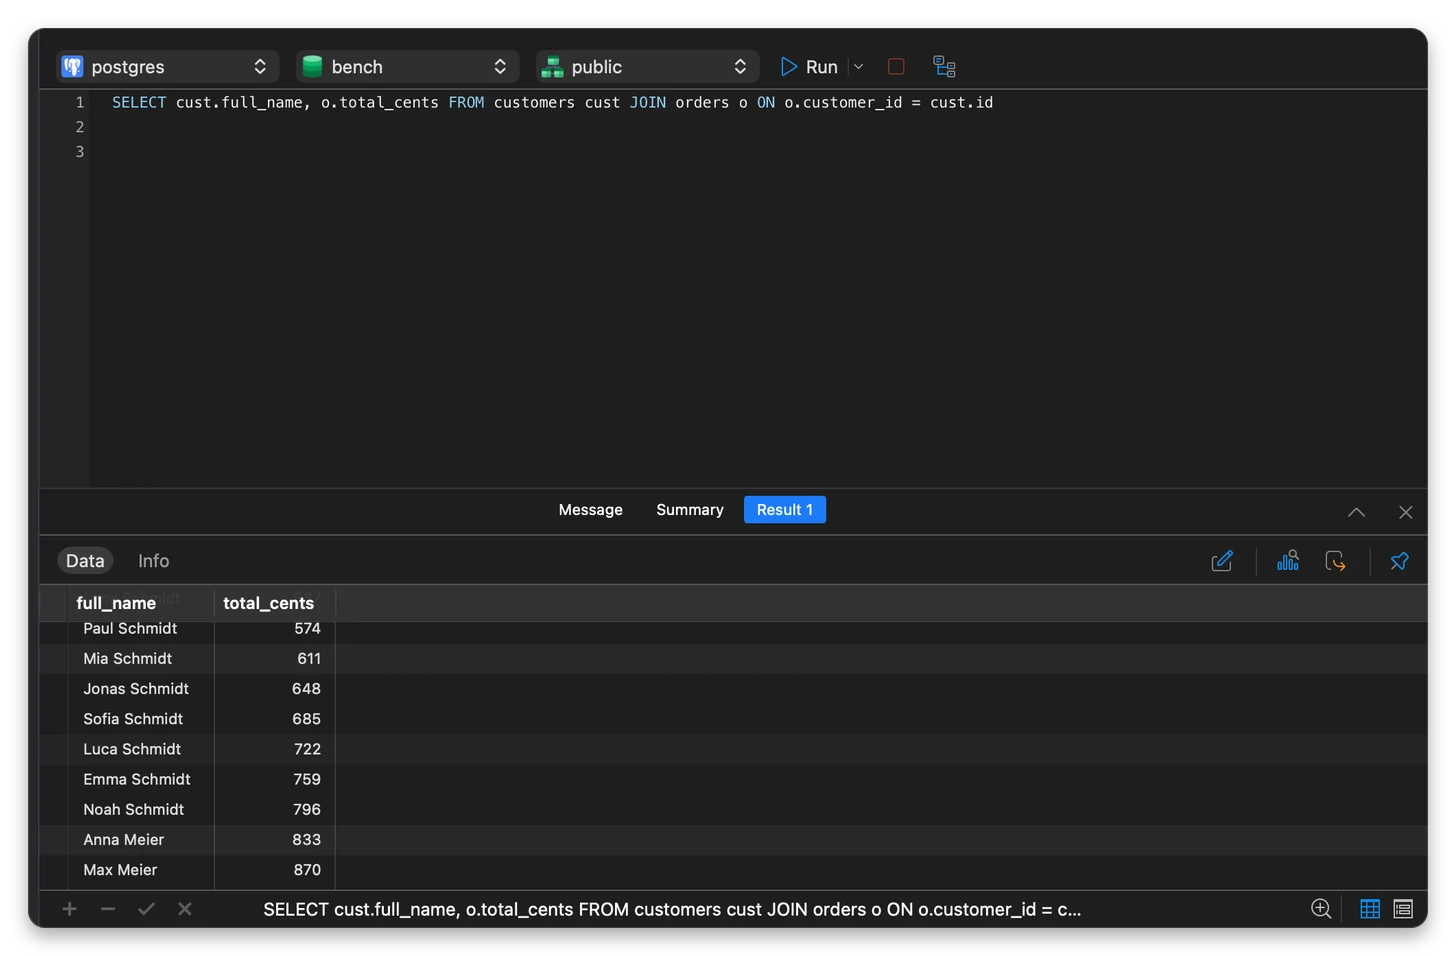
Im Dialog gibt es keine eigene Liste der Änderungen zum Prüfen. Die Hervorhebung im Editor ist die Vorschau. Für eine Abfrage dieser Größe reichte das.
Data Masking: eine Kopie maskieren und die Vorschau lesen
Data Masking steckt im Kontextmenü einer Tabelle, neben Data Generation, Data Dictionary und den Import- und Export-Assistenten.
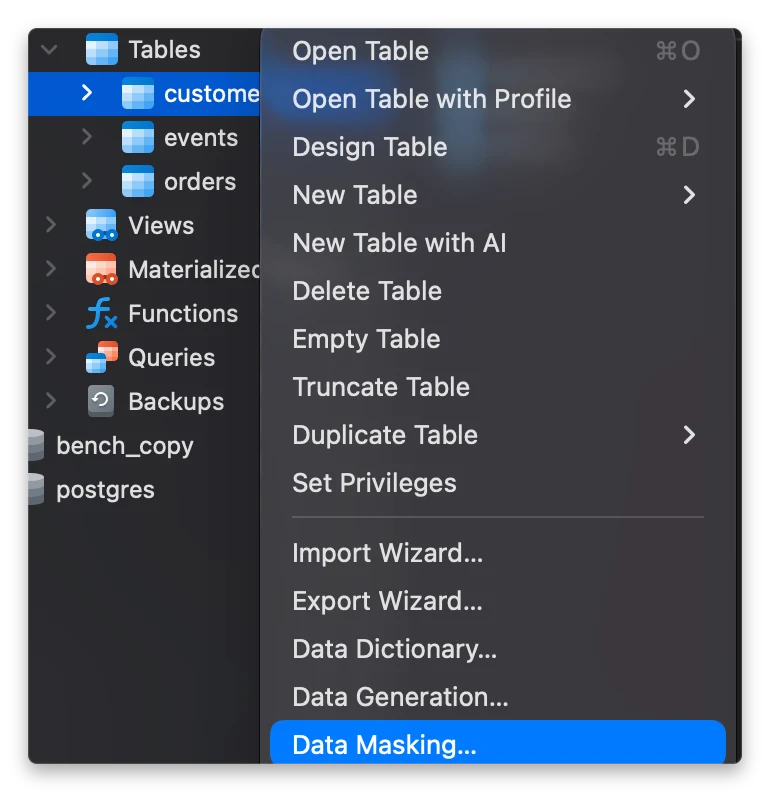
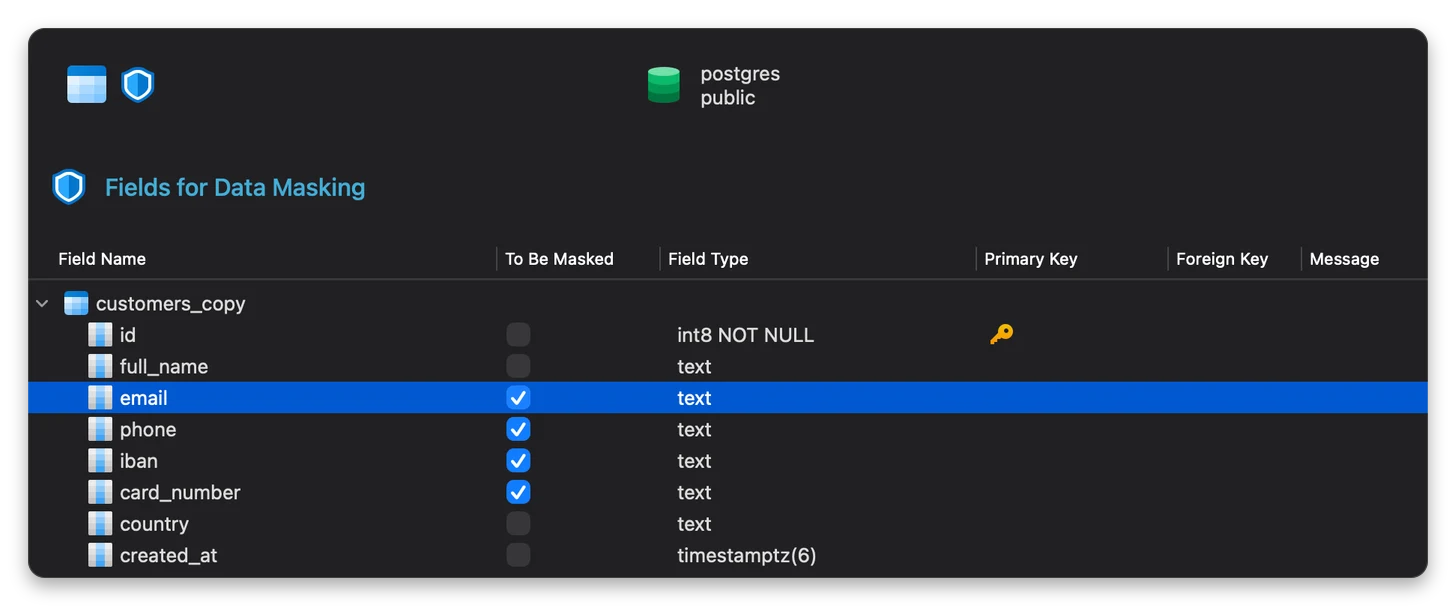
Ich habe es an einer Kopie von customers ausgeführt: 50.000 Zeilen mit ausgedachten Namen, E-Mails, Telefonnummern, IBANs und Kartennummern. Der erste Schritt listet jede Spalte mit Typ und Schlüssel auf, damit du nicht versehentlich einen Primärschlüssel maskierst. Ich habe email, phone, iban und card_number gewählt.
Jede Spalte bekommt ihre eigene Technik: Substitution, Variance, Hashing, Nulling oder Shuffling. Für card_number habe ich Substitution mit der Kategorie Credit Card Number genutzt, die ersten 6 und die letzten 4 Zeichen behalten und den Rest mit * maskiert. Das Vorschaufenster zeigt Eingabe und Ausgabe nebeneinander, bevor etwas geschrieben wird: Aus 0000000015485863 wird 000000******5863. Meine ausgedachten Nummern beginnen mit Nullen, der behaltene Teil sieht hier deshalb schlicht aus.
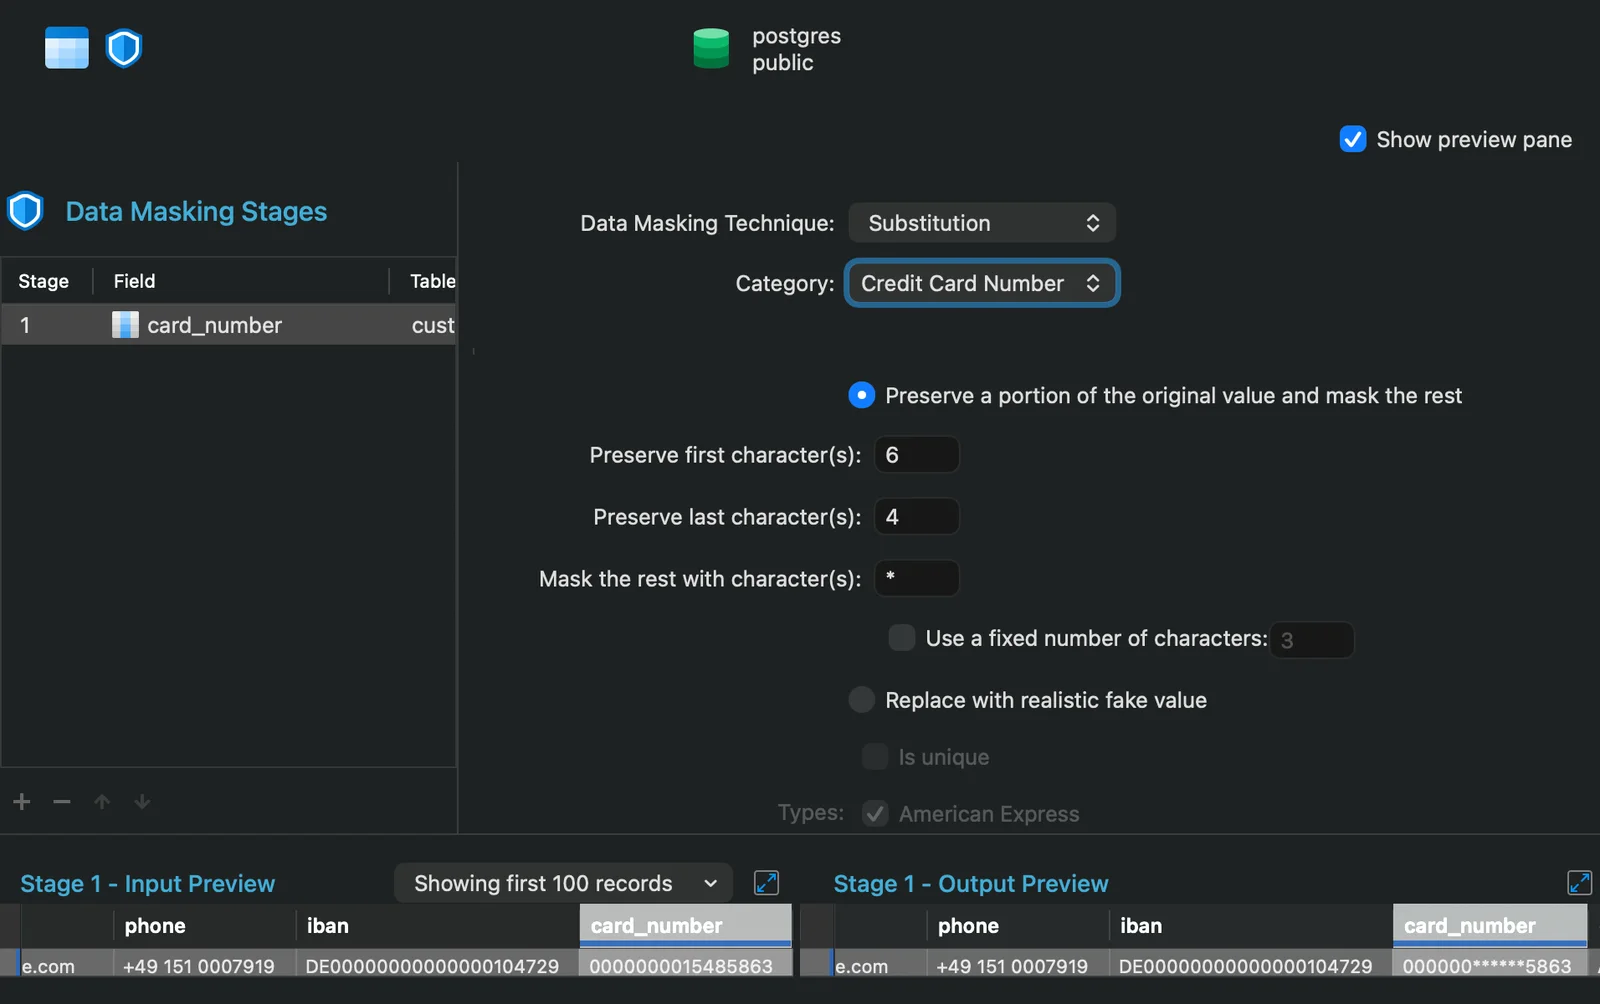
Mein erster Lauf war weniger sauber. Die Spalten email, phone und iban kamen als kurze Zahlen wie -5 und 44 zurück, statt als Text, der wie eine E-Mail-Adresse oder Telefonnummer aussieht. Technik und Kategorie zählen also pro Spalte, und in der Vorschau fängst du es ab, bevor du schreibst.
Zwei Gewohnheiten würde ich beibehalten: auf einer Kopie arbeiten und die Vorschau für jede Spalte lesen. Die anderen Techniken habe ich nicht einzeln getestet, auch nicht das Maskieren der Tabelle mit 10 Millionen Zeilen.
Was die kostenlose Lite-Edition abdeckt
Navicat Premium Lite ist kostenlos, und Navicat sagt, dass es kommerziell genutzt werden darf, mit bis zu fünf kostenlosen Benutzerkonten pro Organisation. Es verbindet sich mit PostgreSQL, MySQL, SQL Server, Oracle, MariaDB, Snowflake, MongoDB, Redis und SQLite aus einer App.
Navicats Feature-Matrix (Stand 30. Oktober) sagt, was in welcher Edition steckt. Für die Funktionen, die ich getestet habe:
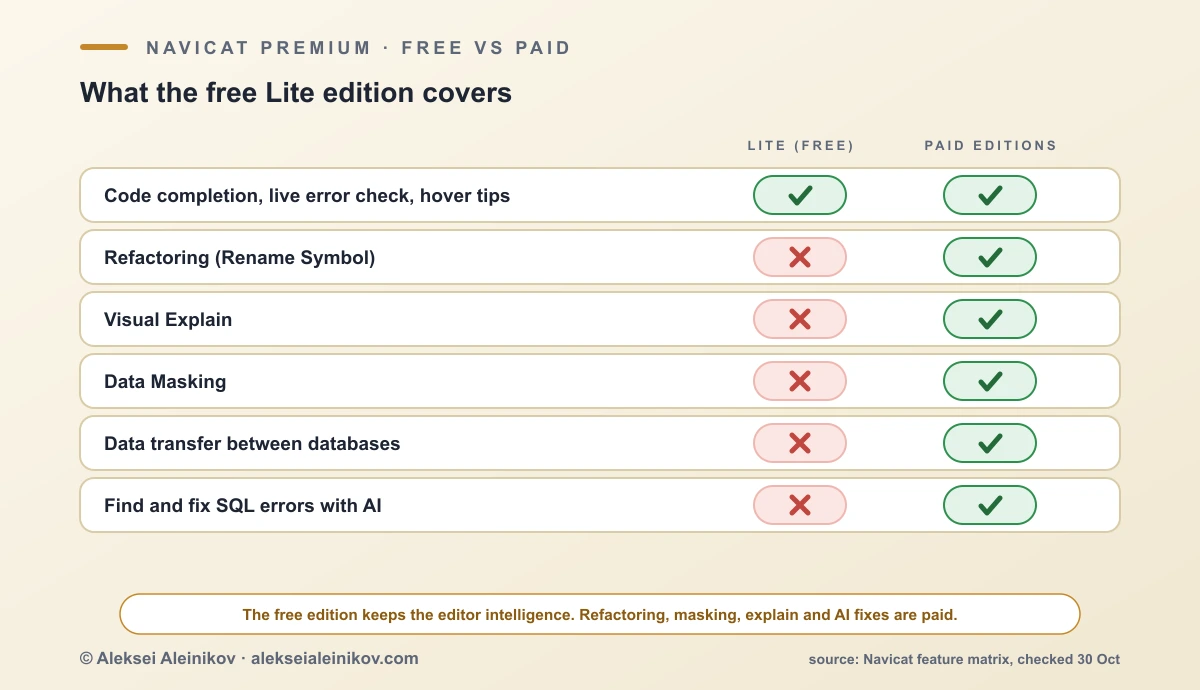
Wenn du hauptsächlich SQL gegen PostgreSQL schreibst, bekommst du mit Navicat Premium Lite die Editor-Intelligenz kostenlos. Refactoring, Visual Explain und Masking stecken in den kostenpflichtigen Editionen, und du kannst sie 14 Tage lang über die Premium-Download-Seite ausprobieren.
Navicat-Alternativen für PostgreSQL
Navicat ist nicht der einzige Weg. Das sind die Clients, mit denen es am häufigsten verglichen wird. Ich habe sie für diesen Artikel nicht getestet, das hier ist also nur, was jedes Projekt über sich selbst sagt:
| Werkzeug | Was es ist | Kosten |
|---|---|---|
| pgAdmin | Das klassische Open-Source-Admin-Werkzeug für PostgreSQL | Kostenlos |
| DBeaver | Ein Client für viele Datenbanken, mit Open-Source-Community-Edition | Kostenlose Community-Edition, kostenpflichtige Editionen |
| HeidiSQL | Ein schlanker Open-Source-Client, beliebt bei MySQL- und MariaDB-Nutzern | Kostenlos |
| DataGrip | Die Datenbank-IDE von JetBrains | Kommerziell |
| phpMyAdmin | Ein browserbasiertes Werkzeug für MySQL und MariaDB | Kostenlos |
Wenn du nur mit PostgreSQL arbeitest und das Budget null ist, reichen pgAdmin, DBeaver Community oder Navicat Lite für die Grundlagen. Navicat Premium ist für Leute, die viele Datenbanktypen in einem ausgereiften Fenster wollen und dafür zahlen.
Was andere Nutzer sagen
Unabhängige Bewertungen sind selten. Auf TrustRadius hat Navicat 4,45 von 5 (8,9 von 10) aus 15 Bewertungen, Stand 31. Oktober. Rezensenten loben die klare Oberfläche, die Anbindung mehrerer Datenbanktypen in einem Werkzeug und die Auto-Vervollständigung. Häufige Kritik sind der Preis, die kurze Testphase und uneinheitliche Dokumentation. AlternativeTo, das Navicat neben DBeaver, HeidiSQL und phpMyAdmin listet, zeigt etwa 80 Likes. Beides sind kleine Stichproben: Einige TrustRadius-Bewertungen sind als incentivized markiert.
Fazit
Die Live-Fehlerprüfung und die Vorschau von Fix with AI taten, was Navicat verspricht. Explain liefert den echten Plan, und Rename Symbol ist nützlich. Die Schwächen liegen in der Auffindbarkeit, nicht im Können: Explain steckt in einem Menü, in dem man nicht sucht, Rename ist aus einem Grund ausgegraut, den man erraten muss, und die Vervollständigung schweigt, bis ein Schema gesetzt ist.
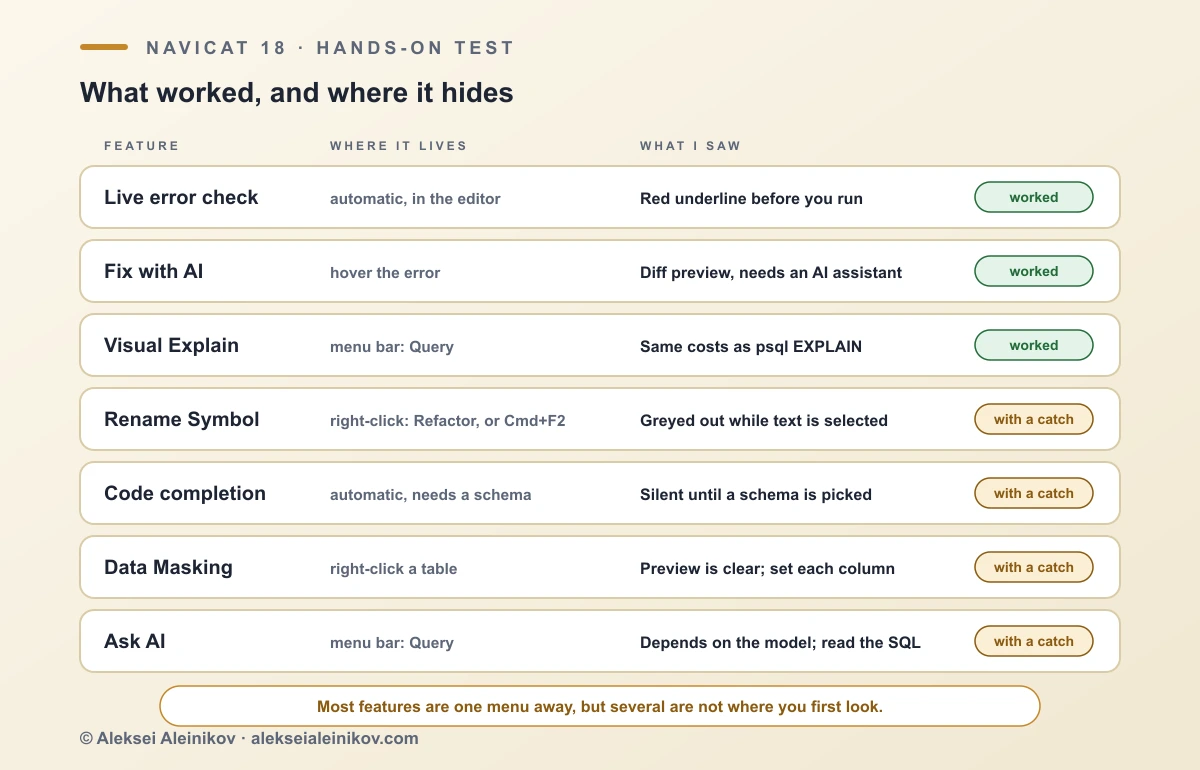
Die KI-Antwort, die ich bekam, brauchte eine Korrektur, und eine Vorschau sagt nicht, ob das SQL stimmt. Behandle Ask AI wie jeden anderen Vorschlag: lesen und an einer Kopie ausführen. Wenn Datenschutz zählt, zeige den Assistenten auf Ollama oder LM Studio.
Für wen es passt. Wenn du jeden Tag SQL gegen PostgreSQL schreibst und willst, dass der Editor Fehler früh fängt, deckt das kostenlose Lite einen guten Teil schon ab. Die kostenpflichtigen Editionen lohnen sich, wenn du Rename Symbol, Visual Explain oder Masking regelmäßig nutzt oder mit mehreren Datenbanktypen arbeitest, was ich hier nicht getestet habe.
Eine Vorschau zeigt, was geschrieben wird. Sie sagt nicht, ob es richtig ist.
PostgreSQL-Indizes: Welcher Typ wann? (10-Mio-Zeilen-Benchmark)
Gewinnspiel: drei Navicat-Lizenzen
Navicat verlost drei Jahreslizenzen: Navicat Premium, Navicat BI und Navicat Monitor. Trag unten deine E-Mail-Adresse ein, die Gewinner werden zufällig aus den bestätigten Teilnahmen gezogen. Das Abonnieren meines Newsletters ist ein freiwilliges Bonus-Häkchen und keine Voraussetzung für die Teilnahme.
Aus der Community
Diskussion auf Mastodon & Bluesky
Antworten auf diesen Artikel aus dem offenen Netz, live geladen. Keine Werbung, keine Tracking-Skripte.
Antworte dort — es erscheint hier automatisch.