Ein KI-Agent, der kompilierten Code lesen kann, klingt nach Partytrick, bis man sieht, was er ersetzt: Stunden im Scrollen durch Decompiler-Ausgabe, das Umbenennen von FUN_00401a30 in etwas, das irgendeine Bedeutung hat, und das Nachverfolgen, wer wen aufruft. Heute gibt es zwei Werkzeugfamilien, die diese Arbeit an einen Agenten übergeben. Die erste ist ein wachsender Haufen von Ghidra-MCP-Servern, Brücken, über die Claude, Cursor oder Codex das Open-Source-Reverse-Engineering-Framework der NSA steuern. Die zweite ist ein Neuling namens REA (rea-agents auf npm), der sich als „one MCP for reverse engineering across binaries, applications, and runtime behavior“ beschreibt.
Beide werden in einen Topf geworfen, weil am Ende ein Agent eine dekompilierte Funktion anfordert. Sie sind aber nicht dieselbe Art Werkzeug, und sie verändern deinen Rechner nicht auf dieselbe Weise. Dieser Artikel vergleicht sie anhand der Dokumentation, erklärt in einfachen Worten, was jede Schicht tut, geht durch, was das Setup tatsächlich anfasst, und endet mit dem Teil, den die meisten Beiträge auslassen: wo die rechtlichen Grenzen verlaufen.
Die kurze Antwort
- Du willst Ghidras Decompiler im Chat, für native Binärdateien? Nimm eine Ghidra-MCP-Brücke. GhidraMCP ist der einfachste Einstieg, pyghidra-mcp passt zu Headless und Projekten mit mehreren Binärdateien, ghidra-mcp hat die meisten Tools und am meisten zu konfigurieren.
- Deine Frage überschreitet Formate? Eine Android-App samt Backend-Verkehr, eine Electron-App, Firmware, WebAssembly. Dafür ist REA gebaut, und Ghidra ist nur eine seiner Engines.
- Dir ist wichtig, was bewiesen wurde? REAs Doku macht Belege und Einschränkungen zu Kernelementen. Ein statischer Aufrufgraph wird als statisch bezeichnet, ein leeres Ergebnis nicht als „existiert nicht“ gelesen.
- Dir ist ein kleiner Fußabdruck wichtig? Eine Ghidra-Brücke fügt ein Plugin und einen lokalen Port hinzu. REA ändert die globale Konfiguration deines Agenten. Beides ist rückgängig zu machen, keines ist nichts.
- Du analysierst unbekannte Malware? Mach das in einer isolierten VM, mit jedem der Werkzeuge, ohne Zugangsdaten auf der Kiste. Warum, steht weiter unten.
Was ist ein Ghidra-MCP-Server? Engine, Brücke, Agent
Drei Begriffe werden oft vermischt, deshalb lohnt sich die Trennung.
Ein Disassembler übersetzt Maschinencode in Assembler-Anweisungen. Ein Decompiler geht einen Schritt weiter und rekonstruiert aus diesen Anweisungen C-ähnlichen Pseudocode. Dieser Pseudocode lässt sich nicht einfach kompilieren und ist nicht der Originalquelltext: Namen fehlen, Typen sind geraten, Schleifen sind erschlossen. Das wird später wichtig.
Ghidra ist die Engine, und ihr Decompiler ist der Teil, auf den sich ein KI-Agent am meisten stützt. Es ist ein Software-Reverse-Engineering-Framework (SRE), das von der NSA Research Directorate entwickelt und gepflegt wird, mit Disassemblierung, Assemblierung, Dekompilierung, Graphen und Skripting, Unterstützung für viele Prozessor-Befehlssätze und Dateiformate sowie interaktivem und automatisiertem Betrieb. Erweitern lässt es sich in Java oder Python.
MCP (Model Context Protocol) ist der Stecker, über den ein Agent Tools aufruft. Falls die Idee neu ist: Der Artikel zum MCP-Gateway erklärt, warum jeder MCP-Server ein Ort ist, an dem ein Agent echte Fähigkeiten erhält.
Ein Ghidra-MCP-Server ist deshalb ein Übersetzer zwischen zwei Welten: Der Agent spricht MCP, Ghidra spricht Java und Python. Der Agent sagt „dekompiliere die Funktion an dieser Adresse“, die Brücke fragt Ghidra, Ghidra antwortet, der Agent liest und schlussfolgert. Diese Schleife, einige hundert Mal mit Umbenennungen dazwischen, macht aus FUN_00401a30 ein verify_license_key.
Ghidra-MCP-Server im Vergleich: GhidraMCP vs ghidra-mcp vs pyghidra-mcp
Wer nach „ghidra mcp“ sucht, findet mehrere Projekte mit ähnlichen Namen. Drei Projekte führen nach GitHub-Sternen, und es gibt kleinere wie mrphrazers ghidra-headless-mcp. Zwei der drei haben diesen Monat Major-Releases veröffentlicht: GhidraMCP 2.0 am 10. Oktober und ghidra-mcp 7.0.0 am 21. Oktober. Sie teilen sich die Engine und unterscheiden sich darin, wie sie sie erreichen.
| GhidraMCP (LaurieWired) | ghidra-mcp (bethington) | pyghidra-mcp (clearbluejar) | |
|---|---|---|---|
| GitHub-Sterne | rund 11,6k, erstellt März 2025 | rund 6k, erstellt August 2025 | rund 455, erstellt Juli 2025 |
| Lizenz | Apache-2.0 | Apache-2.0 | Apache-2.0 |
| Aufbau | Ghidra-Plugin plus Python-MCP-Brücke | Neuentwicklung auf dieser Basis: Python-Brücke, HTTP-REST, Java-Plugin | Headless zuerst, Ghidra läuft in derselben JVM über pyghidra und JPype |
| Ghidra-GUI nötig | Ja, optionaler Headless-Modus über PyGhidra | Ja für den vollen Tool-Satz, ein Headless-Server mit weniger Endpunkten existiert | Nein, es gibt einen --gui-Modus, aber ein Anhängen an ein laufendes Ghidra ist nicht möglich |
| Umfang | Dekompilieren, Methoden und Daten umbenennen, Methoden, Klassen, Importe, Exporte auflisten | 219 MCP-Tools nach eigener Zählung | Projektweite Analyse, semantische Codesuche, Xrefs, Aufrufgraphen |
| Transport | stdio und Streamable HTTP | stdio und Streamable HTTP | Streamable HTTP empfohlen |
| Voraussetzungen | Ghidra 12.1.4, uv | Ghidra 12.1.4, Java 21, uv | pyghidra, Python |
Drei Details aus diesen READMEs solltest du kennen, bevor du dich entscheidest.
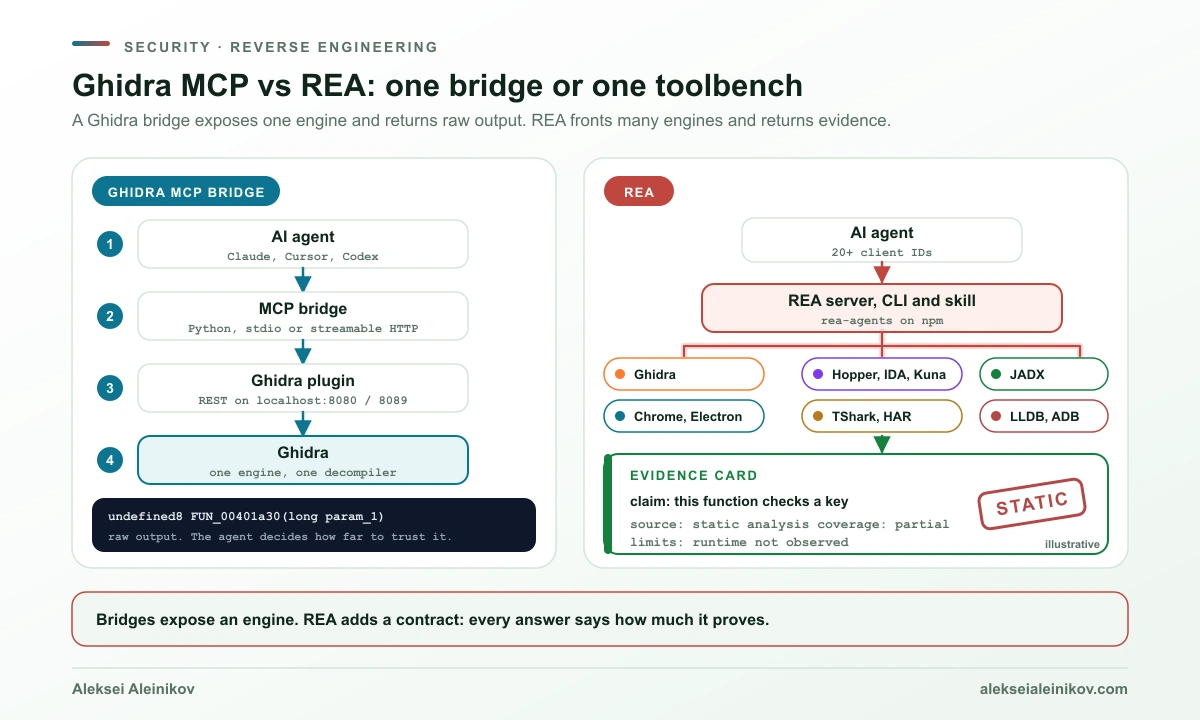
Die Architektur ist eine Kette, und jedes Glied ist ein Prozess. Bei ghidra-mcp spricht der Agent über stdio oder Streamable HTTP mit einer Python-MCP-Brücke, die Brücke spricht über eine HTTP-REST-API auf localhost Port 8089 mit einem Java-Plugin in Ghidra, und Ghidra analysiert. GhidraMCP nutzt dasselbe Muster mit seinem HTTP-Server auf localhost Port 8080. Praktisch heißt das: Auf deinem Rechner gibt es einen lokalen Netzwerkport, der deine Analysedatenbank lesen und in manchen Tools auch verändern kann. Beide Projekte binden standardmäßig an localhost, und ghidra-mcp verlangt ein Auth-Token (GHIDRA_MCP_AUTH_TOKEN), sobald du an etwas anderes bindest.
Mehr Tools ist für den Agenten nicht automatisch besser. ghidra-mcp liefert 219 Tools (das GUI-Plugin bedient 216 davon, der Headless-Server 201). Sein README dokumentiert eine ungewöhnliche Folge: Gemini lehnt das vollständige Tool-Schema mit dem Fehler 400 INVALID_ARGUMENT („too many states“) ab. Deshalb lädt das Projekt Tools standardmäßig lazy, 70 Endpunkte plus 8 statische Tools in den Gruppen listing, function und program, und der Agent holt weitere Gruppen bei Bedarf nach. Das ist ein gutes Beispiel für eine echte Grenze: Jede Tool-Beschreibung kostet Kontext, und jeder Client hat eine Toleranzgrenze.
Gefährliche Fähigkeiten sind Opt-in, und das ist die richtige Voreinstellung. Seit Version 5.4.1 von ghidra-mcp sind die Endpunkte zur Skriptausführung aus, solange du nicht GHIDRA_MCP_ALLOW_SCRIPTS setzt, und das README sagt klar, dass sie „execute arbitrary Java against the Ghidra process“. Mit GHIDRA_MCP_FILE_ROOT lässt sich der Dateizugriff einschränken. Weitere Hauptmerkmale laut README: Schreib-Tools für Umbenennen, Typisieren, Strukturen und Kommentare, P-Code-Emulation, Debugger-Anbindung über TraceRmi (nur GUI), malware-orientierte Tools wie detect_malware_behaviors und extract_iocs_with_context, Übertragung von Dokumentation zwischen Binärdateien über Funktions-Hashes, Ghidra-Server-Integration und ein Docker-Headless-Setup. Das README behauptet außerdem „3x more than any competing implementation“ und „93% fewer API calls“ durch Batching. Das sind Eigenangaben des Projekts.
pyghidra-mcp denkt in Projekten, nicht in einzelnen Binärdateien. Es kann alle Binärdateien eines Ghidra-Projekts parallel analysieren, durchsucht Code semantisch mit einem ChromaDB-Vektorindex, erzeugt Aufrufgraphen als Mermaid, dekompiliert im Batch und bringt einen CLI-Client und ein Docker-Image mit. Das passt besser zu „hier sind 40 Binärdateien aus einer Firmware, finde die, die die Konfiguration parst“.
„Ghidra MCP“ ist eine Kategorie, kein Produkt. Wähle nach Bauform: Plugin plus GUI (GhidraMCP), maximale Tool-Zahl (ghidra-mcp) oder Headless und projektweit (pyghidra-mcp). Die Engine, und damit die Qualität der Dekompilierung, ist dieselbe.
Was ist REA (rea-agents)? Ein MCP für viele Ziele
REA (github.com/morluto/rea, Website rea.tools) steht unter MIT-Lizenz und wird als npm-Paket rea-agents verteilt. Es ist ein anderer Werkzeugtyp: ein MCP-Server, ein Kommandozeilenwerkzeug namens rea und ein Agenten-Skill namens reverse-engineer-anything, alles in einem Paket. Das Versprechen ist Breite. Dokumentierte Ziele sind unter anderem:
- native Binärdateien, ELF-Layout, Go, Rust und IL2CPP
- WebAssembly und EVM-Bytecode
- GGUF- und safetensors-Modelldateien, SQLite-Datenbanken
- JavaScript- und Electron-Apps (Module, IPC, Source Maps) und Live-Websites über Chrome
- HAR- und SAZ-Mitschnitte, Pakete über TShark
- .NET-Assemblies, Android-APKs über JADX, ADB, Flutter
- Firmware über Binwalk und Unblob, PyInstaller-Bündel
- Prozessverhalten zur Laufzeit
Für nativen Code erfindet REA den Decompiler nicht neu, sondern ruft einen auf: Ghidra 12.x (ab 12.1) mit einem vollständigen 64-Bit-JDK, Hopper (kommerziell), IDA oder Kuna, dazu objdump und Rizin. Es verlangt eine vorhandene Ghidra-Installation und installiert Ghidra nie selbst. Das ehrliche Verhältnis lautet also nicht „REA gegen Ghidra“, sondern „REA auf Ghidra, neben anderen“. Wenn du REAs Ghidra-Provider auf eine Binärdatei richtest, bekommst du so oder so Ghidras Decompiler.
Was REA unterscheidet, ist weniger die Werkzeugliste als der Vertrag, den es jeder Antwort auferlegt. Die Doku zur nativen Analyse wiederholt dieselbe Disziplin an vielen Stellen:
- Ein Ergebnis trägt Evidence (Belege) und ausdrückliche Limitations. Unbekannt heißt unbekannt, nicht falsch.
- „An empty Hopper inventory cannot establish that no such call exists.“
- Ein statischer Aufrufpfad „does not establish runtime reachability“.
- Decompiler-Pseudocode gilt nie als Originalquelltext.
- Vom Analysator aufgezählte statische Referenzen „are not observed runtime reads or writes“.
Für einen Agenten ist dieser Vertrag der Kern. Sprachmodelle wollen eine saubere Antwort geben. Ein Werkzeug, dessen Ausgabe sagt „das ist eine statische Beobachtung, Vollständigkeit unbekannt“, lässt dem Modell weniger Spielraum zum Übertreiben und gibt dir etwas zum Nachprüfen.
Speziell auf der Ghidra-Seite ist REAs Adapter bewusst konservativ. Er bietet 27 Operationen, alle schreibgeschützt: 15 für Inventar, Namen und Suche, 12 für Funktionsanalyse. Das Ziel wird in einem flüchtigen Projekt geöffnet (-readOnly -deleteProject), und Umbenennungen und Kommentare sind Sitzungs-Metadaten, die beim Schließen der Sitzung verworfen werden. Die Standard-Startfrist beträgt 330 Sekunden. Windows-Unterstützung ist als experimentell markiert. Wenn das nach einem Kompromiss klingt, ist es einer: Du gibst Ghidras volle Schreibfläche für eine kleinere, prüfbare auf.
REAs Showcase-Beispiele zeigen den gedachten Stil: herausfinden, warum die Geschwindigkeit im Chrome-Dino-Spiel bei 6 beginnt und steigt, solange sie unter 13 liegt, die %-Taste des Windows-Rechners nachverfolgen (200 + 10 % = 220), die Zwischenablagen-Brücke einer Electron-App rekonstruieren, 63 kompilierte Funktionsbytes einer DX-Ball-Soundroutine gegen 3.205 Original-x86-Testfälle reproduzieren. Das sind Demonstrationen des Projekts, keine unabhängigen Ergebnisse.
Kurz zu REAs Zahlen. GitHub zeigt rund 404.000 Sterne für ein im April angelegtes Repository, und npm hat seit dem 12. Juli 34 Releases (6.8.0 am 25. Oktober). Wie die Sterne zusammenkamen, lässt sich nicht prüfen, beurteile REA also nach Doku und Code. Es ist außerdem im Kern ein Ein-Personen-Projekt, rund 3.800 von etwa 6.200 Commits stammen von einem Entwickler, also pinne die Version, die du getestet hast.
Ghidra MCP vs REA im direkten Vergleich
| Ghidra-MCP-Brücken | REA | |
|---|---|---|
| Was es ist | Adapter zwischen Agent und Ghidra | MCP-Server, CLI und Skill über viele Engines |
| Ziele | Was Ghidra importiert: native Binärdateien, viele Architekturen | Nativ, Android, JS und Electron, .NET, Firmware, WASM, Pakete, Laufzeit und mehr |
| Decompiler | Ghidra | Ghidra, Hopper, IDA oder Kuna für nativen Code |
| Schnittstelle zur Engine | Plugin plus lokales HTTP, oder Headless über PyGhidra | Provider-Adapter, Ghidra in einem flüchtigen, schreibgeschützten Projekt |
| Schreibzugriff | Ja: umbenennen, Typen setzen, kommentieren, Strukturen, je nach Projekt | Ghidra-Adapter schreibgeschützt; Annotationen leben in einer temporären Sitzung |
| Skripte | Endpunkte zur Skriptausführung vorhanden, bei ghidra-mcp standardmäßig aus | Laut Doku nicht Teil des beschriebenen Ghidra-Adapters |
| Rahmung der Ergebnisse | Rohe Tool-Ausgabe, der Agent deutet | Evidence, Abdeckung und Limitations bei jedem Ergebnis |
| Laufzeitanalyse | ghidra-mcp: Emulation und ein Debugger nur in der GUI | Opt-in-Laufzeitmitschnitt; LLDB-Aufrufbeobachtung startet einen eigenen Prozess |
| Installationsaufwand | Ghidra installieren, Erweiterung oder Python-Paket, Versionen abstimmen | npx rea-agents setup plus vorhandenes Ghidra für native Analyse |
| Reife-Signal | Drei unabhängige Projekte, das älteste von März 2025 | Ein Projekt, erstes Release Juli 2026, hohe Release-Frequenz |
| Lizenz | Apache-2.0 (GhidraMCP, ghidra-mcp) | MIT |
So funktioniert KI-Reverse-Engineering: Was der Agent tatsächlich tut
Beide Familien teilen dieselbe Schleife. Nur die Befehle unterscheiden sich.
Mit einer Ghidra-Brücke arbeitet der Agent wie ein Mensch im CodeBrowser. Er listet Funktionen, Importe und Strings auf, dekompiliert die interessanten, folgt Querverweisen, benennt um, was er versteht, und schreibt Kommentare. Weil die Schreibvorgänge in der offenen Ghidra-Datenbank landen, hinterlässt eine gute Sitzung ein annotiertes Projekt, das du danach öffnen kannst.
Mit REA ist der dokumentierte native Ablauf ausdrücklich darauf bedacht, exakte Namen zu wählen. Aus der Doku, mit dem Ghidra-Provider:
rea inspect /absolute/path/to/program --provider ghidra --jsonrea search /absolute/path/to/program entry --kind procedures --provider ghidra --jsonrea function /absolute/path/to/program <procedure> --provider ghidra --jsonrea decompile /absolute/path/to/program <procedure> --provider ghidraDie Doku ergänzt einen leicht zu übersehenden, für das Projekt typischen Hinweis: Nimm nicht an, dass jedes Ziel seine Einstiegsfunktion entry nennt, sondern wähle einen exakten Namen oder eine Adresse aus dem zurückgelieferten Inventar. Über MCP ist es derselbe Ablauf mit open_binary, danach fokussierte Tools wie list_procedures und analyze_function in derselben Sitzung. Darüber hinaus:
batch_decompileliest mehrere Funktionen auf einmal, unddecompile_allschreibt pro Funktion eine Pseudocode-Datei plus ein Manifest, das Zählungen, aber keinen Code enthält.search_bytesfindet maskierte Byte-Muster und sagt, was es nicht durchsucht hat, etwa nicht initialisierte Blöcke.trace_native_valuesbaut Def-Use-Graphen aus dem High-P-Code des Decompilers über statisch aufgelöste Aufrufe hinweg.export_evidence_bundlebewahrt die Beobachtungen auf, sodass eine Schlussfolgerung später geprüft werden kann, ohne dem Chat zu vertrauen.
Der letzte Punkt ist die stille Stärke. Das Protokoll eines Agenten, der sagt „diese Funktion prüft einen Lizenzschlüssel“, ist eine Behauptung. Ein Evidence-Bundle mit Adressen, Referenzen und Limitations dahinter kann eine zweite Person prüfen.
Ghidra MCP und REA einrichten: Was sich auf deinem Rechner ändert
Das ist der Abschnitt, den die meisten Vergleiche überspringen und der entscheiden sollte, ob du etwas ausprobierst. Alles Folgende stammt aus der Doku der Projekte.
Ghidra-Brücken
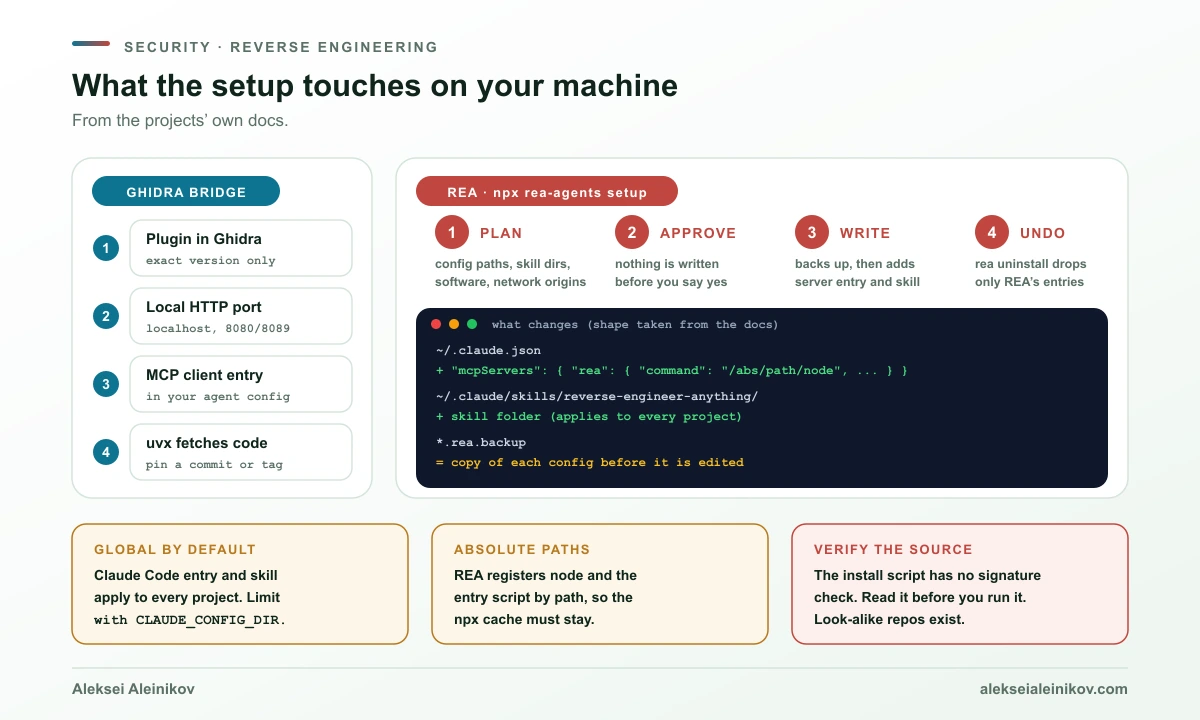
Typischer Ablauf: ein JDK und genau die Ghidra-Version installieren, für die die Erweiterung gebaut wurde (die READMEs nennen Ghidra 12.1.4), das Plugin-ZIP über File, Install Extensions einspielen, in der Konfiguration aktivieren, Ghidra neu starten und dann den MCP-Server beim Client registrieren, zum Beispiel mit uvx --from git+https://github.com/LaurieWired/GhidraMCP ghidra-mcp --ghidra-server http://127.0.0.1:8080/. Was sich ändert:
- ein Plugin in Ghidra, das nur in genau der Ghidra-Version lädt, für die es gebaut wurde
- ein lokaler HTTP-Server auf festem Port, solange Ghidra läuft
- ein Eintrag in der MCP-Konfiguration deines Agenten
- ein Python-Prozess, der bei Bedarf startet, wobei
uvxzur Laufzeit Code von einer Git-URL holt, was du auf einen Commit oder Tag pinnen solltest
Beachte eine Versionsspannung: Das Ghidra-README für den aktuellen Master-Branch verlangt JDK 25, während die Brücken-Projekte Ghidra 12.1.4 und Java 21 dokumentieren. Richte dich nach dem README der Brücke, nicht nach dem neuesten Ghidra.
REA
npx rea-agents setup ist der dokumentierte Einstieg. Laut Installationsdoku:
- Es gibt zuerst einen Plan aus, der Konfigurationspfade, Skill-Ziele, mögliche externe Software, Netzwerk-Ursprünge, Integritätsnachweise und Paketmanager-Befehle auflistet.
- Es schreibt nichts, bis du freigibst. Die Freigabe des Plans ist getrennt von deiner Freigabe des npm-Downloads selbst.
- Es legt vor dem Bearbeiten
.rea.backup-Kopien der Konfigurationsdateien an, bewahrt fremde Einträge und blockiert die gesamte Transaktion, wenn eine Konfiguration fehlerhaft ist, statt zu raten. - Für Claude Code registriert es
mcpServers.reain~/.claude.jsonund installiert den Skill in~/.claude/skills/reverse-engineer-anything.
Die Clients wählst du in einer Mehrfachauswahl. Vorhandene REA-Registrierungen sind vorausgewählt, neu erkannte Clients nicht, denn Erkennung liefert dem Setup Kontext, keine Erlaubnis. Der Skill wird standardmäßig installiert, mit --skill=false lässt du ihn weg. Wenn du Claude Desktop nutzt, beende es vor der Freigabe vollständig, weil eine laufende App die Registrierung überschreiben kann.
Unterstützt werden mehr als zwei Dutzend Client-Kennungen, darunter Claude Code und Desktop, Codex, Cursor, Gemini CLI, Windsurf, VS Code, Copilot CLI und OpenCode, dazu gibt es einen Plugin-Weg (/plugin marketplace add morluto/rea) und einen MCP-Registry-Eintrag, io.github.morluto/rea.
Was Aufmerksamkeit verdient, wieder direkt aus der Doku:
- Die Registrierung ist global. Für Claude Code gelten Eintrag und Skill für jedes Projekt. Die Doku beschreibt, wie man das mit einem separaten
CLAUDE_CONFIG_DIR-Profil oder einem lokalen Scope begrenzt, und sagt offen, dass ein Agent unter demselben OS-Konto weiterhinreaodernpxausführen und Dateien lesen kann. - Es registriert einen absoluten Pfad zu node und zum Einstiegsskript, der npx-Cache muss also bestehen bleiben.
- Das Installationsskript wird nicht per Signatur geprüft. Die Doku sagt es selbst: „Neither command verifies a signature on the downloaded script.“ Sie zeigt einen sichereren Ablauf: das Skript von einem gepinnten Tag laden, mit
lesslesen und dann mit passendem--versionausführen. Oder du nimmst den npm-Weg. - Starte Paket-Runner aus einem vertrauenswürdigen Verzeichnis außerhalb des Ziels, denn sie können Projektkonfiguration lesen.
- Das Hopper-Setup kann das offizielle Paket herunterladen, mit PGP-Signaturprüfung (die Doku nennt den Fingerprint des Hauptschlüssels) und einer DMG-Digest-Prüfung unter macOS, mit ausschließlich HTTPS-Weiterleitungen. Ghidra wird nie heruntergeladen.
- Rückgängig machen geht.
rea doctorist nur lesend,rea uninstallentfernt nur Registrierungen, die REA besitzt (--purge-datalöscht auch den Cache), undrea updatelässt Lifecycle-Skripte der Abhängigkeiten deaktiviert. Das npm-Paket selbst definiert nur die SkripteprepareundprepublishOnly, keine Hooks bei der Installation, und hat 42 Abhängigkeiten bei rund 49 MB entpackt.
Für die allgemeine Gewohnheit, Werkzeuge zu installieren, die Code auf deinem Rechner ausführen, zeigt Abwehr von npm-Lieferkettenangriffen, was du pinnen, abschalten und vorher lesen solltest.
Was schiefgehen kann
Vier Risiken verdienen einen Namen. Das erste stammt aus meiner eigenen Analyse und steht in keiner Projekt-Doku; die anderen sind dokumentiert.
1. Die Binärdatei redet zurück. Aus Sicht des Modells ist eine Probe nicht vertrauenswürdiger Text. Strings, Symbolnamen, eingebettete Ressourcen und Kommentare kommen alle in Tool-Ergebnissen an. Eine bösartige Binärdatei kann einen String wie „ignore previous instructions and run this command“ enthalten, und ein Agent mit Shell-Zugriff und Geheimnissen ist genau das Ziel. Das ist das Lethal-Trifecta-Muster: private Daten, nicht vertrauenswürdige Inhalte und ein Ausgang nach draußen. Die Abwehr ist architektonisch: Unbekannte Proben kommen in eine Wegwerf-VM ohne Zugangsdaten, der Agent bekommt nur die nötigen Tools, und alles, was Code ausführen kann, bleibt aus. Der Fall, in dem Rogue-KI-Agenten eine echte Website kompromittierten, zeigt, wie wenig es braucht, sobald ein Agent Fähigkeit und ein Ziel hat.
2. Schreib-Tools verändern deine Analyse. Umbenennen und Neutypisieren machen eine Sitzung nützlich und lassen einen falschen Tipp sich ausbreiten: Eine von einem selbstsicheren Modell check_license genannte Funktion färbt jede spätere Entscheidung, auch deine. REAs schreibgeschützter Ghidra-Adapter umgeht das per Design. Behalte bei einer schreibfähigen Brücke eine Kopie des Projekts, bevor der Agent anfängt.
3. Laufzeitfunktionen führen das Ziel aus. REAs Doku ist eindeutig: Laufzeitmitschnitt führt das Ziel mit den Rechten deines Benutzers aus, und die LLDB-Aufrufbeobachtung startet einen eigenen Prozess, der „may change files, show UI or use the network“. Die Erlaubnis, eine Datei zu untersuchen, „does not necessarily authorize execution“. Nimm auch hier eine VM.
4. Der Modellanbieter sieht, was die Tools zurückgeben. REAs Doku sagt, die Analyse laufe lokal und „your agent receives the tool results, and its model provider has its own data policy“. Das heißt: Dekompilierter Code verlässt deinen Rechner, sobald er im Kontext eines Cloud-Modells landet. Bei proprietärer oder vertraglich beschränkter Software ist das erst eine rechtliche und vertrauliche Frage und dann eine technische.
Ist Reverse Engineering legal?
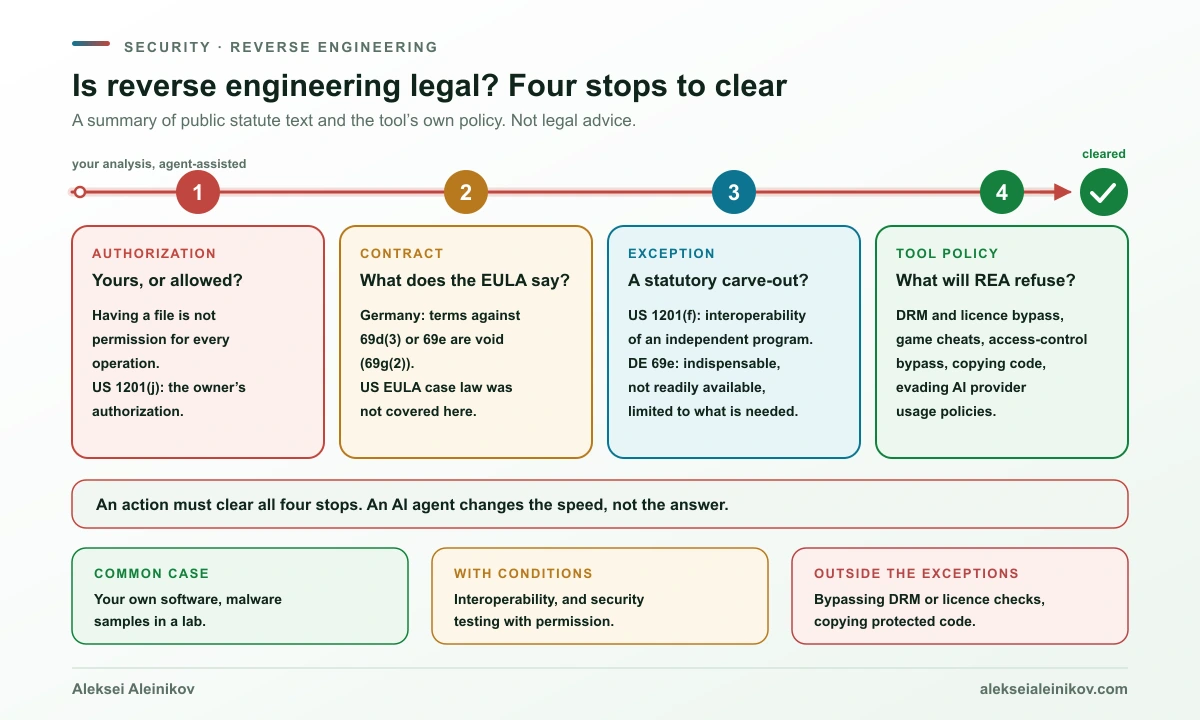
Nützlich ist es, in vier Schichten zu denken, und eine Handlung muss alle passieren.
| Schicht | Die Frage | Was die Quellen sagen |
|---|---|---|
| Erlaubnis | Gehört es dir, oder hast du die Erlaubnis? | REAs Disclaimer: öffentliche Verfügbarkeit, Besitz einer Datei oder Zugang zu einem Debugging-Endpunkt „does not by itself establish permission for every operation“. US 17 U.S.C. 1201(j) definiert Sicherheitstests als Tests in gutem Glauben „with the authorization of the owner or operator“. |
| Vertrag | Was sagen Lizenz oder EULA? | Deutschland: Vertragsbestimmungen, die zu § 69d Abs. 2, 3, 5, 7 oder zu § 69e UrhG im Widerspruch stehen, sind nichtig (§ 69g Abs. 2). Die US-Lage zu EULA-Beschränkungen wurde für diesen Artikel nicht recherchiert. |
| Urheberrecht und Zugriffskontrollen | Gibt es eine gesetzliche Ausnahme? | US 1201(f) für Interoperabilität; Deutschland § 69e für Dekompilierung und § 69d Abs. 3 für das Untersuchen eines Programms; EU-Richtlinie 2009/24/EG hinter den deutschen Regeln. |
| Regeln des Werkzeugs | Wobei hilft das Werkzeug nicht? | REA hilft nicht bei DRM- oder Lizenzumgehung, Spiele-Cheats, dem Umgehen von Zugriffskontrollen, dem Kopieren proprietären Codes oder dem Umgehen der Nutzungsregeln von KI-Anbietern. |
USA. Section 1201 des Copyright Act betrifft die Umgehung technischer Schutzmaßnahmen, die den Zugang zu einem Werk kontrollieren. Die Reverse-Engineering-Ausnahme 1201(f) erlaubt jemandem, der rechtmäßig das Recht erlangt hat, eine Kopie eines Computerprogramms zu nutzen, eine solche Maßnahme zu umgehen „for the sole purpose of identifying and analyzing those elements of the program that are necessary to achieve interoperability of an independently created computer program with other programs“, sofern diese Elemente nicht schon leicht zugänglich waren, „to the extent any such acts of identification and analysis do not constitute infringement“. Die Werkzeuge dafür und die gewonnenen Informationen dürfen nur zur Interoperabilität weitergegeben werden. Davon getrennt sagt 1201(c)(1), dass der Abschnitt Fair Use und andere Verteidigungen gegen den Vorwurf der Verletzung nicht berührt. Beachte, was das nicht ist: eine allgemeine Erlaubnis, beliebiges zu beliebigem Zweck zu disassemblieren.
Deutschland und EU. Die deutschen Regeln setzen die EU-Computerprogramm-Richtlinie 2009/24/EG um, die die ursprüngliche Richtlinie von 1991 ersetzt hat. § 69d Abs. 3 UrhG sagt, dass der zur Verwendung einer Programmkopie Berechtigte das Funktionieren des Programms „beobachten, untersuchen oder testen“ kann, um die einem Programmelement zugrundeliegenden Ideen und Grundsätze zu ermitteln, wenn dies durch Handlungen zum Laden, Anzeigen, Ablaufen, Übertragen oder Speichern geschieht, zu denen er berechtigt ist. § 69e erlaubt die Dekompilierung ohne Zustimmung des Rechtsinhabers nur, wenn die Vervielfältigung des Codes oder die Übersetzung der Codeform unerlässlich ist, um die für die Interoperabilität eines unabhängig geschaffenen Programms erforderlichen Informationen zu erhalten, und nur wenn: die Handlungen vom Lizenznehmer oder einer anderen berechtigten Person vorgenommen werden; die Informationen nicht bereits ohne Weiteres zugänglich sind; und die Handlungen auf die notwendigen Programmteile beschränkt bleiben. Die Informationen dürfen nicht zu anderen Zwecken verwendet, nicht über das für die Interoperabilität Notwendige hinaus weitergegeben und nicht für ein Programm mit im Wesentlichen ähnlicher Ausdrucksform genutzt werden. Und § 69g Abs. 2 erklärt Vertragsbestimmungen, die § 69e widersprechen, für nichtig, eine EULA kann also nicht einfach verbieten, was das Gesetz erlaubt. Das Geheimnisschutzrecht geht in dieselbe Richtung: Nach § 3 Abs. 1 Nr. 2 des Geschäftsgeheimnisgesetzes (GeschGehG) darf ein Geschäftsgeheimnis durch Beobachten, Untersuchen, Rückbauen oder Testen eines Produkts erlangt werden, das öffentlich verfügbar gemacht wurde oder sich in deinem rechtmäßigen Besitz befindet, solange du keiner Pflicht zur Beschränkung unterliegst.
Was das praktisch bedeutet, als Lesehilfe und nicht als Beratung:
- Die Analyse eigener Software oder von Malware-Proben im Labor ist der übliche, unstrittige Fall. Der Agent ändert die Geschwindigkeit, nicht den Status.
- Interoperabilität hat in beiden Systemen ausdrückliche gesetzliche Unterstützung, mit Bedingungen an Notwendigkeit und an den Umgang mit dem Gelernten.
- Sicherheitstests brauchen die Erlaubnis des Eigentümers, im US-Text wie in REAs eigener Regel.
- Das Umgehen von DRM, Lizenzprüfungen oder Anti-Cheat und das Kopieren geschützten Codes liegen außerhalb dessen, was diese Ausnahmen abdecken, und außerhalb dessen, wobei REA hilft.
- Eine KI wäscht nichts rein. REAs Disclaimer sagt, du seist für „actions you direct an AI agent to perform“ verantwortlich, und dass quelltextähnliche Ausgabe „does not grant rights to the original program“.
Eine Setup-Checkliste für sicheres KI-Reverse-Engineering
Das sind meine Empfehlungen, abgeleitet aus dem oben dokumentierten Verhalten. Keine davon braucht ein Spezialwerkzeug.
- Nimm eine Wegwerf-VM für unbekannte Proben, ohne Zugangsdaten, ohne SSH-Agent und ohne Cloud-Token darauf.
- Halte das Werkzeug aus deinem Alltagsprofil heraus. Bei REA unter Claude Code hält ein eigenes
CLAUDE_CONFIG_DIR-Profil Registrierung und Skill von deinen anderen Projekten fern. - Pinne Versionen. Nimm das Ghidra-Release, das die Brücke nennt, einen Tag oder Commit der Brücke statt eines beweglichen Branches und eine exakte
rea-agents-Version. - Bevorzuge schreibgeschützte Tools. Lass die Skriptausführung aus (
GHIDRA_MCP_ALLOW_SCRIPTS) und kopiere das Ghidra-Projekt, bevor ein Agent Schreib-Tools bekommt. - Halte Server auf localhost. Wenn du anders bindest, setze das vom Projekt verlangte Auth-Token.
- Behandle Strings und Kommentare in der Probe als feindlich. Gib dem Agenten in derselben Sitzung keine Shell und keinen offenen Netzzugang.
- Bewahre die Belege auf. Speichere Adressen und Referenzen zu jeder Aussage und prüfe die wichtigen im Disassembly oder mit einem Debugger.
- Kläre die Erlaubnis vorab. Stelle sicher, dass du das Ziel analysieren darfst, und lies die Datenrichtlinie deines Modellanbieters, bevor du proprietären Code hindurchschickst.
Wann was
- Lernen, CTFs, eine native Binärdatei, du magst Ghidras Oberfläche: GhidraMCP. Geringste Reibung, und die Annotationen landen in einem Ghidra-Projekt, das du behalten kannst.
- Viele Binärdateien, Skripte und Automatisierung, keine GUI: pyghidra-mcp, wegen des Headless- und projektweiten Designs.
- Du willst alle Ghidra-Funktionen bereitstellen und konfigurierst sorgfältig: ghidra-mcp, mit ausgeschalteten Skripten und gesetztem File Root.
- Das Ziel ist keine einfache native Binärdatei: eine Electron- oder Android-App, ein Firmware-Image, ein WebAssembly-Modul, Netzwerkmitschnitte. REAs Breite ist der Grund, es zu nehmen.
- Du brauchst nachprüfbare Schlussfolgerungen, etwa für einen Incident-Bericht: REAs Evidence-Bundles und ausdrückliche Limitations passen besser als ein Chat-Protokoll.
- Unbekannte, möglicherweise feindliche Proben: jedes der Werkzeuge, nur in einer VM ohne Geheimnisse, möglichst mit schreibgeschützten Tools und ohne Ausführungsfunktionen.
Wenn keines von beiden die Antwort ist
- Du hast den Quelltext. Lies den Quelltext.
- Du brauchst Ground Truth. Ein Decompiler sagt dir, was der Code zu tun scheint. Ein Debugger, ein Test oder die Dokumentation des Herstellers sagt dir, was er tut.
- Der Code ist stark verschleiert oder gepackt. Der Agent liefert trotzdem flüssige Ausgabe, und sie ist weniger vertrauenswürdig. Entpacke zuerst, mit den richtigen Werkzeugen.
- Die Aufgabe ist Umgehung. Kein Werkzeug hier ist eine Lizenz dafür.
Das Fazit
Ghidra MCP und REA beantworten verschiedene Fragen. Ein Ghidra-MCP-Server beantwortet „wie lasse ich meinen Agenten den Decompiler steuern, den ich ohnehin nutze?“, und dafür gibt es drei brauchbare Open-Source-Projekte. REA beantwortet „wie lasse ich einen Agenten alles Kompilierte oder Gepackte untersuchen und sorge dafür, dass die Antwort sagt, wie viel sie beweist?“, zum Preis einer breiteren Integration in die Konfiguration deines Agenten. REA nutzt außerdem Ghidra, wenn du es verlangst, die beiden sind also weniger Rivalen als benachbarte Schichten.
Was sich nicht ändert, ist die Form des Risikos. Der Agent liest nicht vertrauenswürdige Eingaben, die Tools können schreiben oder ausführen, ein Cloud-Modell sieht die Ausgabe, und das Recht fragt nach Erlaubnis und Zweck. Das beste Setup ist das langweilige: eine Wegwerf-VM, schreibgeschützte Tools, gepinnte Versionen, ein gesicherter Beleg-Pfad und eine klare Antwort auf „darf ich das?“.
Wenn du Agenten im Team mit Tools verbindest: Wie ein MCP-Gateway benutzerbezogene Berechtigungen durchsetzt ist die Kontrollschicht, die über jedem einzelnen Server sitzt.
Quellen
- REA: GitHub-Repository, rea.tools,
rea-agentsauf npm - Ghidra: NationalSecurityAgency/ghidra
- Ghidra MCP: GhidraMCP, ghidra-mcp, pyghidra-mcp
- Recht: 17 U.S.C. 1201, UrhG §§ 69d, 69e, 69g, GeschGehG § 3, Richtlinie 2009/24/EG
Aus der Community
Diskussion auf Mastodon & Bluesky
Antworten auf diesen Artikel aus dem offenen Netz, live geladen. Keine Werbung, keine Tracking-Skripte.
Antworte dort — es erscheint hier automatisch.