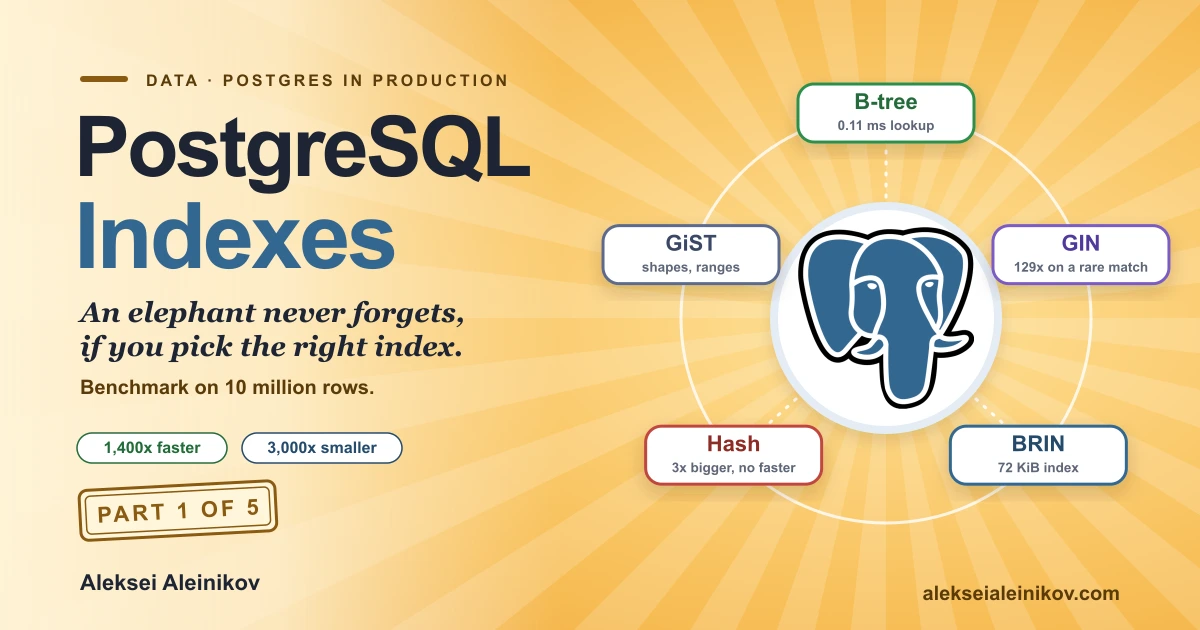
Früher oder später tippt jedes Postgres-Team in Eile CREATE INDEX, und die meisten tippen denselben. B-tree ist der richtige Standard, aber nicht immer die richtige Antwort. Auf einer Tabelle mit 10 Millionen Zeilen fand ich einen Index, der 3.000-mal kleiner und nur 3-mal langsamer war, einen Index, der gar nichts bewirkte, und einen „abdeckenden“ Index, der Abfragen beschleunigte, bis ein ganz normales UPDATE den Vorteil wieder auffraß.
Das ist Teil 1 von Postgres in Production, einer Serie über die Entscheidungen, die zählen, sobald eine Datenbank das Tutorial verlässt: Indizes, VACUUM und Bloat, Connection Pooling, Partitionierung und JSONB. Jeder Teil folgt einer Regel: erst messen, dann erklären. Die Zahlen unten stammen von PostgreSQL 18.6 und einem Open-Source-Benchmark, den du selbst ausführen kannst.
Welcher PostgreSQL-Index-Typ passt: die kurze Antwort
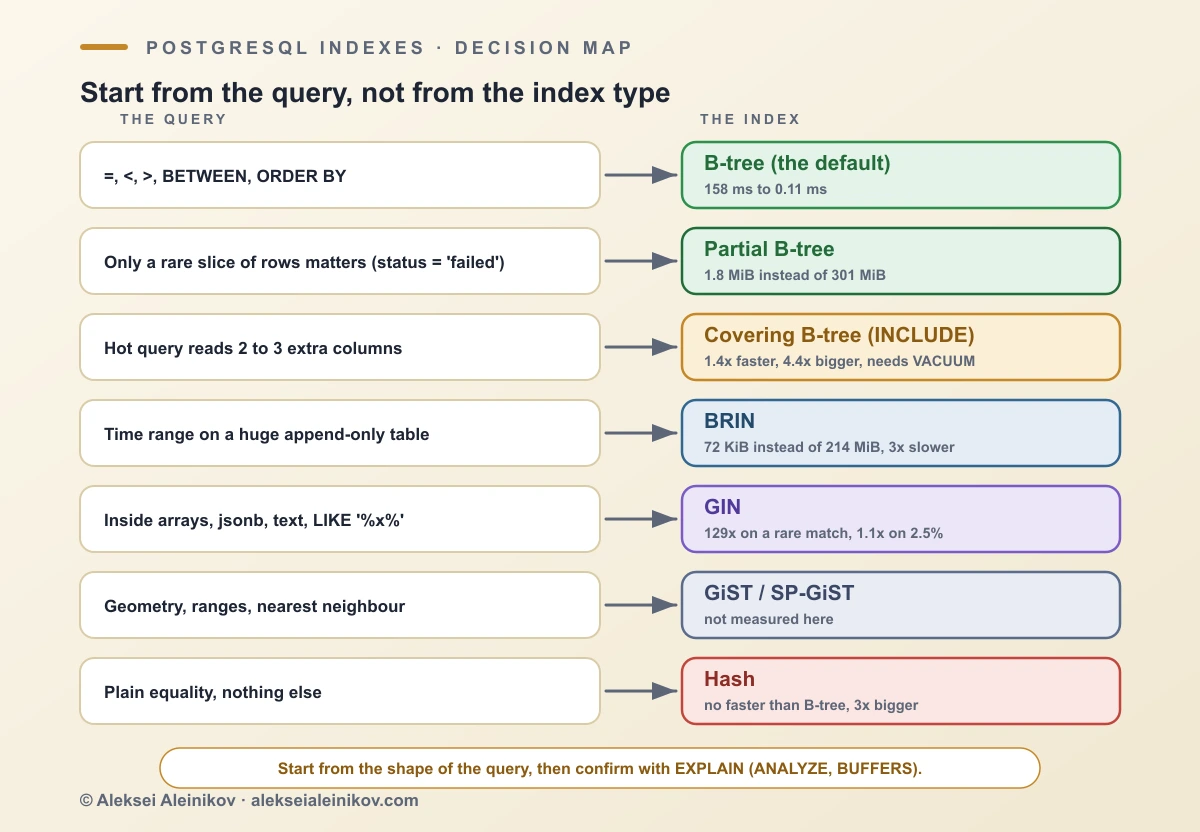
Ein PostgreSQL-Index ist eine eigene Datenstruktur, mit der die Datenbank Zeilen findet, ohne die ganze Tabelle zu lesen. Der Typ bestimmt, welche Fragen er beantworten kann und wie viel Platz und Schreibzeit er kostet.
| Deine Abfrage | Index | Gemessen auf 10 Millionen Zeilen |
|---|---|---|
WHERE user_id = 42, Bereiche, ORDER BY |
B-tree (Standard) | 158 ms Scan, 0,11 ms mit Index |
Nur ein seltener Ausschnitt zählt (status = 'failed') |
Partieller B-tree | 1,8 MiB statt 301 MiB, gleiche Geschwindigkeit |
| Wenige Spalten, viele Zugriffe | Abdeckender B-tree (INCLUDE) |
0,109 auf 0,078 ms, bei 4,4-facher Größe |
| Zeitbereich auf geordneten Append-only-Daten | BRIN | 72 KiB statt 214 MiB, 3-mal langsamer |
Enthält: Arrays, jsonb, Volltext, LIKE '%x%' |
GIN | 360 ms auf 2,8 ms bei seltenem Tag |
| Geometrie, Bereiche, nächster Nachbar | GiST oder SP-GiST | hier nicht gemessen |
| Nur Gleichheit | Hash | nicht schneller als B-tree, 3-mal größer |
Wie ein Index eine Zeile findet und was ein Scan kostet
Ohne Index liest PostgreSQL die Tabelle Seite für Seite und prüft jede Zeile. Die Testtabelle ist 1,6 GB groß, 208.376 Seiten à 8 KB, und ein Sequential Scan hat jede einzelne gezählt. Ein B-tree-Index auf derselben Tabelle ist ein drei bis vier Ebenen tiefer Baum, ein Schlüssel kostet also eine Handvoll Seiten: Die Abfrage unten las 14 Buffer statt 208.376.
Das ist die ganze Idee, alles andere sind Abwägungen. Ein größerer Index beantwortet mehr Arten von Fragen, kostet aber Platz, Aufbauzeit und Schreibzeit. Der Planer wählt anhand geschätzter Kosten zwischen Scan und Index, deshalb wird ein vorhandener Index nicht immer benutzt (mehr dazu unten). Was wirklich passiert ist, zeigt EXPLAIN (ANALYZE, BUFFERS). Seit PostgreSQL 18 ist BUFFERS bei ANALYZE automatisch dabei.
Der Benchmark: eine Tabelle, 10 Millionen Zeilen, und was jeder Index kostet
Eine Tabelle events mit bigint-Primärschlüssel, user_id (zufällig, etwa 10 Zeilen pro Nutzer), status (70 % done, 20 % active, 9 % pending, 0,85 % failed, 0,15 % archived), created_at (eine Zeile alle 3 Sekunden, wächst also mit id), einer Spalte tags text[] und einer Spalte payload jsonb. Die Tabelle ist 1,6 GB groß, der Primärschlüssel 214 MiB. Die Daten kommen aus einem festen Zufalls-Seed, jeder Lauf erzeugt also dieselben Zeilen.
Jede Abfrage lief einmal zum Aufwärmen und danach dreimal, die Tabellen zeigen den Median. Punkt- und Bereichsabfragen wurden für mehrere Parameterwerte wiederholt. Jede gemessene Abfrage lief außerdem mit deaktivierten Index-Scans, und die Antworten mussten übereinstimmen, sonst bricht das Skript ab. PostgreSQL 18.6, warmer Cache, autovacuum aus, damit die Visibility Map unter Kontrolle bleibt (eine Produktionsdatenbank sollte so nicht laufen).
B-tree: der Standard aus gutem Grund
B-tree ist ein balancierter Baum aus sortierten Schlüsseln. Weil die Schlüssel sortiert sind, beantwortet eine Struktur =, <, >, BETWEEN, ORDER BY und IS NULL, und er ist das, was CREATE INDEX baut, solange du nichts anderes verlangst.
CREATE INDEX ix_user ON events (user_id);SELECT * FROM events WHERE user_id = 424242;Suche nach user_id |
Zeit | Buffer | Indexgröße | Aufbau |
|---|---|---|---|---|
| Ohne Index (Sequential Scan) | 158 ms | 208.376 | keiner | keiner |
| B-tree | 0,112 ms | 14 | 88,5 MiB | 1,4 s |
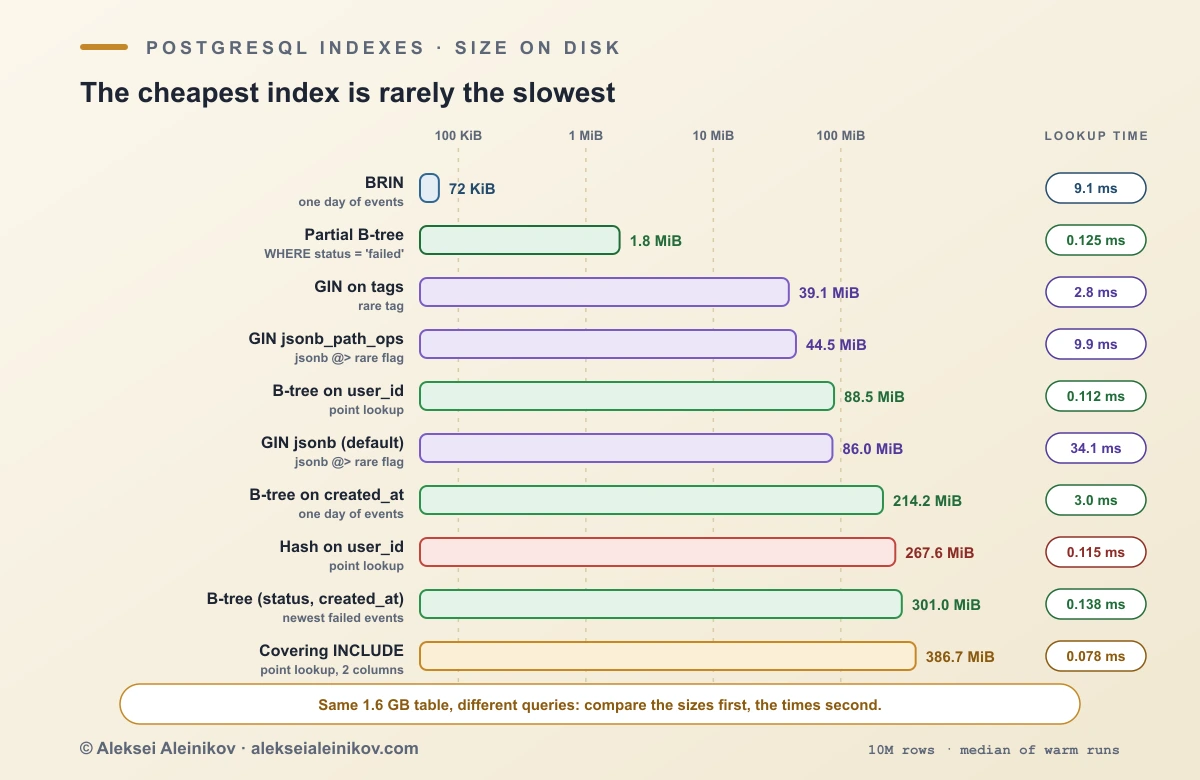
Das ist etwa 1.400-mal schneller für einen zusätzlichen Index von 88,5 MiB, aufgebaut in 1,4 Sekunden auf einer 1,6-GB-Tabelle. Der Index ist klein, weil B-tree jeden doppelten Schlüssel nur einmal speichert und eine Liste von Zeilenzeigern führt (Deduplizierung, seit PostgreSQL 13). Derselbe Index auf einer Zeitspalte, in der jeder Schlüssel einzigartig ist, ist 214 MiB groß.
Wenn eine Spalte im
WHERE,JOINoderORDER BYeiner häufigen Abfrage steht, die wenige Zeilen liefert, ist ein B-tree fast immer die Antwort. Die anderen Typen gibt es für das, was B-tree schlecht kann.
Hash-Index: nicht besser als B-tree
Ein Hash-Index speichert einen Hash des Schlüssels und unterstützt nur Gleichheit. Die Theorie sagt, er müsse bei Punktabfragen schneller sein. In diesem Test war er es nicht:
user_id = ? |
Suche | Indexgröße | Aufbau |
|---|---|---|---|
| B-tree | 0,112 ms | 88,5 MiB | 1,4 s |
| Hash | 0,115 ms | 267,6 MiB | 13,0 s |
Gleiche Geschwindigkeit, dreifacher Platz, neunfache Aufbauzeit, und keine Bereiche oder Sortierung. Hash-Indizes sind seit PostgreSQL 10 absturzsicher, gefährlich sind sie also nicht, aber bei vielen doppelten Schlüsseln haben sie keinen Vorteil gegenüber einem B-tree, der dedupliziert. Das ist ein Datensatz, kein Gesetz: Bei langen String-Schlüsseln kann Hashing Platz sparen, miss also, bevor du ihn abschreibst.
BRIN: ein 72-KiB-Index für zeitlich geordnete Daten
Ein BRIN (Block Range Index) speichert für jeden Bereich von Tabellenseiten eine Zusammenfassung, normalerweise Minimum und Maximum. Eine Abfrage überspringt jeden Bereich, dessen Zusammenfassung nicht passen kann. Er ist winzig, funktioniert aber nur, wenn die Werte der Spalte der physischen Reihenfolge der Tabelle folgen, und ein Append-only-created_at tut genau das: pg_stats meldet hier eine Korrelation von 1,0 für created_at und etwa 0 für user_id.
CREATE INDEX ix_ts_brin ON events USING brin (created_at);Die Abfrage: ein Tag Ereignisse, 28.800 Zeilen von 10 Millionen.
Ein Tag nach created_at |
Zeit | Buffer | Indexgröße | Aufbau |
|---|---|---|---|---|
| Ohne Index | 635 ms | 208.376 | keiner | keiner |
| B-tree | 3,0 ms | 690 | 214,2 MiB | 1,7 s |
| BRIN (Standardbereich von 128 Seiten) | 9,1 ms | 785 | 72 KiB | 0,2 s |
BRIN (pages_per_range = 32) |
8,2 ms | 683 | 232 KiB | 0,2 s |
B-tree ist dreimal schneller, und BRIN ist etwa 3.000-mal kleiner. Bei einer Tabelle, die um Milliarden Zeilen wächst, ist das der Unterschied zwischen einem Index, der in den Speicher passt, und einem, der es nicht tut, und ein BRIN-Index lässt sich in Sekundenbruchteilen neu bauen. Wenn deine Abfragen immer „der letzte Tag“ oder „der letzte Monat“ lauten, ist BRIN die günstige Wahl. Wenn eine einzelne Suche unter einer Millisekunde antworten muss, nimm B-tree. Ein kleineres pages_per_range macht den Index etwas größer und schärfer.
Partielle Indizes: nur die Zeilen indizieren, die zählen
Ein partieller Index hat eine WHERE-Klausel und enthält nur die passenden Zeilen. Er ist die günstigste Optimierung in diesem Artikel, weil viele Abfragen einen kleinen, klar definierten Ausschnitt betreffen: unverarbeitete Jobs, fehlgeschlagene Zahlungen, aktive Sessions.
CREATE INDEX ix_failed_ts ON events (created_at) WHERE status = 'failed';
SELECT id, created_at FROM eventsWHERE status = 'failed' ORDER BY created_at DESC LIMIT 50;| Die neuesten 50 fehlgeschlagenen Ereignisse | Zeit | Indexgröße | Aufbau |
|---|---|---|---|
| Ohne Index | 177 ms | keiner | keiner |
Voller Index (status, created_at) |
0,138 ms | 301,0 MiB | 3,5 s |
Partieller Index WHERE status = 'failed' |
0,125 ms | 1,8 MiB | 0,2 s |
Fehlgeschlagene Ereignisse sind 0,85 % der Zeilen. Der partielle Index beantwortet die Abfrage so schnell wie der volle und ist etwa 160-mal kleiner, baut in einem Bruchteil der Zeit und kostet beim Schreiben fast nichts, weil 99 % der Inserts ihn nie berühren. Die Regel: Das WHERE der Abfrage muss das WHERE des Index implizieren, schreibe die Bedingung also in beiden gleich. Ein Parameter wie status = $1 kann den Planer in einem generischen Plan daran hindern, den Treffer zu beweisen, prüfe mit EXPLAIN, ob der partielle Index genutzt wird.
Abdeckende Indizes: schneller, aber nur auf einer sauberen Tabelle
Ein Index-Only-Scan beantwortet eine Abfrage allein aus dem Index, ohne die Tabelle zu besuchen. INCLUDE (ab PostgreSQL 11) fügt dem Index genau dafür zusätzliche Spalten hinzu.
CREATE INDEX ix_user_cov ON events (user_id) INCLUDE (created_at, status);SELECT created_at, status FROM events WHERE user_id = 424242;| Abdeckender Index gegen einfachen B-tree | Zeit | Buffer | Indexgröße |
|---|---|---|---|
Einfacher B-tree auf user_id |
0,109 ms | 14 | 88,5 MiB |
| Abdeckend, Tabelle frisch vakuumiert | 0,078 ms | 9 | 386,7 MiB |
| Abdeckend, nach Update von 1 % der Zeilen | 0,109 ms | 13 | 386,7 MiB |
Abdeckend, nach VACUUM |
0,079 ms | 9 | 386,7 MiB |
Zwei Lehren. Erstens: Der Gewinn ist echt, aber bescheiden (1,4-fach), während der Index 4,4-mal größer ist: Für eine Abfrage mit zehn Ergebniszeilen ist ein einfacher B-tree schon gut. Abdeckende Indizes lohnen sich in der Theorie mehr, wenn eine Abfrage viele Zeilen aus einem Indexbereich liefert und jeder Heap-Zugriff zählt; miss das auf deinen eigenen Daten. Zweitens: Ein Index-Only-Scan prüft weiterhin die Visibility Map, um zu sehen, ob eine Seite vollständig sichtbar ist, und ein UPDATE löscht diese Bits. Nachdem 1 % der Zeilen angefasst wurden, verteilt über jede Seite, war der Vorteil weg, bis VACUUM wieder lief. Autovacuum übernimmt das normalerweise; der Benchmark schaltet es ab, um den Effekt sichtbar zu machen.
Mehrspaltige Indizes und Skip Scan in PostgreSQL 18
Ein mehrspaltiger B-tree sortiert nach der ersten Spalte, dann innerhalb jedes ersten Werts nach der zweiten, die Reihenfolge der Spalten zählt also. Vor PostgreSQL 18 konnte eine Abfrage, die nur nach der zweiten Spalte filterte, so einen Index nicht effizient nutzen. PostgreSQL 18 bringt Skip Scan, der durch die verschiedenen Werte der führenden Spalte springt.
CREATE INDEX ix_status_ts ON events (status, created_at);-- gar kein Filter auf status:SELECT count(*) FROM eventsWHERE created_at >= '2025-02-12' AND created_at < '2025-02-12 01:00';Eine Stunde nach created_at |
Zeit | Buffer | Plan |
|---|---|---|---|
| Ohne Index | 233 ms | 210.460 | Seq Scan |
Index (status, created_at) |
0,246 ms | 72 | Index Only Scan, Index Searches: 11 |
EXPLAIN meldet jetzt Index Searches: 11 Abstiege durch den Index statt einem, was immer noch winzig ist. Skip Scan macht einen Index nützlicher, den du ohnehin hast. Er funktioniert, wenn die übersprungene Spalte wenige verschiedene Werte hat (hier fünf Status). Bei Millionen verschiedener führender Werte lässt er nach, ersetzt also keinen eigenen Index auf die Spalte, nach der du filterst.
GIN: wenn eine Zeile viele Werte enthält
Ein GIN (Generalized Inverted Index) bildet jedes Element auf die Zeilen ab, die es enthalten, wie das Register hinten in einem Buch. Er ist der Index für Arrays, jsonb, Volltextsuche (tsvector) und, mit der Erweiterung pg_trgm, für LIKE '%text%'.
CREATE INDEX ix_tags ON events USING gin (tags);CREATE INDEX ix_payload ON events USING gin (payload jsonb_path_ops);
SELECT count(*) FROM events WHERE tags @> ARRAY['rare'];SELECT count(*) FROM events WHERE payload @> '{"beta": true}';| Abfrage | Treffer | Ohne Index | GIN | Indexgröße |
|---|---|---|---|---|
| Array, seltener Tag | 1.042 Zeilen | 360 ms | 2,8 ms (129x) | 39,1 MiB |
| Array, häufiger Tag | 99.778 Zeilen (1 %) | 364 ms | 113 ms (3,2x) | 39,1 MiB |
jsonb @> seltenes Flag |
5.064 Zeilen | 353 ms | 34,1 ms (10x) mit Standard-Ops | 86,0 MiB |
jsonb @> seltenes Flag |
5.064 Zeilen | 353 ms | 9,9 ms (36x) mit jsonb_path_ops |
44,5 MiB |
jsonb @> Land und Tarif |
250.512 Zeilen (2,5 %) | 399 ms | 347 ms (1,1x) Standard, 262 ms (1,5x) jsonb_path_ops |
86,0 / 44,5 MiB |
Drei Dinge zum Mitnehmen:
- Die Selektivität entscheidet alles. GIN glänzt, wenn der Treffer selten ist (129-mal schneller), und hilft kaum, wenn der Treffer 2,5 % der Tabelle sind, weil die Heap-Seiten trotzdem gelesen werden müssen. Eine unselektive Enthält-Abfrage ist ein Hinweis auf das Datenmodell, kein Indexproblem.
- Probiere bei
jsonbjsonb_path_ops. Er ist etwa halb so groß und bei@>-Abfragen schneller, unterstützt dafür aber die Operatoren zur Schlüsselprüfung (?,?|,?&) nicht. - Parallele Builds sind neu. PostgreSQL 18 kann einen GIN-Index mit parallelen Workern bauen: 3,8 s mit vier Workern gegenüber 14,4 s seriell beim
tags-Index, 3,8-mal schneller, was beim Neuaufbau großer Tabellen zählt.
GiST und SP-GiST: für Formen und Bereiche
Diese habe ich auf diesen Daten nicht gemessen, weil die Testtabelle keine Geometrie und keine Bereiche enthält, und ein erfundener Benchmark würde nur mein Schema messen. GiST ist ein Rahmen für baumbasierte Indizes über Daten ohne lineare Ordnung: geometrische Typen (PostGIS nutzt ihn), Bereichstypen und Nächste-Nachbarn-Suche (ORDER BY location <-> point). Er stützt auch Exclusion Constraints wie „zwei Buchungen desselben Raums dürfen sich nicht überschneiden“. SP-GiST unterstützt raumpartitionierte Strukturen wie Quad-Trees und Radix-Tries, nützlich für unbalancierte Daten wie IP-Adressen oder Telefonvorwahlen. Wenn deine Abfrage &&, <-> oder @> auf Formen oder Bereichen nutzt, fang hier an.
Wenn der Planer deinen Index ignoriert
Der häufigste Index-Fehler ist nicht der falsche Typ, sondern eine Abfrage, die der Index nicht bedienen kann. Zwei Fälle, gemessen auf derselben Tabelle:
Ein Tag nach created_at oder ein Status-Filter |
Plan | Zeit |
|---|---|---|
created_at >= ... AND created_at < ... |
Index Scan | 3,0 ms |
created_at::date = '2025-04-01' |
Seq Scan | 329 ms |
Dasselbe, mit Ausdrucks-Index auf (created_at AT TIME ZONE 'UTC')::date |
Index Scan | 2,7 ms |
status = 'done' (70 % der Zeilen), Index auf status |
Seq Scan | 263 ms |
status = 'archived' (0,15 % der Zeilen), derselbe Index |
Index Scan | 20,9 ms |
Eine indizierte Spalte in eine Funktion oder einen Cast zu packen macht den Index unbrauchbar. Schreibe die Bedingung also als Bereich um oder indiziere den Ausdruck. Beachte, dass timestamptz::date von der Zeitzone der Session abhängt und sich deshalb nicht direkt indizieren lässt: Der Ausdrucks-Index nutzt AT TIME ZONE 'UTC'. Und wenn eine Abfrage den Großteil der Tabelle trifft, hat der Planer recht, den Index zu überspringen: 70 % einer Tabelle über einen Index zu lesen ist langsamer als ein Sequential Scan.
Die Schreibsteuer: Jeder Index kostet bei jedem Insert
Lesen ist nur die halbe Rechnung. Jeder Insert muss in jedem Index der Tabelle einen Eintrag ergänzen. Ich habe 1 Million Zeilen in eine leere Tabelle mit Primärschlüssel und dann 0, 1, 3 und 5 weiteren Indizes eingefügt:
| Sekundäre Indizes | 1 Mio. Zeilen einfügen | Im Vergleich zu nur Primärschlüssel |
|---|---|---|
| 0 | 1,9 s | 1,0x |
1 (B-tree auf user_id) |
4,3 s | 2,3x |
3 (dazu created_at und (status, created_at)) |
5,8 s | 3,1x |
5 (dazu GIN auf tags und auf payload) |
12,1 s | 6,4x |
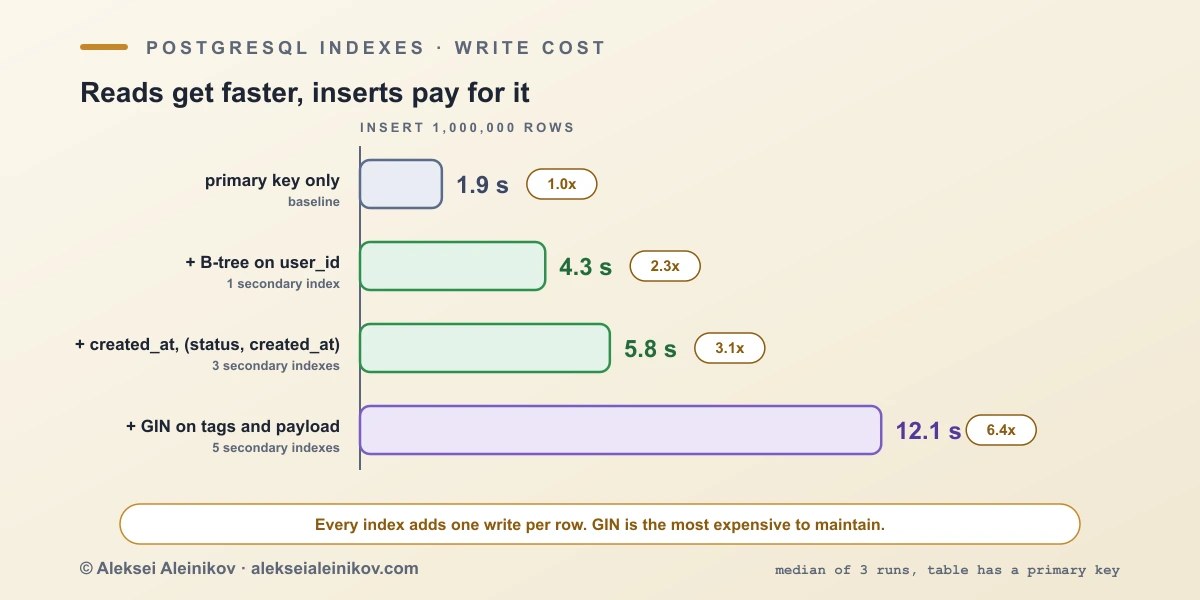
Der Sprung von 3 auf 5 Indizes, mehr als eine Verdopplung der Zeit, sind die beiden GIN-Indizes: Sie sind am teuersten in der Pflege, und PostgreSQL puffert GIN-Updates standardmäßig in einer Pending-Liste, um das abzumildern. Indizes verlangsamen auch UPDATE (wenn sich eine indizierte Spalte ändert) und VACUUM, und sie brauchen Speicher und Platte. Ein Index, den du nicht nutzt, ist reine Kostenstelle.
Zufällige UUID-Schlüssel: versteckte Indexkosten
Ein Primärschlüssel ist ebenfalls ein Index, und sein Typ bestimmt, wie der B-tree wächst. Eine zufällige UUIDv4 landet irgendwo im Baum, Inserts berühren also Seiten im ganzen Baum und spalten sie. Eine UUIDv7 beginnt mit einem Zeitstempel, neue Schlüssel kommen also der Reihe nach am rechten Rand an, wie bei einer Sequenz. PostgreSQL 18 hat dafür ein eingebautes uuidv7(). Ich habe 5 Millionen Zeilen in eine Tabelle mit je einer Art von Primärschlüssel eingefügt:
| Primärschlüssel | 5 Mio. Zeilen einfügen | Größe des Primärschlüssels |
|---|---|---|
UUIDv4 (gen_random_uuid()) |
12,9 s | 191 MiB |
UUIDv7 (uuidv7()) |
9,6 s | 150 MiB |
Der zeitlich geordnete Schlüssel fügte 1,3-mal schneller ein und erzeugte einen etwa ein Fünftel kleineren Index. Diese Tabellen passen in den Speicher, der Abstand dürfte also wachsen, sobald der Index nicht mehr hineinpasst, weil zufällige Schlüssel dann bei jedem Insert den Cache verfehlen. UUIDv7 verrät außerdem die Erstellungszeit in der ID, was zählt, wenn die ID öffentlich ist. Eine bigint-Sequenz ist noch kleiner (8 gegen 16 Byte).
So findest du ungenutzte und fehlende Indizes
Rate nicht, frag die Statistik. Indizes, die seit dem letzten Zurücksetzen der Statistik nie gescannt wurden (pg_stat_database.stats_reset zeigt, wie lange die Zähler schon laufen):
SELECT s.relname AS table_name, s.indexrelname AS index_name, pg_size_pretty(pg_relation_size(s.indexrelid)) AS size, s.idx_scanFROM pg_stat_user_indexes sJOIN pg_index i ON i.indexrelid = s.indexrelidWHERE s.idx_scan = 0 AND NOT i.indisunique AND NOT i.indisprimaryORDER BY pg_relation_size(s.indexrelid) DESC;Lass eindeutige und Primärschlüssel-Indizes aus, sie erzwingen Constraints. Beobachte über einen vollen Geschäftszyklus (Monatsabschluss-Jobs), und denk daran, dass jedes Replikat eigene Zähler führt. Für fehlende Indizes schau auf Tabellen, bei denen Sequential Scans viele Zeilen lesen:
SELECT relname, seq_scan, seq_tup_read, idx_scan, n_live_tupFROM pg_stat_user_tablesWHERE seq_scan > 0ORDER BY seq_tup_read DESC LIMIT 10;Finde dann die Abfragen dahinter mit pg_stat_statements und prüfe den Plan mit EXPLAIN (ANALYZE, BUFFERS). Auf einem Live-System baust du immer mit CREATE INDEX CONCURRENTLY, das Schreibzugriffe nicht blockiert (es kann nicht in einer Transaktion laufen, und ein fehlgeschlagener Build hinterlässt einen INVALID-Index, den du löschen musst), und entfernst Indizes mit DROP INDEX CONCURRENTLY. Ein Index, der nach vielen Updates und Deletes aufgebläht ist, lässt sich ohne Blockieren von Schreibzugriffen mit REINDEX INDEX CONCURRENTLY neu bauen.
Was sich bei Indizes in PostgreSQL 18 und 19 ändert
PostgreSQL 18, das aktuelle Major-Release, brachte vier indexbezogene Änderungen, die in diesem Artikel vorkommen: Skip Scan für mehrspaltige B-tree-Indizes, parallele GIN-Builds, Index Searches und automatisches BUFFERS bei EXPLAIN ANALYZE sowie das eingebaute uuidv7() für indexfreundliche Schlüssel. Es hat außerdem das neue asynchrone I/O-Subsystem eingeführt, das die Sequential und Bitmap Scans beschleunigt, gegen die diese Indizes antreten. PostgreSQL 19 ist im Release-Candidate-Stadium, und PostgreSQL 14 erreicht am 12. November 2026 das Support-Ende, jetzt ist also ein guter Zeitpunkt zu prüfen, welche Version deine eigene Datenbank nutzt. Die offiziellen Release Notes haben die vollständige Liste, und wenn du dich noch für eine Datenbank entscheidest, vergleicht Postgres vs. MySQL 2026 die beiden.
Eine praktische Checkliste
- Schreibe zuerst die Abfrage und sieh dir ihren Plan mit
EXPLAIN (ANALYZE, BUFFERS)an. - Fang mit einem B-tree auf den Spalten in
WHEREundJOINan, Gleichheitsspalten zuerst. - Wenn nur ein kleiner Ausschnitt der Zeilen zählt, mach ihn partiell.
- Wenn die Tabelle riesig, append-only und zeitlich geordnet ist, probiere BRIN vor B-tree.
- Für Arrays,
jsonbund Textsuche nimm GIN und prüfe, ob die Treffer selektiv sind. - Füge
INCLUDEnur für heiße Abfragen hinzu, die viele Zeilen liefern, und lassVACUUMlaufen. - Baue mit
CREATE INDEX CONCURRENTLYund prüfepg_stat_user_indexesjedes Quartal. - Lege für die referenzierende Spalte jedes Fremdschlüssels, nach der du joinst oder löschst, einen Index an: PostgreSQL erzeugt ihn nicht von selbst.
- Nimm für UUID-Primärschlüssel unter PostgreSQL 18 lieber UUIDv7 als zufällige UUIDv4.
Für Gewohnheiten auf Abfrageebene, die dazu passen, siehe SQL Query Optimization 2026, und für Vektoren in Postgres Brauchst du eine Vektordatenbank?.
Das Fazit
Nimm standardmäßig B-tree und miss, bevor du zu etwas anderem greifst. Mach ihn partiell, wenn nur ein Ausschnitt der Zeilen zählt, nutze BRIN bei riesigen, zeitlich geordneten Tabellen und GIN, wenn du in Arrays und Dokumenten suchst und die Treffer selten sind. Sei vorsichtig mit dem Rest: Ein Hash-Index war nicht schneller, ein abdeckender Index war 4,4-mal größer für einen 1,4-fachen Gewinn, und jeder zusätzliche Index verlangsamte Inserts. Der beste Index ist der kleinste, der deine Abfrage beantwortet, und der zweitbeste ist der, den du gelöscht hast.
Indizes sind keine Geschwindigkeit zum Nulltarif. Jeder ist ein Tausch zwischen Lesezeit, Platte, Speicher und Schreibzeit, wähle den Typ also nach der Form der Abfrage und behalte nur die, die laut Statistik genutzt werden.
Postgres, PostgreSQL und das Slonik-Logo sind Marken oder eingetragene Marken der PostgreSQL Community Association of Canada.
Aus der Community
Diskussion auf Mastodon & Bluesky
Antworten auf diesen Artikel aus dem offenen Netz, live geladen. Keine Werbung, keine Tracking-Skripte.
Antworte dort — es erscheint hier automatisch.