
Alle paar Monate verfestigt sich bei lokaler KI-Hardware dasselbe Klischee — und dann sprengt ein neuer Speicherbus die Rechnung. Ende 2026 dreht sich das Duell um 128 GB+ Unified Memory auf dem Schreibtisch um drei Systeme: AMD Strix Halo (Ryzen AI Max+ 395), NVIDIA DGX Spark (GB10) und Apples im August 2026 aktualisierten Mac Studio (M5 Max / M5 Ultra).
Viele Vergleiche im Netz zitieren noch veraltete M4-Max-/M3-Ultra-Tabellen oder bleiben bei Marketing-Floskeln („Apple hat Bandbreite, NVIDIA hat CUDA, AMD ist günstiger“). Entscheidend sind aber die harten Engineering-Details: wie sich MoE- vs. Dense-Modelle auf einem 256-Bit-Bus verhalten, warum Strix Halo unter ROCm bei 64k–128k Kontext einbrechen kann, und was 24/7-Stromkosten in Europa über drei Jahre ausmachen.
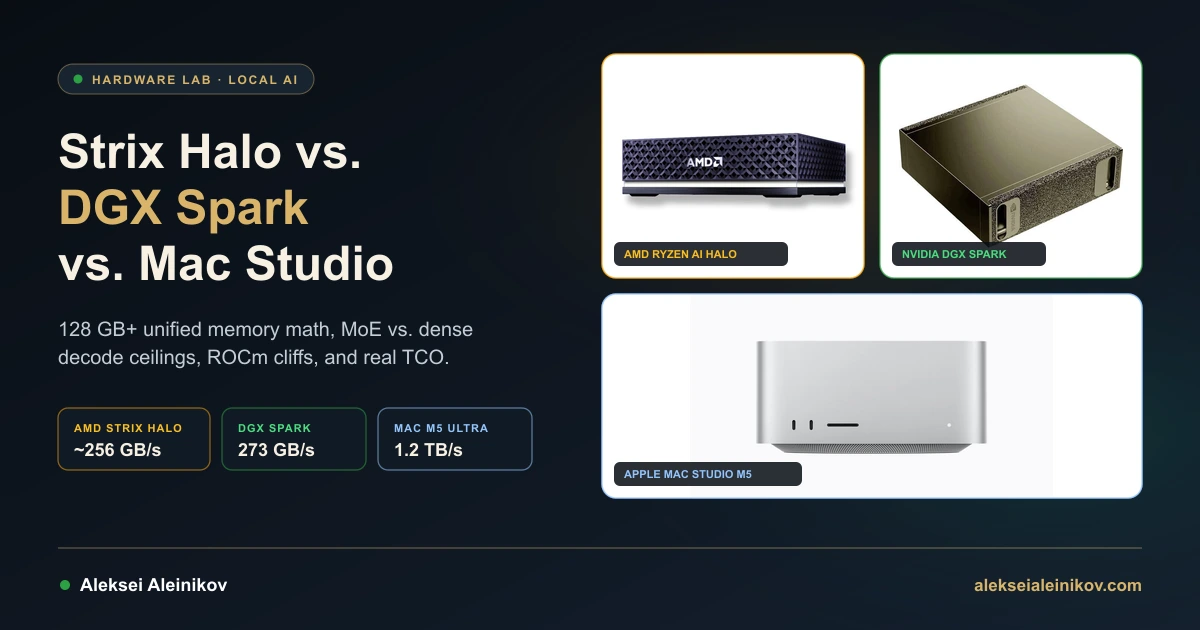
Die drei Kontrahenten im November 2026
Anders als bei diskreten GPUs — wo etwa eine RTX 5090 mit ~1.792 GB/s rennt, bis sie hart an der 32-GB-VRAM-Grenze scheitert — teilen sich CPU und GPU bei allen drei Desktop-Systemen denselben großen Speicherpool. Diese Architektur bestimmt, welche Modelle überhaupt laden, wie schnell sie antworten und welcher Software-Stack trägt.
| Spezifikation | AMD Strix Halo (Ryzen AI Max+ 395) |
NVIDIA DGX Spark (GB10) |
Apple Mac Studio (M5 Max / M5 Ultra) |
|---|---|---|---|
| CPU + GPU | 16-Core Zen 5 + Radeon 8060S (40 CUs, RDNA 3.5) | 20-Core Armv9 + Blackwell GPU (1.000 TOPS FP4) | 18-Core + 32/40-Core GPU (Max) · 30–36-Core + 64/80-Core GPU (Ultra) |
| Unified Memory | 128 GB LPDDR5x-8000 (bis 96 GB BIOS-VGM) | 128 GB kohärenter LPDDR5x | 36–128 GB (Max) · 96–512 GB (Ultra) |
| Speicherbandbreite | ~215–256 GB/s (256-Bit-Bus) | 273 GB/s (256-Bit-Bus) | 460 / 614 GB/s (Max) · 1,2 TB/s (Ultra) |
| Netzwerk / I/O | 2,5GbE (Framework/EVO-X2) bzw. Dual-10GbE + PCIe x16 (MS-S1 Max) | 200 Gb/s ConnectX-7 RDMA (2-Knoten-Cluster) | Thunderbolt 5, 10GbE, Wi-Fi 7 |
| Software-Stack | x86_64 Linux / Windows · ROCm, Vulkan, llama.cpp |
DGX OS (Arm Linux) · natives CUDA, vLLM, TensorRT-LLM | macOS · MLX, Metal, llama.cpp |
| Idle-Verbrauch | ~30 W | ~45 W | ~9 W |
| Einstiegspreis 2026 (128 GB) | ~1.999–2.499 $ (Framework / MS-S1 Max) |
4.699 $ UVP (Handel bis 6.950 $) | ~3.899–4.099 $ (M5 Max) · 5.499 $+ (M5 Ultra ab 96 GB) |
Die konkreten Geräte im Detail
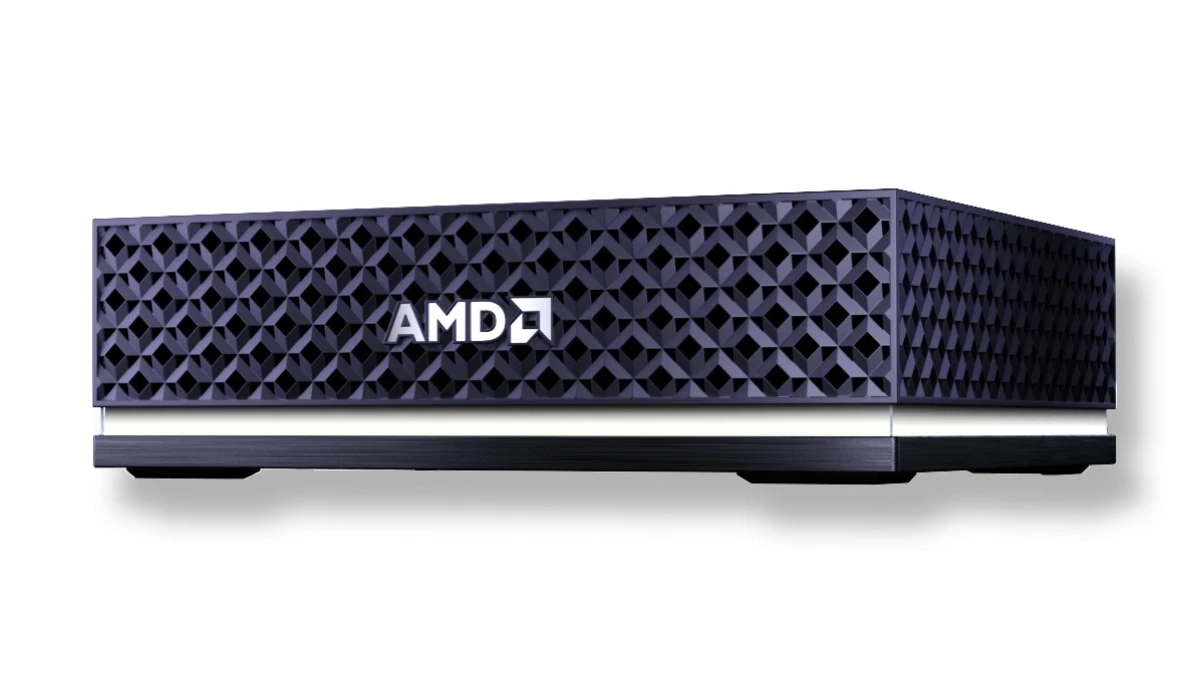
Strix Halo ist kein einzelnes Gerät, sondern steckt in drei unterschiedlichen Formfaktoren:
- Framework Desktop (~1.999 $ Basis für 128 GB): Modulares 4,5-Liter-Mini-ITX-Gehäuse mit zwei M.2-NVMe-Slots und sauberer Linux-Unterstützung.
- GMKtec EVO-X2 (~2.199–3.499 $): Kompakter Mini-PC mit vorinstalliertem Windows 11 Pro.
- Minisforum MS-S1 Max (~2.499 $): Etwas größere Mini-Workstation mit Dual-10GbE-Ports und physischem PCIe-x16-Slot — besonders spannend für Homelab-Cluster und schnelle NAS-Anbindung.
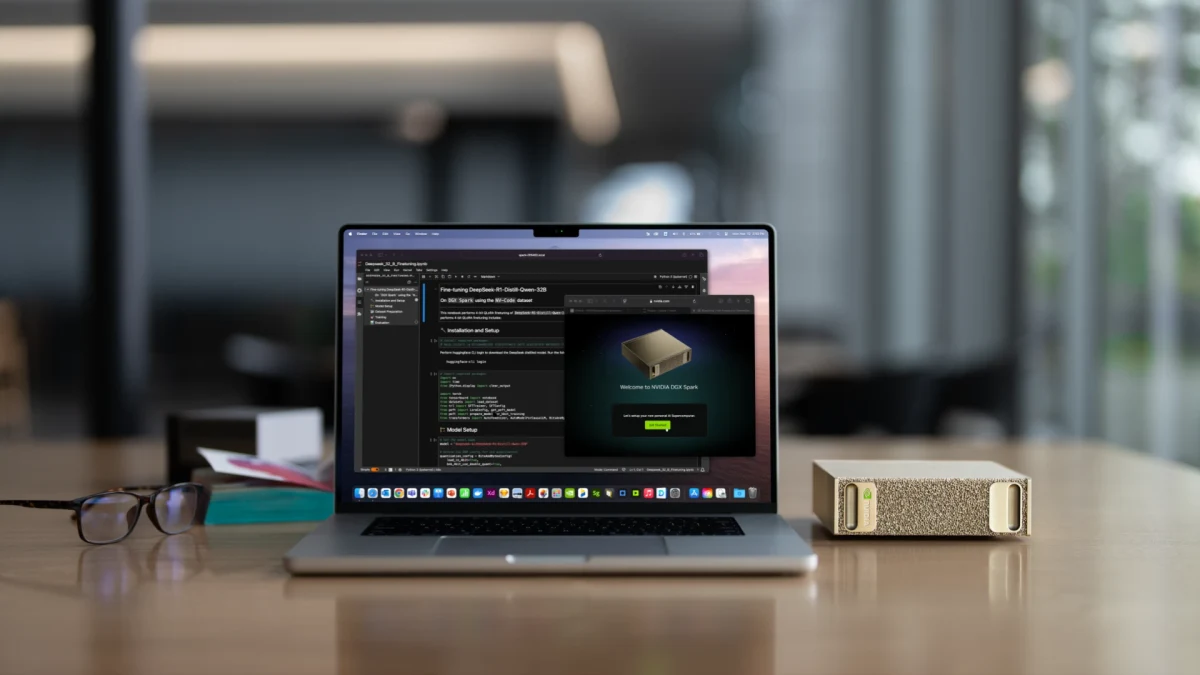
Auf NVIDIA-Seite bleibt der DGX Spark das kompakteste schlüsselfertige CUDA-System der 128-GB-Klasse. Wie in unserer technischen Analyse zum NVIDIA DGX Spark gezeigt, hat NVIDIA den 273-GB/s-Bus bewusst begrenzt, um 1 PFLOP Sparse-FP4-Leistung und 200-Gb/s-ConnectX-7-RDMA in einem 150 × 150 mm-Würfel (~140 W SoC-TDP) unterzubringen.
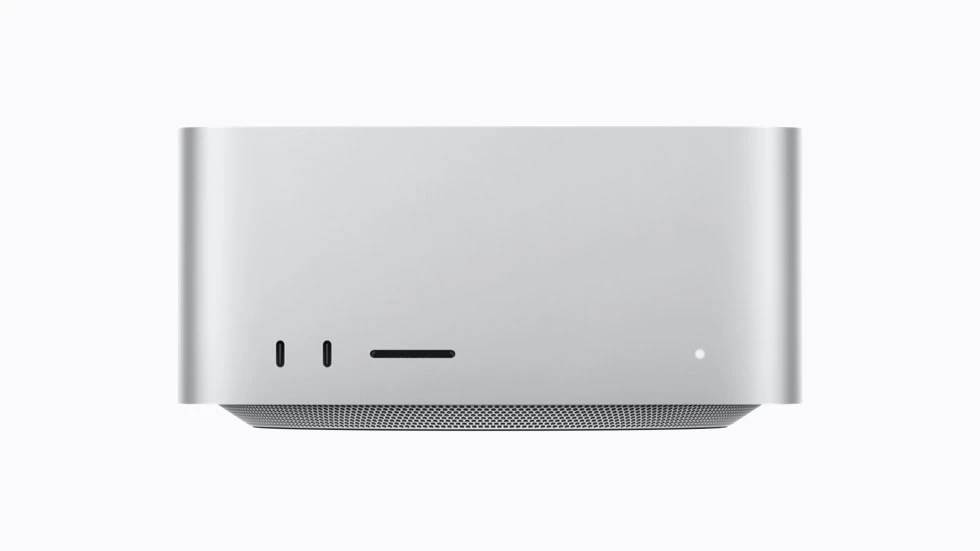
Apples Mac-Studio-Update vom August 2026 hat einen M4 Ultra komplett übersprungen und direkt auf M5 Max (460 GB/s bzw. 614 GB/s mit 40-Core-GPU) und M5 Ultra (1,2 TB/s, bis 512 GB Unified Memory) umgestellt. Neu sind Neural Accelerators direkt in den GPU-Kernen, was den früheren Nachteil beim Prompt-Prefill deutlich reduziert.
Decode-Geschwindigkeit: Warum 70B Dense bremst und MoE fliegt
Die Token-Generierung für einen einzelnen Nutzer (Decode) ist durch die Speicherbandbreite limitiert: Für jedes neue Token muss die GPU alle aktiven Modellgewichte aus dem RAM lesen. Wie Quantisierung den Speicherbedarf reduziert, erklärt unser Leitfaden zur Quantisierung auf Consumer-Hardware.
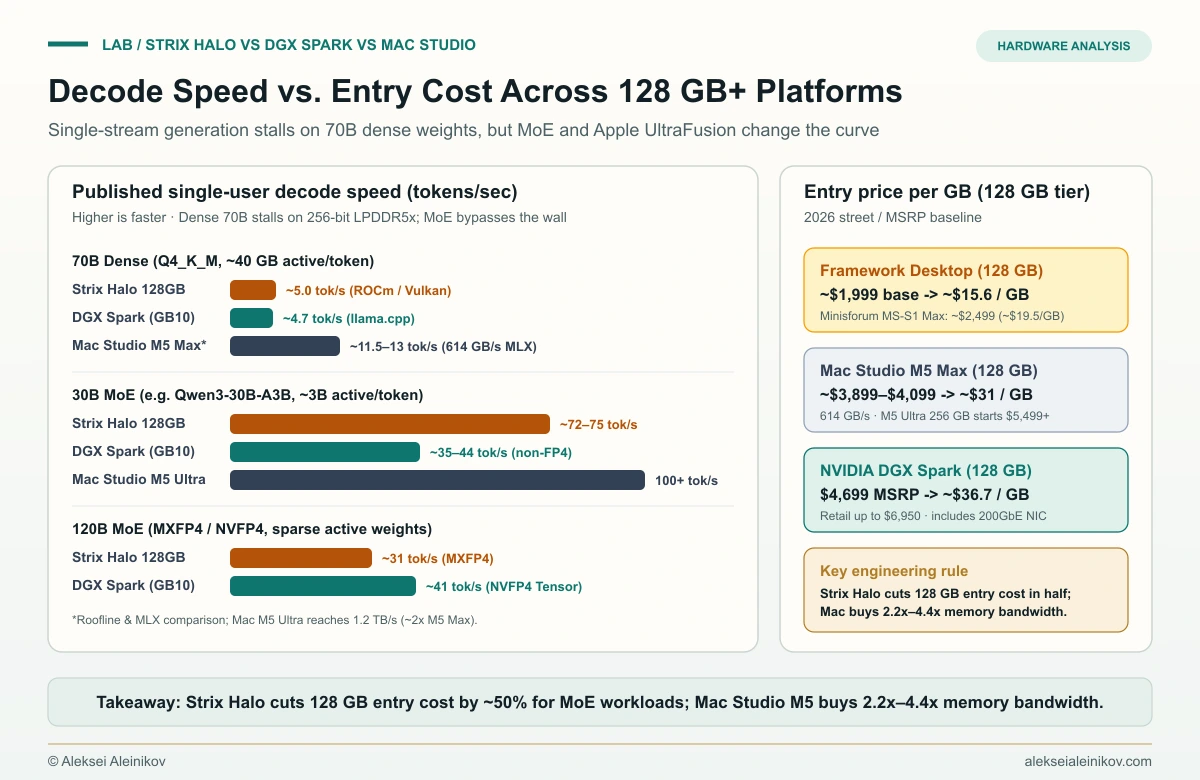
Roofline-Decode-Limit ≈ Speicherbandbreite (GB/s) ÷ Aktive_Modellgröße (GB)Rechnet man das für ein klassisches 70B-Dense-Modell in Q4_K_M (~40,5 GB aktiv pro Token) durch:
- Strix Halo (~256 GB/s): theoretisches Maximum ~6,3 tok/s → ~5,0 tok/s in veröffentlichten
llama.cpp-Messungen. - DGX Spark (273 GB/s): theoretisches Maximum ~6,8 tok/s → ~4,7 tok/s in
llama.cpp(~2,7–3,0 tok/s in FP8 vLLM). - Mac Studio M5 Max (614 GB/s) / M5 Ultra (1,2 TB/s): 2,2- bis 4,4-mal breiterer Bus → ~11,5–13+ tok/s auf dem M5 Max und 20+ tok/s auf dem M5 Ultra.
Wechselt man dagegen auf Mixture-of-Experts-(MoE)-Modelle wie Qwen3-30B-A3B (~3B aktive Parameter pro Token) oder 120B-MXFP4/NVFP4-MoE, bleiben zwar alle Experten im 128-GB-RAM, aber pro Token fließt nur ein Bruchteil über den Bus:
- 30B MoE: Strix Halo erreicht ~72–75 tok/s; DGX Spark liegt ohne FP4-Pfad bei ~35–44 tok/s; der Mac Studio M5 Ultra überschreitet 100+ tok/s.
- 120B MoE (MXFP4 / NVFP4): Strix Halo liefert ~31 tok/s; der DGX Spark zieht dank nativer Blackwell-NVFP4-Tensor-Cores auf ~41 tok/s davon.
Architektur-Fallen: BIOS-VGM, der ROCm-Kontext-Einbruch und CUDA
Datenblätter verschweigen die Praxisprobleme bei 32k bis 128k Kontext. Genau dort entscheidet der Treiber-Stack über flüssiges Arbeiten oder Frust.
1. Der 64k–128k-ROCm-Einbruch bei Strix Halo
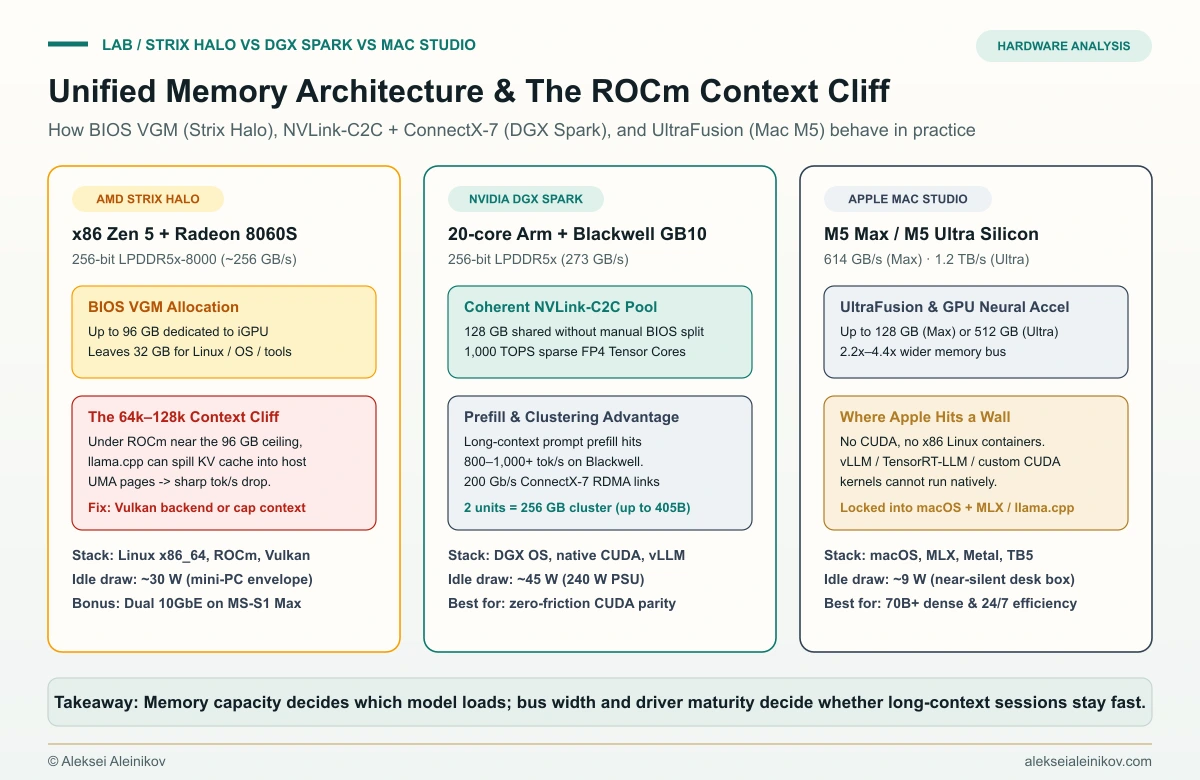
Strix Halo weist den 128-GB-Pool über Variable Graphics Memory (VGM) im BIOS zu — bis zu 96 GB exklusiv für die Radeon 8060S iGPU, während 32 GB beim System bleiben.
Nutzer in r/LocalLLaMA haben dabei einen kritischen Engpass dokumentiert: Wenn VGM auf 96 GB ausgereizt wird und die Kontextlänge unter ROCm in llama.cpp auf 64k–128k Tokens steigt, kann der KV-Cache in Host-UMA-Speicherseiten überlaufen — mit einem abrupten Einbruch der Token-Rate. Community-Benchmarks mit llama.cpp auf Strix Halo (gfx1151) zeigen zudem eine klare Arbeitsteilung zwischen Vulkan (RADV) und getuntem ROCm:
llama.cpp-Backend (Strix Halo gfx1151) |
Prompt-Prefill (TTFT) | Token-Decode (tg/s) |
Stabilität & Setup |
|---|---|---|---|
ROCm / HIP (ROCBLAS_USE_HIPBLASLT=1 + rocWMMA) |
+28 % bis +42 %+ schneller | Konkurrenzfähig | Empfindlich bei ROCm-/LLD-Versionen & 96-GB-UMA-Spill |
Vulkan (RADV) |
Solide Basis | +10 % bis +19 % schneller | Plug-and-play mit Mesa; umgeht den ROCm-UMA-Einbruch |
Daraus ergeben sich zwei klare Praxisregeln:
- Vulkan (
RADV) für interaktiven Chat, Coding-Bursts und stabile Long-Context-Sessions ohne ROCm-Feintuning; - Getuntes ROCm, wenn großes Prompt-Einlesen (lange RAG-Dokumente oder ganze Codebases) Ihre Latenz dominiert.
2. Wann sich der doppelte Preis des DGX Spark rechnet
Bei 4.699 $ UVP (~36,7 $/GB gegenüber ~15,6 $/GB beim 128-GB-Framework-Desktop) lohnt sich der DGX Spark nicht für reines Experimentieren. Seine Stärke liegt in reibungsloser Engineering-Parität:
- Natives CUDA + vLLM + TensorRT-LLM: Derselbe Inference-Stack wie auf Cloud-L4/H100/B200-GPUs läuft ohne ROCm-Workarounds.
- Compute-gebundener Prefill: Das Einlesen eines großen Code-Repositorys (64k+ Tokens) ist rechen- und nicht speicherlimitiert — hier drücken Blackwells 1-PFLOP-FP4-Cores den Prefill auf 800–1.000+ tok/s.
- 200-Gb/s-ConnectX-7-RDMA: Zwei DGX Spark per QSFP-Kabel direkt gekoppelt ergeben einen 256-GB-Cluster für quantisierte 405B-Modelle.
3. Apple Mac Studio M5: Leise Rohgewalt ohne CUDA
Wer mit MLX, llama.cpp oder LM Studio arbeitet, bekommt mit dem M5 Max (614 GB/s) und M5 Ultra (1,2 TB/s, bis 512 GB) die mit Abstand höchste Geschwindigkeit bei großen Dense-Modellen. Der Preis dafür ist strukturell: kein CUDA, keine nativen x86-Linux-Container und hohe Aufpreise für 256-GB-/512-GB-Ausbaustufen.
TCO in Europa: Leerlauf-Watt zählen bei 0,32 €/kWh
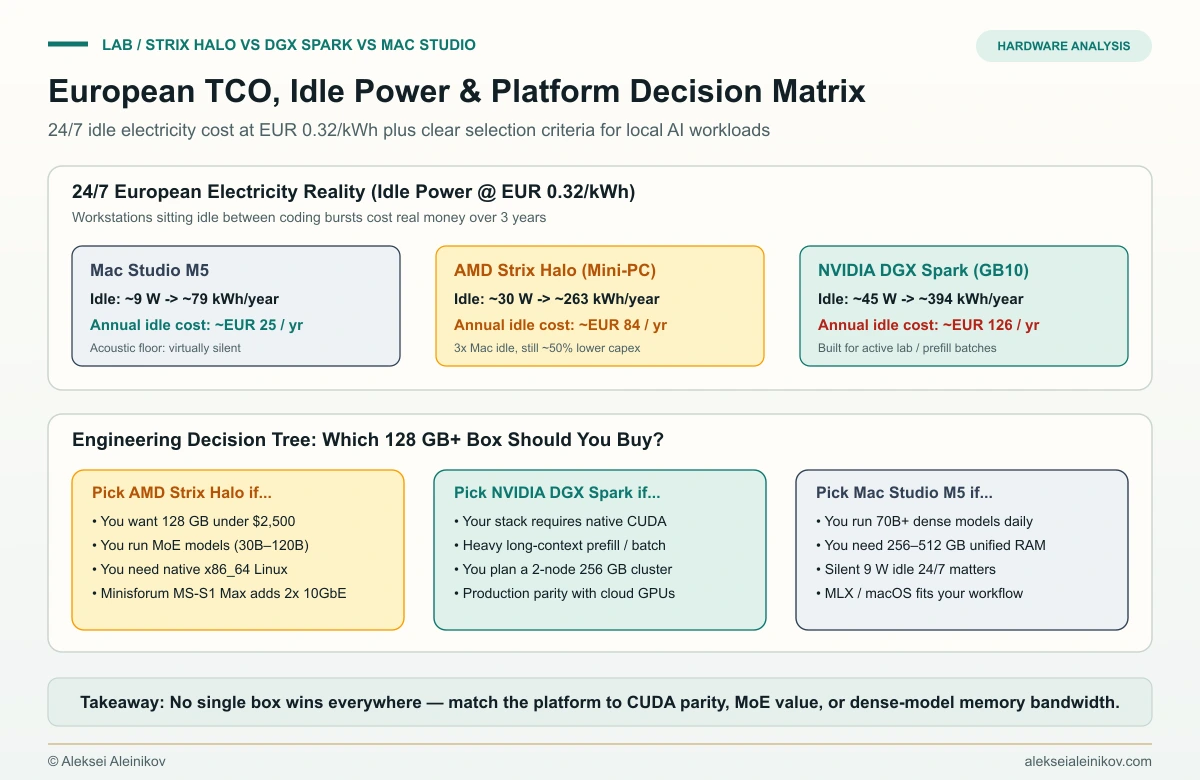
Testberichte messen meist nur Spitzenlast, dabei verbringt eine Entwickler-Workstation 80–90 % einer 24/7-Woche im Leerlauf. Bei typischen europäischen Strompreisen von 0,32 €/kWh summiert sich der Unterschied:
- Mac Studio M5 (~9 W Idle): ~79 kWh/Jahr → ~25 €/Jahr (praktisch unhörbar).
- AMD Strix Halo Mini-PC (~30 W Idle): ~263 kWh/Jahr → ~84 €/Jahr (~3,3× Mac-Idle, aber ~50 % geringere Anschaffungskosten als DGX Spark).
- NVIDIA DGX Spark (~45 W Idle): ~394 kWh/Jahr → ~126 €/Jahr.
Entscheidungsmatrix: Welches 128-GB+-System passt zu wem?
- AMD Strix Halo (
Framework DesktopoderMinisforum MS-S1 Max) wählen, wenn Sie 128 GB unter 2.500 $ wollen, vor allem MoE-Modelle (30B–120B) nutzen und natives x86_64-Linux brauchen (inklusive Dual-10GbE und PCIe-Slot beim MS-S1 Max für Homelab/NAS) — und bereit sind, bei 64k+ Kontext auf Vulkan statt ROCm zu setzen. - NVIDIA DGX Spark wählen, wenn Ihr Stack zwingend natives CUDA / vLLM / TensorRT-LLM verlangt, Sie schnellen Long-Context-Prefill für Coding-Agents brauchen oder ein 256-GB-RDMA-Cluster über ConnectX-7 planen.
- Apple Mac Studio (
M5 Max/M5 Ultra) wählen, wenn Sie täglich 70B+-Dense-Modelle fahren, 256–512 GB in einem leisen Gehäuse benötigen, ~9 W Leerlauf schätzen und im macOS-/MLX-Ökosystem zu Hause sind.
Persönliche Einschätzung: Warum ich zuerst AMD Strix Halo testen würde
Wenn ich mir heute mit eigenem Budget eine 128-GB-Workstation für mein Homelab aussuchen müsste, würde ich zuerst zu AMD Strix Halo greifen — konkret als Framework Desktop oder Minisforum MS-S1 Max. Für rund 1.999–2.499 $ bekommt man 128 GB Unified Memory in einer normalen x86_64-Linux-Umgebung zum halben Preis eines DGX Spark (4.699 $), ohne sich an macOS zu binden. Natürlich kriechen dichte 70B-Modelle bei ~5 tok/s und man muss bei langen Kontexten zwischen Vulkan und ROCm abwägen — aber für 30B–120B-MoE-Coding-Modelle, lokale Agenten und Docker-Dienste parallel bietet Strix Halo das stärkste Verhältnis aus Freiheit und Preis pro Gigabyte.
Fazit
- Speicherkapazität bestimmt, was lädt; Speicherbandbreite bestimmt das Tempo dichter Modelle; MoE-Architekturen holen aus 256–273 GB/s ein Vielfaches heraus.
- Strix Halo ist der Preis-Leistungs-Disruptor Ende 2026 (~15,6–19,5 $/GB) und halbiert den Einstieg in die 128-GB-Klasse.
- DGX Spark gewinnt bei CUDA-Parität, FP4-Prefill und ConnectX-7-Clustering, nicht beim reinen Single-User-Decode.
- Mac Studio M5 gewinnt bei Bandbreite (614 GB/s–1,2 TB/s), 512-GB-Ausbau und 9-W-Effizienz, bleibt aber an macOS gebunden.
Aus der Community
Diskussion auf Mastodon & Bluesky
Antworten auf diesen Artikel aus dem offenen Netz, live geladen. Keine Werbung, keine Tracking-Skripte.
Antworte dort — es erscheint hier automatisch.