Kubernetes wurde mit Version 1.37 nicht plötzlich zu einer anderen Plattform. Die Veränderung kam schrittweise: ein Default, eine Graduation und eine Deprecation nach der anderen über 1.35, 1.36 und 1.37. Liest man jedes Release einzeln, sieht man 197 Enhancements. Betreibt man Cluster durch alle drei Versionen, wird eine zusammenhängende Entwicklung sichtbar.
Kubernetes ersetzt alte Node-Annahmen durch cgroup v2, containerd 2.x und nftables. Mehr Security wandert in den Core: User Namespaces, feingranulare Kubelet-Autorisierung, CEL Admission Policy und native Pod-Zertifikate. Gleichzeitig entsteht mit Dynamic Resource Allocation und Workload-Aware Scheduling ein echtes Ressourcenmodell für GPUs, Batch Jobs und AI-Workloads.
Dies ist kein Katalog aller KEPs. Es ist die Produktionskarte: Was nutzbar wurde, was brechen kann, was vor einem Upgrade geprüft werden muss und was Kubernetes 1.38 als Nächstes bringen könnte.
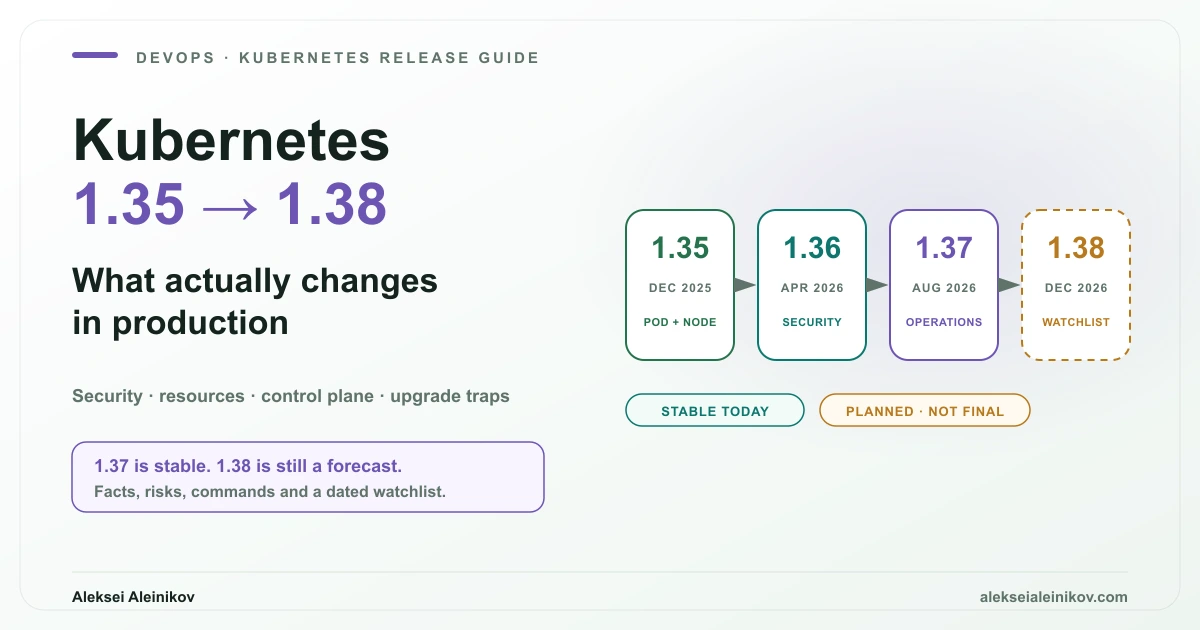
Die Versionsübersicht in 30 Sekunden
Am 22. September 2026 sind diese Upstream-Versionen relevant:
| Version | Veröffentlicht / geplant | Upstream-Status | Produktionsaussage |
|---|---|---|---|
| 1.35 Timbernetes | 17. Dez. 2025 | Aktiv; EOL 28. Feb. 2027 | In-place Pod Resize wird Stable; die Modernisierung der Nodes bekommt eine echte Frist |
| 1.36 Haru | 22. Apr. 2026 | Aktiv; EOL 28. Juni 2027 | User Namespaces, native Mutation, OCI Image Volumes und stärkere Kubelet-Auth werden Stable |
| 1.37 Garhwal | 26. Aug. 2026 | Aktuelles Stable; EOL 28. Okt. 2027 | HPA Scale-to-Zero, Memory QoS und Gang Scheduling reifen; Workload Identity und Storage Migration stabilisieren sich |
| 1.38 | 16. Dez. 2026 geplant | In Entwicklung | Enhancement-Umfang noch beweglich; Kandidaten sind keine ausgelieferten Features |
Das Upstream-Projekt pflegt die drei neuesten Minor Branches. Das bedeutet nicht, dass Ihr Provider alle drei am selben Tag unterstützt. GKE, EKS und AKS haben eigene Qualifizierungspläne, Feature-Gate-Defaults und Extended-Support-Regeln. Prüfen Sie zuerst den Upstream-Release-Status und danach die Versionsmatrix Ihres Providers.
Was sich über drei Releases verändert hat
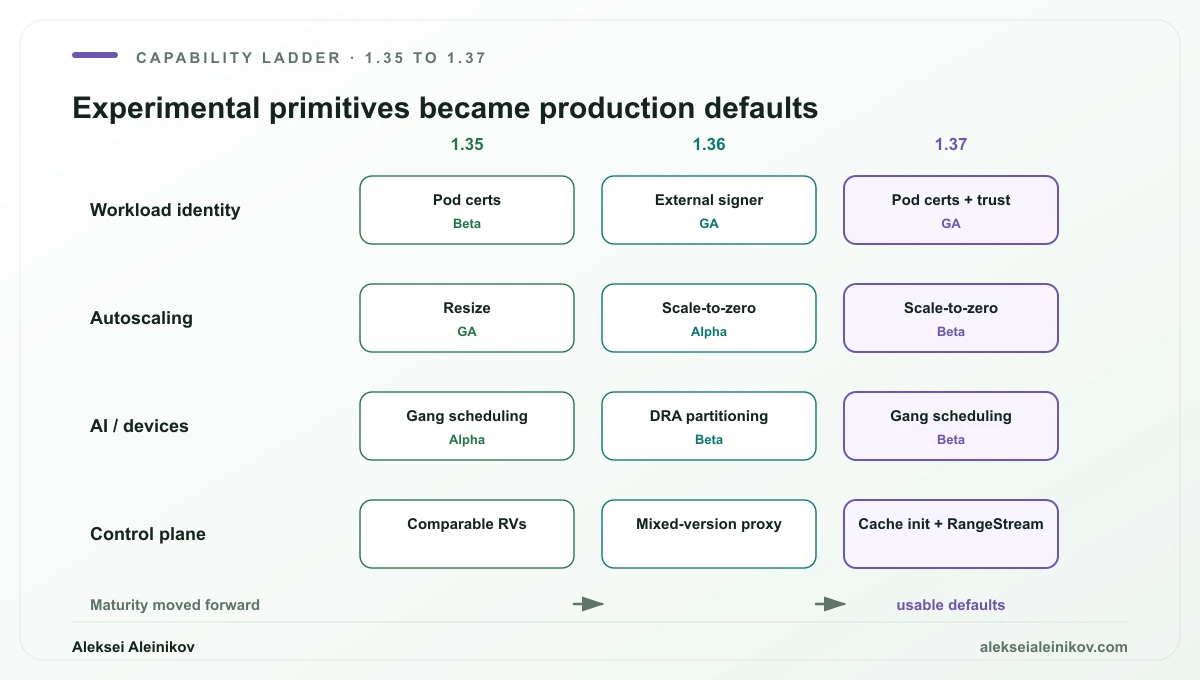
1.35–1.37 lässt sich besser nach Fähigkeiten als nach Kalender lesen.
| Fähigkeit | 1.35 | 1.36 | 1.37 |
|---|---|---|---|
| In-place Pod Resource Resize | Stable | Pod-Level Resources reifen | Scheduler-Preemption für Resize kommt als Alpha |
| HPA | Toleranz pro HPA Beta | Scale-to-Zero Alpha | Scale-to-Zero Beta, standardmäßig aktiv |
| Workload Identity | Pod-Zertifikate Beta | Externer SA-Token-Signer Stable | Pod-Zertifikate + Trust Bundles Stable |
| Container-Isolation | User Namespaces Beta/Default | User Namespaces Stable | Rootless Kubelet Beta |
| Admission Policy | Grundlagen reifen | MutatingAdmissionPolicy Stable | Manifest-basierte Admission Config Beta |
| Spezialgeräte | DRA Core immer aktiv | Partitionierung und Device Controls reifen | Weitere DRA-Teile Stable; Workload-Integration Beta |
| Batch-/AI-Scheduling | Gang Scheduling Alpha | Workload-Aware Scheduling wächst | Gang Scheduling Beta |
| Control-Plane-Skalierung | Vergleichbare Resource Versions | Sharded List/Watch entwickelt sich | Resilient Cache Init Stable; RangeStream Beta |
| Node-Basis | cgroup-v2-Umstieg; letztes containerd 1.x | containerd 2.x erwartet | cgroup-v1-Override nur Übergang; moderne Basis vorausgesetzt |
Kubernetes 1.35: Die Basis für Nodes und Pods verschiebt sich
Kubernetes 1.35 lieferte 60 Enhancements. Vier davon wirken in Produktion überproportional stark.
In-place Pod Resize wird praktisch nutzbar
CPU- und Memory-Requests können jetzt geändert werden, ohne den Pod neu anzulegen. Die /resize-Subresource erreichte Stable und gibt vertikalem Autoscaling endlich ein Kernprimitiv, das jahrelang fehlte.
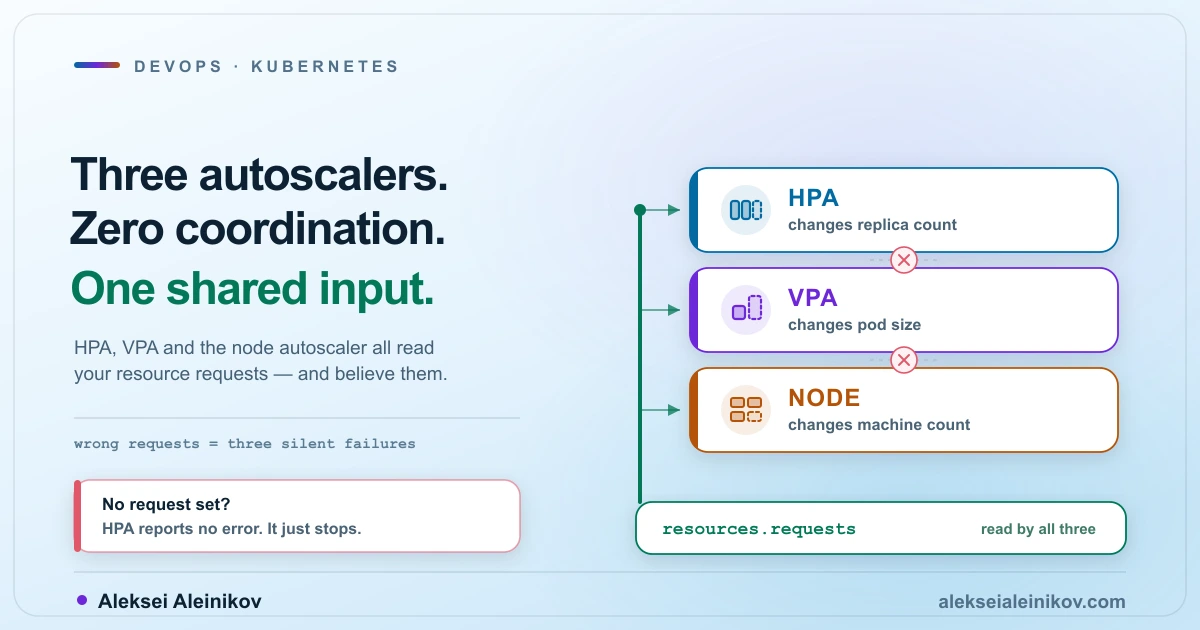
Nicht jedes Resize bleibt unterbrechungsfrei. Ein Container kann festlegen, ob CPU- oder Memory-Änderungen einen Restart erfordern; ein Resize darf die QoS-Klasse des Pods nicht ändern; und auf einem vollen Node bleibt die Anfrage pending. Die Mechanik und die aktuelle VPA-Einschränkung erkläre ich im Deep Dive zu Kubernetes Autoscaling.
Security folgt dem Workload statt dem Secret
Pod-Zertifikate wurden Beta. Statt einen langlebigen privaten Schlüssel aus einem Secret zu mounten, kann der Kubelet kurzlebige X.509-Credentials anfordern und für den Workload rotieren. Das ist der Anfang eines nativen Workload-Identity-Pfads, der in 1.37 Stable wird.
Dasselbe Release nähert die Autorisierung gecachter Images dem Verhalten an, das viele Betreiber längst erwarten. Mit KubeletEnsureSecretPulledImages darf ein Pod ein privates Image nicht einfach deshalb wiederverwenden, weil ein anderer autorisierter Pod es zuvor auf dem Node gecacht hat. In Multi-Tenant-Clustern schließt das eine sehr reale Isolationslücke.
Autoscaling wird workload-spezifisch
Die feste clusterweite HPA-Toleranz von 10% war immer grob. Kubernetes 1.35 führte ein Beta-Feld tolerance pro HPA ein. Ein latenzkritischer Workload kann damit bei 5% reagieren, während ein verrauschter Workload ein breiteres Totband behält.
Feingranulare Container-Restart-Regeln wurden ebenfalls Beta. Ein Batch- oder AI-Pod kann restartPolicy: Never behalten und trotzdem einen einzelnen Container bei ausgewählten Exit Codes neu starten, statt wegen einer behebbaren GPU- oder Netzwerkinitialisierung den ganzen Pod zu ersetzen.
Der alte Node-Stack bekommt ein Ablaufdatum
Version 1.35 war das letzte Kubernetes-Release mit Unterstützung für containerd 1.x. Außerdem wurde failCgroupV1 standardmäßig aktiviert: Ein Kubelet auf cgroup v1 startet nur noch, wenn Sie den Legacy-Pfad ausdrücklich wieder erlauben. Dieser Override ist eine Migrationshilfe, keine Architekturentscheidung.
Im Netzwerk begann IPVS seinen Rückzug zugunsten von nftables. Wenn Ihre Plattform-Templates weiterhin mode: ipvs fest eintragen, ist das keine spätere Aufräumarbeit, sondern Upgrade-Schuld mit klar veröffentlichter Richtung.
Kubernetes 1.36: Security und Policy wandern in den Prozess
Kubernetes 1.36 brachte 70 Enhancements. Sein stärkstes Thema: Infrastruktur entfernen, die nur existierte, weil die Core API den Job noch nicht sicher selbst erledigen konnte.
User Namespaces werden Stable
Ein Prozess kann im Container UID 0 sein und auf dem Host trotzdem einer unprivilegierten UID entsprechen. Das macht Container nicht zu VMs, reduziert aber die Folgen eines Container Escapes deutlich und ist besonders für Multi-Tenant-Worker-Nodes relevant.
Das ist Defense in Depth, keine Erlaubnis für überall privilegierte Container. Pod Security Standards, seccomp, Capabilities und eine gehärtete Runtime-Grenze bleiben wichtig.
Kubelet-Autorisierung braucht nicht mehr pauschal nodes/proxy
Feingranulare Kubelet-API-Autorisierung wurde Stable. Monitoring Agents brauchen nicht länger die breite Berechtigung nodes/proxy, nur um ausgewählte Kubelet-Endpunkte zu lesen. Das schließt ein altes Least-Privilege-Problem: nodes/proxy erreicht wesentlich mehr von der Kubelet API als die meisten Observability Clients benötigen.
MutatingAdmissionPolicy wird Stable
CEL-basierte Mutation läuft jetzt innerhalb des API Servers. Häufige Defaults und Transformationen benötigen keinen separaten Webhook mit Deployment, Service, TLS-Zertifikat und Netzwerk-Hop mehr.
Das ersetzt OPA, Gatekeeper oder Kyverno nicht. Native Policy übernimmt weder Image Verification noch Resource Generation, Background Scanning oder reichhaltiges Reporting. Die praktische Grenze zeigt OPA vs. Kyverno: Kubernetes liefert Policies jetzt selbst.
OCI-Artefakte werden Volumes
Die image Volume Source erreichte Stable. Modelle, Binaries, Konfigurationspakete und statische Assets lassen sich als OCI-Artefakte paketieren, über die Registry Supply Chain laden und read-only mounten, ohne sie in das Application Image einzubauen oder einen eigenen Downloader als Init Container zu schreiben.
Für AI-Plattformen ist das direkt nützlich: Model Weights und Runtime Images können getrennte Release-Zyklen haben und trotzdem Registry-Authentifizierung, Provenance und Retention Controls teilen.
Zwei Upgrade-Fallen kommen an
Das alte gitRepo Volume Plugin ist in 1.36 dauerhaft deaktiviert. Es war seit 1.11 deprecated, doch „deprecated“ und „nicht wieder aktivierbar“ sind operativ verschiedene Zustände. Ersetzen Sie es durch einen Init Container oder ein gepflegtes Sync Tool.
Service.spec.externalIPs ist deprecated; die Entfernung ist für 1.43 geplant. Das Feld verursacht seit Jahren Sicherheitsprobleme, weil es Traffic für Adressen umleiten kann, die Kubernetes nicht besitzt. Nutzen Sie einen LoadBalancer, einen bewusst kontrollierten NodePort oder Gateway API. Den Migrationspfad auf GKE behandelt Gateway API vs. Ingress.
Kubernetes 1.37: Die aktuelle Version ist ein Operations-Release
Kubernetes 1.37 enthält 67 Enhancements: 16 Stable, 23 Beta, 27 Alpha und eine getrackte Deprecation/Removal. Bemerkenswert ist, wie viele Änderungen Kosten, Recovery und Plattformsicherheit statt Anwendungssyntax betreffen.
HPA kann ausgewählte Workloads endlich auf null skalieren
HPA Scale-to-Zero ist Beta und standardmäßig aktiv. Es funktioniert mit Object oder External Metrics, denn CPU- und Memory-Metriken existieren nicht, wenn es keine Pods zu messen gibt.
apiVersion: autoscaling/v2kind: HorizontalPodAutoscalermetadata: name: queue-workerspec: scaleTargetRef: apiVersion: apps/v1 kind: Deployment name: queue-worker minReplicas: 0 maxReplicas: 50 metrics: - type: External external: metric: name: queue_depth target: type: AverageValue averageValue: "5"Das hilft Queue Consumern, Batch Workern und teurer GPU-Inferenz, sofern Cold Starts akzeptabel sind. Es ist kein kostenloser Serverless-Schalter. Der External Metrics Adapter muss auch bei null verfügbar bleiben, und Ihr SLO muss die Aktivierungszeit einbeziehen.
Native Workload Identity wird Stable
Pod-Zertifikate und ClusterTrustBundles sind Stable. Ein Workload kann automatisch erneuerte Private Keys und Zertifikate über ein Projected Volume mounten, während Trust Anchors über eine eigene Trust-Bundle-Projektion kommen.
Sie benötigen weiterhin einen Signer Controller: Kubernetes definiert Request, Auslieferung und Rotation, nicht die Policy Ihrer Enterprise CA. Der Vertrag zum Workload ist nun aber eine stabile Core API statt einer Sammlung von Secret-Konventionen.
Metrics und Resource Management reifen
Die metrics.k8s.io API erreicht nach fast neun Jahren Beta den Stable-Status. v1beta1 verschwindet nicht sofort, aber Clients sollten auf v1 umsteigen.
Memory QoS wird Beta und ist auf cgroup-v2-Nodes standardmäßig aktiv. Kubernetes kann memory.min, memory.low und memory.high nutzen, um angeforderten Speicher zu schützen und Druck vor einem harten OOM zu drosseln. Die Defaults sind konservativ: „aktiv“ bedeutet nicht, dass Workloads plötzlich unerwartet gedrosselt werden, sondern dass eine unterstützte Steuerfläche existiert.
Für AI und HPC wird Gang Scheduling Beta. Kubernetes kann eine Pod-Gruppe als Alles-oder-nichts-Workload behandeln, statt nur die Hälfte eines Distributed Training Jobs zu schedulen und dessen GPUs zu verschwenden, während die restlichen Worker Pending bleiben.
DRA wird Plattformarchitektur statt Device-Plugin-Experiment
Dynamic Resource Allocation übernimmt immer mehr Aufgaben, die Device Plugins nicht sauber ausdrücken konnten. In 1.37 werden unter anderem Device Taints und Tolerations, über DRA Driver erfüllte Extended-Resource-Requests, standardisierte NUMA-Attribute und ein aussagekräftigerer ResourceClaim-Status Stable.
Die praktische Aussage lautet nicht „morgen alle Device Plugins ersetzen“. GPU-, Accelerator- und Netzwerkgeräte-Allokation hat jetzt APIs für Health, Topologie, Partitionierung und Policy, die weiterentwickelt werden können, ohne alles in einer einzigen Integer-Ressource zu kodieren.
Die Control Plane wird unter Last robuster
Resiliente Watch-Cache-Initialisierung ist Stable. Bei Start oder Recovery verwandelt kube-apiserver das Aufwärmen des Caches nicht mehr in einen unkontrollierten Request-Burst gegen etcd. Einige Anfragen werden begrenzt, andere erhalten HTTP 429. Eigene Controller und Operatoren müssen deshalb Retry-After respektieren und Backoff implementieren.
Der neue Beta-Pfad EtcdRangeStream streamt große Range-Ergebnisse in Chunks, statt eine riesige Antwort im Speicher aufzubauen. Er benötigt etcd 3.7 oder neuer und fällt bei älteren Versionen automatisch zurück. Concurrent Watch Object Decoding ist ebenfalls standardmäßig aktiv und kann die Cache-Initialisierung deutlich verkürzen, erhöht aber möglicherweise die parallele Last auf CRD Conversion Webhooks.
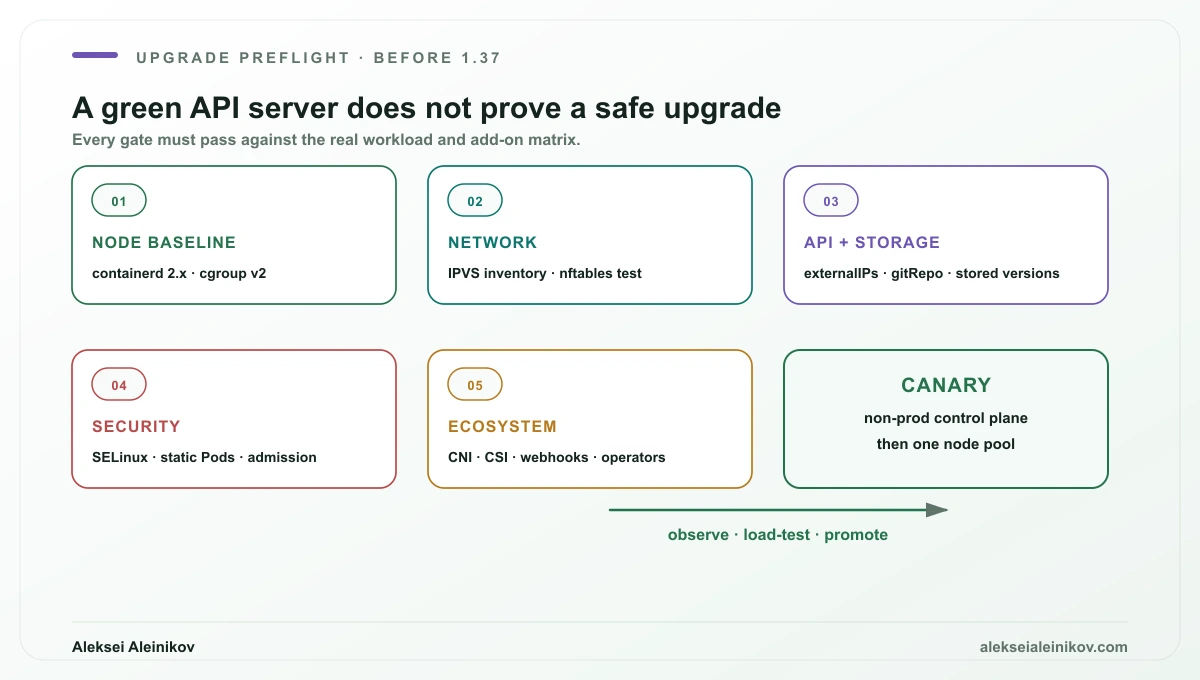
Deshalb reicht ein „grüner API Server“ nicht als Upgrade-Test. Belasten Sie die Webhooks dahinter.
Storage-Migrationen werden deklarativ
StorageVersionMigration ist Stable und standardmäßig aktiv. Betreiber und CRD-Autoren können bestehende Objekte in die aktuelle Storage-Version umschreiben lassen, ohne eine fragile Schleife aus kubectl get | kubectl replace oder einen externen Migrator zu pflegen.
Auch Key Rotation bekommt so einen saubereren Abschluss: Nach einer Änderung der Encryption-at-Rest-Konfiguration kann eine Migration alte Objekte unter dem neuen Schlüssel neu schreiben, statt auf zufällige spätere Updates zu warten.
Der relevante Breaking-Change-Audit
Die Feature-Liste sagt, was Sie nutzen können. Diese Tabelle sagt, was aufhören kann zu funktionieren.
| Annahme im Cluster | Was sich geändert hat | Aktion vor 1.37 |
|---|---|---|
| containerd 1.x ist noch akzeptabel | 1.35 war das letzte unterstützte Release | Alle Nodes auf containerd 2.x umstellen und CRI-Konfiguration prüfen |
| cgroup v1 kann unbegrenzt bleiben | Kubelet verweigert standardmäßig den Start; v1-Pfad nur Übergang | Node-OS und Runtime auf cgroup v2 umstellen; Override entfernen |
| IPVS ist der langfristige kube-proxy-Backend | IPVS ist deprecated; nftables ist der Nachfolger | Modus, Kernel-Support, Monitoring und NodePort-Annahmen inventarisieren |
Service.spec.externalIPs ist normale Exposition |
Seit 1.36 deprecated; Entfernung für 1.43 geplant | LoadBalancer, bewusst kontrollierten NodePort oder Gateway API nutzen |
gitRepo Volumes funktionieren weiterhin irgendwie |
Seit 1.36 dauerhaft deaktiviert | Durch Init-Container-Cloning oder gepflegten Synchronizer ersetzen |
| Static Pods dürfen Secrets/ConfigMaps lesen | Seit 1.37 ausdrücklich verboten | Daten als Node-Dateien verwalten oder Bootstrap-Pfad neu entwerfen |
| SELinux-Relabelling läuft immer rekursiv | Mount-Time-Labeling für Opt-in-CSI-Treiber Stable | Shared Volumes mit verschiedenen SELinux-Labels finden; Pod-Start testen |
kubectl run -f bleibt |
--filename/-f ist deprecated |
Für Manifeste kubectl apply/create -f verwenden |
| kube-dns wird weiter paketiert | Nach 1.40 keine neuen Pakete erwartet | Zu CoreDNS migrieren; node-local-dns bleibt separat gepflegt |
Cluster vor dem Upgrade prüfen
Beginnen Sie mit Fakten, nicht mit Helm-Chart-Versionen in einer Tabelle.
1. Node- und Runtime-Skew inventarisieren:
kubectl get nodes -o custom-columns=\NAME:.metadata.name,KUBELET:.status.nodeInfo.kubeletVersion,\OS:.status.nodeInfo.osImage,RUNTIME:.status.nodeInfo.containerRuntimeVersion2. kube-proxy-Modus prüfen:
kubectl -n kube-system get configmap kube-proxy \ -o jsonpath='{.data.config\.conf}' | grep 'mode:'3. Services mit externalIPs finden:
kubectl get services -A -o json | jq -r ' .items[] | select((.spec.externalIPs // []) | length > 0) | [.metadata.namespace, .metadata.name, (.spec.externalIPs | join(","))] | @tsv'4. Entfernte gitRepo Volumes in Live Pods finden:
kubectl get pods -A -o json | jq -r ' .items[] | select(any(.spec.volumes[]?; has("gitRepo"))) | [.metadata.namespace, .metadata.name] | @tsv'5. Abhängigkeiten prüfen, die Kubernetes nicht für Sie aktualisieren kann:
- CNI- und CSI-Treiber;
- Ingress-/Gateway-Controller und Service Mesh;
- Admission- und CRD-Conversion-Webhooks;
- Metrics Adapter, Autoscaler und Policy Engines;
- Backup-/Restore-Tools und Operatoren;
- Node Image, Kernel, SELinux Policy und Container Runtime.
Aktualisieren Sie danach ein Minor Release nach dem anderen. Die Kubernetes Version Skew Policy erlaubt dem Kubelet, hinter kube-apiserver zu liegen, aber keine beliebigen Sprünge. Managed Services automatisieren möglicherweise die Control-Plane-Sequenz, beweisen aber nicht, dass Webhooks, CRDs und Workloads sie überleben.
Was Kubernetes 1.38 bringen könnte
Dieser Abschnitt ist bewusst datiert. Am 22. September 2026 hat Kubernetes 1.38 den Enhancement Freeze noch nicht erreicht. Der Zyklus begann am 31. August; Enhancement Freeze ist für den 29. September AoE, Code Freeze für den 16. November AoE und GA für den 16. Dezember 2026 geplant.
Das offizielle v1.38 Release Tracking Board enthält bereits viele Kandidaten; Inhalt und Status ändern sich noch. Ein Tracking Board ist eine Planungsfläche, kein Liefervertrag.
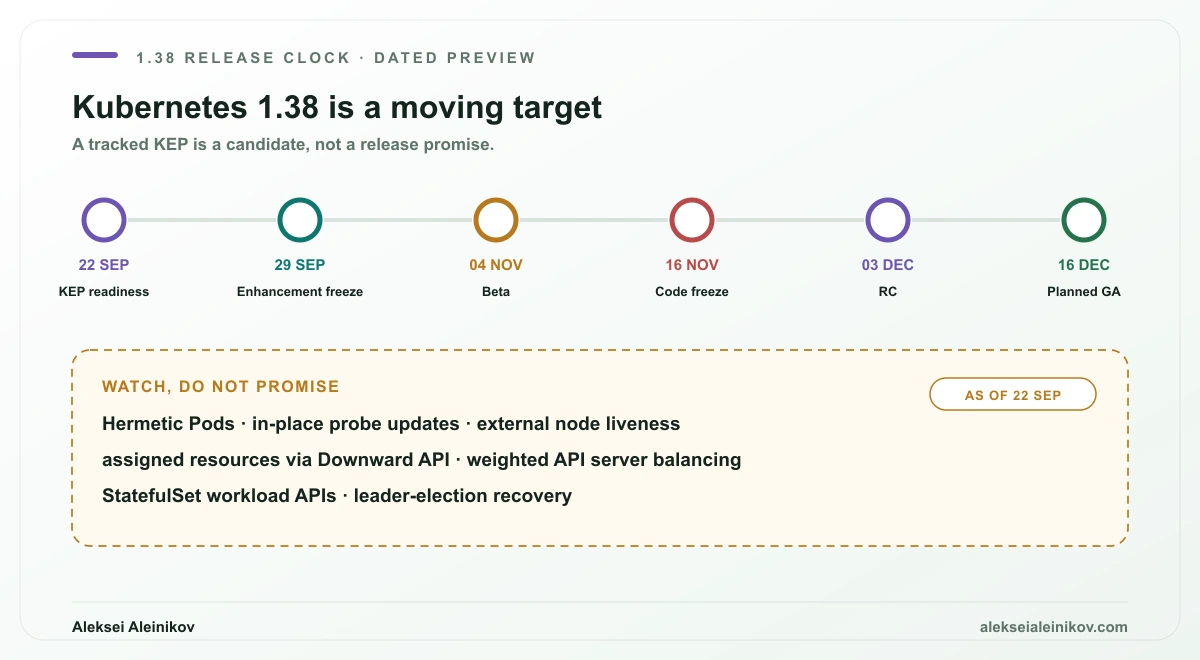
Diese Kandidaten sind besonders interessant, weil sie die Richtung aus 1.35–1.37 fortsetzen:
| Kandidat | Warum relevant | Sicherheit heute |
|---|---|---|
| Hermetische netzwerkisolierte Pods | Workload-Vertrag für Pods, die keine Netzwerkkonnektivität haben dürfen | Getrackter Kandidat; Aufnahme nicht final |
| In-place-Updates von Container Probes | Probes ändern, ohne den Pod neu anzulegen | Getrackter Kandidat; Aufnahme nicht final |
| Externe Node-Liveness-Erkennung | Spezialisierte Infrastruktur kann bessere Node-Health-Signale liefern | Getrackter Kandidat; Aufnahme nicht final |
| Zugewiesene Ressourcen über Downward API | Tatsächliche Geräte-/Ressourcenzuweisung ohne API-Zugriff im Container | Getrackter Kandidat; Aufnahme nicht final |
| Gewichtetes kube-apiserver Load Balancing | Mehr Traffic an gesündere oder leistungsfähigere API-Server-Peers senden | Getrackter Kandidat; Aufnahme nicht final |
| Controller Leader-Election Recovery | Unterbrechung von Control Loops nach Leader-Ausfall verkürzen | Getrackter Kandidat; Aufnahme nicht final |
| StatefulSet-Integration mit Workload APIs | Workload-Aware Scheduling über Jobs hinaus erweitern | Getrackter Kandidat; Aufnahme nicht final |
Weitere Linien verdienen Beobachtung: SELinux-Mount-Verhalten, cgroup-v1-Rückzug, IPVS-Deprecation, DRA, Workload-Aware Scheduling, Pod Checkpoint/Restore und In-place Resize. Ich aktualisiere diesen Artikel nach dem Enhancement Freeze und erneut nach Veröffentlichung von 1.38.0. Bis dahin verkauft jeder Artikel mit einer angeblich finalen „Kubernetes-1.38-Feature-Liste“ eine Prognose als Changelog.
Welche Version sollten Sie betreiben?
Neuer selbstverwalteter Cluster: Nehmen Sie 1.37, sofern CNI, CSI, Runtime und Operatoren es unterstützen. Es gibt wenig Grund, bewusst mit 1.35 zu starten, dessen Maintenance Window im Dezember 2026 beginnt.
Bestehende Produktion auf 1.35: Kein Panik-Upgrade, aber die Node-Basis jetzt abschließen: containerd 2.x, cgroup v2, Add-on-Kompatibilität und IPVS-Inventar. Danach in einer getesteten Sequenz über 1.36 gehen.
Managed Kubernetes: Nutzen Sie das neueste Release, das Ihr Provider als production-ready markiert und das Ihre Add-on-Matrix unterstützt. Upstream Stable ist eine Aussage über API-Reife, keine Zusage zur Provider-Verfügbarkeit.
Auf 1.38 warten: Verschieben Sie kein notwendiges Security- oder Support-Upgrade für ein Release mit noch nicht eingefrorenen Features. Gehen Sie auf eine unterstützte 1.36/1.37-Basis und behandeln Sie 1.38 als nächsten Validierungszyklus.
Zur größeren Verantwortungsgrenze zwischen Upstream und Managed Services lesen Sie was EKS, AKS und GKE wirklich verwalten. Für Plattform-Guardrails rund um den Cluster siehe die Secure-by-Default-GKE-Referenzarchitektur.
Fazit
Kubernetes 1.35–1.37 ist ein Plattformübergang, verkleidet als drei Minor Releases.
Die alte Basis hieß containerd 1.x, cgroup-v1-Kompatibilität, IPVS, breite Kubelet-Proxy-Rechte, Webhook-Infrastruktur für jede Policy, Secrets für Workload-Zertifikate und Device Plugins, die eine GPU auf eine Zahl reduzieren. Die neue Basis heißt containerd 2.x, cgroup v2, nftables, feingranulare Autorisierung, In-process-CEL-Policy, rotierende Pod-Identität und Resource APIs, die Geräte und ganze Workloads verstehen.
Aktualisieren Sie nicht wegen KYAML-Ausgabe oder einer längeren Feature-Gate-Liste. Aktualisieren Sie, weil sich das unterstützte Security- und Ressourcenmodell verschoben hat. Prüfen Sie die Annahmen, die sich mitverschoben haben, testen Sie die Abhängigkeiten außerhalb von Kubernetes per Canary und lassen Sie 1.38 im Watchlist-Status, bis das Release Team aus Kandidaten Release Notes gemacht hat.
Aus der Community
Diskussion im Fediverse
Antworten von Mastodon und Bluesky — direkt aus dem offenen Netz, ohne Tracking.
Antworten werden geladen …
Noch keine Antworten. Starte die Diskussion:
Antworten konnten gerade nicht geladen werden.